一、背景:传统数仓开发之痛
在传统的数据仓库开发模式中,一个需求从提出到上线通常需要经历以下流程:
-
人工澄清需求、理解业务口径
-
架构师设计分层架构与表定位
-
建模师手动编写建表 DDL、在平台逐条执行
-
开发工程师手写 ETL SQL、手动配置 大数据平台 调度任务
-
手动配置上下游依赖关系、触发执行
-
测试人员逐条编写测试 SQL、手动执行、人工整理报告
-
开发工程师编写开发文档、提交 JOB 上线
整个过程环节多、周期长、容易出错,且严重依赖个人经验。更致命的是,当多个项目同时推进时,只能串行排队,效率极低。
二、数仓专家团:五角色协作的 AI 智能体团队
基于 Workbuddy 平台,我们构建了一个由五个 AI 专家角色组成的数仓开发团队,每个角色各司其职、边界清晰:
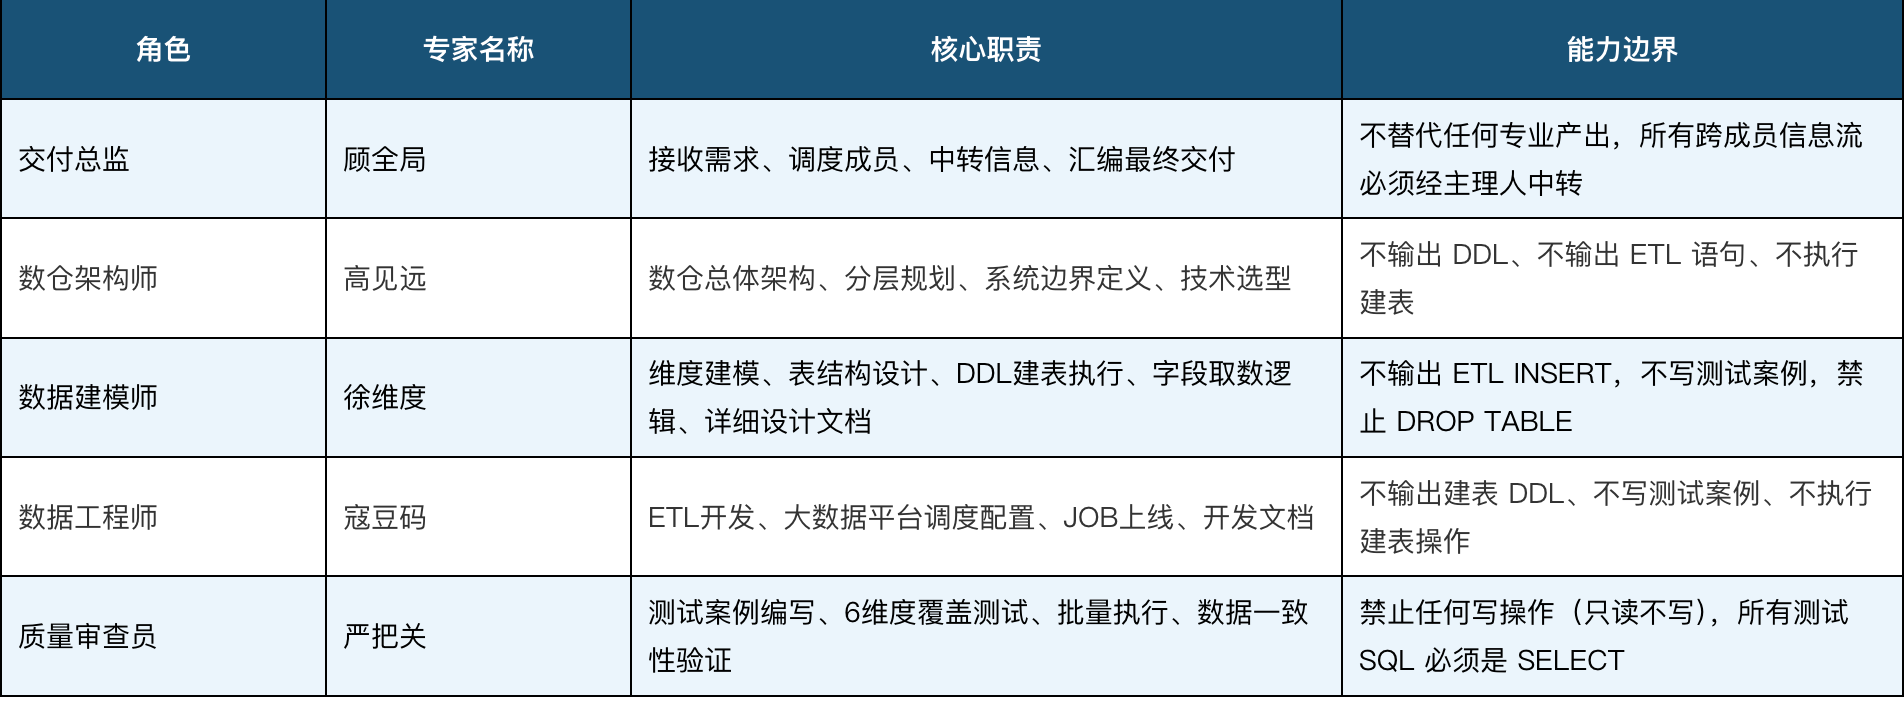
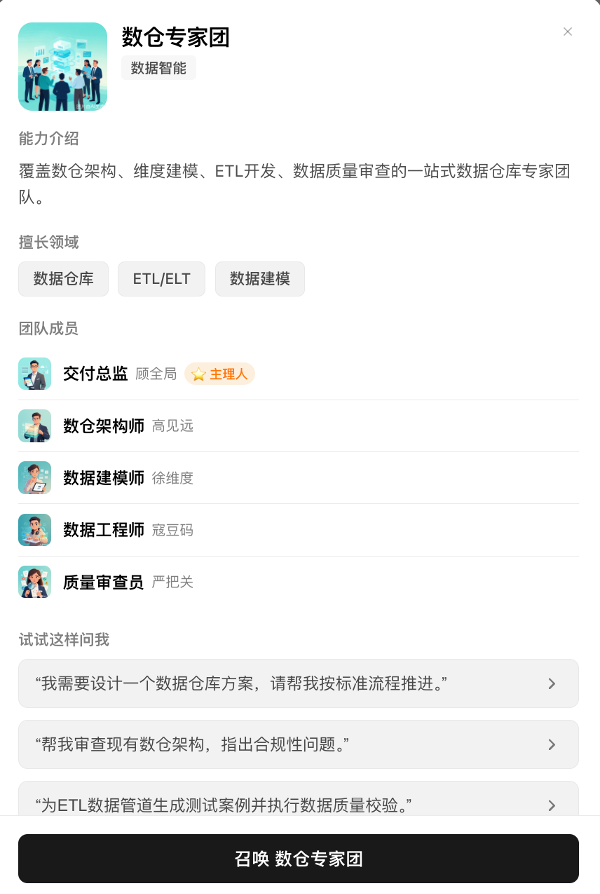
图 1:Workbuddy 数仓专家团界面截图
职责边界矩阵
为避免角色间职责重叠或遗漏,专家团对核心工作项做了唯一责任人划分。每项工作只由一个角色负责,确保边界清晰、协作高效:
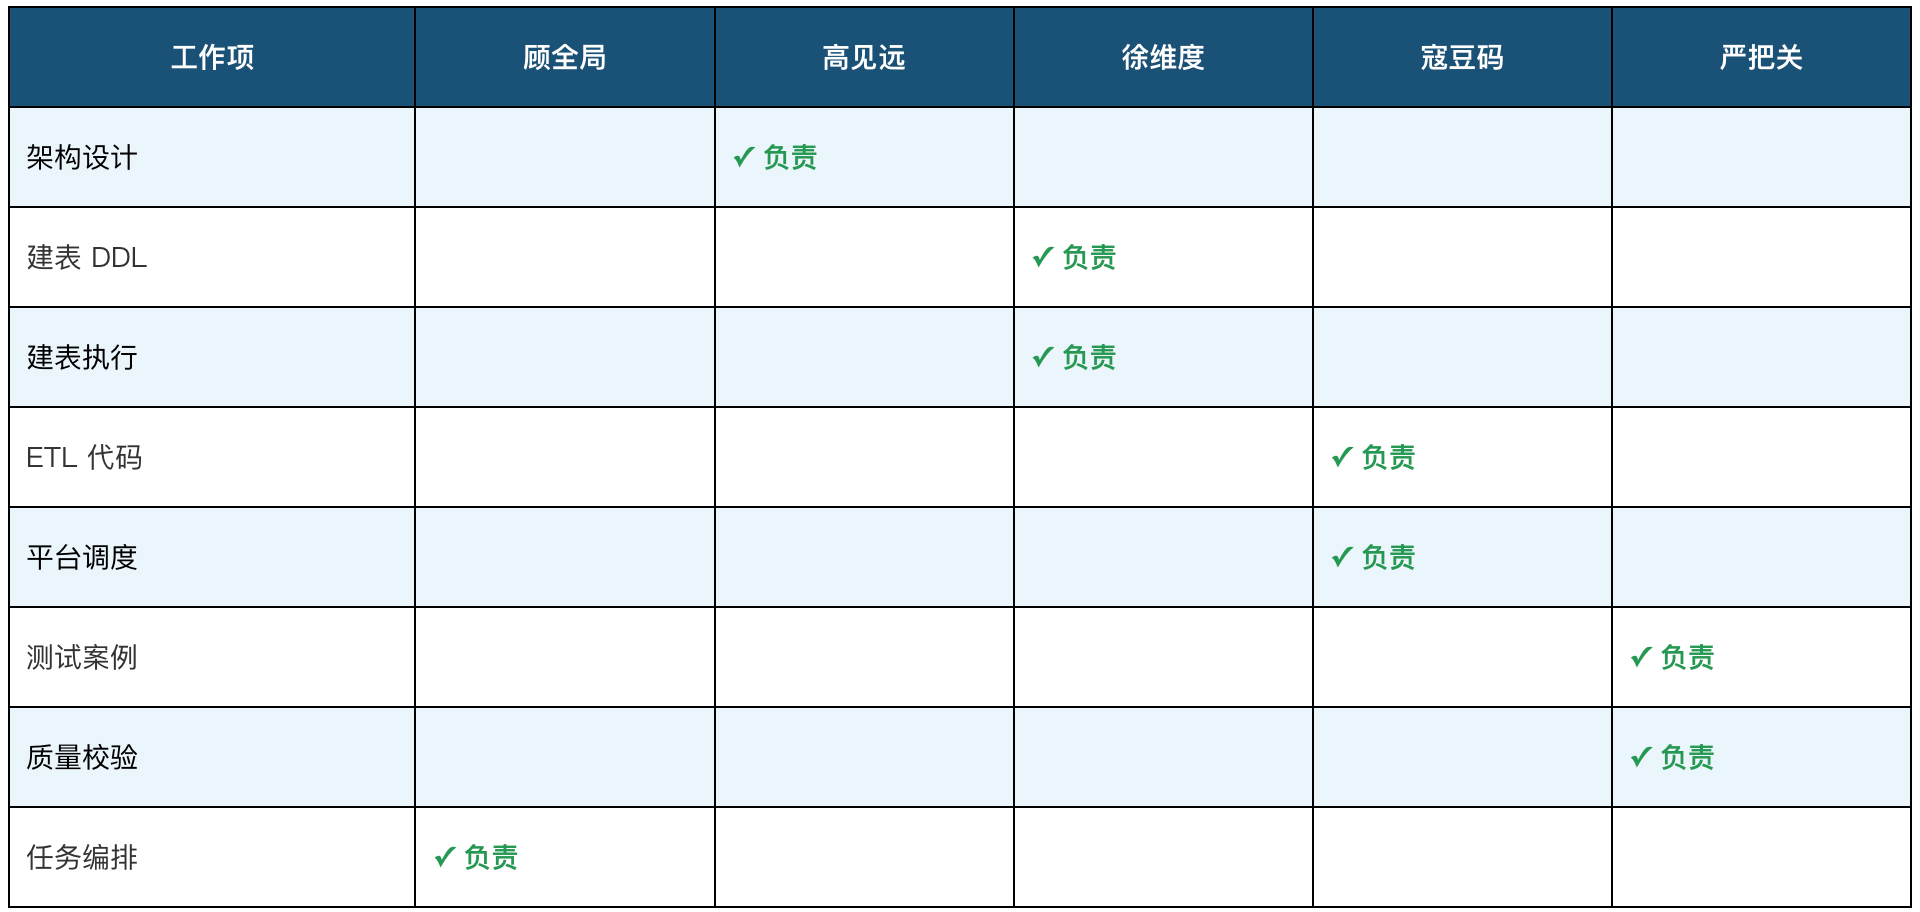
原则:每项工作只有一个负责人,职责不交叠。✓ 负责 = 负责该工作项;空白 = 不参与。
标准工作流程(SOP):
需求澄清 → 架构设计 → 建模+建表 → ETL开发+上线 → 质量审查 → 交付
协作机制:主理人创建团队 → 调度成员下发任务 → 成员回传产出 → 主理人汇编交付。所有跨成员信息流必须经主理人中转,严禁成员互直连。
三、指标库:专家团体系中的人工唯一职责
3.1 指标库的定位
指标库,是数仓专家团工作流中人工与自动化的交接点,也是一个整体共享、持续积累的知识库。在专家团体系中,维护指标库是人工唯一的开发职责——未来人工更多的是对接业务需求、确认业务口径,然后维护指标库,最后触发专家团做后续全流程自动化开发:
对接业务需求 → 确认业务口径 → 维护指标库 → 触发专家团 → 全流程自动化开发
(人工) (人工) (人工) (自动) (自动)
核心理念:人工只负责“定规则”——对接需求、确认口径、维护指标库;专家团负责“写代码”——从建模到交付全部自动完成。
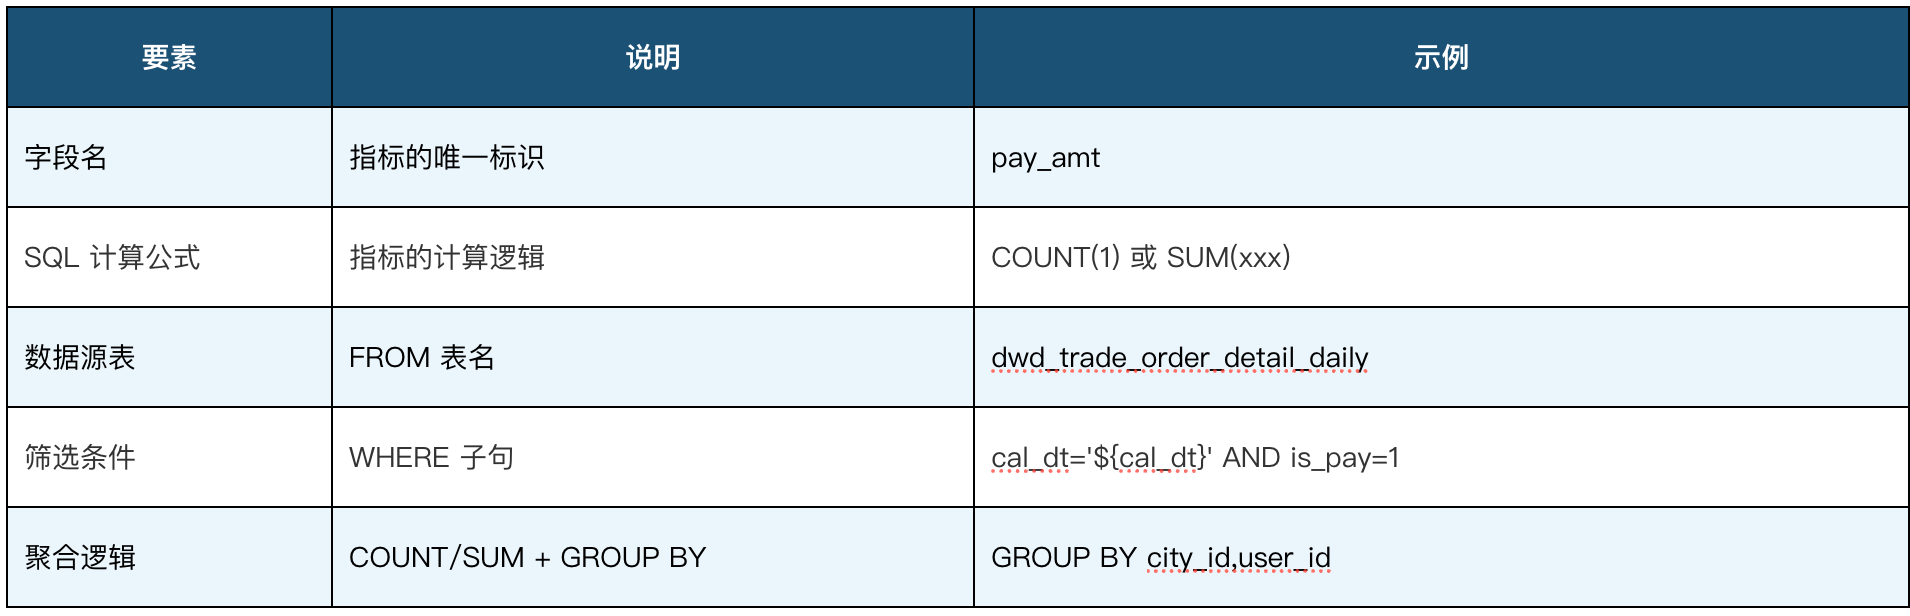
3.2 指标库包含的内容
3.3 人工职责与触发机制
在传统模式下,开发人员需要理解需求后,自行查找数据源表、推断取数逻辑、编写 SQL。这个过程大量依赖个人对业务的理解和对数据表的熟悉程度,是导致开发效率低、质量不稳定的根源。
专家团模式下,人工的职责从“写代码”转变为“定规则”:
⚠ 关键约束:指标库必须先维护好,否则专家团无法启动。维护指标库是触发自动化开发的唯一入口。
-
对接业务需求:与业务方沟通,理解指标的业务含义和使用场景
-
确认业务口径:明确指标的计算逻辑——从哪张表取数、用什么条件筛选、如何聚合
-
维护指标库:将确认后的口径以 SQL 公式的形式固化到路由文档中
-
触发专家团:指标库维护完成后,触发专家团自动完成建模、建表、ETL 开发、测试、交付全流程
其中第 1、2 步是业务沟通工作,第 3 步是规则固化工作,第 4 步起全部由专家团自动完成。新增指标时,重复以上步骤即可。
指标库的引入,实现了“计算逻辑”与“开发执行”的彻底解耦:
-
口径统一:所有指标的取数逻辑在一个地方维护,杜绝了“同一个指标不同人写出不同 SQL”的问题
-
可追溯:任何字段的计算逻辑都可以在路由文档中查到源头
-
低门槛:新人不需要熟悉底层表结构,只需要知道指标怎么算,就能驱动整个开发流程
-
质量可控:因为计算逻辑已由人工确认并固化,专家团自动生成的 SQL 不会出现理解偏差
3.4 指标复用:共享库的规模效应
指标库不是一次性的工作产物,而是一个整体共享、持续积累的指标知识库。这一点至关重要:
核心原则:只有新增指标才需要人工维护,已有指标可直接复用。
当新的开发需求到达时,工作流程如下:
业务需求到达 → 指标已在库中? → 是→直接复用→触发专家团(跳过维护) / 否→确认口径→维护指标库→触发专家团
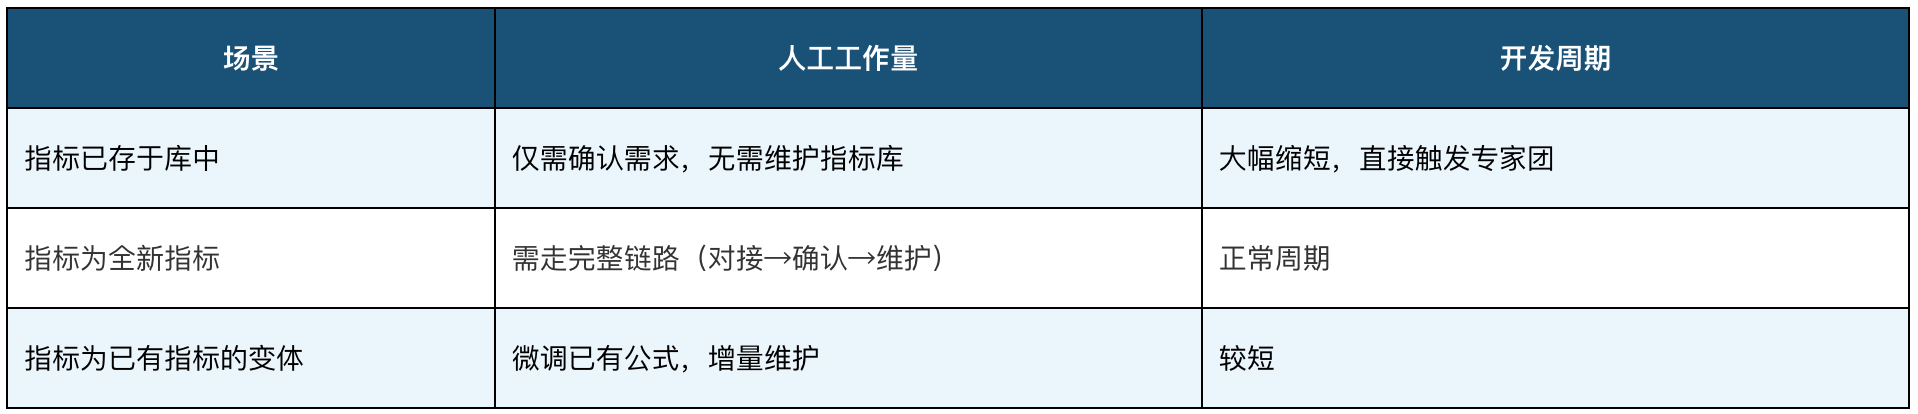
规模效应:随着指标库不断积累,可复用的指标比例越来越高,人工实际维护工作量逐渐递减。这意味着:
-
开发效率持续提升:指标库越丰富,“零维护直接复用”的比例越高,开发周期从天级压缩到小时级
-
口径一致性天然保障:同一指标全公司共用一套计算逻辑,不同项目引用同一个公式,杜绝口径分歧
-
人工投入递减:初期需要大量维护新指标,后期维护量逐步下降,人工精力更多转向业务理解和需求对接
-
知识资产沉淀:指标库本身就是企业的数据资产,人员的流动不再影响计算逻辑的连续性
四、详细设计文档:串联各专家角色的核心纽带
如果说指标库是“输入”,那么详细设计文档就是串联所有专家角色的“中枢”。它是整个开发流程中信息传递和角色协作的核心载体。
4.1 详细设计文档的定位
指标库(输入)──→ 详细设计文档(中枢)──→ ETL 开发 + 测试(并行执行)
详细设计文档由数据建模师(徐维度)独立产出,它的特殊性在于:
-
向上:消费指标库中的取数逻辑,将其转化为结构化的表设计
-
向下:为数据工程师(寇豆码)提供 ETL 开发的精确输入
-
横向:为质量审查员(严把关)提供测试案例编写的字段依据
4.2 各角色如何通过详细设计文档串联
第一环:架构师(高见远)→ 建模师(徐维度)
架构师输出《架构设计文档》,明确数仓分层定位、表的分区策略和生命周期、系统边界和上下游关系。建模师拿到架构设计文档后,结合指标库的取数逻辑,输出《详细设计文档》,内容包括完整的 DDL 建表语句、每个字段的取数逻辑、分区/分桶策略、命名规范。
第二环:建模师→ 工程师 + 审查员(并行)
详细设计文档是关键的分叉点,ETL 开发和测试案例编写可以并行启动:
左路——寇豆码(数据工程师):
-
读取详细设计文档中的字段取数逻辑
-
编写 ETL SQL(ALTER TABLE DROP PARTITION + INSERT OVERWRITE)
-
配置 大数据平台 调度任务(调度周期、依赖配置)
-
触发执行确保成功,提交 JOB 上线
-
输出《ETL 详细开发文档》
右路——严把关(质量审查员):
-
读取详细设计文档中的字段定义
-
为每个字段编写测试案例 SQL,覆盖 6 个质量维度:完整性、准确性、一致性、唯一性、有效性、空值检查
这种并行架构大幅缩短了整体交付周期:ETL 上线后,测试案例已就绪,可立即执行质量验证。
第三环:审查员→ 主理人(顾全局)
测试执行完成后,审查员输出《测试案例文档》和《测试结果报告》,主理人汇编所有交付物:架构设计文档、模型概要设计文档、模型详细设计文档、ETL 开发文档、大数据平台 调度上线信息、测试案例文档、测试结果报告、最终交付报告。
4.3 详细设计文档的核心价值
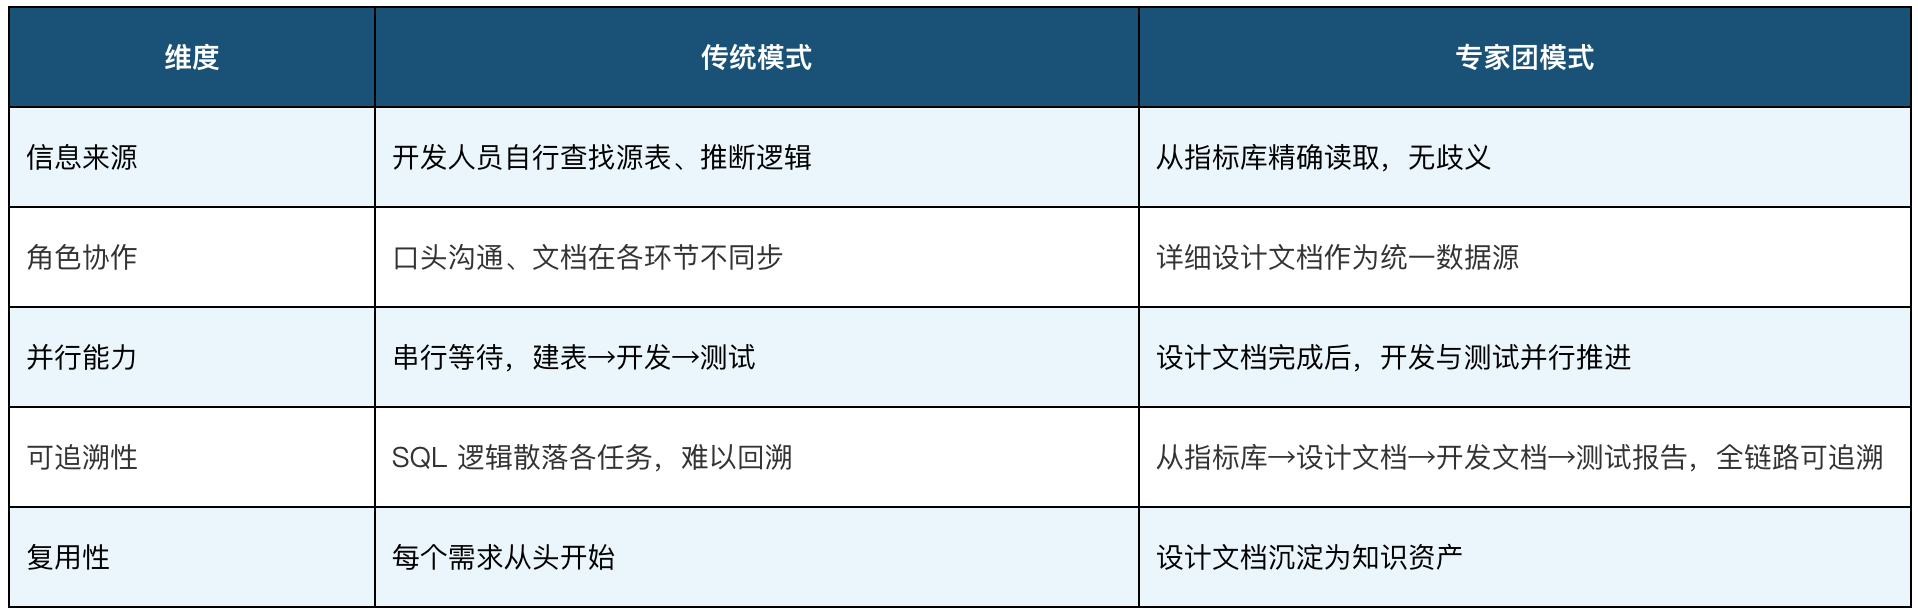
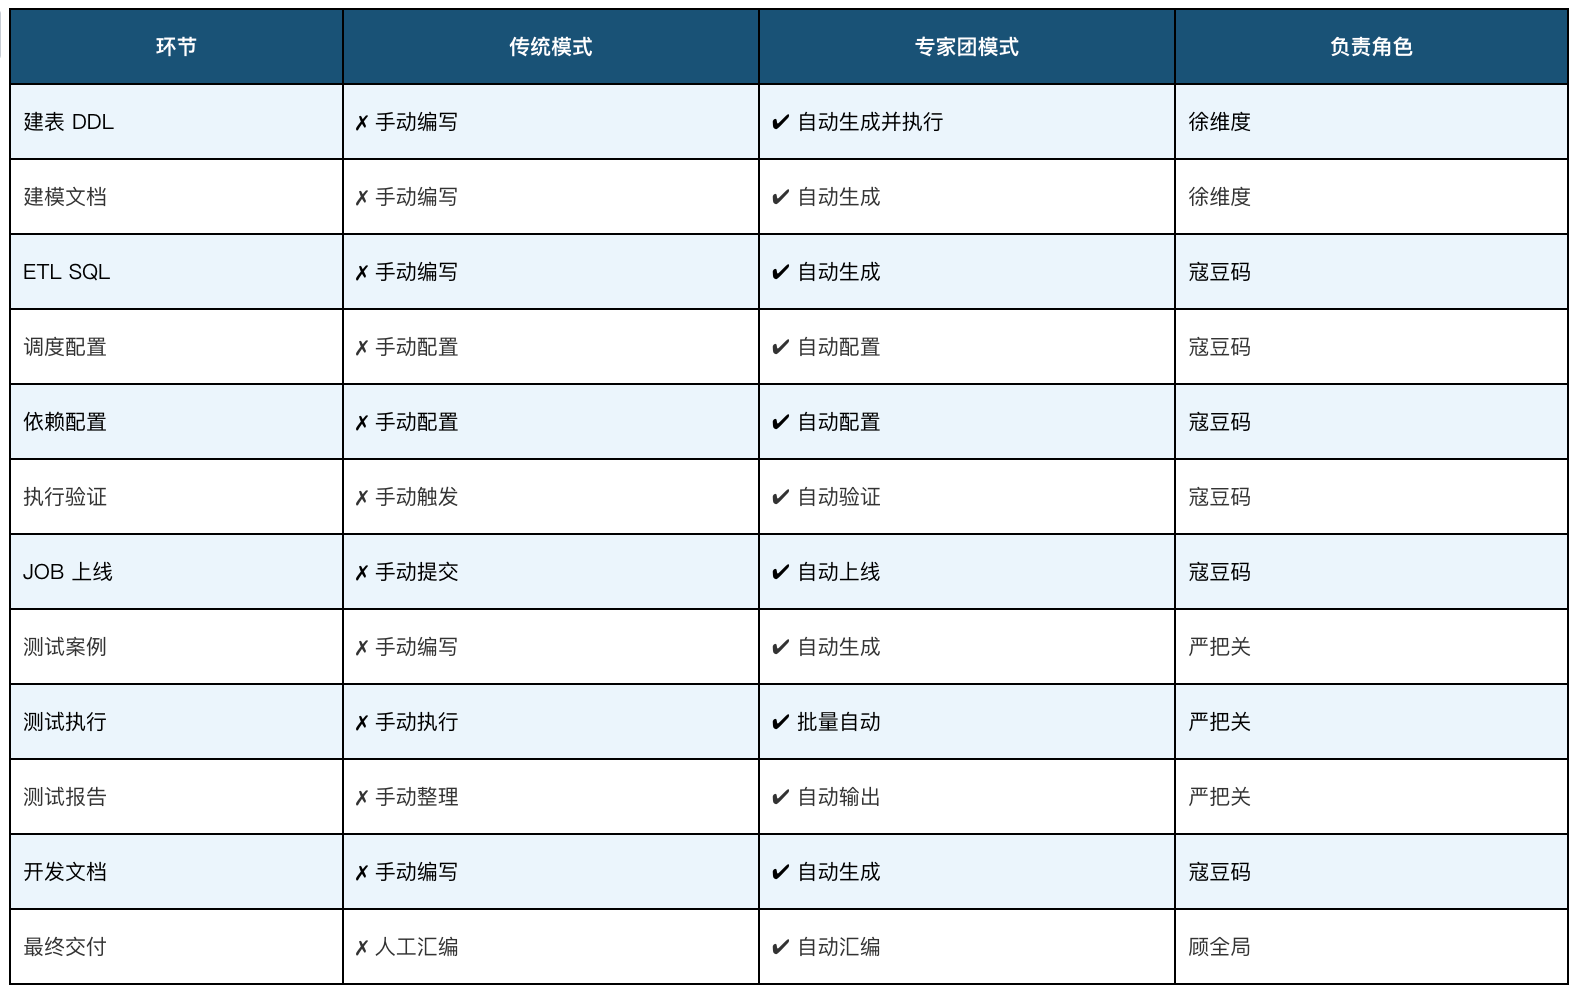
五、全流程自动化:传统模式与专家团模式对比
六、并行能力:多项目同时推进
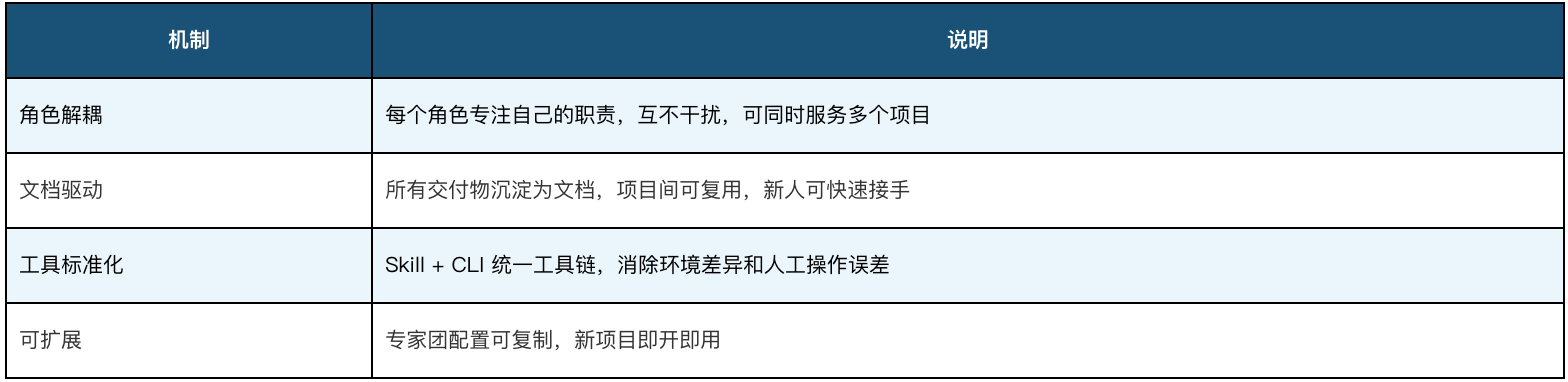
专家团的另一大核心优势是角色解耦带来的并行能力。
传统模式:串行排队
项目A(完整流程)→ 项目B(完整流程)→ 项目C(完整流程)
传统模式下,一个开发人员同时只能做一个项目,多个需求只能排队等待。
专家团模式:多项目并行
项目A:顾全局A ← 高见远 ← 徐维度 ← 寇豆码 + 严把关(并行) | 项目B:同理 | 项目C:同理
并行能力来源
七、工具链与知识库
7.1 标准化工具链
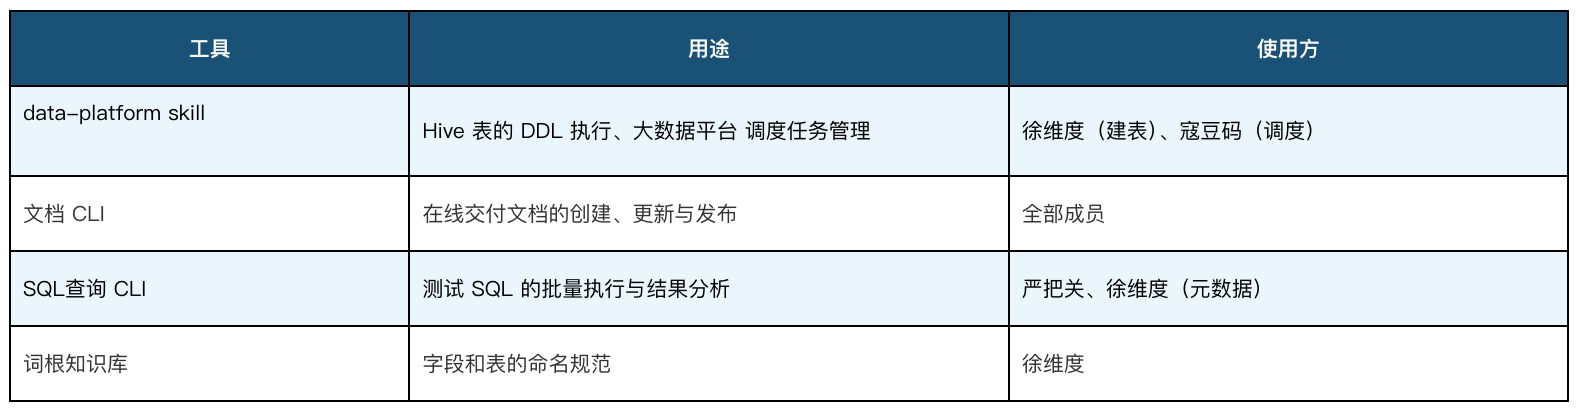
7.2 内置知识库
专家团内置了以下知识库,确保产出的一致性和规范性:
-
服务器&库使用规范:开发环境、库的选择与使用约束(面向徐维度)
-
表规范:表命名、分区策略、生命周期管理(面向徐维度)
-
词根知识库:字段和表的标准命名词根(面向徐维度)
-
JOB 规范:大数据平台 任务配置标准(面向寇豆码)
-
SQL 编程规范:SQL 编写风格与性能要求(面向寇豆码)
设计原则:固化的东西直接封装在专家团中,不固定的东西走外部接口(如指标库)。
八、总结与展望
核心结论
数仓专家团通过以下三层设计,实现了数仓开发的全流程自动化:
-
指标库(唯一输入):人工只需维护指标计算路由文档,计算逻辑被精确固化,消除口径歧义和手工推断
-
详细设计文档(中枢纽带):由建模师从指标库自动生成,成为各角色协作的统一数据源,实现 ETL 开发与测试并行
-
五角色协作(自动化执行):架构师 → 建模师 → 工程师 + 审查员 → 主理人,职责明确、边界清晰、交付可追溯
演进愿景
数仓开发从“人写代码”进化到“人定规则”,人工只需定义业务逻辑(What),专家团负责技术实现(How),实现真正的数据全流程自动化开发。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70051111/viewspace-3180348/ ,如需转载,请注明出处,否则将追究法律责任。

