当"一人公司"(One Person Company,OPC)开始规模化使用AI时,最先崩溃的往往不是模型本身,而是调用方式。今天用A厂商的API,明天换B厂商的模型,后天要接入知识库问答,大后天要定时跑一批自动化任务——如果每个需求都单独写一套胶水代码,很快就会被维护成本拖垮。
本文记录我从0搭建一套面向OPC的AI中台的全过程。核心思路是:把模型调用、知识检索、任务编排这三件事抽象成平台能力,用一套统一接口对外服务。文章覆盖架构设计、API编排、RAG全链路、工作流自动化、部署运维与成本优化,所有代码和配置均可复现。
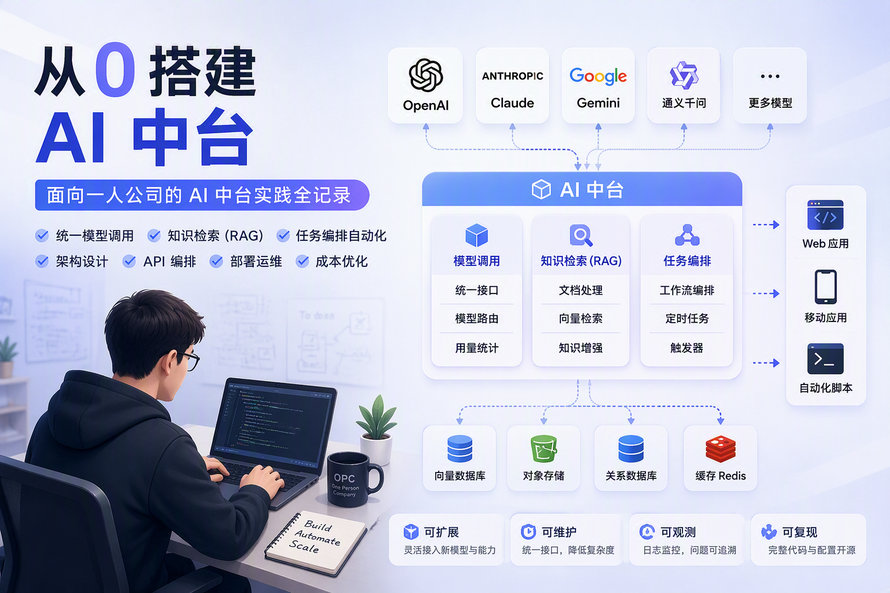
一、整体架构设计
OPC的AI中台不需要像大厂那样拆成十几个微服务,但必须做到"模块清晰、接口统一、可水平扩展"。我的分层设计如下:
┌─────────────────────────────────────────────┐
│ 接入层 (API Gateway) │
│ 统一鉴权 / 限流 / 计费 / 日志 / 多租户隔离 │
└──────────────────┬──────────────────────────┘
│
┌──────────────────▼──────────────────────────┐
│ 编排层 (Orchestration) │
│ ┌──────────┐ ┌──────────┐ ┌──────────────┐ │
│ │ API编排 │ │ RAG引擎 │ │ 工作流引擎 │ │
│ │ 多模型路由 │ │ 文档切分 │ │ 任务编排/定时 │ │
│ │ 负载均衡 │ │ 向量化 │ │ Agent协作 │ │
│ │ 降级策略 │ │ 检索增强 │ │ 状态机 │ │
│ └──────────┘ └──────────┘ └──────────────┘ │
└──────────────────┬──────────────────────────┘
│
┌──────────────────▼──────────────────────────┐
│ 模型与数据层 │
│ 多模型Provider / 向量数据库 / 文档存储 / 缓存 │
└─────────────────────────────────────────────┘
设计要点:
1. 接入层与编排层分离:接入层只负责鉴权、限流、计费,不关心业务逻辑;编排层才是核心。
2. 三大引擎解耦:API编排、RAG、工作流各自独立,通过内部事件总线通信,避免互相耦合。
3. Provider抽象:所有模型厂商(OpenAI、Claude、通义千问、DeepSeek等)统一封装成Provider接口,上层无感知。
💡 落地建议:如果你不想从零搭建整套中台,可以试试 [实在Agent](https://agent.iaiai.com/)。它的社区版完全免费,内置可视化工作流编辑器和多模型路由能力,拖拽即可完成编排,对一人公司来说上手门槛极低。下文涉及的API编排、RAG、工作流等能力,实在Agent 均有对应的开箱即用模块,可以作为本文方案的"快捷替代路径"。
二、API编排层:多模型路由、负载均衡与降级
API编排层是AI中台的"交通枢纽"。它解决三个核心问题:该用哪个模型、怎么分配流量、模型挂了怎么办。
2.1 Provider抽象
先定义一个统一的Provider接口,屏蔽不同厂商的差异:
providers/base.py
from abc import ABC, abstractmethod
from dataclasses import dataclass
@dataclass
class ModelRequest:
model: str
messages: list[dict]
temperature: float = 0.7
max_tokens: int = 2048
@dataclass
class ModelResponse:
content: str
usage: dict
latency_ms: int
class BaseProvider(ABC):
@abstractmethod
async def chat(self, req: ModelRequest) -> ModelResponse:
"""统一对话接口"""
...
@abstractmethod
async def health_check(self) -> bool:
"""健康检查,供路由层使用"""
...
2.2 多模型路由
路由策略决定了"这次请求发给谁"。我实现了三种策略,可组合使用:
- 按能力路由:根据任务类型(代码、翻译、长文)选择擅长模型;
- 按成本路由:简单任务走便宜模型,复杂任务走旗舰模型;
- 按优先级路由:优先使用配额充足或延迟低的模型。
router.py
class ModelRouter:
def __init__(self, registry: dict[str, BaseProvider]):
self.registry = registry # {"deepseek-chat": provider, ...}
async def route(self, req: ModelRequest, strategy: str) -> ModelResponse:
if strategy == "cost":
# 简单任务优先便宜模型
candidates = sorted(
self.registry.values(),
key=lambda p: p.cost_per_1k_tokens
)
elif strategy == "capability":
candidates = self._match_capability(req)
else: # priority
candidates = self._by_priority(req)
return await self._try_with_fallback(candidates, req)
2.3 负载均衡与降级策略
负载均衡采用加权轮询 + 健康检查:每个Provider维护一个滑动窗口的失败率,失败率高的自动降低权重。降级策略采用多级熔断:
config/fallback.yaml
fallback:
# 主模型失败后依次降级
chain:
- model: deepseek-chat
provider: deepseek
- model: qwen-plus
provider: dashscope
- model: gpt-4o-mini
provider: openai
circuit_breaker:
failure_threshold: 5 # 连续失败5次熔断
recovery_timeout: 30s # 30秒后尝试恢复
half_open_max: 2 # 半开状态最多放行2个请求
核心降级逻辑:
fallback.py
async def chat_with_fallback(req: ModelRequest, chain: list[dict]):
last_error = None
for item in chain:
provider = get_provider(item["provider"])
if breaker.is_open(item["model"]):
continue # 熔断中的模型直接跳过
try:
resp = await provider.chat(req)
breaker.record_success(item["model"])
return resp
except Exception as e:
breaker.record_failure(item["model"])
last_error = e
logger.warning(f"model {item['model']} failed: {e}")
raise ServiceUnavailable(f"all models failed: {last_error}")
经验:降级链一定要把"便宜但稳定"的模型放在最后兜底,而不是把最贵的放最后——否则故障时成本反而飙升。
三、RAG知识库搭建:文档切分、向量化、检索增强全链路
RAG(Retrieval-Augmented Generation)让AI能回答私有知识库的问题。全链路分四步:文档解析 → 切分 → 向量化 → 检索增强生成。
3.1 文档切分
切分质量直接决定检索效果。我采用分层切分策略:先按结构切块,再按语义边界微调。
chunker.py
from langchain_text_splitters import RecursiveCharacterTextSplitter
def split_document(text: str, chunk_size=800, overlap=150):
# 先按标题/段落结构切分,保留语义完整性
splitter = RecursiveCharacterTextSplitter(
chunk_size=chunk_size,
chunk_overlap=overlap,
separators=["\n\n", "\n", "。", ";", " ", ""],
)
chunks = splitter.split_text(text)
# 为每个chunk补充元数据(来源、章节、页码)
return [{"content": c, "meta": extract_meta(c)} for c in chunks]
切分要点:
- chunk_size 建议 500-1000 token,太小丢失上下文,太大检索噪声高;
- overlap 保留 10%-20%,避免关键信息被切断在边界;
- 对Markdown/PDF等结构化文档,优先按标题层级切分。
3.2 向量化与存储
向量化选择Embedding模型 + 向量数据库的组合。我使用 text-embedding-3-small 做向量化,Qdrant 做向量存储(支持过滤、可本地部署、免费额度友好)。
vectorize.py
from qdrant_client import QdrantClient
from qdrant_client.models import Distance, VectorParams, PointStruct
client = QdrantClient(url="http://localhost:6333")
def upsert_chunks(chunks: list[dict], collection: str):
points = []
for i, chunk in enumerate(chunks):
vector = embed(chunk["content"]) # 调用Embedding模型
points.append(PointStruct(
id=hash(chunk["content"]),
vector=vector,
payload={"content": chunk["content"], chunk["meta"]},
))
client.upsert(collection_name=collection, points=points)
建集合时指定向量维度
client.create_collection(
collection_name="opc_kb",
vectors_config=VectorParams(size=1536, distance=Distance.COSINE),
)
3.3 检索增强生成
检索阶段采用混合检索:向量相似度 + 关键词BM25,再融合排序,提升召回率。
rag.py
def retrieve(query: str, top_k=5):
# 向量检索
vec_hits = client.search(
collection_name="opc_kb",
query_vector=embed(query),
limit=top_k,
)
# 关键词检索(BM25)
kw_hits = bm25_search(query, top_k=top_k)
# 融合排序(RRF:Reciprocal Rank Fusion)
return rrf_fusion(vec_hits, kw_hits)
def generate_answer(query: str):
docs = retrieve(query)
context = "\n\n".join(d["content"] for d in docs)
prompt = f"""基于以下资料回答问题,若资料中没有答案请明确说明:
【资料】
{context}
【问题】
{query}"""
return chat_with_fallback(ModelRequest(
model="deepseek-chat",
messages=[{"role": "user", "content": prompt}],
))
RAG优化经验:
- 检索结果一定要带来源引用,方便用户溯源,也便于排查幻觉;
- 对高频问题加一层缓存,命中缓存直接返回,省一次模型调用;
- 定期做知识库增量更新,避免旧文档污染检索结果。
四、工作流自动化:任务编排、定时触发与Agent协作
工作流引擎让AI中台从"被动响应"变成"主动执行"。我用 Temporal 做任务编排(支持持久化、重试、定时),配合 LangGraph 做Agent协作。
💡 轻量替代方案:Temporal + LangGraph 的组合功能强大但部署较重。如果你更倾向于开箱即用的方案,实在Agent 社区版提供了完整的可视化工作流引擎——在画布上拖拽节点、连线配置依赖关系即可完成 DAG 编排,支持定时触发和 Agent 协作,并且原生对接企业微信、飞书、CRM、数据库等常见业务系统,跨系统自动化无需额外写集成代码。对于没有专职运维的一人公司,这是更务实的选择。
4.1 任务编排
把业务拆成有向无环图(DAG),每个节点是一个任务,支持依赖、重试、超时。
workflow.py
from temporalio import workflow
@workflow.defn
class ContentPipeline:
@workflow.run
async def run(self, topic: str):
# 1. 收集素材
materials = await workflow.execute_activity(
collect_materials, topic,
start_to_close_timeout=timedelta(minutes=5),
)
# 2. 生成初稿
draft = await workflow.execute_activity(
generate_draft, materials,
retry_policy=RetryPolicy(maximum_attempts=3),
)
# 3. 质量检查,失败则重写
quality = await workflow.execute_activity(check_quality, draft)
if quality.score < 0.8:
draft = await workflow.execute_activity(rewrite, draft)
# 4. 发布
await workflow.execute_activity(publish, draft)
return draft
4.2 定时触发
定时任务用Temporal的Schedule API,支持Cron表达式:
schedule.py
from temporalio.client import Schedule, ScheduleAction, ScheduleSpec
await client.create_schedule(
"daily-content-digest",
Schedule(
action=ScheduleAction.start_workflow(ContentPipeline, "每日行业摘要"),
spec=ScheduleSpec(
cron_expressions=["0 8 "], # 每天早上8点
timezone_name="Asia/Shanghai",
),
),
)
4.3 Agent协作
复杂任务拆给多个Agent协作,用LangGraph定义状态机,让Agent之间能传递上下文、互相调用工具。
agents.py
from langgraph.graph import StateGraph, END
def build_agent_graph():
g = StateGraph(AgentState)
g.add_node("planner", plan_task) # 规划Agent:拆解任务
g.add_node("researcher", research) # 研究Agent:检索资料
g.add_node("writer", write_content) # 写作Agent:生成内容
g.add_node("reviewer", review) # 审核Agent:质量把关
g.set_entry_point("planner")
g.add_edge("planner", "researcher")
g.add_edge("researcher", "writer")
g.add_edge("writer", "reviewer")
g.add_conditional_edges(
"reviewer",
lambda s: "writer" if s.need_revision else END,
{"writer": "writer", END: END},
)
return g.compile()
Agent协作要点:每个Agent只做一件事,通过共享状态传递结果;审核Agent作为"质量闸门",不合格就回退重写,避免垃圾内容直接产出。
五、部署与运维方案
OPC的部署原则是轻量、可迁移、低成本。我采用 Docker Compose + 单机部署,后续可平滑迁移到K8s。
docker-compose.yml
version: "3.9"
services:
gateway:
build: ./gateway
ports: ["8080:8080"]
depends_on: [orchestrator]
orchestrator:
build: ./orchestrator
environment:
- REDIS_URL=redis://redis:6379
- QDRANT_URL=http://qdrant:6333
qdrant:
image: qdrant/qdrant:latest
volumes: [qdrant_data:/qdrant/storage]
redis:
image: redis:7-alpine
temporal:
image: temporalio/auto-setup:latest
ports: ["7233:7233"]
volumes:
qdrant_data:
运维要点:
- 可观测性:接入 OpenTelemetry,统一采集链路追踪、指标、日志,用 Grafana 展示;
- 配置管理:密钥(API Key)放环境变量或Vault,绝不写进代码仓库;
- 备份:向量库和文档库每日快照,模型调用日志保留30天用于审计和成本核算;
- 灰度发布:新模型先小流量灰度,观察延迟和错误率再全量切换。
💡 成本提示:如果用实在Agent 社区版,上面这套 Docker Compose 的部署和运维成本可以直接省掉——社区版完全免费,无需自建Temporal、Qdrant等基础设施。社区还提供丰富的教程和模板,上手快;邀请好友注册还能获得免费的资源点,进一步降低模型调用成本,对预算敏感的OPC非常友好。
六、成本与性能优化实践
6.1 成本优化
手段 | 说明 | 效果
模型分级路由 | 简单任务走便宜模型 | 成本可降 40%-60%
结果缓存 | 高频问题命中缓存 | 省去重复调用
上下文压缩 | 长对话裁剪历史 | 减少token消耗
批量Embedding | 文档向量化合并请求 | 降低API调用次数
本地小模型兜底 | 简单分类用本地模型 | 零边际成本
6.2 性能优化
缓存层:Redis + 语义缓存
async def cached_chat(req: ModelRequest):
key = semantic_hash(req.messages) # 语义哈希,相似问题命中
if cached := await redis.get(key):
return cached
resp = await chat_with_fallback(req, FALLBACK_CHAIN)
await redis.setex(key, TTL=3600, value=resp)
return resp
性能优化清单:
- 流式输出:SSE流式返回,首token延迟从秒级降到百毫秒级,体验提升明显;
- 并发控制:用信号量限制并发,避免打爆模型配额触发限流;
- 连接池复用:HTTP连接池 + 异步IO,减少握手开销;
- 向量索引优化:Qdrant开启HNSW索引,检索延迟稳定在10ms内;
- 预热:服务启动时预热Embedding模型和连接池,避免冷启动慢。
七、总结与踩坑记录
这套AI中台从0搭建,核心收益是把"每次接新模型都要改业务代码"变成了"改一行配置"。几个关键经验:
1. 抽象先行:Provider接口、路由策略、降级链这些抽象,越早做越省事,后期重构成本极高;
2. 降级比优化更重要:模型厂商随时可能限流或故障,降级链是稳定性的生命线;
3. RAG的瓶颈在切分:向量化和检索都是成熟技术,真正决定效果的是文档切分质量;
4. 成本要可视化:每个请求记录模型、token、成本,月底一算就知道该优化哪里;
5. 一人公司也要可观测:没有监控,故障时只能靠猜,务必从第一天就接入日志和指标。
踩过的坑:
- 早期把降级链最贵的模型放最后,故障时成本飙升——已改为"便宜稳定模型兜底";
- 文档切分overlap设太小,导致关键信息被切断、检索召回率低——已调整为15%;
- 定时任务用系统Cron,进程重启就丢任务——已迁移到Temporal持久化调度。
AI中台不是大厂的专利,一人公司同样需要。只要把模型调用、知识检索、任务编排这三件事抽象成平台能力,一个人也能维护一套稳定、可扩展、成本可控的AI基础设施。希望这篇文章能帮你少走弯路。
如果你不想从零搭建,也可以直接用 [实在Agent](https://agent.iaiai.com/) 社区版——免费、可视化工作流、跨系统自动化开箱即用,社区有丰富的教程和模板,邀请好友还能获得免费资源点,是一人公司快速落地AI中台的捷径。
本文所有代码与配置均基于开源组件(Qdrant、Temporal、LangGraph、LangChain)实现,可完整复现。欢迎在评论区交流你的AI中台实践。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70051110/viewspace-3180350/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 从工单到凭证:财务 Agent 接入 ERP 的三条路线与取舍
- 不会写代码能做智能体开发吗?零代码方案全盘点
- 国内办公智能体:大厂平台与独立厂商的落地差异,一文读懂
- 选数字员工之前,不妨先看看这四家厂商怎么做的
- 不用 API 也能连老系统:Harness 工程底座实现 CS 架构软件 AI 自动化
- 2026 多场景 Agent 工具全景盘点:桌面 Agent、代码 Agent、企业 Agent 怎么选
- 从Copilot到DataAgent:企业级智能数据开发治理平台的技术演进与实践
- 2026企业级桌面办公Agent选型参考:四款主流产品能力拆解
- 6款主流AI办公智能体对比,哪款适合你?看完这篇不纠结
- 企业AI数字员工选型实战:主流厂商对比与场景适配深度解析
