如果一张 GPU 只能给一个 Pod 用,而那个 Pod 只跑到 5% 的利用率,剩下 95% 的算力就那么空转着。这篇记录一次完整的云原生 GPU 资源池化实践。 环境:
- K8s v1.35.6 + containerd 2.2.6
- 驱动 580.126.20 / CUDA 13.0
- HAMi v2.10.0 + GPU Operator v26.7.0
一、先回答一个问题:为什么要切分 GPU
GPU 和 CPU 有一个本质区别—— 它不能被分时复用,至少默认情况下不能。
K8s 的 device plugin 把 GPU 注册成扩展资源
nvidia.com/gpu,而扩展资源有两条死规矩:
- 必须是 整数
- 不允许超卖
结果就是: 一张卡 = 一个 Pod 。第二个申请 GPU 的 Pod 直接 Pending,而第一个 Pod 可能只跑了 5% 的利用率。这就是为什么行业里 GPU 平均利用率长期在 20%–30%。切分的价值不在"省钱"这么简单,而在于把一张物理卡变成可申请、可计量、可调度的资源单位**。
二、方案选型
它有一个必须在动手前确认的事实:
T4 不支持 MIG **。
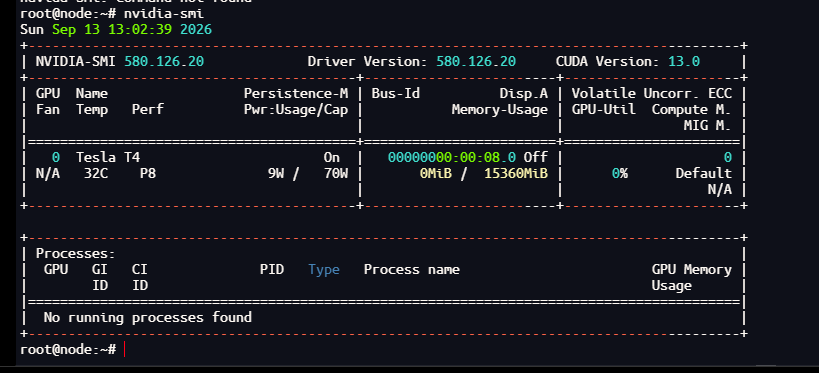
nvidia-smi 里那列
MIG M. 显示
N/A 就是证据。MIG(Multi-Instance GPU)是 A100 / A30 / H100 / L40 这一代才有的硬件切分能力,能把一张卡切成最多 7 个
硬件隔离的实例——有独立的 SM、L2、显存通道,互不干扰。T4 没有这个能力,所以硬件切分这条路直接堵死。剩下的选项:
| 方案 | 隔离级别 | 成本 | 结论 |
|---|---|---|---|
| MIG | 硬件级 | 免费 | ❌ T4 不支持 |
| NVIDIA vGPU | 硬件辅助(需 vGPU Manager) | 需付费 License + 授权服务器 | ❌ 个人/小团队不现实 |
| Time-Slicing | 无隔离,纯时间片轮转 | 免费 | ⚠️ 只是让多个容器"能跑",谁超额谁拖垮全场 |
| MPS | 算力有隔离,显存无隔离 | 免费 | ⚠️ 一个进程 OOM 全炸 |
| HAMi | 显存 硬限制 + 算力 **软限速 | 免费开源( CNCF * Incubating)* | ✅ * 本次选型* |
为什么选 HAMi:它是开源方案里唯一同时管住 显存和 算力两个维度的,而且是真正挂在 K8s 调度器上的——不是"让容器能跑起来",而是"能按额度申请、能被调度、超额会被拒"。
一个判断 :如果你的目标是"算力调度"这四个字,K8s 就不是可选项,而是必需品。因为调度这件事的载体就是调度器,HAMi 本质上是 kube-scheduler 的一个扩展。如果你只想看"一张卡怎么被两个进程分显存",docker + NVIDIA Container Toolkit 二十分钟就够,不用上 K8s。
三、环境准备:从裸机到 K8s 就绪
这一节的目标只有两件事: 宿主机 上有可用的 NVIDIA 驱动,集群里有可用的 K8s。下面按实际顺序记录每一步;如果你已经有现成的环境,可以直接跳到第四章。
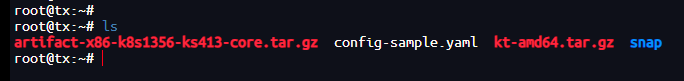
① 基础环境:系统镜像与安装包
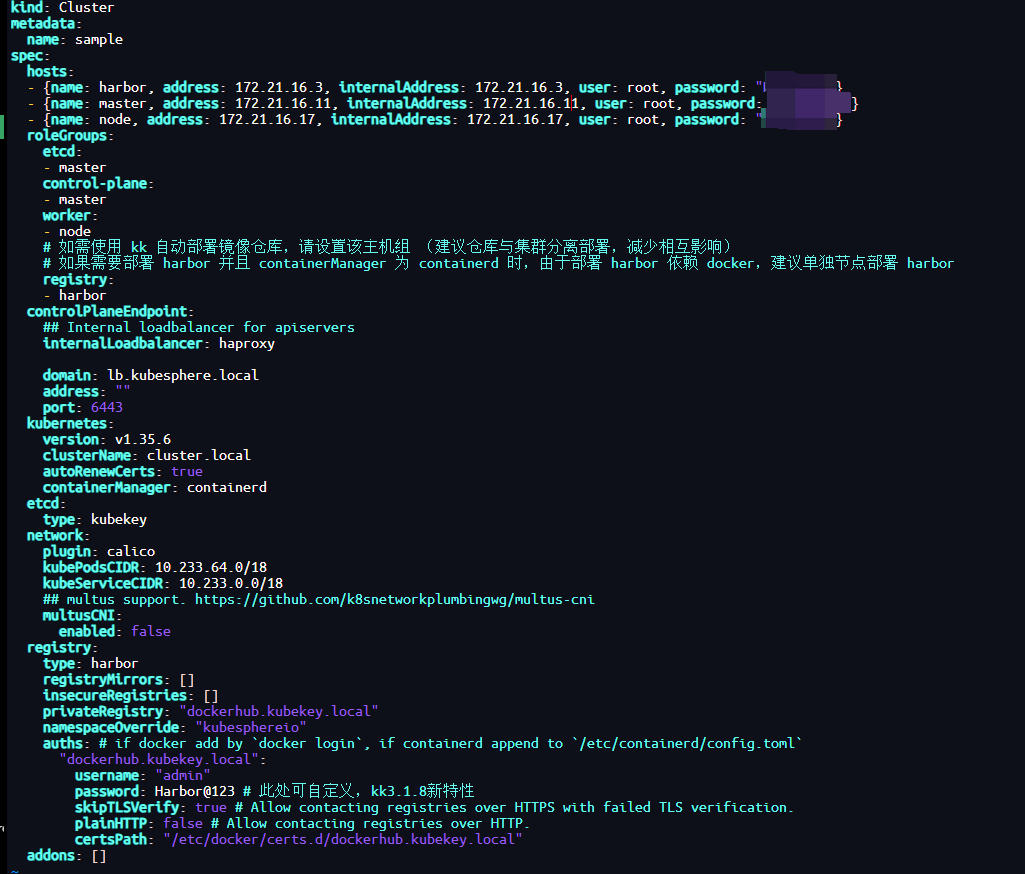
② 主机配置:网络、存储与节点角色
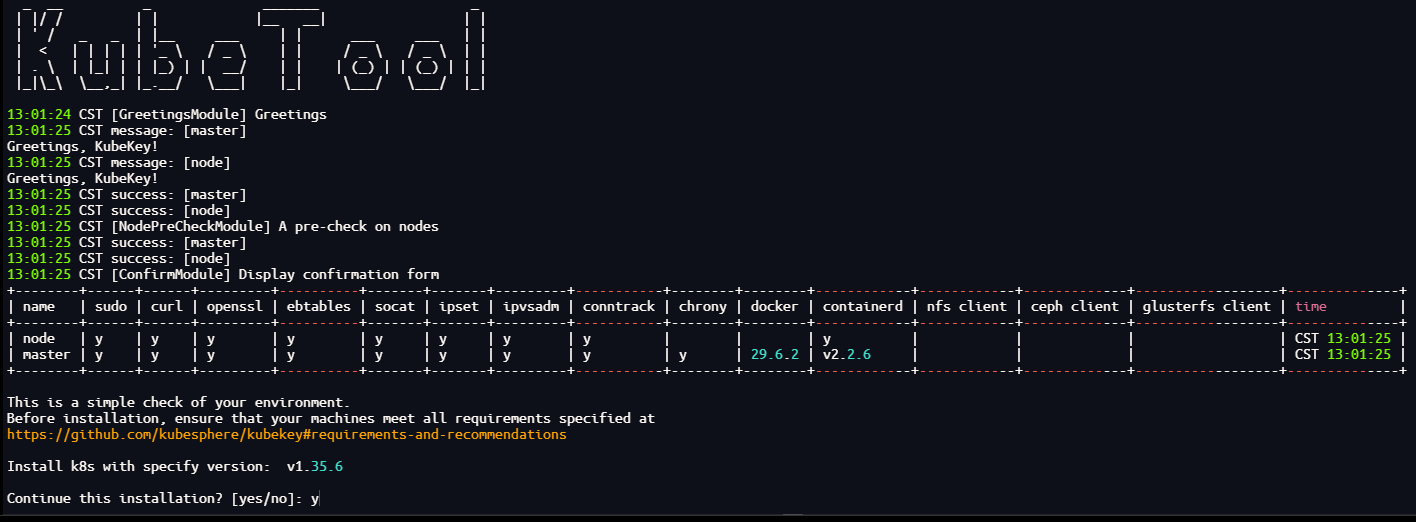
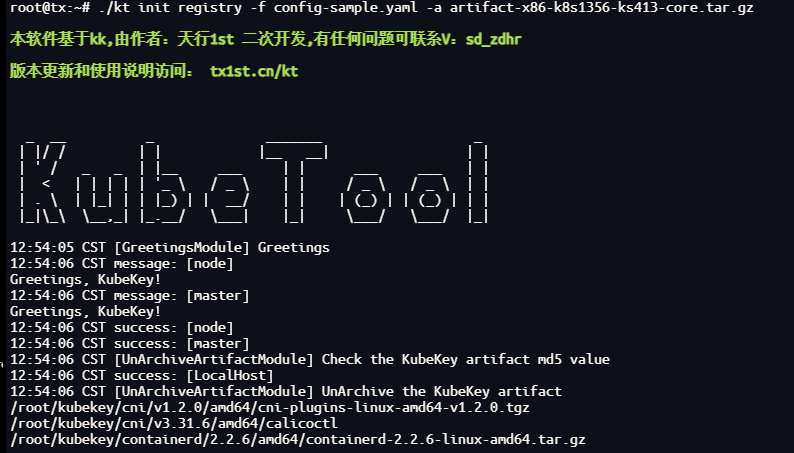
③ 部署 Kubernetes 集群(KubeKey)
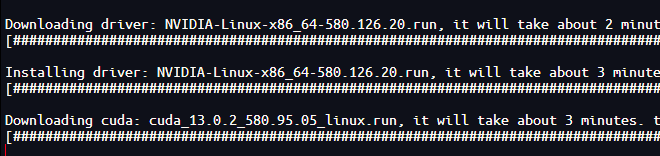
④ 安装 NVIDIA 驱动与 CUDA Toolkit
⑤ 搭建 Harbor 私有镜像仓库(离线/内网环境必备)
⑥
nvidia-smi:确认驱动 580.126.20 与 CUDA 13.0
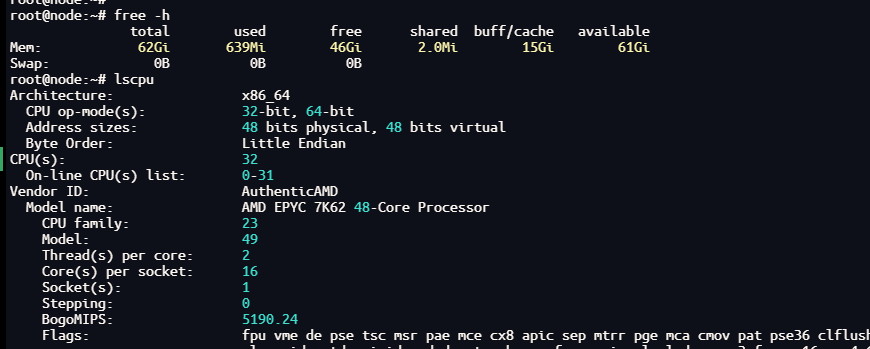
⑦ 节点资源概览:CPU 与内存
⑧ K8s 集群就绪
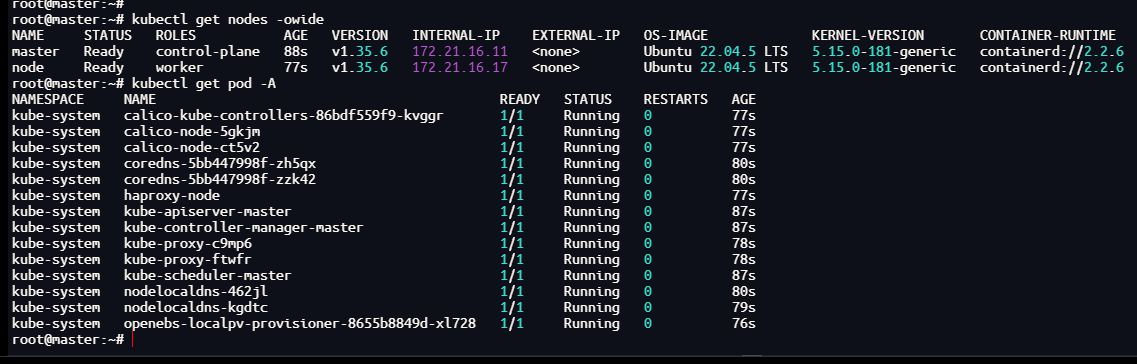
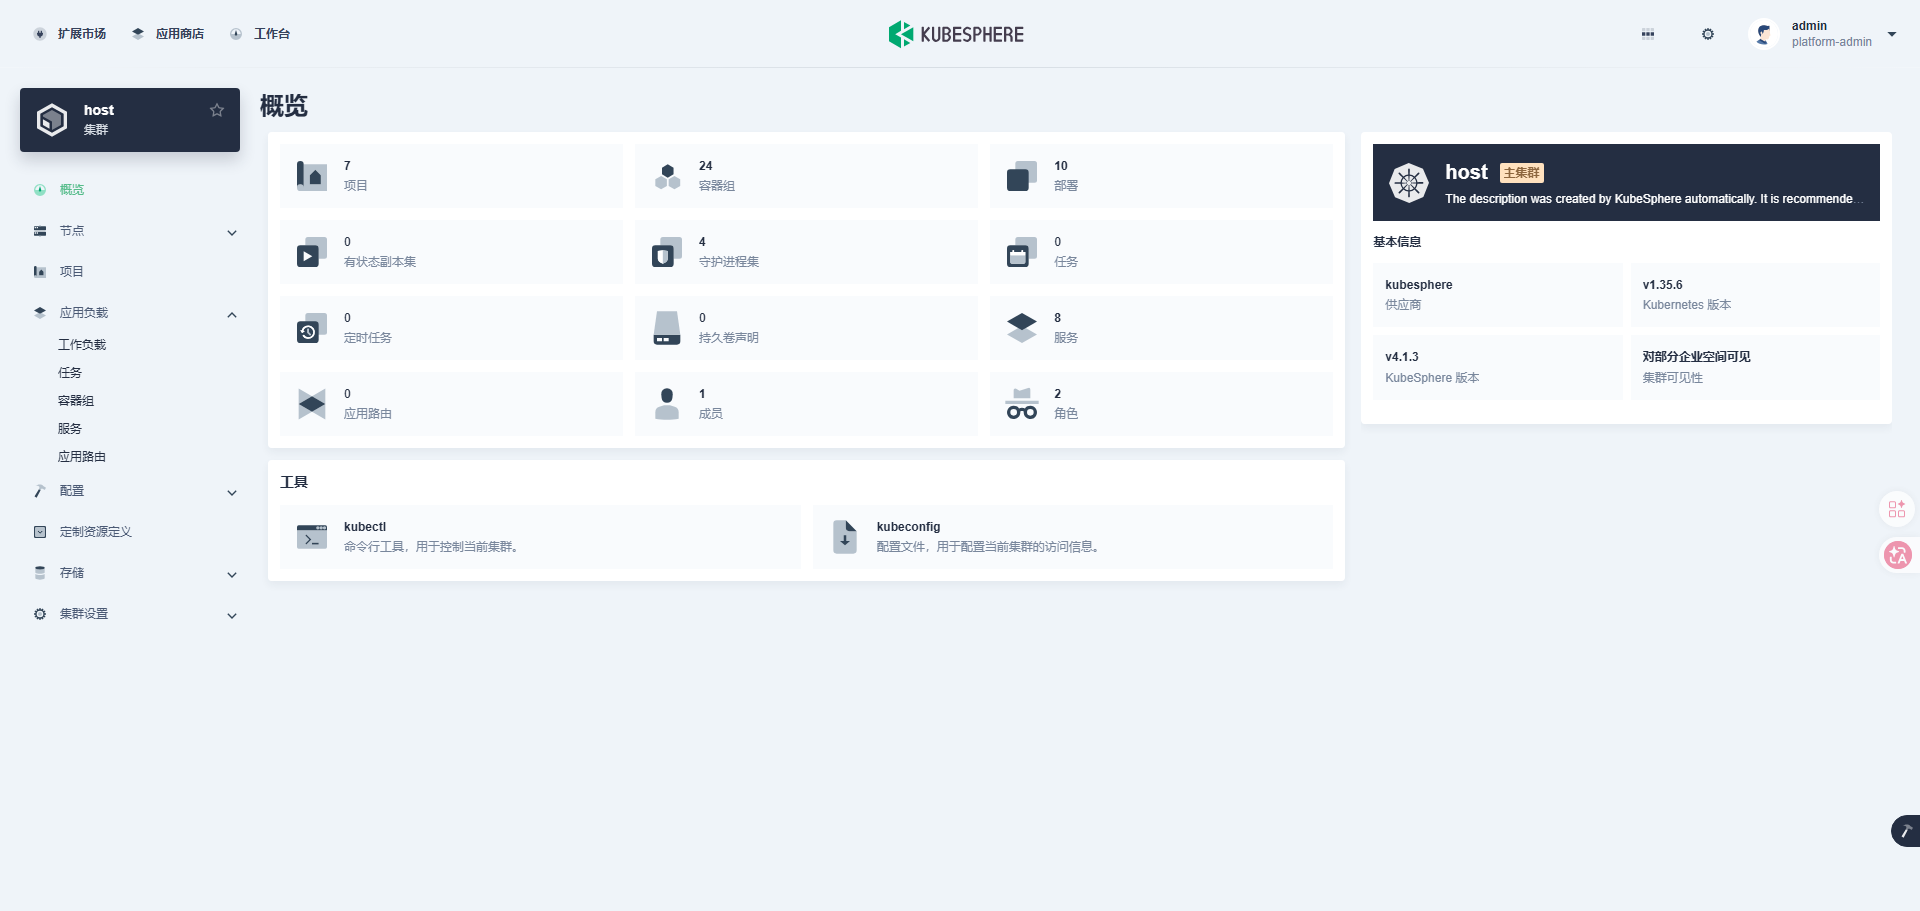
上面两张是集群部署完成的确认:节点 Ready、系统组件 Running。 至此环境就绪,后续所有操作都在 master * 上执行,不再需要登录 *GPU ** 节点手动装东西——这正是 GPU Operator 存在的意义。
环境信息
| 项 | 值 |
|---|---|
| 节点 |
master(control-plane,2 核)+
node(GPU 节点,节点名就叫
node) |
| K8s | v1.35.6(Kt 部署,集群管理 KubeSphere) |
| 容器运行时 | containerd 2.2.6 |
| OS | Ubuntu 22.04.5 LTS,内核 5.15.0-181 |
| GPU | Tesla T4, 15360 MiB** |
| 驱动 | 580.126.20( 宿主机 已装),CUDA 13.0 |
| CNI | Calico |
最终跑通的组合
GPU Operator v26.7.0  (driver.enabled=false, devicePlugin.enabled=false)
      +
HAMi v2.10.0          (scheduler.kubeScheduler.image.tag=v1.35.6,
                       devicePlugin.runtimeClassName=nvidia-legacy)
      +
节点标签 gpu=on  +  containerd 镜像加速
四、部署步骤
4.1 前置检查(别跳过,这一步决定了后面要不要装 GPU Operator)
在 GPU 节点上:
nvidia-ctk --version
grep -in nvidia /etc/containerd/config.toml
kubectl get runtimeclass
我这台三条结果分别是:
command not found、无输出、
No resources found。
说明 toolkit 没装、containerd 没配 nvidia runtime —— GPU Operator 不能省,它就是来补这一层的。
反过来也成立:如果你的宿主机已经装好了驱动 + toolkit,且 containerd 默认 runtime 已经是 nvidia, 可以完全跳过 GPU ** Operator,直接打标签装 HAMi。
4.2 给 GPU 节点打标签
kubectl label nodes node gpu=on

这个标签是给 HAMi 的 device plugin DaemonSet 用的——它靠
gpu=on 选择要部署到哪些节点。不打标签,device plugin 会一直停在 0/0 的调度状态。
4.3 装 GPU Operator:两个 enabled 必须都关
这是整个流程里最容易搞错的地方。这套环境的驱动是宿主机自带的 580.126.20,所以:
helm repo add nvidia https://helm.ngc.nvidia.com/nvidia
helm repo update
# 先看有哪些版本可选
helm search repo nvidia/gpu-operator --versions | head -10
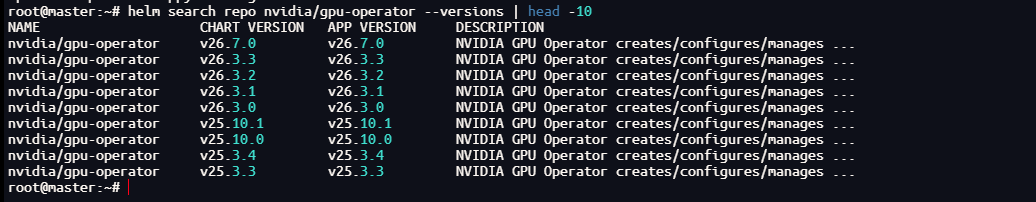
正式安装(
--version 建议显式指定,避免不同时间拉到不同版本):
helm install gpu-operator -n gpu-operator --create-namespace \
  nvidia/gpu-operator \--version=v26.7.0 \
  --set driver.enabled=false \
  --set devicePlugin.enabled=false
两个
false 各管一件事,缺一个都出事:
| 参数 | 为什么必须关 |
|---|---|
| driver.enabled=false | 别让 Operator 去装驱动,会和你云主机的 580.126.20 打架。你驱动已就绪,它不需要装 |
| devicePlugin.enabled=false | HAMi 自带 device plugin,两者都报 nvidia.com/gpu 会直接冲突,这是官方硬约束 |
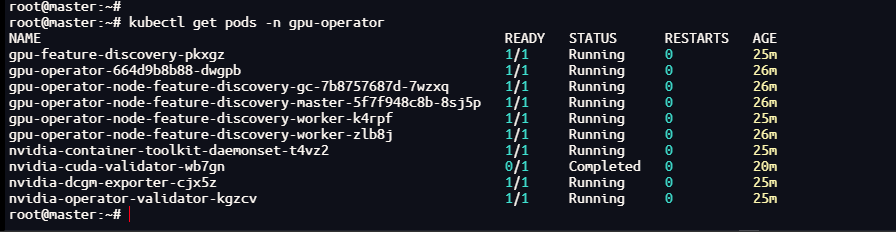
4.4 安装 HAMi
helm repo add hami-charts https://project-hami.github.io/HAMi/
helm repo update
# 先确认 scheduler 参数的真实键名(2.9.0 是嵌套的 image.tag,不是 imageTag)
helm search repo hami-charts/hami --versions | head -10
helm show values hami-charts/hami --version 2.10.0 | grep -n -A8 kubeScheduler
# 渲染出全部镜像,看有哪些拉不到
helm template hami hami-charts/hami --version 2.10.0 \
  --set scheduler.kubeScheduler.image.tag=v1.35.6 \
  | grep -oE 'image: *[^ ]+' | awk '{print $2}' | tr -d '"' | sort -u
正式安装。
注意
*
**kubeScheduler.image.tag**
必须对齐你的 K8s 版本*,否则 scheduler 起不来:
helm install hami hami-charts/hami --version 2.10.0 \
  -n hami-system --create-namespace \
  --set scheduler.kubeScheduler.image.tag=v1.35.6
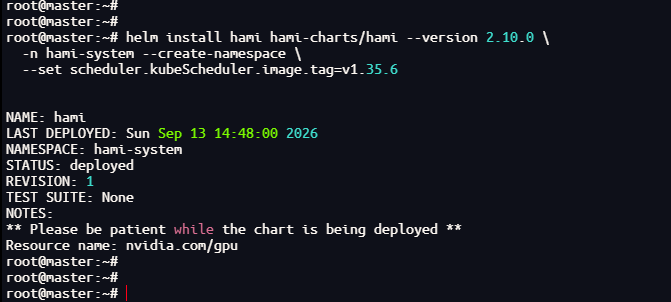
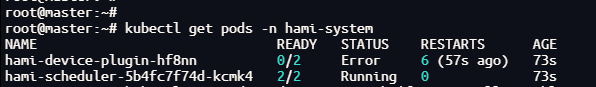
装完先看 device plugin 是否 Ready。多数情况下它会直接报错
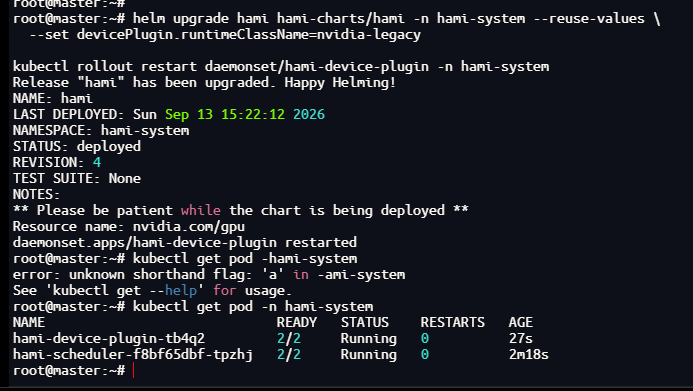
Incompatible strategy detected auto(详见 6.6),这时必须显式指定 RuntimeClass:
helm upgrade hami hami-charts/hami -n hami-system --reuse-values \
  --set devicePlugin.runtimeClassName=nvidia-legacy
kubectl rollout restart daemonset/hami-device-plugin -n hami-system
4.5 验证:allocatable 从 1 变成 10
kubectl get node node -o jsonpath='{.status.allocatable.nvidia\.com/gpu}{"\n"}'
kubectl describe nodes node
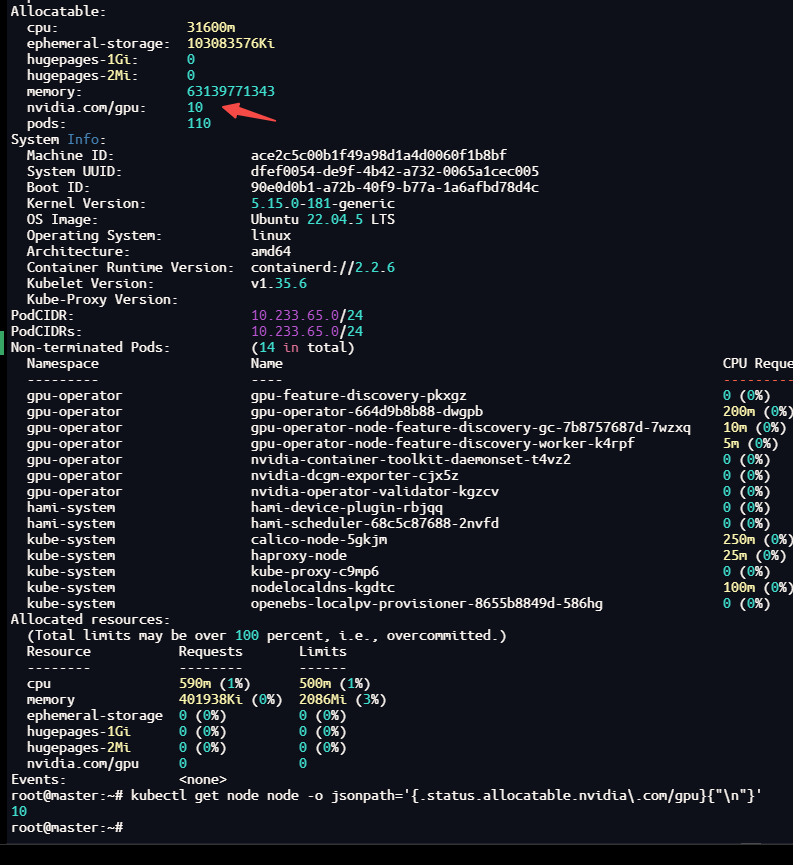
这是第一个「肉眼可见」的成功标志:
一张物理卡开始对外报 10 个可调度单位。
deviceSplitCount 默认 10,HAMi 的 device plugin 会把每张卡虚拟成 10 份上报给调度器。
如果这里
还是 1,说明 HAMi device plugin 没起来,或者它在和 GPU Operator 自带的 device plugin 抢着上报资源——回头检查 4.3 那两个
false。
五、验证:隔离到底成不成立,用四个层次证明
# HAMi vGPU 切分验证:两个 Pod 共享同一张物理 T4
---
apiVersion: v1
kind: Pod
metadata:
  name: gpu-slice-a
spec:
  schedulerName: hami-scheduler
  restartPolicy: Never
  containers:
    - name: app
      image: nvidia/cuda:12.4.1-base-ubuntu22.04
      command: ["sleep", "infinity"]
      resources:
        limits:
          nvidia.com/gpu: 1        # 1 个 vGPU 实例
          nvidia.com/gpumem: 4000  # 显存配额 4000 MiB
          nvidia.com/gpucores: 30  # 算力配额 30%
---
apiVersion: v1
kind: Pod
metadata:
  name: gpu-slice-b
spec:
  schedulerName: hami-scheduler
  restartPolicy: Never
  containers:
    - name: app
      image: nvidia/cuda:12.4.1-base-ubuntu22.04
      command: ["sleep", "infinity"]
      resources:
        limits:
          nvidia.com/gpu: 1
          nvidia.com/gpumem: 4000
          nvidia.com/gpucores: 30
kubectl apply -f hami-vgpu-test.yaml
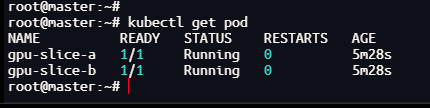
用同一份 YAML 起两个 Pod,各申请 1 个 vGPU、4000MiB 显存、30% 算力。起好之后按下面四层顺序验证——前三层只能证明「看起来隔离了」,第四层才真正证明「确实拦得住」。
L1 · 共卡:两个 Pod 拿到的是同一张卡
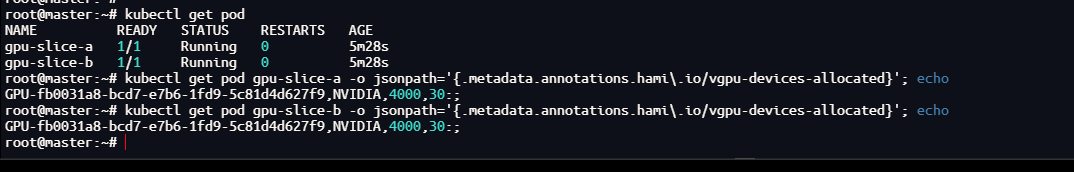
两个 Pod 拿到的 GPU UUID 完全一致——它们确实挤在同一张物理 T4 上。注意注解里还带着各自的资源额度。
L2 · 视图隔离:容器里只看到自己的 4GB
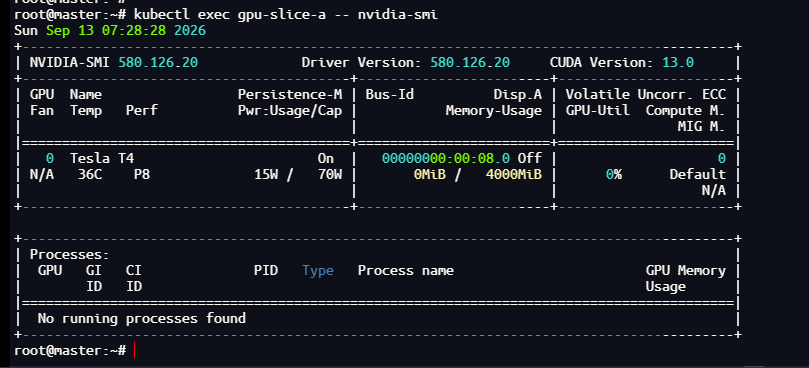
容器内的显存上限显示为 4096 MiB,而不是物理卡的 15360MiB——从这一刻起,它以为自己独占一张 4G 的卡。
L3 · 配额注入:容器内的环境变量证据
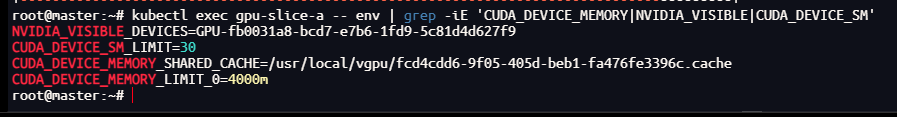
HAMi 注入的两个关键环境变量:
CUDA_DEVICE_MEMORY_LIMIT_0=4000m(显存上限)与
CUDA_DEVICE_SM_LIMIT=30(算力上限),HAMi Core 就是照着这两个值做拦截的。
L4 · 运行时隔离:超额时真的会被拦住吗
前三层证明的是「看起来隔离了」,这一层要证明的是「程序真的申请不到多余的显存」。
不需要 nvcc 和编译器,
base 镜像里自带
libcudart.so.12,装个 python3 用 ctypes 直接调
cudaMalloc,做一次逐档扫描:
kubectl exec gpu-slice-a -- bash -c 'apt-get update -qq && apt-get install -y -qq python3'
kubectl exec gpu-slice-a -- python3 -c '
import ctypes
c = ctypes.CDLL("libcudart.so.12")
for g in (2, 3, 3.8, 4.0, 4.5, 6):
    p = ctypes.c_void_p()
    err = c.cudaMalloc(ctypes.byref(p), ctypes.c_size_t(int(g*1024*1024*1024)))
    print("cudaMalloc %.1f GiB -> errcode=%d  %s" % (g, err, "OK" if err==0 else "OOM"))
    if err == 0:
        c.cudaFree(p)
'
实测输出:
[HAMI-core ERROR (pid:479 allocator.c:52)]: Device 0 OOM 4401922048 / 4194304000
[HAMI-core ERROR (pid:479 allocator.c:52)]: Device 0 OOM 4938792960 / 4194304000
cudaMalloc 2.0 GiB -> errcode=0  OK
cudaMalloc 3.0 GiB -> errcode=0  OK
cudaMalloc 3.8 GiB -> errcode=0  OK
cudaMalloc 4.0 GiB -> errcode=2  OOM
cudaMalloc 4.5 GiB -> errcode=2  OOM
cudaMalloc 6.0 GiB -> errcode=2  OOM
分界线干净得不像话: 3.8GiB 通过,4.0GiB 拒绝。
更有意思的是把 HAMi 日志里的数字拆开算。日志格式是
Device 0 OOM <已用 + 本次请求> / <配额字节>:
| 申请量 | 请求字节 | 固定开销 | HAMi 报出的数 |
|---|---|---|---|
| 4.0 GiB | 4294967296 | +106954752 | 4401922048 ✅ 吻合 |
| 4.5 GiB | 4831838208 | +106954752 | 4938792960 ✅ 吻合 |
| 6.0 GiB | 6442450944 | +106954752 | 6549405696 ✅ 吻合 |
那个固定开销
106954752 字节 =
102 MiB
*,正是 *CUDA
** context 自身的常驻占用。它也被 HAMi 计进了「已用」——因为拦截点在
cuMemAlloc 这一层,创建 context 时的分配同样走这条路径。
于是边界可以被精确算出来,判定式是
102 MiB + 本次请求 > 4000 MiB:
| 申请 | 折算 MiB | 加 102MiB 后 | 余量 | 结果 |
|---|---|---|---|---|
| 3.8 GiB | 3891.2 | 3993.2 | +6.8 MiB** | OK(惊险通过) |
| 4.0 GiB | 4096 | 4198 | −198 MiB | OOM |
一个反直觉但很实用的结论 :申请 4000MiB 的配额,用户实际能 malloc 到的大约是 3898 MiB(≈3.807 GiB) ,不是名义的 4000MiB。给别人配配额时记得留这 102MiB 的余量。
顺带解答一个疑点:OOM 日志打印在结果
之前,不是时序错乱——HAMi-core 写的是 stderr(无缓冲),
print 写的是 stdout(有缓冲,进程退出时才 flush)。
决定性的一击:6GiB = 6144MiB,而
物理 T4 有 15360MiB。没有 HAMi 的话闭着眼睛都能分到,这里却返回
errcode=2。此刻物理卡几乎全空,却分配失败——这一条就证明限制来自 HAMi,而不是硬件。
六、踩坑清单
部署本身只有几条命令,真正耗时间的是下面这些。每一条都按「现象 → 根因 → 解法」记,顺序基本就是实际踩中的顺序。
6.1 NFD 拉不到镜像 → 整条链路的死结
现象:GPU Operator 主控 Pod 已经 Running,但
node-feature-discovery 全家
ImagePullBackOff。
为什么它是
死结:GPU Operator 的部署链路是「NFD 检测到 NVIDIA 硬件 → 打上
nvidia.com/gpu.present 标签 → 各组件 DaemonSet 靠这个标签选节点部署」。NFD 挂掉,标签就不存在,
nvidia-container-toolkit-daemonset
根本不会被创建,containerd 里永远没有 nvidia runtime。
迷惑点在于:
kubectl get pods -n gpu-operator 里
完全看不到 toolkit daemonset —— 不是它还在启动,是压根没被创建。
根因:
registry.k8s.io 不可达,报错打到
europe-west3-docker.pkg.dev 超时。
6.2 containerd 的镜像加速配了却不生效
containerd 的镜像加速机制是
/etc/containerd/certs.d/<registry>/hosts.toml:
server = "https://registry.k8s.io"
[host."https://k8s.tencentcloudcr.com"]
  capabilities = ["pull", "resolve"]
这个文件是热加载的,写完即生效,连 containerd 都不用
重启——它就是 containerd 版的
daemon.json。多出来的只有一步:要在
config.toml 里用
config_path 告诉 containerd「去这个目录找 hosts.toml」。
问题就出在这一步。
第一次配置:文件写对了、语法合法、containerd 正常启动,但 mirror 就是不用,报错和配之前一字不差。根因是版本键不匹配:
| containerd 版本 | 配置键 |
|---|---|
1.x(
version = 2) |
[plugins."io.containerd.grpc.v1.cri".registry] |
2.x(
version = 3) |
[plugins."io.containerd.cri.v1.images".registry] |
我的 config.toml 是 1.x 格式,加的却是 2.x 的键。containerd 官方迁移文档说得很难听:硬编码旧插件路径的配置文件「 will not apply the settings you think it does」,而最先崩的「 就是配了自定义 registry mirror 的集群」。
判断生效与否,唯一可靠的手段是
**<font style="background-color:rgb(240,251,239);">containerd config dump</font>**
——它输出的是合并后的
生效值
,不是文件里写了什么。
<font style="background-color:rgb(240,251,239);">containerd config dump | grep -nE 'config_path|sandbox'</font>
同类小坑还有三个:
-
config_path写成 冒号分隔的多路径会被静默忽略(containerd config default生成的恰恰就是/etc/containerd/certs.d:/etc/docker/certs.d),必须是单路径。 - containerd 2.1+ 拉取默认走 Transfer Service,它对 registry 配置的支持面比老路径窄。
- GPU Operator 的 toolkit 会往
/etc/containerd/conf.d/99-nvidia.toml写覆盖配置并通过imports架空主配置—— 装完 GPU Operator 必须复查一次。
6.3 配置脚本把 containerd 搞挂了
现象:第二次跑配置脚本后 containerd 启动失败,节点直接掉线。
根因:TOML 不允许同一张表定义两次,而脚本因为正则在复制粘贴过程中失真,每次都判定「段不存在」并追加一遍,于是文件里出现了两个一模一样的
[plugins...registry] 表头。
两条教训:
- 给「复制粘贴到终端执行」用的脚本,
绝对不要包含
*
**\[****\]****\.**这类反斜杠转义*——聊天窗口 → 剪贴板 → 终端这条链路会吞掉反斜杠。需要匹配特殊字符就用line.strip() == "..."这种纯字符串比较。 - 改配置必须先校验、后 重启 ,并带自动回滚。 有这道保护,那次根本不会挂。
恢复只要一条:用脚本自动备份的
config.toml.bak.<时间戳> 覆盖回去,再重启 containerd。
6.4 pause 沙箱镜像:helm 管不到的那一层
现象:toolkit 配好 nvidia runtime 之后,Pod 卡在
failed to get sandbox image "registry.k8s.io/pause:3.10.1"。
镜像拉取其实分三层, helm 只能管到第一层:
| 层 | 谁能控制 | 举例 |
|---|---|---|
| A. chart manifest 里的容器镜像 | helm values /
--post-renderer |
nvcr.io/nvidia/k8s/... |
| B. pause / sandbox_image | 只有 containerd config.toml 能改,helm 完全管不到 |
registry.k8s.io/pause:3.10.1 |
| C. 后续未预见的镜像 | 只有 containerd 层 mirror 能兜 | 后装的 HAMi、Prometheus 等 |
所以
只改 helm 永远解决不了 B 层。要么把
sandbox_image 指向可达地址,要么老实把 containerd 的 mirror 配好。
6.5 HAMi device plugin 起不来:
Incompatible strategy detected auto
现象:
hami-device-plugin 0/2 Error,
hami-scheduler 正常。
factory.go:135] Incompatible strategy detected auto
factory.go:136] If this is a GPU node, did you configure the NVIDIA Container Toolkit?
main.go:201] error starting plugins: ... invalid device discovery strategy
那句「did you configure the NVIDIA Container Toolkit?」是 误导性的——toolkit 明明是 Running 的。
真正根因(HAMi 官方排障手册原文):从 GPU Operator 25.10.0 起 CDI 默认开启,Operator
不再把
*
**nvidia**
设为默认 runtime
;通过
NVIDIA_VISIBLE_DEVICES 访问 GPU 的管理容器
必须显式使用
runtimeClassName: nvidia,而 HAMi Device Plugin 就属于此类管理容器*。
我装的是 v26.7.0,正是 CDI 模式。
runc 仍是 containerd 默认 runtime → HAMi device plugin 没走 NVIDIA runtime hook → 容器里没有驱动库、没有
/dev/nvidia* → NVML 初始化失败。
helm upgrade hami hami-charts/hami -n hami-system --reuse-values \
  --set devicePlugin.runtimeClassName=nvidia
kubectl rollout restart daemonset/hami-device-plugin -n hami-system
6.6 业务 Pod 起不来:
unresolvable CDI devices
上一节的
nvidia RuntimeClass 救了 device plugin,却
把问题转移给了业务 Pod**:
failed to inject CDI devices: unresolvable CDI devices
  management.nvidia.com/gpu=GPU-fb0031a8-bcd7-e7b6-1fd9-5c81d4d627f9
原因写在 HAMi 官方手册里:
「HAMi chart 会把 _
_devicePlugin.runtimeClassName_ 同时应用到 Device Plugin
*和被 HAMi scheduler 改写的业务负载*」_。也就是说业务 Pod 也被注入了同一个 RuntimeClass。
而这个
nvidia RuntimeClass 在 GPU Operator 26.7 下走 CDI 注入,去找
management.nvidia.com/gpu=<UUID> 这个 CDI 设备类。上节点一查:
ls -l /etc/cdi/ /var/run/cdi/
# 两个目录都不存在
节点上压根没生成任何 CDI spec**,注入必然失败。
修法:换成
nvidia-legacy(这也正是 4.4 里那次 upgrade 做的事)。它走老的 nvidia-container-runtime hook +
NVIDIA_VISIBLE_DEVICES 环境变量注入,
完全不依赖 CDI,而 HAMi 默认的
deviceListStrategy 恰好就是
envvar,天生匹配。
备选方案是关掉 GPU Operator 的 CDI(
kubectl patch clusterpolicies.nvidia.com/cluster-policy ... /spec/cdi/enabled=false),但会触发 Operator 重新配置 containerd,影响面大得多。
6.7 Pending 的 Pod 会「幽灵占用」GPU 配额
这是本次
最意外的发现。起了 8 个
gpucores: 5 的 Pod,只有 4 个 Running,其余全 Pending,报
1 1/1 CardInsufficientCore。算笔账:
| Pod | 算力 | 状态 |
|---|---|---|
| gpu-slice-a | 30% | Running |
| gpu-slice-b | 30% | Running |
| gpu-oom-test | 20% | ImagePullBackOff,但配额已占 |
| gpu-fill-3 ~ 6 | 5% × 4 = 20% | Running |
| 小计 | 100% | 卡满 |
100%,一分不差。 那个 ImagePullBackOff 的 Pod 容器根本没起来,但 HAMi 在 Bind 阶段就已经把配额扣给它了。
运维要点 :HAMi 环境下遇到「明明没几个 Pod 在跑,为什么新 Pod 调度不进去」,第一个要看的就是 有没有卡住的 Pod 。Pending / ImagePullBackOff / CrashLoop 状态的 Pod 会一直占着 GPU 配额不释放,删掉即释放。
七、原理:HAMi 到底是怎么做到的
四个组件的分工
| 组件 | 位置 | 职责 |
|---|---|---|
| Mutating Webhook | Master | 拦截 Pod 创建,识别 GPU 请求,把
schedulerName 改成
hami-scheduler,补全资源声明 |
| HAMi Scheduler | Master | 挂成 kube-scheduler 的 extender。 Filter 判断有没有满足显存 / 算力的卡; Score 决定 binpack 还是 spread; Bind 把「用哪张卡、多少显存、多少算力」写回 Pod 注解 |
| Device Plugin | GPU 节点 DaemonSet | 把 1 张物理卡虚拟成 N 个可调度单位,并把每张卡的明细写进节点注解 |
| HAMi Core | 业务容器内 | 真正执行隔离。
*它不是进程,是挂进容器的 *
**libvgpu.so** |
关键在于: 调度阶段和运行阶段是两件事。Scheduler 决定「分配多少」,HAMi Core 负责「真的只能用到这么多」。前者不管执行,后者不参与决策——这种解耦也是它能兼容原生 K8s 的原因。
注入机制
libvgpu.so 通过 Linux 的
/etc/ld.so.preload 加载——动态链接器在任何进程启动时都会优先加载它,效果等同
LD_PRELOAD,但对容器内
所有进程透明生效,既不用改环境变量,也不用改业务代码。
加载之后只做一件事:
重写
*
**dlsym**
,劫持所有以
**cu** 和
**nvml** 开头的函数符号*。所有 CUDA 调用都得先过它这一关。
显存隔离:两个动作缺一不可
| 动作 | 拦截目标 | 作用 |
|---|---|---|
| 改上报值 |
nvmlDeviceGetMemoryInfo /
_v2 |
让
nvidia-smi 只看到配额——
骗眼睛 |
| 拦分配 |
cuMemAlloc_v2 /
cuMemAllocManaged |
分配前算「已用 + 本次 > 配额?」,超了返回
CUDA_ERROR_OUT_OF_MEMORY——
真拦路 |
只做第一条,程序照样能把显存分配爆;只做第二条,
nvidia-smi 显示的数字会误导业务代码自己算余量。
两条合起来才有效,这也是为什么 L2(看得见)和 L4(拦得住)要分开验证。
算力隔离:一个令牌桶,不是硬件限速
- 全局计数器
g_cur_cuda_cores,初值 = 配额(30% → 30 个 token) - 每次
cuLaun提交时,按本次 kernel 的 grid * 数量*扣 token - token 扣成负数 → 当前调用
自旋
等待(
nanosleep),这就是「限速」真正发生的时刻 - 后台
utilization watcher线程采样真实 GPU 利用率,用delta()动态把 token 补回来
八、先说清楚它的局限
这套方案好用,但不能吹过头。上线前必须知道它的边界在哪:
算力 隔离是「软限速」,不是硬隔离。
- 限流粒度绑定在 kernel 提交时刻 。如果提交的都是超长 kernel(一次跑几秒),token 只在提交那一瞬间扣一次,限速就会失准——压测中看到的抖动和突刺就是这么来的。
-
可以被绕过
:静态链接 CUDA 的程序(不走 ld.so.preload)、直接 ioctl 操作
<font style="background-color:rgb(255,245,235);">/dev/nvidia*</font>、或设置<font style="background-color:rgb(255,245,235);">CUDA_DISABLE_CONTROL=true</font>。 - 所以它是 「多租户防误伤」级别的隔离,不是安全边界 。同一张卡上不要混放不同信任级别的租户。
显存 隔离也不是完美的:如实测所见,CUDA context 的 102MiB 会被计入配额,实际可用略小于名义值,配配额时要留余量。
另外 HAMi 管不了 PCIe * 带宽、 NVLink* 带宽以及 **显存 带宽的争抢——同一张卡上的邻居如果疯狂刷显存带宽,你的实际性能仍然会掉。这是所有软件切分方案的共同短板,MIG 之所以强,就在于它连这些也一起隔了。
九、总结
最终跑通的最小命令集
# 1. GPU Operator:关掉 driver 和 devicePlugin,只借它的 toolkit
helm install gpu-operator -n gpu-operator --create-namespace nvidia/gpu-operator \
  --version=v26.7.0 \
  --set driver.enabled=false \
  --set devicePlugin.enabled=false
# 2. 节点标签
kubectl label nodes <gpu-node> gpu=on
# 3. HAMi:scheduler 镜像 tag 必须对齐 K8s 版本
helm install hami hami-charts/hami --version 2.10.0 \
  -n hami-system --create-namespace \
  --set scheduler.kubeScheduler.image.tag=<你的K8s版本> \
  --set devicePlugin.runtimeClassName=nvidia-legacy
一张表看懂变化
| 对比项 | 原生 K8s | 加 HAMi 之后 |
|---|---|---|
| 一张 T4 能给几个 Pod | 1 | 9(实测) |
| 调度依据 | 整数槽位 | 显存 + 算力 双维度连续量 |
| 超额请求 | 起来之后 OOM | 调度阶段直接拒绝 |
| 容器可见显存 | 全量 15360MiB | 各自配额(4000MiB) |
| 邻居 OOM 的影响 | — | 互不影响(实测) |
四条经验
-
先做前置检查再决定装什么。
nvidia-ctk --version和kubectl get runtimeclass两条命令,决定了 GPU Operator 是必需品还是多余的负担。 - 版本对齐是隐形成本。 containerd 1.x/2.x 配置键、GPU Operator 25.10 的 CDI 默认开关、HAMi 的 kubeScheduler 镜像 tag——三个地方的版本错配,贡献了本次一半的排查时间。
-
判断配置是否生效,永远看运行时 dump,不看文件内容。
containerd config dump这一条原则,能省掉大量「明明配了却没用」的困惑。 - 验证要分层。 「能跑起来」「看起来隔离了」「真的拦得住」「炸了不影响邻居」是四件事,只做前两层的话,上线后照样会翻车。
附:常用诊断命令
# 节点上 GPU 的真实用量明细(调度器 Filter 读的就是这份)
kubectl get node <node> -o jsonpath='{.metadata.annotations.hami\.io/node-nvidia-register}'
# 可调度槽位数(应为 物理卡数 × deviceSplitCount)
kubectl get node <node> -o jsonpath='{.status.allocatable.nvidia\.com/gpu}'
# 某个 Pod 被分到了哪张卡、多少额度
kubectl get pod <pod> -o jsonpath='{.metadata.annotations.hami\.io/vgpu-devices-allocated}'
# 容器内配额视角
kubectl exec <pod> -- nvidia-smi
kubectl exec <pod> -- env | grep CUDA_DEVICE
# containerd 生效配置(不是文件内容)
containerd config dump | grep -nE 'config_path|sandbox'
# RuntimeClass 现状
kubectl get runtimeclass
# 手动预拉镜像(绕开 kubelet 的 pull deadline)
ctr -n k8s.io images pull --hosts-dir=/etc/containerd/certs.d <image>
如果这篇对你有帮助,欢迎转发给同样在折腾 GPU 利用率的朋友。有问题可以在评论区交流,踩到新的坑我也会继续补充进来。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70050990/viewspace-3182599/ ,如需转载,请注明出处,否则将追究法律责任。

