“本文以“概念-交互-开发”的递进逻辑,通过通俗易懂的语言系统拆解生成式AI从理论到落地的核心脉络,提供了从基础到高级的全链路指南”
01
—
生成式AI概述
1.1 生成式AI的基本概念
通俗解释:生成式AI与传统AI的最大区别在于“创造”能力。传统AI主要是“识别”和“分类”——比如识别图片中的猫、分类邮件是否为垃圾邮件。而生成式AI则是“创造”新内容——比如写一篇文章、画一幅画、创作一段音乐。
关键技术概念:
大型语言模型(LLM):可以理解为“超级文本预测器”。它通过分析海量文本数据,学会了语言的规律和知识,能够根据前面的文字预测后面的文字。
Transformer架构:这是现代大模型的“大脑结构”,通过自注意力机制让模型能够理解长文本中的复杂关系。
提示工程(Prompt Engineering):与AI“对话”的艺术。就像给一个很聪明但需要明确指令的助手下达任务,提示词的质量直接影响AI的输出质量。
1.2 生成式AI的应用场景
生成式AI在企业级应用中的多种场景:
内容创作:自动生成营销文案、技术文档、产品描述
代码辅助:智能代码补全、bug修复、代码重构
客户服务:智能客服、个性化推荐
数据分析:自动生成报告、数据可视化解释
教育培训:个性化学习材料、智能答疑
1.3 开发挑战与应对策略
对于程序员和架构师而言,开发生成式AI应用面临的主要挑战包括:
成本控制:API调用成本、算力资源消耗
响应延迟:实时性要求高的场景需要优化
输出稳定性:如何确保AI输出的可靠性和一致性
安全合规:内容过滤、数据隐私、版权问题
02
—
会话编程:与AI的交互方式
2.1 基础API调用
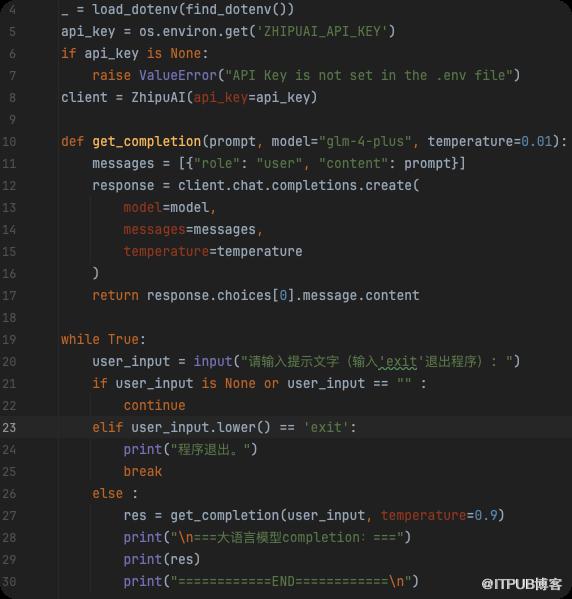
通俗解释:会话编程就是让程序能够与AI模型“对话”。这就像给你的应用增加了一个“智能大脑”,可以通过API接口向这个大脑提问并获取回答。
关键技术点:
API密钥管理:安全地存储和使用AI服务的访问凭证
请求参数配置:温度(temperature)、最大令牌数(max_tokens)、top_p等参数对输出质量的影响
错误处理:网络超时、API限流、服务不可用等异常情况的处理策略
以Python代码举例如下:
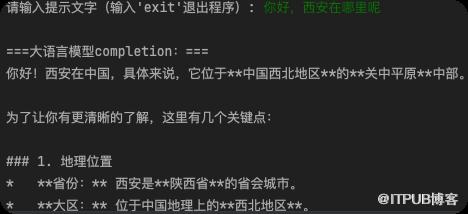
运行的结果如下:
关于get_completion各个参数的说明如下

2.2 提示词工程实践:与AI高效沟通的艺术
通俗解释:提示词就是给AI的“任务说明书”。好的提示词能让AI准确理解你的意图,差的提示词可能导致答非所问。
实用技巧:
角色设定:明确告诉AI它应该扮演什么角色(如“你是一个资深Java架构师”)
任务分解:复杂任务拆分成多个简单步骤
示例引导:提供输入输出的例子(few-shot learning)
格式约束:明确要求输出格式(JSON、Markdown、表格等)
如果说LLM是一个能力强大但需要明确指令的助手,那么提示工程就是清晰传达指令的技能集。
基础提示构造原则:
明确性高于简洁性:宁可提示过长、过详细,也不要因为追求简洁而留下歧义空间。例如,“总结这篇文章”是模糊的,“用三段话总结这篇文章的核心论点,每段不超过100字,专注于技术影响而非历史背景”则明确得多。
提供充足上下文:AI没有常识记忆,所有必要信息都应该在提示中明确提供。如果任务涉及特定领域知识,最好在提示中简要说明相关概念。
结构化输出要求:明确指定期望的输出格式。例如,“请以JSON格式返回,包含title、summary、keywords三个字段”比“返回标题、摘要和关键词”更易于程序化处理。
高级提示设计模式:
角色扮演提示:通过让AI扮演特定角色来引导其思维方式。例如,“你是一位有10年经验的Java架构师,正在评审代码质量…”比直接提问往往能获得更专业的回答。
思维链提示:对于复杂推理问题,在提示中明确要求AI展示思考步骤。例如,“请分步解决这个数学问题,先列出已知条件,再解释解题思路,最后给出答案。”这种方法不仅提高答案准确性,也便于人类理解AI的推理过程。
少样本学习提示:在提示中提供几个输入-输出示例,让AI通过类比学习任务要求。这种技巧特别适合格式转换、数据提取等结构化任务。
提示工程的系统化方法:
提示工程不应是随意尝试,而应有系统化方法:
任务分析阶段:明确任务本质是什么(是创造性生成、信息提取、逻辑推理还是格式转换?)
约束定义阶段:确定输出的必要约束条件(长度、格式、风格、禁忌内容等)
原型设计阶段:设计几个不同版本的提示进行对比测试
评估优化阶段:建立评估标准(相关性、准确性、流畅度等),基于反馈迭代优化提示
一个容易被忽视但至关重要的观点是:优秀的提示工程不是一次性活动,而是持续优化过程。随着对模型特性理解的深入和业务需求的变化,提示需要定期复审和更新。
2.3 上下文管理
通俗解释:让AI记住之前的对话内容。就像人与人聊天,如果对方每句话都忘记前面说了什么,对话就无法进行。
实现方式:
对话历史维护:在请求中携带之前的对话记录
上下文窗口限制:不同模型有不同长度的上下文限制(如4K、8K、32K tokens)
摘要压缩:长对话时自动生成摘要,节省token消耗
03
—
函数调用
3.1 函数调用的基本原理
通俗解释:让AI不仅能“说”,还能“做”。通过函数调用,AI可以触发外部系统的操作,比如查询数据库、调用第三方API、执行计算任务。
工作流程:
AI分析用户请求,判断是否需要调用外部函数
如果需要,AI返回函数调用请求(包含函数名和参数)
应用程序执行该函数,获取结果
将结果返回给AI,AI基于结果生成最终回复
3.2 本地函数集成
示例场景:开发一个加法计算器应用

函数的使用

3.3 数据库访问集成
实现方式与本地函数集成类似,把本地调用改成基于SQL语句的函数调用即可。
架构设计考虑:
安全性:AI只能访问授权的数据和操作
性能:避免复杂的联表查询导致响应延迟
可维护性:函数接口设计要清晰、稳定
3.4 第三方API集成
最佳实践:
API封装:将第三方API封装成统一的函数接口
错误处理:处理API调用失败、超时、限流等情况
结果标准化:将不同API的返回格式统一处理
04
—
生成式AI编程模式
4.1 思维链(Chain of Thought)模式深入解析:
思维链的核心价值在于提高AI推理的透明度和准确性。当AI被要求“展示思考过程”时,它被迫将隐含的推理步骤显式化,这有助于:
减少跳跃性错误:AI必须一步步推理,而不是直接从问题跳到答案,减少了逻辑跳跃导致的错误
便于人类验证:开发者可以检查AI的推理链条,定位错误发生的具体环节
支持中间干预:在多步骤任务中,人类可以在关键决策点进行干预或纠正
思维链在复杂问题解决中的实际应用框架:
问题:如果小明每天存10元,妈妈每周额外给他50元,他需要多少天才能存够1000元?AI思维链:1. 计算每日存款:每天自己存10元2. 计算每周额外收入:妈妈每周给50元,相当于每天约50/7≈7.14元3. 计算每日总收入:10 + 7.14 = 17.14元4. 计算所需天数:1000 ÷ 17.14 ≈ 58.4天5. 取整:需要59天(因为天数必须是整数)答案:需要59天
这种显式推理不仅提高了答案的可信度,也提供了教育价值——用户可以看到问题是如何解决的。
4.2 思维树(Tree of Thought)模式的战略价值:
思维树是思维链的自然扩展,它承认复杂问题通常有多种解决路径。思维树模式要求AI:
生成多个候选方案:针对问题提出不同的解决思路
并行评估各方案:分析每个方案的可行性和优缺点
选择最优路径:基于评估结果选择最佳方案或方案组合
必要时回溯:如果选定的路径遇到障碍,回溯到决策点选择其他路径
这种模式特别适合开放性的创意任务或复杂的决策问题。例如,当AI被要求“设计一个吸引年轻人的社交媒体营销活动”时,思维树模式可以让它生成多个创意方向(短视频挑战、网红合作、用户生成内容竞赛等),分别评估每个方向的预期效果和实现成本,然后综合选择或组合出最终方案。
4.3 蜂巢模式(Hive Mind)的分布式智能体架构:
蜂巢模式代表了AI应用架构的前沿方向:不再依赖单一的通用大模型,而是构建由多个专业化智能体组成的协作系统。每个智能体都是针对特定任务优化的AI模块,它们通过标准化的通信协议协作解决复杂问题。
蜂巢架构包含以下核心组件:
任务分解器:接收用户请求,将其分解为多个子任务
专家智能体池:包含各种专业智能体(文案专家、数据分析师、代码工程师、设计师等)
协调管理器:分配子任务给合适的智能体,协调它们的工作流程
结果聚合器:整合各智能体的输出,生成统一的最终结果
这种架构的优势显而易见:
专业化优势:每个智能体可以在特定领域达到比通用模型更高的专业水平
成本效率:可以为不同任务选择不同规模的模型,避免“杀鸡用牛刀”
系统弹性:单个智能体失败不会导致整个系统崩溃
持续进化:可以独立更新或替换特定智能体,无需重建整个系统
蜂巢模式的典型应用包括:
智能客服升级:路由智能体将问题分类,分别交给产品咨询、技术支持、投诉处理等专业智能体处理
内容创作工厂:选题智能体生成创意,研究智能体收集资料,写作智能体撰写初稿,编辑智能体优化润色
数据分析平台:查询解析智能体理解用户需求,数据提取智能体获取相关数据,分析智能体进行计算,可视化智能体生成图表,解释智能体用自然语言说明洞察
4.4 组合模式的模块化设计哲学:
组合模式强调将AI能力封装为标准化、可重用的模块,通过灵活组合这些模块构建复杂应用。这种思想与软件工程中的微服务架构和组件化设计一脉相承。
核心组合模式包括:
检索-生成(Retrieval-Generation)组合:
这是当前最成功、应用最广泛的组合模式。其工作流程为:
用户提问后,先使用检索模块从知识库中查找相关信息
将检索到的相关信息与原始问题一起提供给生成模块
生成模块基于检索到的信息生成回答
这种组合有效解决了大模型的“幻觉”问题(编造不存在的信息)和知识截止问题(不知道最新信息)。例如,在企业客服系统中,检索模块从产品手册、FAQ和过往工单中查找相关信息,生成模块基于这些信息生成准确、一致的回答。
分析-决策-执行组合:
这种三层组合适合自动化工作流场景:
分析模块:理解任务需求,识别关键要素和约束条件
决策模块:基于分析结果制定行动计划,选择适当的工具和策略
执行模块:调用相应函数执行具体操作
例如,在智能邮件处理系统中,分析模块识别邮件类型和紧急程度,决策模块决定是自动回复、转发给相应人员还是加入待办列表,执行模块执行相应操作。
生成-验证-优化循环组合:
这种组合确保输出质量:
生成模块:创建初始内容
验证模块:检查内容质量(准确性、合规性、风格一致性等)
优化模块:基于验证反馈改进内容
循环直到达到质量阈值
这种组合在内容创作、代码生成等对质量要求高的场景中特别有价值。
05
—
LangChain
5.1 LangChain的核心价值
通俗解释:LangChain是生成式AI应用的“脚手架”或“中间件”。它提供了一套标准化的组件和工具,让开发者能够快速搭建AI应用,而不用从头实现所有基础功能。
主要功能模块:
模型封装:统一不同AI模型的调用接口
提示词模板:可复用的提示词设计模式
记忆管理:对话历史、上下文维护
链式调用:将多个AI操作串联成工作流
代理系统:智能体的调度和管理
5.2 核心组件详解
5.2.1 模型(Models)from langchain.llms import OpenAIfrom langchain.chat_models import ChatOpenAI
两种模型调用方式llm = OpenAI(temperature=0.7) # 基础LLMchat_model = ChatOpenAI(temperature=0.7) # 对话优化模型
5.2.2 提示词模板(Prompt Templates)
通俗解释:可参数化的“对话模板”。就像邮件模板,你可以替换其中的变量来生成具体的提示词。
示例:
from langchain.prompts import PromptTemplatetemplate = """你是一个{role},请用{style}风格回答以下问题:问题:{question}回答:"""prompt = PromptTemplate( input_variables=["role", "style", "question"], template=template)5.2.3 链(Chains)
通俗解释:AI操作的“流水线”。将多个步骤串联起来,实现复杂的处理逻辑。
典型链类型:
LLMChain:最基本的链,LLM + 提示词模板
SequentialChain:顺序执行多个链
TransformChain:数据转换链
5.2.4 记忆(Memory)
实现方式:
ConversationBufferMemory:存储完整的对话历史
ConversationBufferWindowMemory:只保留最近N轮对话
ConversationSummaryMemory:存储对话摘要而非完整历史
5.2.5 检索增强(Retrieval Augmentation)
通俗解释:给AI配一个“外部知识库”。当AI遇到不知道的问题时,可以先去知识库查找相关信息,再基于这些信息生成回答。
技术实现:
文档加载:从各种来源加载文档(PDF、Word、网页等)
文本分割:将长文档切分成适合处理的片段
向量化:将文本转换为向量表示
向量存储:将向量存入向量数据库
相似度检索:根据问题向量查找最相关的文档片段
06
—
智能体
6.1 智能体的核心概念
通俗解释:智能体是“能自主行动的AI助手”。它不仅能够回答问题,还能主动使用工具、制定计划、执行任务。
与传统AI的区别:
被动响应 vs 主动行动:传统AI等待用户输入,智能体可以主动规划
单一能力 vs 多工具协作:智能体可以调用多种工具完成任务
固定流程 vs 动态决策:智能体根据情况动态调整策略
6.2 智能体架构设计
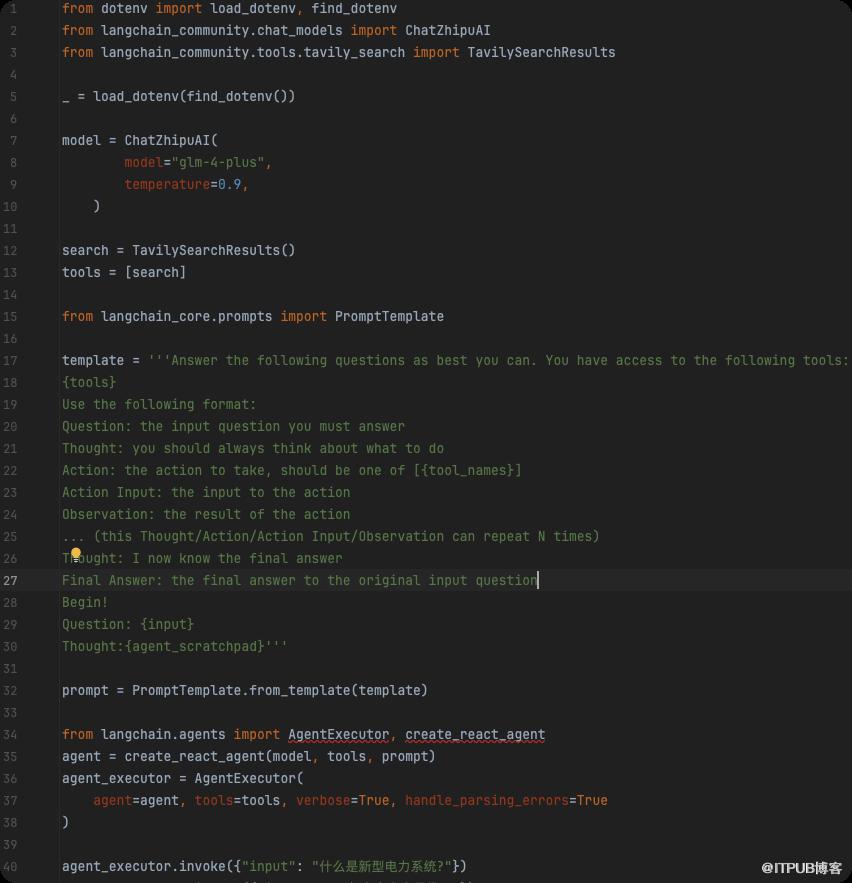
6.2.1 ReAct智能体
ReAct模式:推理(Reasoning)+ 行动(Acting)
思考:用户想了解北京的天气,我需要调用天气查询工具行动:调用get_weather("北京")观察:返回结果{"temperature": "25°C", "condition": "晴朗"}思考:根据天气信息,我可以建议用户穿轻薄衣物回答:北京今天天气晴朗,气温25°C,建议穿轻薄衣物6.2.2 ConversationalChat智能体
特点:专门优化对话场景,保持对话连贯性,处理多轮对话中的上下文依赖。
6.3 工具集成策略
工具类型:
信息查询工具:搜索引擎、数据库查询、API调用
计算工具:计算器、单位转换、日期计算
操作工具:文件操作、系统命令、网络请求
专业领域工具:代码执行、数据分析、图像处理
工具选择策略:
相关性优先:根据任务类型选择最相关的工具
成本考虑:优先使用免费或低成本工具
可靠性评估:选择稳定可靠的工具提供商
6.4 自定义智能体开发
开发步骤:
定义智能体目标:明确智能体要解决什么问题
选择基础模型:根据需求选择合适的LLM
设计工具集:确定智能体需要哪些工具
实现决策逻辑:如何选择工具、如何解析工具结果
测试优化:在各种场景下测试智能体表现
示例:多源问答智能体
07
—
多模态编程
7.1 多模态AI的基本原理
通俗解释:让AI能“看”、能“听”、能“说”。多模态AI能够处理和理解文本、图像、音频、视频等多种类型的数据。
技术基础:
跨模态理解:建立不同模态数据之间的语义关联
统一表示学习:将不同模态数据映射到同一向量空间
多任务学习:同时处理多种类型的任务
7.2 图像理解与生成
7.2.1 图像内容理解
应用场景:
图像描述生成:为图片生成文字描述
物体检测识别:识别图片中的物体和场景
OCR文字识别:从图片中提取文字信息
7.2.2 图像生成
生成方式:
文生图:根据文字描述生成图像
图生图:基于参考图像生成新图像
图像编辑:修改图像的特定部分
质量控制:
提示词优化:详细的描述获得更好的效果
参数调整:尺寸、质量、风格参数设置
迭代优化:多次生成选择最佳结果
7.3 视频内容处理
7.3.1 视频理解
技术挑战:
时序理解:理解视频中的时间序列信息
动作识别:识别视频中的动作和行为
场景理解:理解视频的整体场景和上下文
7.3.2 视频生成
生成策略:
文本到视频:根据文字描述生成视频
图像到视频:将静态图像转化为动态视频
视频编辑:视频剪辑、特效添加、内容修改
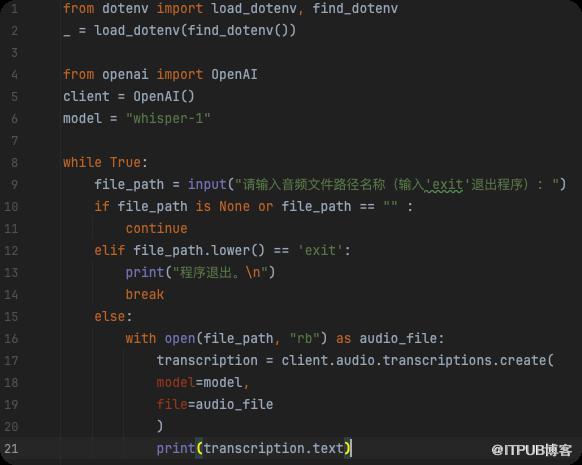
7.4 语音识别与合成
7.4.1 语音识别(ASR)
技术要点:
准确率优化:在嘈杂环境下的识别准确率
实时性要求:低延迟的实时语音转文字
多语言支持:支持多种语言和方言
7.4.2 语音合成(TTS)
质量指标:
自然度:语音是否自然流畅
表现力:能否表达情感和语气
个性化:支持不同的声音风格
7.5 多模态融合应用
典型应用场景:
智能客服:文字+语音+图像的全面支持
内容创作:自动生成图文并茂的内容
教育培训:多媒体的互动学习材料
医疗诊断:医学影像+文本报告的智能分析
实现举例,从声音到文本
08
—
总结
本文通过简单易懂的方式和实例阐述了“生成式AI应用开发”。在AI技术快速发展的今天,希望对于技术从业者来说具有重要的参考价值和实践意义。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70050081/viewspace-3117793/ ,如需转载,请注明出处,否则将追究法律责任。

