
小七准备开个新坑,找些好用的 Skill,实测跑一跑,看看它们到底是真提效,还是 README 看起来很美。第 1 期本来想走一个经典的剧本:先让 AI 裸跑出一版“土味网页”,再挂几个 Skill 来一场改头换面。结果第一步就被 Codex 把剧本撕了——至少在这次个人主页任务里,Codex 默认做出来的页面已经挺能打。
不过准备工作都做一半了,那就换个思路(其实是偷懒🐶): 当 Agent 本身已经具备不错的任务能力,再给它叠 Skill,还能提升什么?
懒人版:这 3 个 Skill 分别管什么?
这次我们用同一个个人主页任务,连续测了 3 个 Skill。简单说就是:
设计 → 文案 → 交付检查
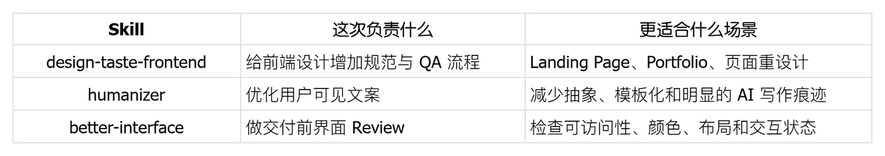
下面是实测过程:
Baseline 先验证 Codex 的默认能力
为了方便做前后对照,这次统一使用 Codex CLI 完成整个实验。Baseline 和后续 Skill 都保持同一套环境:
OS           Windows
Codex        0.149.1
Model        GPT-5.6 Sol High
Frontend     HTML + CSS + JavaScript
Input        同一份 vic-source.md
Skill scope  Project
所有第三方 Skill 都只安装在当前项目的
.agents/skills/ 下,不写入全局环境。这样每一轮尽量只增加一个变量,也避免测试 Skill 影响其他 Codex 项目。
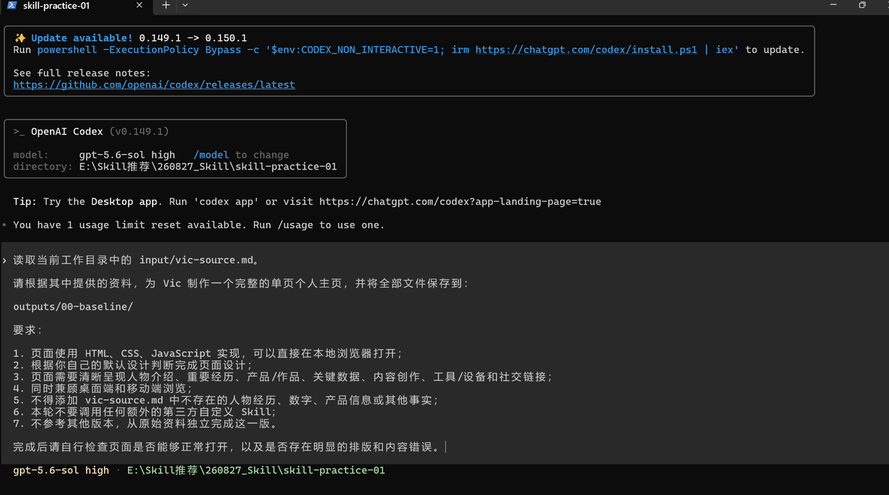
图 1:Codex CLI 实验环境
我们准备了一份虚构的个人资料
vic-source.md,里面有独立产品、摄影、播客、旅居经历,以及 ARR、用户数、播放量等数据。第一轮不给任何第三方 Skill,直接让 Codex 自己做:
读取当前工作目录中的 input/vic-source.md。
请根据其中提供的资料,为 Vic 制作一个完整的单页个人主页,并将全部文件保存到:
outputs/00-baseline/
要求:
1. 页面使用 HTML、CSS、JavaScript 实现,可以直接在本地浏览器打开;
2. 根据你自己的默认设计判断完成页面设计;
3. 页面需要清晰呈现人物介绍、重要经历、产品/作品、关键数据、内容创作、工具/设备和社交链接;
4. 同时兼顾桌面端和移动端浏览;
5. 不得添加 vic-source.md 中不存在的人物经历、数字、产品信息或其他事实;
6. 本轮不要调用任何额外的第三方自定义 Skill;
7. 不参考其他版本,从原始资料独立完成这一版。
完成后请自行检查页面是否能够正常打开,以及是否存在明显的排版和内容错误。
结果比我们预期要好,Codex 选择了黑底 + 荧光黄绿色的视觉方案,还主动把:
$42K ARR
2,800+ 用户
3.2M 摄影浏览
4 年+旅居
提取成独立指标。页面生成后,它继续调用浏览器检查桌面端和移动端,发现标题拥挤等问题后又修改 CSS 并重新验证。

图 2:Codex 未使用第三方 Skill 生成的 Baseline 个人主页首屏
在这次任务里,不加第三方 Skill,Codex 已经自行跑完:
信息整理
→ 页面结构
→ 视觉设计
→ 前端实现
→ 响应式
→ 浏览器检查
→ 自我修复
到这里,就出现了开头提到的本期内容的思路转变: 已经会做页面的 Codex,加上专业 Skill 之后,会发生什么变化?
design-taste-frontend 给页面增加设计约束
还是在
Project 中,我们安装第一个 Skill
Leonxlnx/taste-skill:
npx skills add https://github.com/Leonxlnx/taste-skill `
  --skill "design-taste-frontend"
接着让 Codex 调用
design-taste-frontend 并读取同一份
vic-source.md,明确不参考 Baseline:
$design-taste-frontend
读取当前工作目录中的 input/vic-source.md。
请根据其中提供的资料,为 Vic 制作一个完整的单页个人主页,并将全部文件保存到:
outputs/01-taste/
要求:
1. 页面使用 HTML、CSS、JavaScript 实现,可以直接在本地浏览器打开;
2. 请严格按照 design-taste-frontend Skill 的设计原则完成页面设计;
3. 页面需要清晰呈现人物介绍、重要经历、产品/作品、关键数据、内容创作、工具/设备和社交链接;
4. 同时兼顾桌面端和移动端浏览;
5. 不得添加 vic-source.md 中不存在的人物经历、数字、产品信息或其他事实;
6. 不参考 outputs/00-baseline,从原始资料独立完成这一版;
7. 不要主动调用其他第三方自定义 Skill。
两版最终走出了明显不同的设计方向。

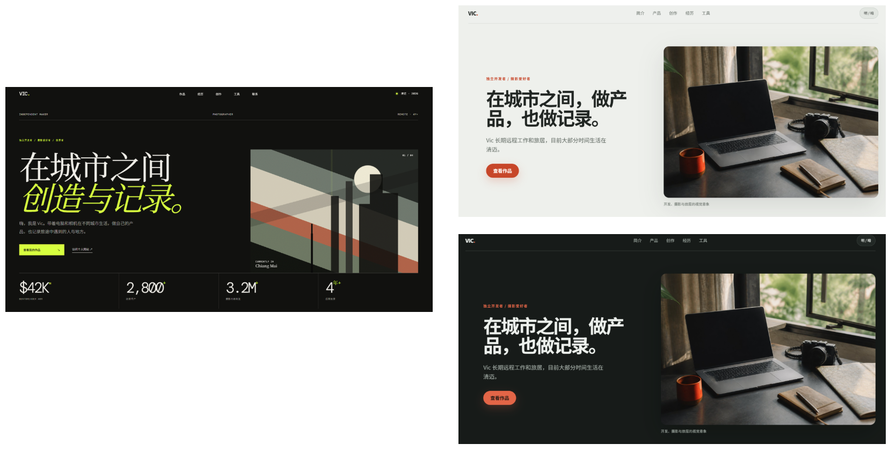
图 3:Baseline 与
design-taste-frontend 版本首屏对比,左侧为 Codex 默认版本,右侧为 Taste 页面(支持明 / 暗主题)
Baseline 倾向于一次性‘画’一张具有视觉张力的海报,而挂载
taste-skill 后,Codex 更像一个懂工程规范的前端工程师——把文字、按钮、交互图片解耦,做成了可维护的双主题组件系统。
这一轮实际覆盖了更多设计与 QA 检查:
图片与文字关系
Hero 标题换行
390px / 500px 移动端
横向溢出
深色主题
完整长页面
prefers-reduced-motion
文字对比度
例如,有一张生成图片直接把说明文字烘焙进了图片里,Codex 在读取 Skill 规则后主动调整成:
图片
+
独立 HTML 文本
移动端标题、导航和不同视口也经过了多轮重新渲染。这一轮的变化是 Codex 开始按照更明确的设计规则和更完整的 QA 流程执行任务。
Baseline vs
design-taste-frontend 第一轮实验对比
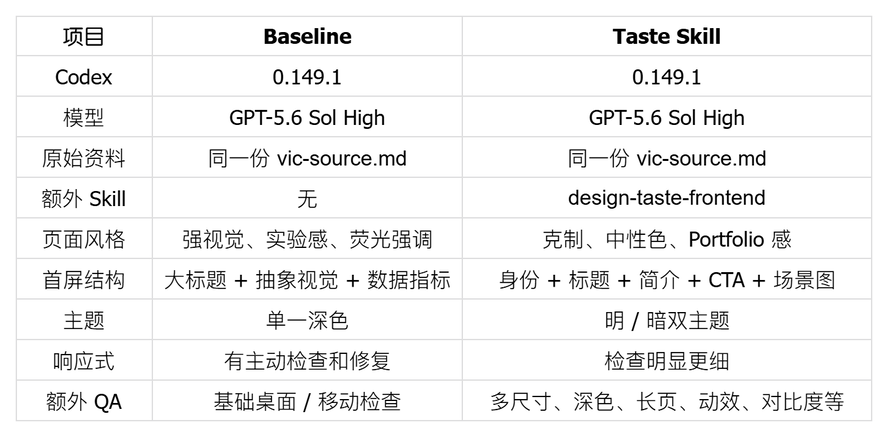
不过,也需要划清归因边界:Taste 版本同时调用了 Codex 自带的图像生成能力生成 3 张场景配图,最终页面来自
GPT-5.6 Sol 本身的前端能力、Skill 规则、图像生成能力以及本轮
QA 的共同作用,不能把所有视觉变化都归因于
design-taste-frontend。另外,Taste 这一轮实际覆盖了更多设计与 QA 检查,执行链也明显更长。
页面基本定了,下一步只动文字。
humanizer 不动页面只改文字
先尝试安装
humanizer:
npx skills add https://github.com/blader/humanizer
不过安装到这里先碰到了一个安全提示,我们暂停检查了一轮,确认后才继续在 Project 中安装并测试。
安装 Skill 前先检查安全提示
humanizer 安装小插曲,安装器给出的安全扫描结果是:
Gen      Safe
Socket   0 alerts
Snyk     High Risk
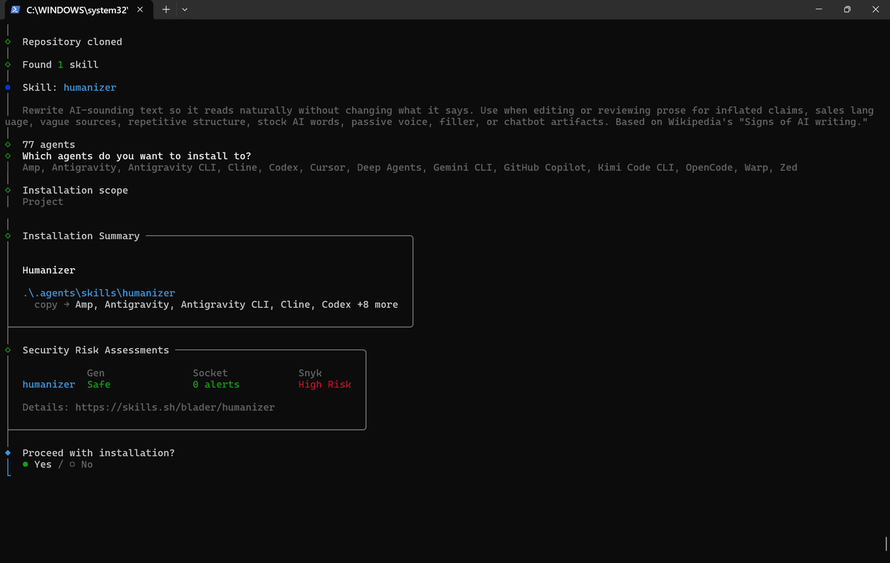
图 4:安装
humanizer 时的安全扫描截图——Gen Safe、Socket 0 alerts、Snyk High Risk
第一次看到这个结果时,我们没有继续安装,而是先取消操作,人工检查当前仓库里的
SKILL.md,重点确认:
是否要求执行外部脚本
是否下载未知文件
是否上传本地数据
是否读取无关目录
是否调用额外网络服务
当前
SKILL.md 主要是文本处理规则,没有看到上述明显高风险指令,因此才决定在这个隔离的 Project 中继续测试。这里没法简单判断 Snyk 的
High Risk 就是误报;同时,
人工检查
SKILL.md
也不等于完成了一次完整安全审计。
更实用的处理方式是:安全扫描出现冲突时,先确认 Skill 来源和实际指令,再根据当前任务决定是否继续安装,以及把权限限制在什么范围。测试中所有 Skill 都采用 Project 级安装,也是出于这个考虑。
搞定
humanizer 安装后,让 Codex 调用 Skill 执行以下指令:
$humanizer
请基于 outputs/01-taste/ 中已经完成的个人主页,使用 humanizer Skill 优化页面中的用户可见文案。
请先将 outputs/01-taste/ 的最终交付文件完整复制到:
outputs/02-humanizer/
之后只修改 outputs/02-humanizer/。
本轮要求:
1. 只优化页面文案,不改变页面整体布局、CSS 视觉系统、组件结构和交互逻辑;
2. 使用 humanizer Skill 去除明显的 AI 写作痕迹、空洞升华、营销式表达和不自然的措辞;
3. 尽量使用具体动作、真实事实和已有数字表达人物经历;
4. 不得添加 input/vic-source.md 中不存在的事实;
5. 不要为了“更像人”而改变原始信息含义;
6. 页面整体表达保持自然、简洁,符合个人主页而不是企业宣传稿的语气。
完成后,请另外告诉我:
- 哪些文案被修改;
- 原文是什么;
- 修改后是什么;
- 为什么修改。
实际修改比“删掉几个 AI 高频词”更有意思:
Before
在城市之间,做产品,也做记录。
After
在不同城市生活,做产品,也拍照。
Before
过去几年,Vic 在不同城市生活,
独立完成产品、代码、摄影和播客。
After
过去几年,Vic 一边在不同城市生活,
一边做产品、写代码、拍照和录播客。
更多详细内容可以看下面这张图:
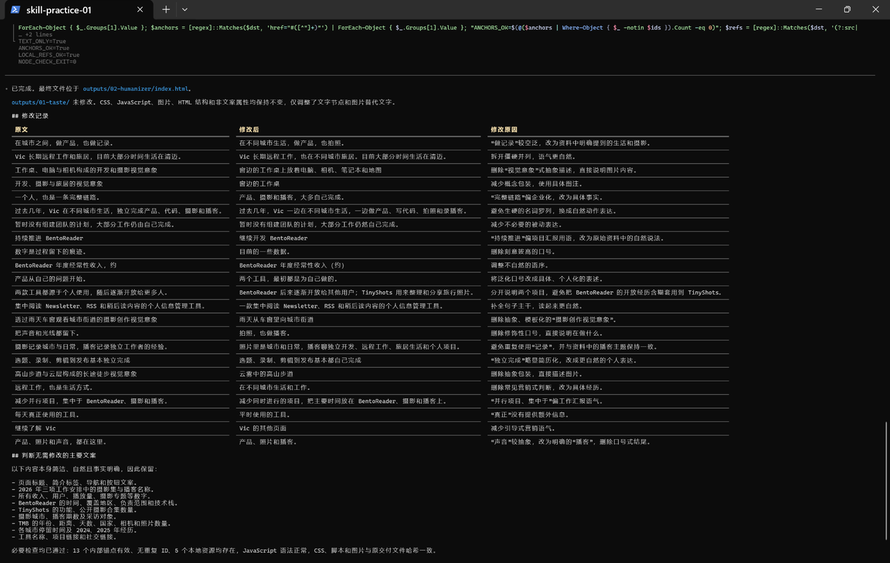
图 5:
humanizer 实测文案 Before / After 修改展示
这轮变化主要集中在:
抽象名词 → 具体动作
泛化总结 → 具体事实
介绍稿语气 → 更自然的个人表达
数字、年份、项目名称、技术栈等已经明确的信息则基本保持原样。
在这次个人主页制作中,
humanizer 进行了一轮
系统的文案 Review:它会提醒 Agent 哪些地方太抽象、太模板化,但具体修改是否采用,仍然需要人工判断。
设计和文案都有了,最后看看这版页面在交付检查里会发生什么。
better-interface 做交付前界面 Review
better-interface 会协调多个专项 Skill。我们没有把整个仓库全部安装,只选择本次 Review 需要的 7 个:
npx skills add jakubkrehel/skills `
  --skill better-interface `
  --skill better-accessibility `
  --skill better-layout `
  --skill better-writing `
  --skill better-typography `
  --skill better-colors `
  --skill better-ui
全部采用 Project 级安装。第一次运行只 Review,不允许它自动修改:
$better-interface
请对 outputs/02-humanizer/ 中已经完成的个人主页做一次 full interface review。
这一轮只审查,不修改任何文件。
要求:
1. 不修改 outputs/02-humanizer/ 中的 HTML、CSS、JavaScript、图片或其他文件;
2. 不复制文件到 outputs/03-final/,03-final 暂时保持为空;
3. 可以读取页面代码、原始资料和必要的 Skill,也可以使用本地浏览器做桌面端、移动端或主题检查;
4. 请按照 better-interface 的完整审查流程,重点检查:
   - Accessibility
   - Layout
   - Writing
   - Typography
   - Colors
   - UI / interaction
5. 所有问题必须基于当前实际页面,不要为了凑数量而提出修改;
6. 不要重新设计页面,也不要把纯审美偏好当成错误。
请把发现的问题分成三类:
A. 明确需要修复的问题
B. 建议优化但不影响正常使用的问题
C. 纯审美偏好或可选建议
本轮完成 Review 后停止,不要自动修复。
执行完成后,
better-interface 给出了这次 Full Interface Review 的结果:
A 明确需要修复    4
B 建议优化        4
C 纯审美偏好      0
Layout            Clear
Writing           Clear
Typography        Clear
Verdict            Block
这个结果还挺有意思。页面肉眼看已经没有明显问题,
better-interface 也没有继续纠结圆角、留白这类设计选择,而是抓出了
颜色、可访问性和交互状态上的 4 个交付问题:

这些都不属于“页面好不好看”的问题,却是 肉眼浏览时很容易漏掉的交付细节。
只修明确问题让 Review 从 Block 变成 PASS
到这里,4 个需要修复的问题已经明确。Review 另外还给了 4 个 B 类建议,包括 Escape 关闭移动菜单、新标签页提示、主题切换过渡和 Hover 处理。
为了继续控制变量,这一轮 只修 A1~A4,B 类建议全部保留不动:
基于刚才完成的 Full Interface Review,请进入修复阶段。
请先将 outputs/02-humanizer/ 的最终交付文件完整复制到:
outputs/03-final/
之后只修改 outputs/03-final/,不得修改 outputs/02-humanizer/、outputs/01-taste/ 或 outputs/00-baseline/。
本轮只修复 Review 中被归为 A 类“明确需要修复”的 4 个问题:
A1. 小字号强调色文字对比度不足
A2. 焦点环对比度不足
A3. 可见标签与 accessible name 不一致
A4. 系统主题变化后 aria-pressed 状态不同步
要求:
1. 按刚才 Review 给出的建议修复;
2. B1-B4 建议优化项本轮全部不修改;
3. 不重新设计页面;
4. 不修改已经确认正常的布局、排版、文案、图片和视觉结构;
5. 修改后重新验证 A1-A4 是否解决;
6. 最后明确列出每个问题的具体修改方式和验证结果;
7. 如果 A1-A4 全部通过,请给出新的 Review verdict。
完成后停止,不继续做额外优化。
修复完成后,我们重新验证了 A1~A4,4 个问题均已解决:

按照
better-interface
本轮 Review 的检查口径,最终结果变成:
A 类问题    4 → 0
Verdict
Block → PASS
这里的
PASS 仅代表本轮 Review 已不存在 A 类阻断问题,并不等同于完成了完整的生产级可访问性认证;本次也没有额外进行真实屏幕阅读器或 Axe / Lighthouse 独立审计。
到这里,这次 Skill 实践就算正式收口了。
这 3 个 Skill 怎么选?
跑完整个流程后,3 个 Skill 的定位已经比较清楚:

如果只是临时做一个简单个人页,现在的 Codex 默认能力已经能完成大部分工作。如果经常让 Agent 重复完成同类任务,Skill 的价值会更加明显:它可以把设计规范、写作习惯或者 Review 标准固定到 Agent 的工作流里,减少每次重新解释规则的成本。
这次实践给我们的一个明显感受是:随着模型本身能力增强,Skill 的价值开始更多体现在把专业工作方法、约束和检查流程固化给 Agent。“会不会做”已经不是唯一的问题。按什么标准做、做到什么程度、最后怎么检查,正在成为 Skill 更值得看的部分。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70050060/viewspace-3180990/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 周 1 上线 | Deno 团队加入 Cloudflare,黄老板 “盯上” Reflection AI
- 从 Bun 到 Deno,AI 时代的开发工具正在经历什么?
- Coding Agent 长任务中的 Context 压缩时机
- 模型变强之后,Skill 和 Prompt 该做减法了
- Agent 小知识|MCP 里的 Tools、Resources、Prompts 有什么区别
- 从上下文到权限:如何把 Agent 接进真实业务流程
- 从自我改进到递归进化:RSI 的五级路线
- 攒了上百个 Skill,Agent 知道怎么用吗?拆解多 Skill 场景下的分层加载机制
- 当 Coding Agent 开始内卷,软件工程的标准会变吗?
- 谷歌利用果蝇实现“AI 突围”?Cognition 再融 20 亿美元;AI 三巨头集体呼吁放慢脚步
