可能现在大家对 Coding Agent 的期待都不低。毕竟它能读代码、改文件、跑命令,已经很接近“把一个开发助手放进项目里”的想法。但真正用过 Coding Agent 的小伙伴应该已经发现一个很现实的问题:只要任务稍微长一点,成本就很难忽略。
如果只是让它解释一段代码、改一个小函数,大多数的 Coding Agent 体验一般都不错。然而一旦进入真实项目,Agent 就要反复读取文件、理解项目结构、记录任务要求、调用工具、执行命令,还要带着前面的结果继续往下做。这时候,上下文会越滚越长,token 成本也会跟着往上走。
所以,当同事给我安利 Reasonix,说它颜值高还省钱时,我就来了兴趣,打算在本文里讲一讲这个开源项目。
Reasonix 的亮点
小七对 Reasonix 的第一反应是:它的问题切入点很准。既照顾了颜狗对界面的要求,也照顾了实用主义者对成本的敏感。
先来简单介绍下这个项目,Reasonix 是一个运行在终端里的 AI Coding Agent,目前 GitHub 标星已经接近 15k(截至 5 月 31 日,标星为 14.8k)。它第一眼吸引人的地方,是终端 UI 做得挺舒服。
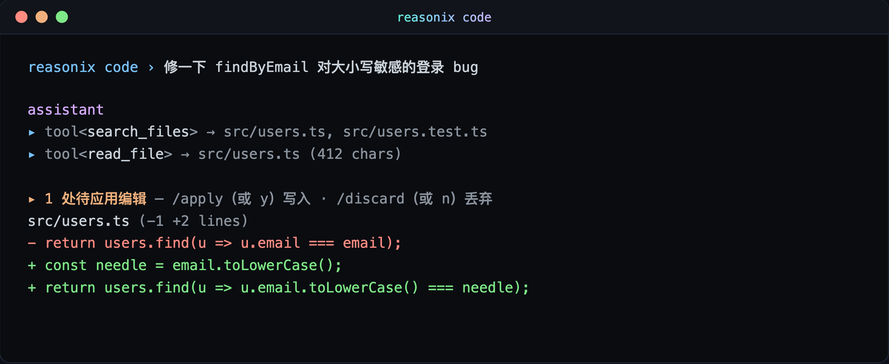
信息层次比较清楚,Agent 在思考什么、调用了什么工具、执行了什么操作,都更容易看出来。
这点对 Coding Agent 其实很重要。
因为我们用这类工具辅助开发时,看的不只是最后结果,还会关心它读了哪些文件、为什么要修改某段代码、有没有执行了危险的命令、现在任务又推进到了哪一步。UI 做得清楚,关键信息一眼就能看到,也就更放心地把它留在项目里跑。
但 Reasonix 更值得单独讲的地方,是它把重点放在了一个更具体的问题上: 怎么让 Coding Agent 在长会话里更省钱。
它给出的思路,是围绕 DeepSeek 的缓存机制来重新设计 Agent 的工作方式。
为什么它只做 DeepSeek
Reasonix 的定位很明确:它是一个 DeepSeek-native AI coding agent。它的很多技术设计都围绕 DeepSeek API 展开,尤其是 DeepSeek 的前缀缓存机制。
相比之下,很多 Agent 工具会优先追求多模型支持,让 Claude、OpenAI、DeepSeek、Gemini 都能接入。这样确实更灵活,但也意味着底层设计需要兼容不同模型,很难充分利用某一个模型的具体特性。
Reasonix 的选择很直接:既然 DeepSeek 有前缀缓存,那就把 Agent 的运行循环设计成适合缓存命中的样子。它关心的不只是“能不能调用 DeepSeek”,还包括:
- 每一轮请求的上下文怎么组织?
- 哪些内容应该保持稳定?
- 哪些内容可以继续追加?
- 怎么减少无意义的上下文扰动?
- 怎么让缓存命中率尽量高一点?
这些问题看起来很细,但对一个长期运行的 Coding Agent 来说,这很关键,每一步都能帮我们“省钱”。
DeepSeek 缓存为什么重要
这里先来简单地介绍下 DeepSeek 的前缀缓存机制。
DeepSeek 的上下文缓存功能是默认开启的。每次收到请求后,系统会构建并持久化一部分前缀内容;如果后续请求能够完整匹配这些已经持久化的缓存前缀单元,重叠部分就有机会直接从缓存中复用,并计为 cache hit,也就是命中缓存。
这对长会话很重要。只要前面的上下文足够稳定,后面的内容又是持续追加的,重复输入的成本就有机会降下来。
其实这很像 Coding Agent 的工作方式。如果你让 Agent 进入一个项目,它一开始会读取项目结构、理解代码风格、加载系统提示词、记录任务要求。后面每一轮,它都会带着这些上下文继续工作。
但这里有一个前提: 这些上下文要足够稳定,缓存才更容易命中。
很多 Agent 在长会话里会不断整理上下文,比如压缩历史、重写摘要、调整内容顺序。这样做是为了让模型更好地理解当前任务,但也可能带来一个副作用:前面的内容看起来差不多,底层输入其实已经变了。
语义上差不多,不代表缓存一定能命中。前缀越不稳定,缓存效果就越容易打折。
Reasonix 的核心思路, 就是尽量让上下文前半部分保持稳定,把新的交互、工具调用结果、任务进展用追加的方式放进去。这样一来,DeepSeek 的前缀缓存才更容易发挥作用。
Cache-First Loop 是它的关键设计
Reasonix 架构里有一个很重要的概念,叫 Cache-First Loop。你可以把它理解成是一种“优先考虑缓存命中”的 Agent 循环。
普通 Agent 可能更关心下一轮怎么把上下文整理得更聪明;Reasonix 更关心下一轮怎么尽量不破坏前面已经稳定下来的上下文。
所以它会尽量避免频繁改写历史内容。
比如,系统提示、工具说明、项目约束这类固定信息,会尽量保持稳定;已经发生过的操作和结果,会尽量以追加日志的形式进入上下文;而临时推理和草稿信息,则尽量不进入主上下文,避免影响前缀缓存的稳定性。
这样做的好处很直接:会话跑得越久,前面可复用的部分越多,缓存命中就越有价值。
这也是 Reasonix 和很多“套一层模型 API”的工具不太一样的地方。
它的重点不只是把 DeepSeek 接进来,还要让 Agent 的上下文结构配合 DeepSeek 的缓存机制工作。
其他核心设计
除了缓存,Reasonix 还有几个设计点值得关注。
tool-call repair
第一个是 tool-call repair。
Coding Agent 不只是聊天,它还要调用工具,比如读写文件、执行命令。模型在生成工具调用时,偶尔会出现格式不完整、参数不规范的问题。Reasonix 会尝试自动修复这类工具调用错误,减少因格式问题导致的执行失败、额外请求,避免白白多花一轮 token。
flash-first cost control
第二个是 flash-first cost control。
这个设计讲的不是简单“省钱”,而是 Reasonix 默认会优先使用更便宜的 DeepSeek flash 模型,把 pro 模型留给真正需要更强推理能力的任务。

按照它的架构文档,Reasonix 提供了几种模型档位:
flash、
auto 和
pro。其中
auto 会先用
v4-flash,遇到困难任务时再切到
v4-pro;而一些辅助调用,比如摘要、子 Agent、截断修复重试,也会固定使用
v4-flash + effort=high。
这背后的思路挺现实:Coding Agent 的每一轮请求,不一定都需要最强模型。有些任务只是整理工具结果、搜索代码、生成摘要,直接用 pro 模型反而是浪费。
所以,Reasonix 的成本控制不是最后加一个“省钱模式”,而是把模型选择、上下文压缩、工具结果处理都放进了运行策略里。它想解决的,是 Coding Agent 长时间运行时,哪些请求值得花更多钱,哪些请求可以用更轻的模型完成。
接入友好
第三个是它的终端形态比较直接。
Reasonix 运行在终端里,对开发者来说路径很自然。你进入项目目录,启动 Agent,让它读代码、改文件、跑命令,整个流程和日常开发环境比较贴近。
这类工具最后能不能留下来,往往不取决于第一次演示有多惊艳,而是你平时愿不愿意一直打开它。
注意事项
如果你想实际试一下 Reasonix,需要注意一个细节。
项目近期有版本演进,README 里提到 1.0 正在转向 Go 版本,旧的 0.x TypeScript 版本还在维护。
所以安装和使用时,建议直接看 GitHub 项目的最新 README,确认当前分支、版本说明和安装命令。
这种快速迭代的开源 Agent 项目,一般项目变化会比较快。尤其是涉及 CLI、模型 API、工具调用这些部分,文档更新节奏可能会比第三方介绍更快,记得以官方 README / Changelog 为准。
最后
Reasonix 值得关注的地方,不只是它做了一个 DeepSeek Coding Agent,更在于它把“模型计费机制”放进了 Agent 的架构设计里。
过去我们聊 Coding Agent,更多关注模型能力、工具调用、上下文管理和代码修改效果。但 Reasonix 提醒了一个更现实的问题:Agent 想要长期运行,成本本身也是工程问题。
如果上下文组织不稳定,再便宜的模型也可能在长会话里慢慢变贵;如果 Agent 的运行循环能适配缓存,同样的任务就可能跑得更久、更稳,也更适合日常使用。
这也是 Reasonix 接近 15k Star 后,仍然值得单独拿出来讲一讲的原因。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70050060/viewspace-3172921/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 周 1 上线 | Deno 团队加入 Cloudflare,黄老板 “盯上” Reflection AI
- 从 Bun 到 Deno,AI 时代的开发工具正在经历什么?
- Coding Agent 长任务中的 Context 压缩时机
- 模型变强之后,Skill 和 Prompt 该做减法了
- Agent 小知识|MCP 里的 Tools、Resources、Prompts 有什么区别
- 从上下文到权限:如何把 Agent 接进真实业务流程
- 从自我改进到递归进化:RSI 的五级路线
- 攒了上百个 Skill,Agent 知道怎么用吗?拆解多 Skill 场景下的分层加载机制
- 当 Coding Agent 开始内卷,软件工程的标准会变吗?
- 谷歌利用果蝇实现“AI 突围”?Cognition 再融 20 亿美元;AI 三巨头集体呼吁放慢脚步
