分布式数据管理基础
分布式数据管理基础
文章目录
一、CAP与ACID
1.1 CAP
1、概念
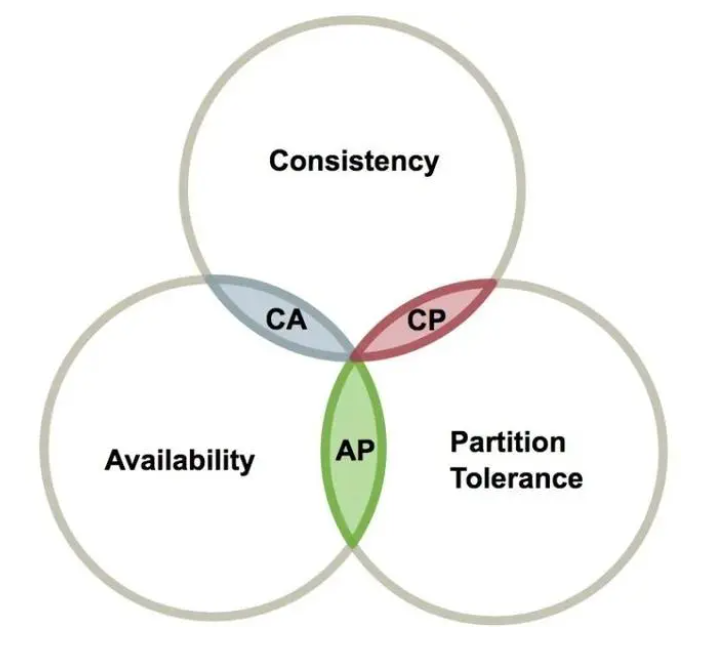
CAP原则适用于分布式系统,只能满足两者之一
C (Consistency):一致性,指分布式系统中所有节点在同一时刻数据相同。
A(Availability):可用性,指分布式系统提供的服务一直可用。
P (Partition Tolerance):分区容错性,指分布式系统在遇到网络分区故障时,仍然可以对外服务————需要奇数个节点。
2、为什么CAP无法同时满足
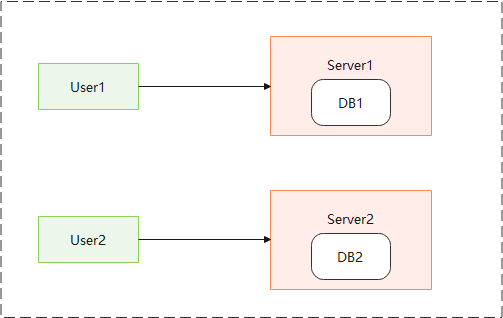
对于上图的系统
- C:DB1和DB2内容保持相同
- A:用户不管访问Server1还是Server2,都能得到响应
- P:Server1/Server2间出现网络故障时,仍能对外服务
一次请求过程至少包含如下三个步骤:
- 步骤1:用户向Server:1发起请求,将数据a从1改为2
- 步骤2:系统进行同步,将DB1的修改同步到Server2,DB2的数据2从改为2
- 步骤3:用户向Server2发起读取a的请求,得到最新值2
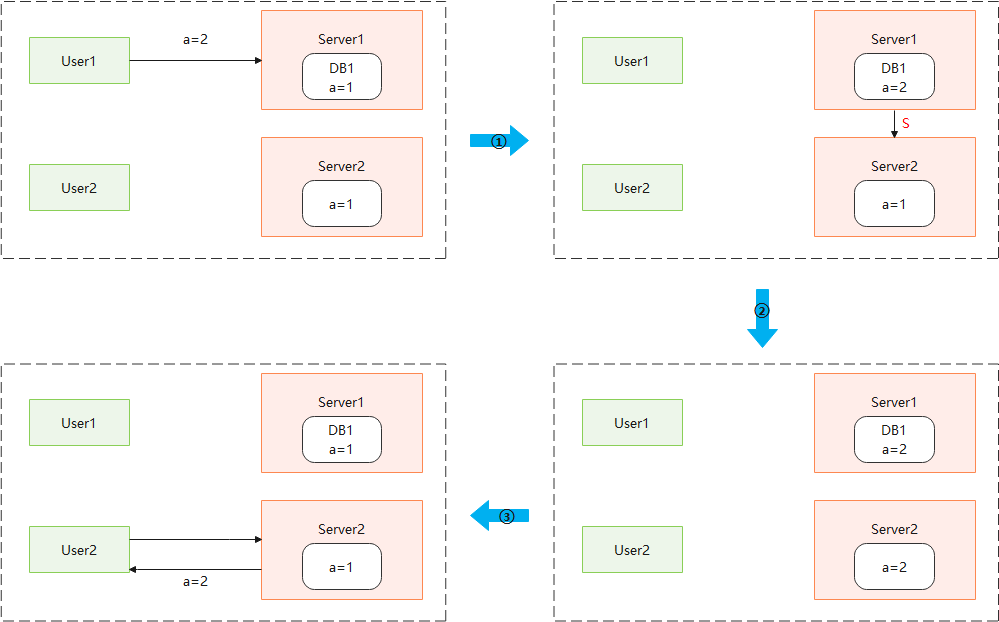
保持一致性,牺牲可用性
- 网络故障发生时,因为不知道另一个分区是否对数据进行修改,因此拒绝服务直到网络恢复
- 即,当发现server1出现问题时,a=2的写入操作会被拒绝,此时可用性遭到牺牲
保持可用性,牺牲一致性
- server2将旧的数据返回给用户,等网络恢复再进行同步
- 即user1会获得a=1,与DB1的a=2不一致
3、CAP选择策略
- 保CA放弃P:放弃分布式系统
- 一般涉及关键数据的场景,一致性更为重要,选择CP:Zookeeper、Redis、Hbase(国内较为常用)等
- 对于其他场景,选择AP牺牲C,采用最终一致性
- 保证用户体验
- Eureka、CoachDB、Cassandra等
1.2 ACID
ACID,是指数据库管理系统(DBMS)在写入或更新资料的过程中,为保证事务(transaction)是正确可靠的,所必须具备的四个特性:原子性(atomicity,或称不可分割性)、一致性(consistency)、隔离性(isolation,又称独立性)、持久性(durability)。
- Atomicity(原子性):一个事务(transaction)中的所有操作,要么全部完成,要么全部不完成,不会结束在中间某个环节。事务在执行过程中发生错误,会被恢复(Rollback)到事务开始前的状态,就像这个事务从来没有执行过一样。
- Consistency(一致性):在事务开始之前和事务结束以后,数据库的完整性没有被破坏。这表示写入的资料必须完全符合所有的预设规则,这包含资料的精确度、串联性以及后续数据库可以自发性地完成预定的工作。
- Isolation(隔离性):数据库允许多个并发事务同时对其数据进行读写和修改的能力,隔离性可以防止多个事务并发执行时由于交叉执行而导致数据的不一致。事务隔离分为不同级别,包括读未提交(Read uncommitted)、读提交(read committed)、可重复读(repeatable read)和串行化(Serializable)。
- Durability(持久性):事务处理结束后,对数据的修改就是永久的,即便系统故障也不会丢失
二、分布式数据存储基本原理
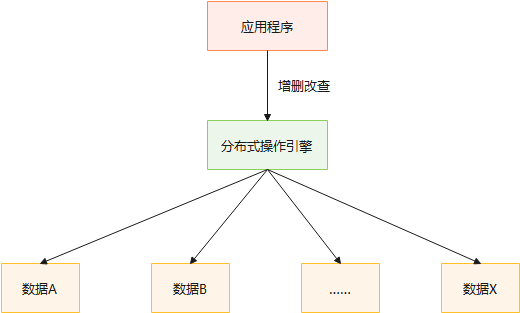
分布式数据存储的三要素
- 数据生产者/消费者
- 数据索引
- 数据存储
对比现实中的超市购物:
- 买东西的人:消费者
- 购物区标签:数据索引
- 放商品的货架:数据存储
关心数据的结构
2.1 生产者/消费者产生的数据类型
结构化数据
- 格式固定,具备关联性
- 通常用数据库存储
半结构化数据
- 具备基本固定结构模式,数据间关系简单
- 通常用Key/Value系统存储
非结构化数据
- 没有固定模式,数据之间关联不大
- 通常用文档存储(MongDB)或对象存储(Simple Storage Service (Amazon S3))
- 医疗影像
2.2 数据索引
用于确定数据位置
在写入时按照一定规则将数据存储到相应节点中,并能在访问时找到对应的数据
-
基于数据特征——便于上下文查看:食品,衣服……放在一起
-
基于数据范围:按照学号,1~100放到一起,101~200放在一起
-
……
2.3 数据存储分类
1、分布式数据库,通过表格来存储结构化数据,方便查找。
-
常用的分布式数据库有MySQL Sharding、Microsoft SQL Azure、Google Spanner、Alibaba OceanBase等。
2、分布式键值系统,通过键值对来存储半结构化数据。
- 常用的分布式键值系统有Redis、Memcache等,可用作缓存系统。
3、分布式存储系统,通过文件、块、对象等来存储非结构化数据
- 常见的分布式存储系统有Ceph、GFS、HDFS、Swift等。
- 最接近硬件和操作系统
2.4 数据存储介质
磁盘存储量大,但0开销大,访问速度较低,常用于存储不经常使用的数据。
- Tape Drive
- HDD(Hard Disk Drive)
- SSD(Solid-State Drive)
内存容量小,访问速度快,因此常用于存储需要经常访问的数据
三、数据分布设计原则
3.1 数据均匀
不同存储节点中存储的数据要尽量均衡,避免让某一个或某几个节点存储压力过大,而其他节点却几乎没什么数据。
比如,现在有 100G 数据,4 个同类型节点,通常希望数据存储时尽可能均衡,比如每个节点存储 25G 数据。
3.2 数据稳定
当存储节点出现故障需要移除或者扩增时,数据按照分布规则得到的结果应该尽量保持稳定,不要出现大范围的数据迁移。
比如,现有 100G 数据,刚开始有 4 个同类型节点(节点 1~4),每个节点存储 25G 数据。现在节点 2 故障了,也就是说每个节点需要存储 100G/3 数据。尽可能只迁移节点 2 上的数据到其他节点上,而不需要对大范围或所有数据进行迁移存储。当然,如果有扩展同类型节点,也是尽可能小范围迁移数据到扩展的节点上。迁移方法采用下文介绍的一致性哈希方法。
3.3 节点异构性
不同存储节点的硬件配置可能差别很大。比如,有的节点硬件配置很高,可以存储大量数据,也可以承受更多的请求;
但有的节点硬件配置低, 存储的数据量不能过多,用户访问也不能过多。如果这种差别很大的节点,分到的数据量、用户访问量都差不多,本质就是一种不均衡。所以一个好的数据分布算法应该考虑节点异构性。
3.4 故障隔离
目的是为了保证数据的可用和可靠性。
比如,通常通过备份来实现数据的可靠性。但如果每个数据及它的备份,被分布到了同一块硬盘或节点上,就有点违背备份的初衷了。
3.5 性能稳定性
数据存储和查询的效率要有保证,不能因为节点的添加或者移除,造成存储或访问性能的严重下降
四、数据分布方法
4.1 哈希
哈希是一种非常常用的数据分布方法,其核心思想是:首先确定一个哈希函数,然后通过计算得到对应的存储节点。
适用于同类型节点且数量不变
4.2 一致性哈希
一致性哈希是指:将存储节点和数据都映射到一个首尾相连的哈希环上:
- 存储节点可以根据 IP 地址进行哈希;
- 数据通常通过顺时针方向寻找的方式,来确定自己所属的存储节点,即从数据映射在环上的位置开始,顺时针方向找到的第一个存储节点。
适合同类型节点,数量会变化
4.3 带有限负载的一致性哈希
核心原理:给每个存储节点设置了一个储上限值来控制存储节点添加或移除造成的数据不均匀。
当数据按照一致性哈希算法找到相应的存储节点时,要先判断该存储节点是否达到了存储上限;如果已经达到了上限,则需要继续寻找该存储节点顺时针方向之后的节点进行存储。
适合同类型节点,数量会变化
4.4 带虚拟节点的一致性哈希
核心思想:根据每个节点的性能,为每个节点划分不同数量的虚拟节点,并将这些虚拟节点映射到哈希环中,然后再按照一致性哈希算法进行数据映射和存储。
适合异构节点,数量会变化
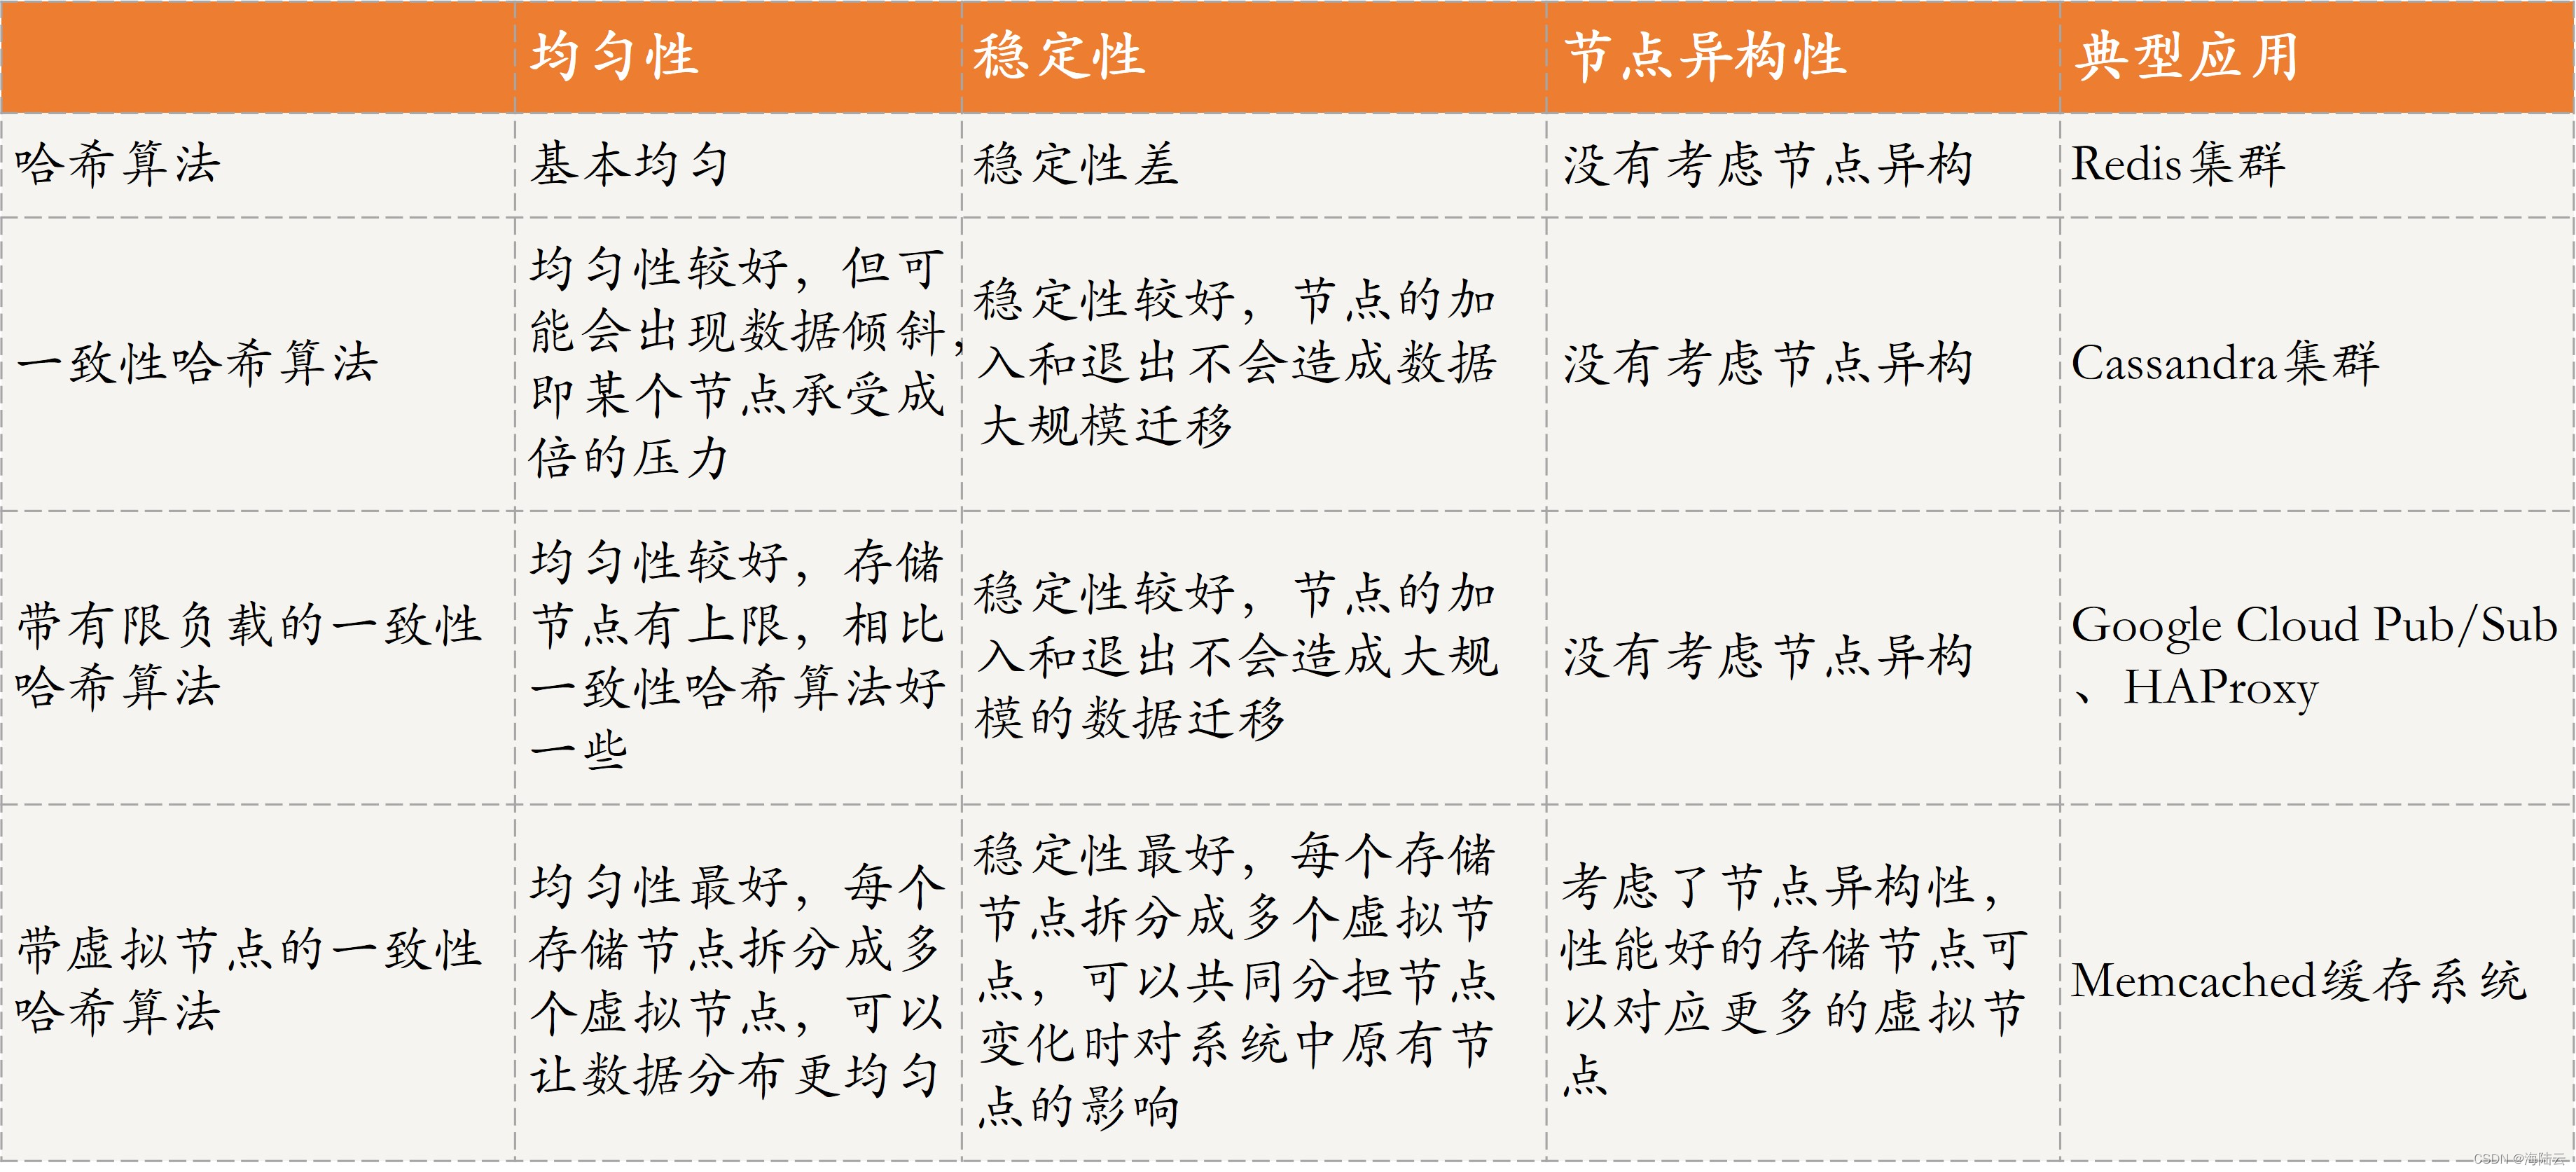
4.5 对比
五、数据复制技术
数据复制是一种实现数据备份的技术,实现分布式存储系统的自动容错。
可以保证存储在不同节点上的同一份数据是一致的。
当一个节点故障后,可以从其他存储该数据的节点获取数据,避免数据丢失,进而提高了系统的可靠性
多种数据复制技术方法,大体上有三类:
- 注重一致性,比如同步复制技术;
- 注重可用性,比如异步复制技术;
- 介于前两者之间的,比如半同步复制技术。
5.1 同步复制技术
当用户请求更新数据时,主数据存储必须要同步到备数据存储之后才可给用户返回。
如果主数据存储没有同步到备数据存储,用户的更新操作会一直阻塞。
保证了数据的强一致性,但牺牲了系统的可用性。
5.2 异步复制技术
当用户请求更新数据时,主数据存储处理完请求后可直接给用户响应,而不必等待备数据存储完成同步
备数据存储会异步进行数据的同步,用户的更新操作不会因为备数据存储未完成数据同步而导致阻塞。
保证了系统的可用性,牺牲了数据一致性。
5.3 半同步复制技术
用户发出写请求后,主数据存储会执行写操作,并给备数据存储发送同步请求,但主数据存储不用等待所有备数据存储回复数据
同步成功便可响应用户
两种方案
- 当主数据存储收到多个备数据存储中的某一个回复数据同步成功后,便可给用户响应写操作完成
- 主数据存储等超过一半节点(包括主数据存储)回复数据更新成功后,再给用户响应写操作成功
5.4 对比
| 一致性 | 可用性 | 应用场景 | 典型的框架/系统 | |
|---|---|---|---|---|
| 同步复制技术 | 强 | 弱 | 适用于一主一备或对数据一致性有严格要求的场景,比如与金融相关的分MySQL布式数据库 | MySQL |
| 异步复制技术 | 弱 | 强 | 适用于对性能要求很高的场景,比如直接服务用户的网站或App后台的数据库或缓存 | MySQL、Redis、Oracle |
| 半同步复制技术 | 较强 | 较弱 | 适用于大多数的分布式场景 | MySQL,ZooKeeper,Cloud SQL Server、Etcd、Oracle等 |
六、数据缓存技术
分布式缓存就是指在分布式环境或系统下,把一些热门数据存储到离用户近、离应用近的位置,并尽量存储到更快的设备,以减少远程数据传输的延迟,让用户和应用可以很快访问到想要的数据。分布式数据缓存,属于计算机应用中的缓存的一种。而计算机应用中的缓存,一般指内存,内存存储了用户经常访问的数据,用户或应用不再需要到磁盘中去获取相应的数据,大幅提高访问速度。
6.1 常见缓存服务对比
| Memcached | Redis |
|---|---|
| 基于内存 | 基于内存+磁盘 |
| 支持简单Key/Value | 支持简单Key/Value,也支持复杂类型 |
| 不支持同步,需要借助第三方工具 | 异步复制,支持完整重复制+部分重复制 |
参考资料
原文作者:雨落俊泉;如有侵权,请联系管理员删除。

