1 核心概念
1.1 搜索引擎
- ElasticSearch功能的核心是搜索引擎,学习搜索引擎的基础知识对于加深ElasticSearch核心概念的理解大有裨益。
1.1.1 全文索引
-
全文检索(Full-Text Search)
-
是一种从大量文本数据中快速检索出包含指定词汇或短语的信息的技术。它允许用户输入一个或多个关键词,系统会在预先建立好的索引中查找包含这些关键词的文档或文档片段,并返回给用户;
-
广泛应用于搜索引擎、文档管理系统、电子邮件客户端、新闻聚合网站等信息管理系统和应用中,帮助用户快速定位所需信息,提升检索效率和准确性;
查询:有明确的搜索条件边界。例如“年龄15~25岁”“颜色=红色”“价格<3000”,条件(如15、25、红色、3000)有明确范围界定;
检索(全文检索):无搜索条件边界,召回结果取决于相关性。同义词、谐音、别名、错别字、混淆词、网络热梗等均可作为相关性判断依据;
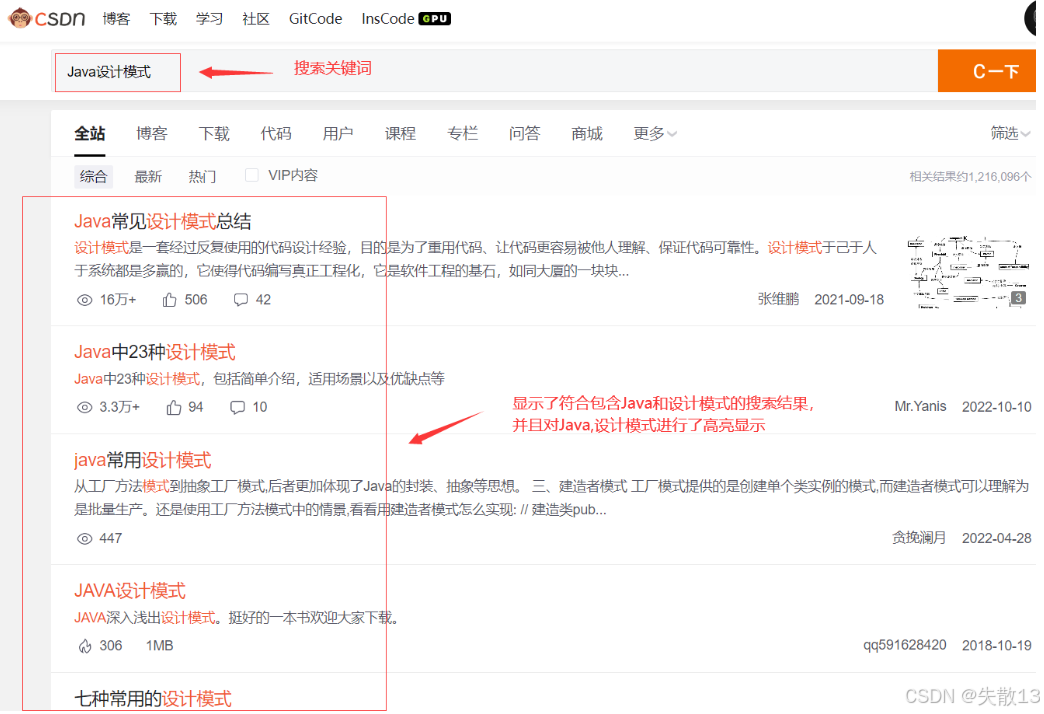
-
-
传统关系型数据库实现全文检索的问题。以MySQL为例,若用
select * from t_blog where content like "%Java设计模式%"这类SQL查询,需要遍历所有记录进行匹配,存在两大问题:-
效率极低:数据量庞大时,查询耗时严重;
-
结果不符合预期:无法处理同义词、错别字等相关性场景,检索精准度和灵活度不足;
-
-
全文检索的实现原理
-
文本预处理与索引建立:首先对文本数据进行分词、去除停用词等处理;然后通过**倒排索引(inverted index)**建立索引——倒排索引将“单词”映射到“包含该单词的文档列表”,同时记录词频、权重等元数据,从而实现快速定位相关文档;
-
用户查询与结果返回:当用户发起搜索请求,搜索引擎根据关键词在索引中查找匹配文档;再通过相关性计算对文档排序,最终返回结果。用户还可通过搜索策略、过滤条件来控制结果质量和范围。
-
1.1.2 倒排索引
-
在文档集合中,每个文档可视为“词语的集合”,倒排索引是将“词语”映射到“包含该词语的文档”的数据结构;
-
正排索引(正向索引)与倒排索引的对比:
类型 定义与特点 适用场景与示例 正排索引 将文档按顺序排列并编号,每个文档包含完整文本内容及标题、作者等属性;
可根据文档编号/属性快速定位文档,但大文本数据集下存储和查询效率受限适合文档整体检索/展示场景,如MySQL中通过 ID查找数据倒排索引 按“单词/短语”建立索引,将每个单词映射到包含它的文档列表;
需先对文档分词,记录单词出现的文档、位置等信息,支持关键词快速检索和相关性排序适合大规模文本数据的关键词搜索、相关性排序场景,如搜索引擎的关键词检索 -
倒排索引的结构示例:
关键词 文章ID 是否命中索引 Java 1,2 √ 设计模式 1,2,3,4 √ 多线程 2 JavaScript 4 -
倒排索引的实现步骤:
-
文档预处理:对文档进行分词处理(拆分词语)、移除停用词(如“的、了、在”等无意义词汇)、词干提取(如将“运行”“运行中”归为同一词干)等操作;
-
构建词典:将预处理后的词汇加入词典,为每个词汇分配唯一ID;
-
创建倒排列表:对词典中每个词汇,记录它在哪些文档中出现,以及在文档中的位置信息(如段落、行号);
-
存储索引文件:将词典和倒排列表存储到磁盘索引文件中,通常会压缩处理以减少存储空间、提升查询效率;
-
查询处理:用户发起搜索时,搜索引擎从词典中查找关键词对应的倒排列表,根据文档ID快速定位包含关键词的文档。
-
1.2 常用术语
-
MySQL与ElasticSearch概念对比:
MySQL 概念 ElasticSearch 对应概念/特性 Table(表) Index(索引) Row(行) Document(文档) Column(列) Field(字段) Schema(模式) Mapping(映射) Index(索引,MySQL的索引) Everything is indexed(所有字段都可索引化) SQL(结构化查询语句) Query DSL(查询语句) Select * from table(查询语句)GET http://...(RESTful API 查询)Update table SET ...(更新语句)PUT或POST http://...(RESTful API 新增/更新)- 注意:ElasticSearch 6.X及之前版本中,索引类似SQL数据库,
type(类型)类似表;但从7.x版本开始,type被弃用,一个索引只能包含一个文档类型;
- 注意:ElasticSearch 6.X及之前版本中,索引类似SQL数据库,
-
索引(Index):ElasticSearch 中用于存储和管理相关数据的逻辑容器,可类比为数据库中的“表”。它包含一组结构相似的文档,数据以JSON格式存储在索引内。每个索引有唯一的小写名称,用于执行搜索、更新、删除等操作。通过划分不同索引,用户可更高效地管理和查询数据;
-
映射(Mapping)
-
类比关系型数据库的“Schema(表结构)”,用于定义索引中文档的字段名称、字段类型、分词规则、是否索引/存储等属性;
-
示例代码如下,创建
employee索引的映射时,需指定各字段的类型(如name为keyword类型、age为integer类型),以及文本字段的分词器(如address用ik_max_word分词、remark用ik_smart分词)。业务中需根据需求细分索引,并为每个索引设计固定的映射结构;
-
-
文档(Document)
-
ElasticSearch 的基本存储单元,是存储在索引中的JSON对象,类比数据库中的“行”。文档由键值对构成,键是字段名,值可以是字符串、数字、布尔、对象等数据类型;
-
文档包含元数据(用于标注文档信息):
-
_index:文档所属的索引名 -
_type:文档所属的类型名(7.x及以上版本已弃用) -
_id:文档唯一ID -
_source:文档的原始JSON数据 -
_version:文档版本号(修改/删除操作会自增) -
_seq_no:数据更改的累计序列号(Shard级别严格递增) -
_primary_term:用于恢复数据时处理冲突,Primary Shard 重分配时递增
-
-
2 ElasticSearch 索引操作详解
2.1 索引的实战场景
-
索引是具有相同结构的文档的集合,由唯一索引名称标定。一个ElasticSearch集群中可包含多个索引,不同索引代表不同业务类型的数据;
-
场景一:将采集的不同业务类型数据分别存储到专属索引,各索引的字段个数、名称、类型可不完全一致
-
微博业务:对应索引
weibo_index -
新闻业务:对应索引
news_index -
博客业务:对应索引
blog_index
-
-
场景二:针对日志数据,按时间维度切分索引,以平衡数据量规模、检索性能等
-
2024年7月日志:对应索引
logs_202407 -
2024年8月日志:对应索引
logs_202408
这类索引属于“同一类业务(日志)”,但通过时间切分来优化存储和检索效率。
-
2.2 索引的基本操作
2.2.1 创建索引
-
创建索引的基本语法。通过
PUT请求创建索引,语法结构如下: -
索引名称(index_name):必须为小写字母,可包含数字和下划线;
-
索引设置(settings):用于配置索引的底层属性。核心包含两类:
-
分片数量(number_of_shards):决定索引的并行度和数据分布。示例:
-
副本数量(number_of_replicas):提高数据的可用性和容错能力。示例:
-
-
映射(mappings)。定义索引中文档的字段及其类型,常用字段类型包括
text(文本,支持分词检索)、keyword(关键字,精确匹配)、integer(整数)、float(浮点数)、date(日期)等。示例: -
创建索引的不同方式示例
-
方式1:只定义索引名,
settings和mappings取默认值 -
方式2:自定义
settings和mappings创建名为
student_index的索引,设置字段:-
name(学生姓名):text类型 -
age(年龄):integer类型 -
enrolled_date(入学日期):date类型
-
-
2.2.2 删除索引
-
删除单个索引
-
基本语法
-
例:删除名为
student_index的索引
-
-
删除多个索引
-
基本语法(两种方式)
-
逗号分隔多个索引名:
-
使用通配符
*匹配符合规则的索引(谨慎使用,避免误删):
-
-
例
-
删除
weibo_index和news_index两个索引: -
删除所有以
logs_开头的日志索引(如logs_202407、logs_202408):
-
-
-
删除所有索引(极度危险,禁止在生产环境使用)。通过通配符
*匹配所有索引,执行后会删除集群中所有索引,数据不可恢复: -
注意
-
不可逆操作:删除索引后,索引中的所有文档和数据会被永久删除,无法恢复,操作前务必确认。
-
权限控制:生产环境中应限制删除索引的权限,避免误操作。
-
通配符风险:使用
*时需严格检查匹配规则,防止误删无关索引。
-
-
执行删除请求后,ElasticSearch 会返回操作结果,若成功,
acknowledged字段为true。
2.2.3 查询索引
-
查询操作分为两类:
-
检索索引信息:获取索引本身的元数据(如设置、映射等);
-
搜索索引中的文档:在指定索引内根据条件检索文档数据;
-
-
检索索引信息
-
基本语法
-
例:获取名为
myindex的索引信息
-
-
搜索索引中的文档
-
基本语法
-
例:搜索
student_index中name字段包含John的文档:
-
2.2.4 修改索引
-
动态更新索引的settings部分:用于更新索引的配置(如副本数量等)
-
基本语法
-
例:将
student_index的副本数量更新为 2
-
-
动态更新索引的部分mapping字段信息(添加新字段):用于向索引中新增字段,需指定字段名称和类型
-
基本语法
-
例:向
student_index添加一个名为grade的新字段,类型为integer
-
2.2.5 实践练习
-
需求:向
student_index添加名为grade的integer类型新字段,并将副本数量更新为 2; -
步骤1:创建
student_index索引(基础结构)name(学生姓名):text类型age(年龄):integer类型enrolled_date(入学日期):date类型
-
步骤2:更新副本数量(settings)
-
步骤3:添加
grade字段(mapping)
2.3 索引别名详解
2.3.1 为什么需要别名
-
ElasticSearch创建索引后不允许修改索引名,但有一些业务场景(比如下面列举的两个)需要更灵活的索引管理,因此引入“索引别名”:
-
场景1:面对PB级增量数据,若按日期切分了数十/数百个索引(如日志索引),每次检索都指定多个索引会非常繁琐;
-
场景2:线上索引设计不合理(如字段分词错误),需在不更改业务代码的前提下“无缝切换索引”,保证服务不中断;
-
-
索引别名可指向一个或多个索引,并能在所有需要索引名称的API中使用,具备以下灵活能力:
-
透明切换索引:在运行中的集群上,可在两个索引之间无缝切换(如替换设计不合理的索引);
-
分组组合多个索引:将多个索引按业务逻辑分组,例如用
last_three_months别名组合过去3个月的日志索引(logstash_202303、logstash_202304、logstash_202305); -
创建文档子集“视图”:在索引的文档子集上建立别名,缩小检索范围,提升检索效率;
-
-
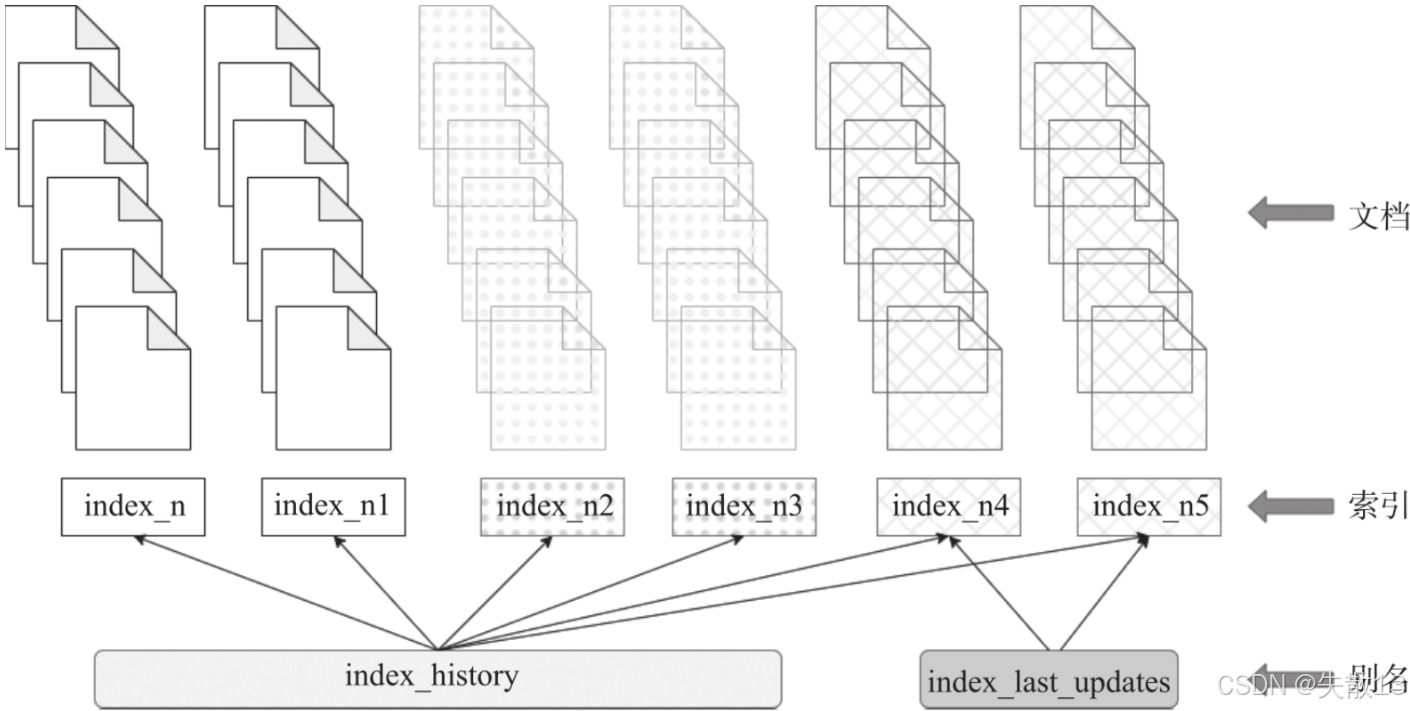
下图中展示了多个索引(
index_n、index_n1、index_n2、index_n3、index_n4、index_n5)与别名的映射关系-
别名
index_history关联了index_n、index_n1、index_n2等多个历史类索引; -
别名
index_last_updates关联了index_n4、index_n5等最新更新类索引;
-
-
通过别名,业务可以通过统一的别名检索多个索引,无需关注底层索引的具体名称和数量,实现了索引与业务代码的“松耦合”。
2.3.2 创建索引时指定别名
-
在创建索引的请求中,通过
aliases字段直接为索引指定别名; -
为已有索引添加别名:使用
_aliasesAPI,通过add操作给现有索引添加别名。-
基本语法
-
代码示例:为
my_index索引添加别名my_index_alias
-
2.3.3 多索引检索的实现方案
-
不使用别名的方案。无需依赖索引别名,直接对多个索引进行检索,包含两种方式:
-
方式一:使用逗号分隔多个索引名称
-
方式二:使用通配符进行多索引检索(如以
tlmall_logs_开头的所有索引)
-
-
使用别名的方案。通过为多个索引关联同一个别名,实现“以别名代指多个索引”的检索,分为两步:
-
使别名关联已有索引。通过
_aliasesAPI 为多个物理索引添加同一个别名 -
使用别名进行检索。通过别名即可检索其关联的所有索引,示例:
-
-
检索效率与注意事项
-
检索效率:若别名指向的物理索引与直接检索的索引一致,检索效率完全相同(因为别名只是物理索引的“软链接”);
假设场景:有3个日志索引
logs_202401、logs_202402、logs_202403,我们给这3个索引添加了一个共同的别名logs_2024_q1(代表2024年第一季度的日志)。-
情况1:直接检索多个物理索引。如果要查询这3个索引中包含“error”的日志,请求如下:
- ElasticSearch 的执行逻辑是:
-
解析请求中的3个物理索引名称;
-
分别在这3个索引中执行查询,找到包含“error”的文档;
-
合并结果并返回;
-
- ElasticSearch 的执行逻辑是:
-
情况2:通过别名检索(别名指向相同的物理索引)。同样查询包含“error”的日志,但使用别名
logs_2024_q1,请求如下:- ElasticSearch 的执行逻辑是:
-
解析别名
logs_2024_q1,找到它关联的3个物理索引(logs_202401、logs_202402、logs_202403); -
后续步骤与“直接检索”完全一致:分别在这3个索引中查询、合并结果。
-
- ElasticSearch 的执行逻辑是:
两种方式最终操作的物理索引完全相同,查询逻辑和执行步骤也完全一致,因此检索效率没有区别。别名的作用只是“简化索引名称的书写”,本质是物理索引的“软链接”,不会额外增加性能开销。
-
-
注意事项:
- 建议为同一别名关联的物理索引设置一致的映射结构,以提升检索效率;
- 别名适合发挥检索优势,但写入/更新操作仍需使用物理索引。
-
3 ElasticSearch 文档操作详解
3.1 文档的介绍
- 作为ElasticSearch的基本存储单元,文档是指存储在ElasticSearch索引中的JSON对象。
3.2 文档的基本操作
3.2.1 新增文档
3.2.1.1 新增单个文档
-
在 ES 8.x 中,新增文档可通过
POST或PUT请求实现,核心区别在于是否指定文档唯一标识(ID); -
使用 POST 请求新增文档(不指定 ID)。当不指定文档 ID 时,ES 会自动生成唯一 ID。语法如下:
-
使用 PUT 请求新增文档(指定 ID)。当指定文档 ID 时,若 ID 不存在则创建新文档;若 ID 已存在则替换现有文档。语法如下:
-
PUT 和 POST 的区别:
对比维度 PUT 请求 POST 请求 指定文档 ID 必须指定唯一 ID;ID 存在则替换文档,不存在则创建新文档 可指定或不指定 ID;不指定时 ES 自动生成唯一 ID 幂等性 幂等(多次执行相同请求,结果一致) 非幂等(多次执行相同请求可能创建多个文档) 更新行为 更新时替换整个文档内容(即使未修改的字段也会被覆盖) 可通过 _updateAPI 只更新特定字段,无需替换整个文档 -
示例:
-
为
employee索引新增文档(ES 自动生成 ID,用 POST 请求不指定 ID 新增单条文档): -
为
employee索引新增 ID 为1的文档(用 PUT 请求指定 ID 新增单个文档):
-
3.2.1.2 批量新增文档
-
基本语法:
-
在 ElasticSearch 8.x 中,通过
_bulkAPI 实现批量操作(包含新增、更新、删除等)。请求格式要求每个操作是独立的 JSON 对象,交替出现形成请求体,且每个操作对象开头必须是index、update或delete,操作之间用空行分隔; -
基本语法结构如下:
-
-
_bulk API 共支持四种操作类型,功能和行为如下:
-
Index:用于创建新文档或替换已有文档(若文档 ID 已存在,会覆盖原有内容)
-
Create:仅在文档不存在时创建;若文档已存在,直接返回错误
-
Update:用于更新现有文档的指定字段(需配合
_op_type: "update"和doc字段) -
Delete:用于删除指定 ID 的文档
-
-
示例:
-
Create 操作示例(文档不存在则创建,存在则报错)。向
article索引批量创建文档,ID 为 3 和 4: -
Index 操作示例(创建新文档或替换已有文档)。向
article索引批量创建/替换文档,ID 为 3 和 4:
-
3.2.1.3 实践练习:批量插入员工信息
-
创建员工索引:
-
批量插入员工文档:
-
每个
index操作对象后紧跟对应的文档内容,交替出现形成请求体; -
批量操作通过
_bulkAPI 实现,可大幅提升批量插入的效率,减少网络往返次数。
-
3.2.2 查询文档
3.2.2.1 根据id查询文档
-
在 ElasticSearch 8.x 中,通过
GET请求配合索引名和文档ID,可查询单个文档; -
使用
_mgetAPI,可在单个请求中指定多个文档ID,批量查询多个文档; -
单个文档查询示例:从
employee索引中检索ID为1的文档 -
多个文档批量查询示例:从
employee索引中批量检索ID为1、2、3的文档
3.2.2.2 根据搜索关键词查询文档
-
在 ElasticSearch 8.x 中,查询文档主要使用 Query DSL(基于JSON的领域特定语言),通过
_searchAPI 实现。基本请求格式为: -
匹配所有文档(
match_all)。用于检索索引中所有文档,语法如下: -
文本字段匹配(
match)。对指定文本字段进行分词匹配,适合全文检索场景。语法如下: -
精确匹配(
term,不分词)。对字段进行精确值匹配(字段需为keyword、integer等不分词类型)。语法如下: -
范围查询(
range)。对数值、日期等字段进行范围筛选,支持gte(大于等于)、lte(小于等于)等操作符。语法如下: -
例(基于
employee索引)-
精确匹配:姓名是“张三”的员工
-
文本字段匹配:地址包含“广州白云山”的员工
-
范围查询:年龄在20至26岁之间的员工
-
3.2.3 删除文档
3.2.3.1 删除单个文档
-
通过
DELETE请求配合索引名和文档ID,可删除指定的单个文档; -
基本语法:
-
例:删除员工ID为1的文档
3.2.3.2 批量删除文档
-
方式1:使用
_bulkAPI 批量删除。通过_bulkAPI 发送多个删除操作的JSON对象,每个对象指定要删除的索引和文档ID:-
基本语法:
-
例:删除员工ID为3和4的文档
-
-
方式2:使用
_delete_by_queryAPI 按条件删除。根据查询条件(如文本匹配、范围查询等)删除符合条件的文档:-
基本语法:
-
例:删除地址包含“广州”的员工文档
-
3.2.4 更新文档
3.2.4.1 更新单个文档
-
通过
_update接口实现部分字段更新,无需替换整个文档; -
基本语法:
-
例:更新员工ID为1的文档,修改age字段为28
3.2.4.2 批量更新文档
-
方式1:使用
_bulkAPI 批量更新。通过_bulkAPI 发送多个更新操作的JSON对象,每个对象指定要更新的索引、文档ID及字段内容-
基本语法:
- 每个
update块代表一个更新操作 _index和_id指定了要更新的文档doc部分包含了更新后的文档内容upsert部分定义了如果文档不存在时应该插入的内容
- 每个
-
例:更新员工ID为3和4的文档,分别修改age字段
-
-
方式2:使用
_update_by_queryAPI 按条件更新。根据查询条件(如term、match等)批量更新文档,操作具有原子性(要么所有匹配文档都更新,要么都不更新)-
基本语法:
<index_name>是要更新的索引名称query部分定义了哪些文档需要被更新script部分定义了如何更新这些文档的字段
-
例:更新姓名为“张三”的员工,将age字段设为30
-
3.2.4.3 并发场景下更新文档如何保证线程安全
-
在 ElasticSearch 7.x 及以后版本中,通过
_seq_no(文档在特定分片的序列号) 和_primary_term(文档所在主分片的任期编号) 替代旧版本的_version字段,共同构成文档的唯一版本标识符,用于实现乐观锁机制,确保高并发环境下文档更新的一致性; -
在高并发场景下,更新文档时需携带当前文档的
_seq_no和_primary_term,语法如下: -
例:更新
employee索引中 ID 为 1 的文档,携带seq_no=13和primary_term=1 -
若请求中携带的
_seq_no和_primary_term与文档当前版本不一致,ElasticSearch 会抛出version_conflict_engine_exception异常,提示版本冲突,如下: -
这一机制确保了高并发场景下,只有基于“最新版本”的更新会被执行,避免了数据不一致问题。
3.2.5 实践练习
-
需求:实现某金融企业理财平台的理财产品信息检索功能;
-
该企业的理财产品信息如下:
-
创建索引(
product_info) -
新增文档(批量插入理财产品数据)
-
全文检索:匹配描述含“每天收益到账消息推送”的产品
-
按查询条件检索:年化率在3.0000%~3.1300%之间的产品
4 ElasticSearch 文件建模
4.1 ElasticSearch 处理关联关系
4.1.1 概述
-
ElasticSearch 多表关联的问题是讨论最多的问题之一。多表关联通常指一对多或者多对多的数据关系,如博客及其评论的关系;
-
ElasticSearch 并不擅长处理关联关系,一般会采用以下四种方法处理关联:
-
嵌套对象(Nested Object)
-
适用场景:一对少量、子文档偶尔更新、查询频繁的场景(如博客与评论的关系)。若需索引对象数组并保持每个对象的独立性,需用
Nested类型而非Object类型 -
优点:可将父子关系数据关联(如博客与评论),支持基于
Nested类型的任意查询 -
缺点:查询相对较慢;更新子文档时需更新整篇文档
-
-
Join父子文档类型
-
适用场景:在同一索引的文档中创建父子关系,适用于子文档数据量明显多于父文档的场景(如产品与供应商的一对多关系)
-
优点:父子文档可独立更新
-
缺点:维护
Join关系会占用部分内存;查询较Nested类型更耗资源 -
查询方式:使用
has_child或has_parent进行父子关联查询
-
-
宽表冗余存储
-
适用场景:一对多或多对多的关联关系
-
优点:检索速度快
-
缺点:索引更新/删除数据时,需处理冗余数据;因冗余存储,部分搜索和聚合操作结果可能不准确
-
-
业务端关联
-
适用场景:数据量少的多表关联业务场景
-
实现方式:在应用接口层面处理关联,存储层用两个独立索引,业务层通过两次请求完成关联
-
优点:数据量少时用户体验好
-
缺点:数据量多时,两次查询耗时较长,影响用户体验
-
4.1.2 案例1:博客作者信息变更
-
数据模型设计(对象类型):在博客文档中内嵌作者信息,即每篇博客文档都包含作者的
userid、username、city等字段。若作者信息变更,需修改所有关联的博客文档; -
通过
PUT请求定义blog索引的字段映射:-
content:text类型(支持博客内容的全文检索) -
time:date类型(存储博客发布时间,支持日期范围查询) -
user:嵌套对象,包含子字段:userid:long类型(作者ID,精确数值)username:keyword类型(作者名称,精确匹配)city:text类型(作者所在城市,支持分词检索)
-
-
通过
PUT请求向blog索引插入ID为1的博客文档,包含博客内容、发布时间及作者信息: -
通过
_searchAPI 结合bool查询,同时匹配“博客内容含ElasticSearch”和“作者名为Shisan”的文档
4.1.3 包含对象数组的文档
-
数据模型设计(对象数组场景):以电影索引
my_movies为例,文档中包含演员对象数组actors,每个演员对象含first_name(名字)和last_name(姓氏)字段; -
通过
PUT请求定义my_movies索引的字段映射:-
actors:对象类型,包含子字段first_name(keyword类型,精确匹配)和last_name(keyword类型,精确匹配); -
title:text类型(支持电影名称的全文检索),同时开启keyword子字段(支持名称的精确匹配,ignore_above: 256表示超过256字符的内容不做精确匹配);
-
-
通过
POST请求向my_movies索引插入ID为1的电影文档,包含电影名称Speed和演员对象数组(Keanu Reeves、Dennis Hopper): -
通过
_searchAPI 结合bool查询,尝试匹配“演员名为Keanu且姓氏为Hopper”的文档: -
问题:会意外匹配到电影
Speed,但实际逻辑中“Keanu”的姓氏是“Reeves”,“Hopper”的名字是“Dennis”,该结果不符合预期;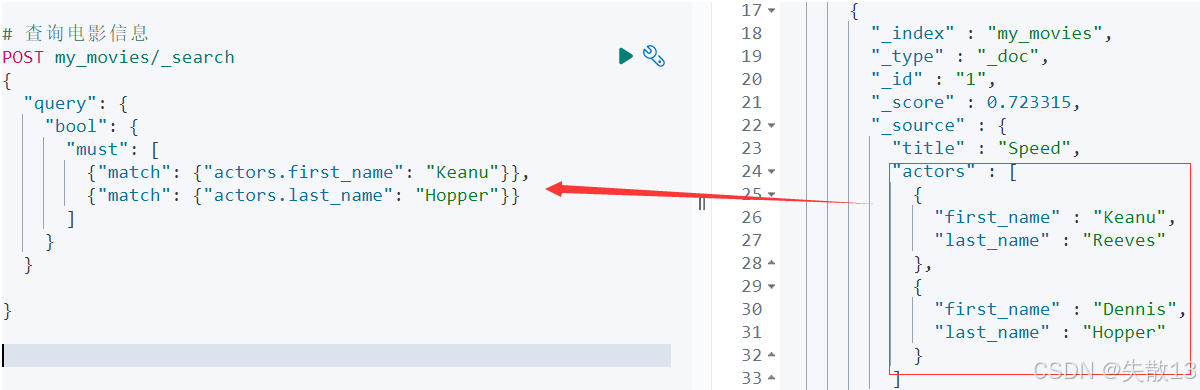
-
原因:ElasticSearch 存储对象数组时,会将其扁平化处理(如
actors.first_name合并为["Keanu", "Dennis"],actors.last_name合并为["Reeves", "Hopper"])。当多字段查询时,会出现“跨对象匹配”的意外结果; -
解决方案:使用
Nested数据类型替代普通对象类型,保持数组中每个对象的独立性,确保查询时仅在同一对象内的字段间匹配。
4.1.4 嵌套对象(Nested Object)
-
Nested 数据类型的定义
-
核心作用:允许对象数组中的每个对象被独立索引,解决普通对象数组“扁平化存储导致跨对象匹配”的问题;
-
实现原理:使用
nested和properties关键字,将对象数组拆分为多个分隔的文档;内部存储为两个Lucene文档,查询时通过Join处理保证对象内字段的关联性;
-
-
通过
PUT请求定义my_movies索引的映射,其中actors字段类型为nested,确保演员对象数组的独立性: -
通过
POST请求向my_movies索引插入ID为1的电影文档,actors为嵌套对象数组: -
使用
nested查询语法,指定path为actors,确保仅在同一演员对象内的first_name和last_name间匹配: -
需通过
nested聚合语法指定path,才能对嵌套对象的字段进行聚合(普通聚合不支持嵌套对象):
4.1.5 Join父子关联类型
-
技术背景:Join类型的设计初衷
-
普通对象/Nested对象的局限:更新时需重新索引整个对象(包括根对象和嵌套对象)
-
Join类型的优势:通过维护
Parent/Child关系,分离两个独立文档。父、子文档可独立更新,互不影响(更新父文档不影响子文档,子文档的增删改也不影响父文档和其他子文档)
-
4.1.5.1 Mapping设置:定义父子关系
-
通过
join类型的字段(如blog_comments_relation),在映射中声明父子关系(如blog为父、comment为子):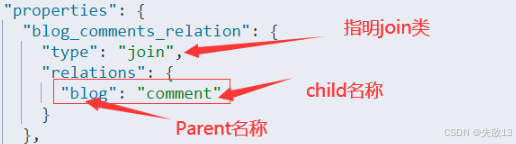
4.1.5.2 文档索引:分别索引父、子文档
-
索引父文档。通过
PUT请求索引父文档,需在join字段中声明类型为父类型(如blog)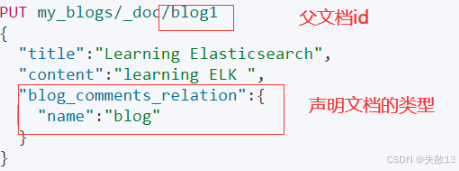
-
索引子文档。通过
PUT请求索引子文档,需指定routing参数(与父文档ID一致,确保父子同分片),并在join字段中声明类型为子类型(如comment)及父文档ID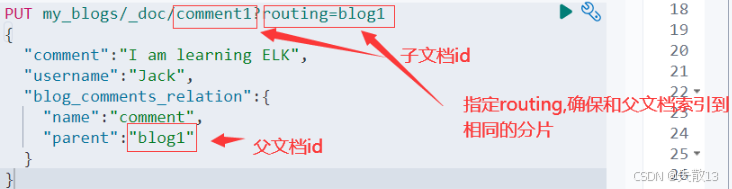
-
注意:父子文档必须在同一分片上(通过
routing参数保证),否则Join查询性能会受影响。
4.1.5.3 查询与更新:父子关联的操作
-
查询所有文档:
POST /my_blogs/_search -
根据父文档ID查询:
GET /my_blogs/_doc/blog2 -
parent_id查询:根据父文档ID查询子文档
-
has_child查询:根据子文档条件查询父文档
-
has_parent查询:根据父文档条件查询子文档
-
访问子文档: 带routing确保分片正确
-
更新子文档:需携带
routing参数,保证与父文档同分片
4.1.5.4 多表关联方案对比
-
在 ElasticSearch 开发实战中,需突破关系型数据库的设计思维定式,不建议做多表关联操作。推荐采用扁平的宽表模型,或尽量将业务转化为无关联关系的文档形式,通过文档建模提升检索效率;
-
四种关联方案对比:
方案类型 优点 缺点 适用场景 Nested嵌套类型 文档存储在一起,读取性能高 更新嵌套子文档时需更新整篇文档,查询相对较慢 一对少量、子文档偶尔更新、查询频繁的场景 Join父子文档类型 父子文档可独立更新,互不影响 Join关系维护耗内存,读取性能比Nested差 子文档更新频繁的场景 宽表冗余存储 以空间换时间,检索速度快 字段冗余导致存储空间浪费,部分聚合/搜索结果不准确 一对多或多对多的关联关系 业务端关联 数据量少时用户体验好 数据量多时两次查询耗时久,影响用户体验 数据量少的多表关联业务场景
4.2 ElasticSearch 文档建模的最佳实践
4.2.1 如何处理关联关系
- 根据场景选择不同的关联模型:
-
Object类型:优先考虑反范式(Denormalization),将关联数据嵌入文档,提升读取性能
-
Nested类型:当数据包含多数值对象,且有精确查询需求时使用(如对象数组需保持字段关联性)
-
Child/Parent(Join类型):适用于关联文档更新非常频繁的场景,父子文档可独立更新,互不影响
-
4.2.2 避免过多字段
-
过多字段的弊端
-
维护困难:字段数过多不易管理
-
集群性能影响:Mapping信息存储在
Cluster State中,字段过多会增大数据量,拖累集群性能 -
操作成本高:删除或修改字段需执行
reindex操作
-
-
字段数限制:Elas ticsearch 默认最大字段数为1000,可通过
index.mapping.total_fields.limit参数自定义限定; -
生产环境建议关闭
dynamic参数,避免自动新增字段,使用strict模式严格控制字段:-
true(默认):未知字段会被自动索引并加入Mapping -
false:新字段不会被索引,但会保存在_source中 -
strict:新增字段不会被索引,且文档写入失败(确保字段结构严格可控)
-
-
例(
user索引设置dynamic: strict,插入含新增字段age的文档会报错): -
对于多属性字段(如cookie、商品属性),可考虑使用Nested类型进行建模,保证字段关联性与检索精度。
4.2.3 避免正则、通配符、前缀查询
-
正则、通配符查询、前缀查询都属于 Term 查询,但性能较差。尤其当通配符放在开头时,会引发“性能灾难”(需遍历大量倒排索引项)。因此,实战中应尽量规避这类查询,优先采用更高效的建模和查询方式;
-
例:版本号搜索的优化实现
-
通过结构化建模版本号字段,替代低效的通配符/正则查询,提升检索性能;
-
Mapping 设计(
softwares索引)。将版本号拆分为多个结构化字段,避免对版本字符串的模糊查询:-
version.display_name:keyword类型(存储版本号的显示名称,如“7.1.0”) -
version.marjor:byte类型(主版本号,如“7”) -
version.minor:byte类型(次版本号,如“1”) -
version.hot_fix:byte类型(热修复版本号,如“0”)
-
-
向
softwares索引插入3条包含版本结构化信息的文档: -
通过
bool查询的filter子句,对主版本号(marjor)和次版本号(minor)进行精确匹配,替代低效的模糊查询:
-
4.2.4 避免空值引起的聚合不准
-
通过
null_value配置将空值映射为指定值(如0),确保聚合计算准确; -
例:
-
Mapping 设计:为
score字段设置null_value: 0,空值会被映射为0 -
写入文档:包含有值和空值的文档
-
聚合查询:计算
score的平均值时,空值会以0参与计算,保证聚合结果准确
-
4.2.5 为索引的Mapping加入Meta信息
-
Mapping 设计需从**功能(搜索、聚合、排序)和性能(存储开销、内存开销、搜索性能)**两个维度考量,且是迭代过程。为便于版本管理,可在Mapping中加入
_meta元信息,甚至将Mapping文件纳入Git管理; -
例:在索引
my_index的Mapping中加入_meta字段,存储映射版本信息 -
Mapping设置是一个迭代的过程:
-
新增字段较容易(必要时用
update_by_query) -
更新/删除字段不允许,需通过
Reindex重建数据 -
加入
_meta可实现Mapping版本管理,推荐结合Git进行版本追踪
-
原文作者:失散13;如有侵权,请联系管理员删除。

