1 引言
简单介绍一下在TensorFlow中调用GPU,以及TensorFlow与Docker、Kubernetes相结合的方法。主要参考了TensorFlow官方文档中相关的Tutorial、Guide和API Doc。仅做抛砖引玉,英文好的朋友建议去看看源文档。
2 TensorFlow中的GPU
TensorFlow对多种硬件都提供了支持,比如常见的CPU、GPU和TPU。由于GPU是在计算深度学习时最常见的设备,在接下来,本文将对GPU的分布式计算做进一步的介绍。
2.1 记录和指定执行设备
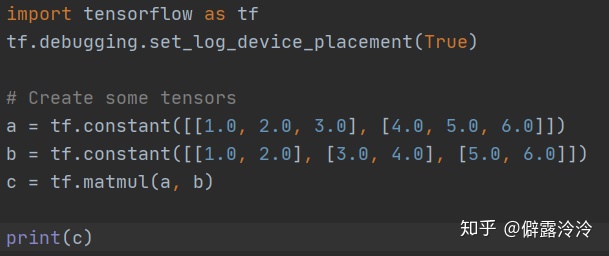
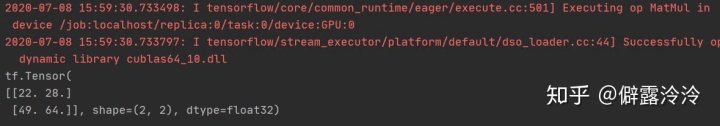
当一台服务器同时拥有CPU和GPU,并且要执行的操作也同时支持CPU和GPU时,GPU拥有的优先级会更高。比如tf.matmul同时拥有CPU和GPU内核,如果一个系统此时同时包括CPU和GPU设备,在未指定的情况下,TensorFlow会默认选择GPU(函数tf.device()可以用于指定执行设备)。如果想要确定在程序运行过程中哪些操作是由哪些设备执行的,可以再程序的开始部分添加代码:
tf.debugging.set_log_device_placement(True)
这一段代码会打印出张量在存储和运算时使用的每一台设备。
2.2 限制显存增长
在默认情况下,TensorFlow会占用所有的GPU和所有的显存。为了满足更多个性化的需求,还可以在TensorFlow中对使用的GPU和显存大小进行限制。函数tf.config.experimental.set_visible_devices()可以限制TensorFlow使用的GPU。
2.3 使用多个GPU
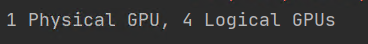
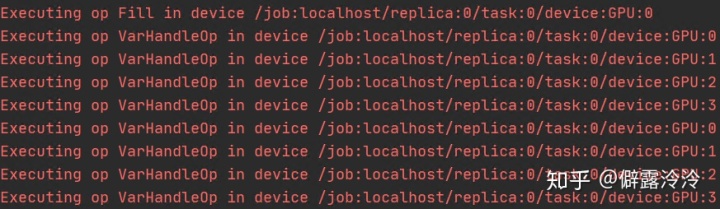
Tensorflow中提供的虚拟化技术,tensorflow既可以将一个物理GPU虚拟成多个逻辑GPU,也可以反其道而行之:将多个物理GPU虚拟成为一个逻辑GPU。代码如下,运行结果见图 2‑3。
第3章 分布式训练
tf.distribute.Strategy,跨多个处理单元(processing units),现有模型,少量修改,进行分布式训练。
单机多卡:将所有模型变量复制到每个处理单元中,使用all-reduce整合所有处理器的梯度(gradients),并将整合结果应用于所有副本。
分布式训练分为异步训练与同步训练。同步训练中的每一个工作结点都同时输入数据,同时聚合在模型每一层计算中产生的梯度。异步训练则与之相反,在异步训练中,每一个工作结点在输入数据和计算梯度时都是独立的。通常同步训练时采用all-reduce,异步训练采用服务器架构。
分布式训练的硬件平台主要包括两种:单台服务器多GPU和通过网络连接的多台服务器
3.1 All Reduce
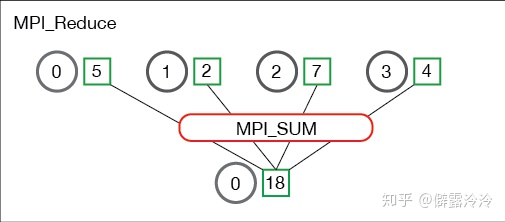
Reduce是函数式编程中的一个经典概念,指的是通过一个函数对原有数据进行聚合操作,聚合的具体方式可以使多种多样的,如相加、相乘或者字符串、数组间的拼接,见下图。
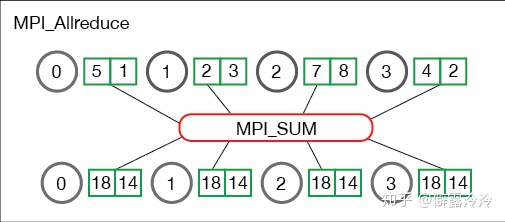
All-reduce是指在并行运算中让所有进程都进行reduce操作而不是只在根进程进行reduce。
3.2 分发策略
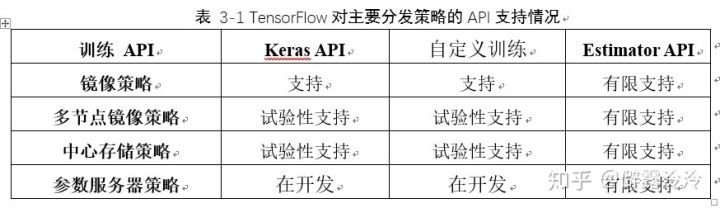
TensorFlow中的分发策略主要有4中:镜像策略(Mirrored Strategy)、多节点镜像策略(Multi-Worker Mirrored Strategy)、中心存储策略(Central Storage Strategy)、参数服务器策略(Parameter Server Strategy)。TensorFlow对这些分发策略的API支持情况可以参见表1。在表 3‑1中,试验性支持意味着功能不稳定,尚未覆盖所有可能的情况。需要注意的是,除了这4种策略以外,TensorFlow同样支持自定义分发策略。
本小节接下来的内容个将对这4中主要的策略和使用方法进行进一步的介绍。
3.2.1 镜像策略(Mirrored Strategy)
单机多GPU的同步分布式训练
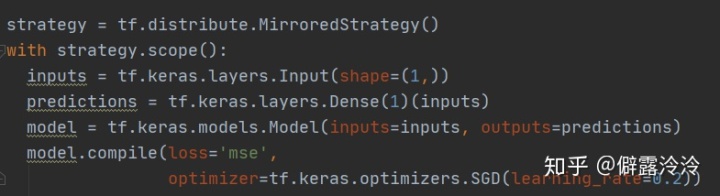
为每一个GPU设备创建一个副本,模型中的每一个参数都会通过镜像的方式保存在每一个副本中。所有的这些参数组成的集合称为镜像参数(Mirrored Variable),这些参数间通过相同的更新保持同步。
高效的All-reduce算法用于跨设备保持参数间的通讯和更新。All-reduce算法通过加法跨设备聚合模型中的所有张量,同时将聚合的结果提供给所有设备。all-reduce方法的具体算法实现有很多,在未指定的情况下,tensorflow默认选取NVIDIA NCCL,除此之外,可选择的还有Hierarchical Copy All-Reduce和Reduction To One Device,同时tensorflow也支持自定义all-reduce策略。

3.2.2 多节点镜像策略(Multi-Worker Mirrored Strategy)
多节点镜像策略与镜像策略十分相似,多节点镜像策略为所有节点的所有设备创建相应的模型镜像,此镜像中包含了模型中的所有参数。与镜像策略不同的是,镜像策略是在单一服务器中对多运算设备进行参数分发,而多节点镜像策略实现了多节点中多运算设备的分发,也就是说,多节点镜像策略是镜像策略在多节点情况下的一个改进版。
与镜像策略的另一个不同点在于进行all-reduce时选择的实现方式。镜像策略选择通过加法保持不同运算设备中参数的同步,而多节点镜像策略选择的是集合操作(CollectiveOps())。这里的集合并不是一个运算,而是指一类运算,TensorFlow在运算时会根据硬件的类型、网络的拓扑结构,以及张良的大小自动选择运算的具体方式。
为了能够提高运算效率,多节点镜像策略还原有基础上增加了一些优化算法。比如通过一些静态运算将多个小张量的all-reduce转化为少量大张量的all-reduce。
可以通过一下代码创建多节点镜像策略:
多节点与多GPU相比,在训练时的一个主要区别是多节点需要对每一个节点进行初始化,具体的初始化方法如下:
3.2.3 中心存储策略(Central Storage Strategy)
中心存储策略主要用于在同步训练中进行参数分发,与上面提到的镜像类策略不同,中心存储策略不对参数进行镜像操作。中心存储策略将参数存储在CPU中,并在GPU中进行运算。
可以通过以下代码进行中心存储策略实例的初始化:
3.2.4 参数服务器策略(Parameter Server Strategy)
参数服务器策略是一种支持多台设备的异步训练策略。在参数服务器策略中,所有参与的设备被分为两类:工作结点和参数服务器。模型中的每一个参数都存储在参数服务器中,所有的计算都运行在由GPU组成的工作节点中。
第4章 TensorFlow Serving及基于云计算技术的运行实例
4.1 TensorFlow Serving
TensorFlow Serving 是专门为生产环境设计的灵活、高性能的服务体系,其目的是通过对模型的整合实现“即插即用”,即在保留原有架构和API的情况下,将模型或算法部署至服务器端。
通过一个例子介绍在Docker容器中借助TensorFlow Serving运行ResNet模型,并通过Kubernetes部署至Google云平台服务器。
4.2 初始化并在Docker中运行
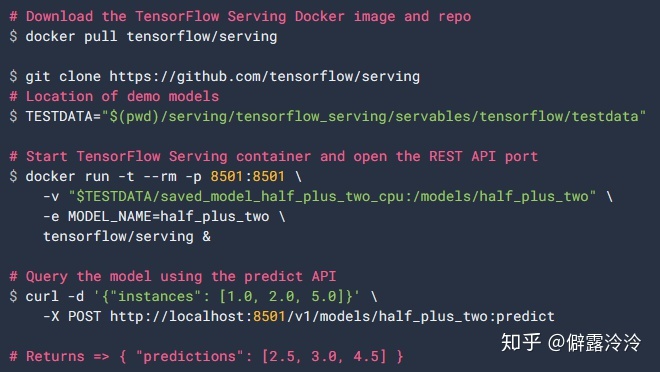
使用TensorFlow Serving最简单的方法之一就是通过Docker。在安装docker之后,首先通过以下代码从Docker镜像库中拉取TensorFlow
(1)下载适用于ImageNet数据集的ResNet模型并解压至本地:
(2)开启服务评将其作为后台进程:
(3)将模型数据复制至容器所在文件夹,并提交:
(4)打开包含ResNet的容器让它准备运行:
(5)在客户端从GitHub仓库中克隆TensorFlow Serving:
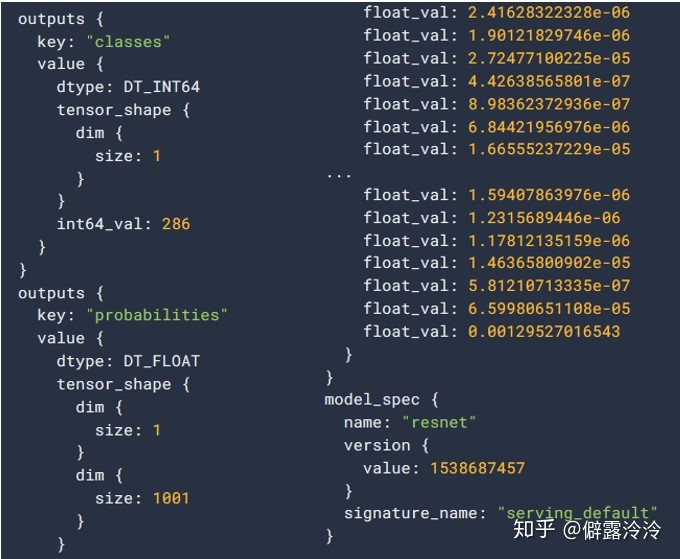
(6)通过resnet_client_grpc.py查询服务器
4.3 部署至Kubernetes
(1)在Google Cloud上创建工程和容器集群,并设置默认容器。
(2)上传Docker镜像:
(3)创建Kubernetes服务及运行
原文作者:weixin_39982236;如有侵权,请联系管理员删除。

