分布式任务调度平台——XXL-JOB
本章笔记整理自1小时掌握XXL-JOB分布式调度实战。
1.概述
1.1.什么是任务调度?
(1)我们可以思考一下下面业务场景的解决方案:
- 某电商平台需要每天上午 10 点,下午 3 点,晚上 8 点发放一批优惠券;
- 某银行系统需要在信用卡到期还款日的前三天进行短信提醒;
- 某财务系统需要在每天凌晨 0:10 分结算前一天的财务数据,统计汇总;
(2)以上场景就是任务调度所需要解决的问题。任务调度是为了自动完成特定任务,在约定的特定时刻去执行任务的过程。
1.2.为什么需要分布式调度
(1)使用 Spring 中提供的注解 @Scheduled,也能实现调度的功能,在业务类中方法中使用这个注解,然后在启动类上使用 @EnableScheduling注解:
有关 Spring Boot 中如何实现定时任务的相关知识可以查看 Spring Boot 面试题——定时任务这篇文章。
(2)感觉 Spring 给我们提供的这个注解可以完成任务调度的功能,好像已经完美解决问题了,为什么还需要分布式呢?主要原因如下:
- 高可用:单机版的定式任务调度只能在一台机器上运行,如果程序或者系统出现异常就会导致功能不可用。
- 防止重复执行:在单机模式下,定时任务是没什么问题的。但当我们部署了多台服务,同时又每台服务又有定时任务时,若不进行合理的控制在同一时间,只有一个定时任务启动执行,这时,定时执行的结果就可能存在混乱和错误了
- 单机处理极限:原本 1 分钟内需要处理 1 万个订单,但是现在需要 1 分钟内处理 10 万个订单;原来一个统计需要 1 小时,现在业务方需要 10 分钟就统计出来。你也许会说,你也可以多线程、单机多进程处理。的确,多线程并行处理可以提高单位时间的处理效率,但是单机能力毕竟有限(主要是 CPU、内存和磁盘),始终会有单机处理不过来的情况。
1.3 XXL-JOB 介绍
1.3.1.概述
(1)XXL-Job 是一个轻量级分布式任务调度平台,其核心设计目标是开发迅速、学习简单、轻量级、易扩展。大众点评目前已接入 XXL-JOB,该系统在内部已调度约 100 万次,表现优异。目前已有多家公司接入 XXL-Job ,包括比较知名的大众点评,京东,优信二手车,360金融 (360),联想集团,网易等等。
(2)官网地址:https://www.xuxueli.com/xxl-job/
1.3.2.✨系统架构图
XXL-JOB 的系统架构图如下图所示,其主要由以下两部分组成:
- 调度模块(调度中心):负责管理调度信息,按照调度配置发出调度请求,自身不承担业务代码。调度系统与任务解耦,提高了系统可用性和稳定性,同时调度系统性能不再受限于任务模块;支持可视化、简单且动态的管理调度信息,包括任务新建,更新,删除,GLUE 开发和任务报警等,所有上述操作都会实时生效,同时支持监控调度结果以及执行日志,支持执行器 Failover。
- 执行模块(执行器):负责接收调度请求并执行任务逻辑。任务模块专注于任务的执行等操作,开发和维护更加简单和高效;接收“调度中心”的执行请求、终止请求和日志请求等。
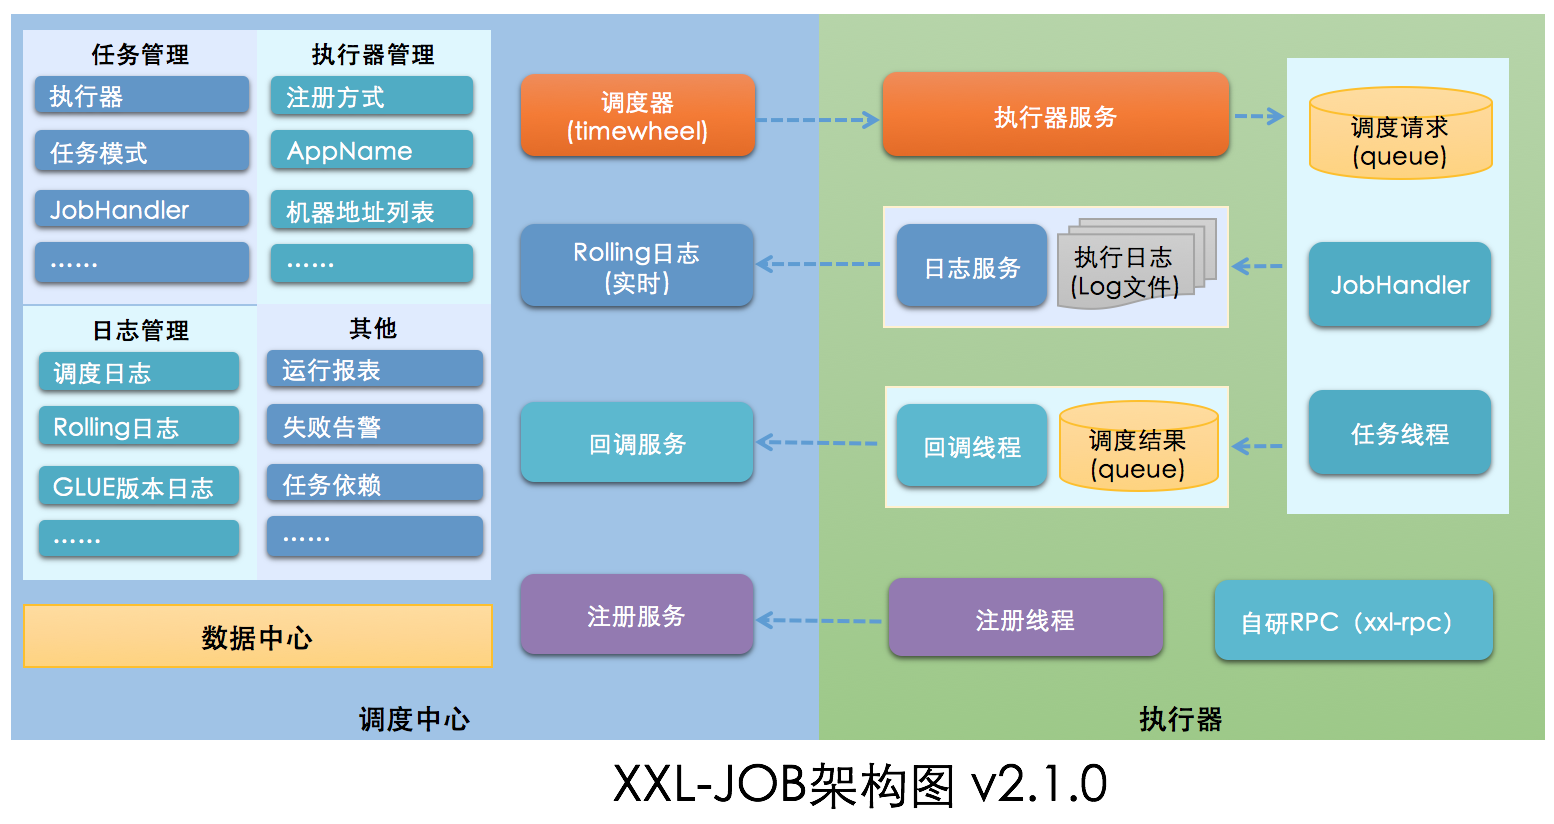
1.3.3.✨设计思想
XXL-JOB 的设计思想为:
- 将调度行为抽象形成“调度中心”公共平台,而平台自身并不承担业务逻辑,“调度中心”负责发起调度请求;
- 将任务抽象成分散的
JobHandler,交由“执行器”统一管理,“执行器”负责接收调度请求并执行对应的JobHandler中业务逻辑; - 因此,“调度”和“任务”两部分可以相互解耦,提高系统整体稳定性和扩展性;
1.3.4.✨执行流程
XXL-Job 的工作流程如下:
- 启动调度中心:调度中心是整个 XXL-Job 的核心,负责任务的调度和管理。在启动时,调度中心会加载任务信息并持续运行。
- 注册执行器:执行器是任务的具体执行者,运行在各个执行节点上。执行器在启动时会根据配置的调度中心地址向调度中心进行注册,并发送心跳以保持与调度中心的连接。
- 任务调度:调度中心根据任务的配置和调度策略,决定任务的触发时间和执行节点。调度策略可以基于固定时间点触发、固定间隔触发或者基于 Cron 表达式触发。
- 任务下发:当到达任务的触发时间时,调度中心会将任务下发给执行器。下发的任务包含任务的元数据、执行参数等信息。
- 任务执行:执行器接收到任务后,根据任务的配置和参数,在执行器内部执行具体的任务逻辑。执行过程中,执行器会记录任务的执行日志。
- 任务结果回调:任务执行完成后,执行器会将任务的执行结果回调给调度中心。执行结果包括任务的执行状态、执行日志、执行耗时等信息。
- 调度日志和统计:调度中心接收到执行器的回调结果后,会更新任务的状态和执行日志,并进行相关的统计和监控。
- 报警和告警:在任务执行过程中,调度中心会根据任务的配置和执行结果,触发相应的报警和告警机制,通知管理员和相关人员。
- 重复执行:整个流程会循环进行,以实现任务的周期性调度和执行。调度中心会根据预设的调度策略和触发条件,按时触发任务的下发和执行。
2.快速入门
2.1.下载源码
源码下载地址:
2.2.初始化调度数据库
请下载项目源码并解压,获取 “调度数据库初始化SQL脚本” 并执行即可。“调度数据库初始化SQL脚本” 位置为:
2.3.编译源码
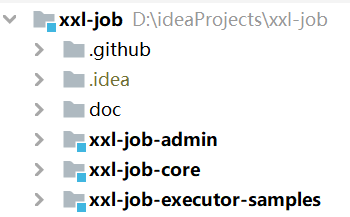
解压源码,按照 Maven 格式将源码导入 IDE,使用 Maven 进行编译即可,源码结构如下:
2.4.配置部署调度中心
2.4.1.调度中心配置
修改xxl-job-admin项目的配置文件application.properties,把数据库账号密码配置上:
2.4.2.部署项目
- 运行
XxlJobAdminApplication程序即可。 - 调度中心访问地址:http://localhost:8080/xxl-job-admin
- 默认登录账号 “admin/123456”,登录后运行界面如下图所示:
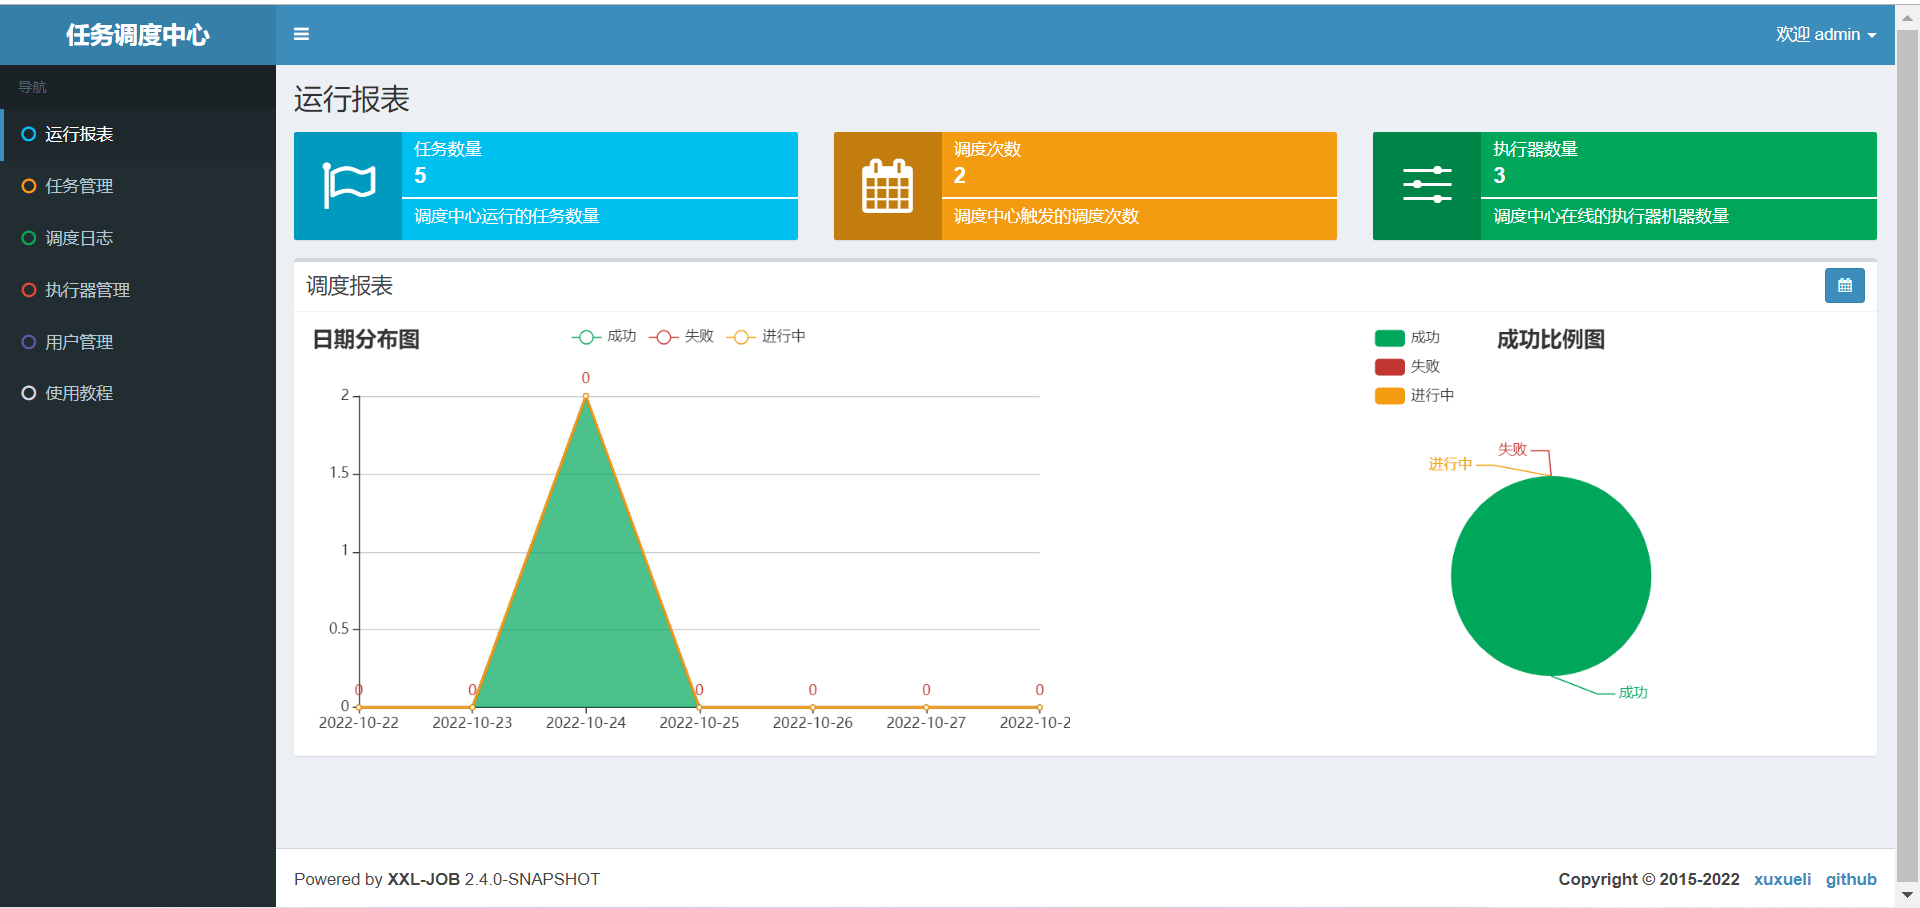
- 至此“调度中心”项目已经部署成功。
2.5.配置部署执行器项目
2.5.1.添加 Maven 依赖
创建 SpringBoot 项目并且添加如下依赖:
2.5.2.执行器配置
在配置文件中添加如下配置:
2.5.3.添加执行器配置
创建 XxlJobConfig 配置对象:
2.5.4.添加任务处理类
添加任务处理类,交给 Spring 容器管理,在处理方法上使用 @XxlJob 注解:
2.6.运行 HelloWorld 程序
2.6.1.任务配置 & 触发执行
登录调度中心,在任务管理中新增任务,配置内容如下:
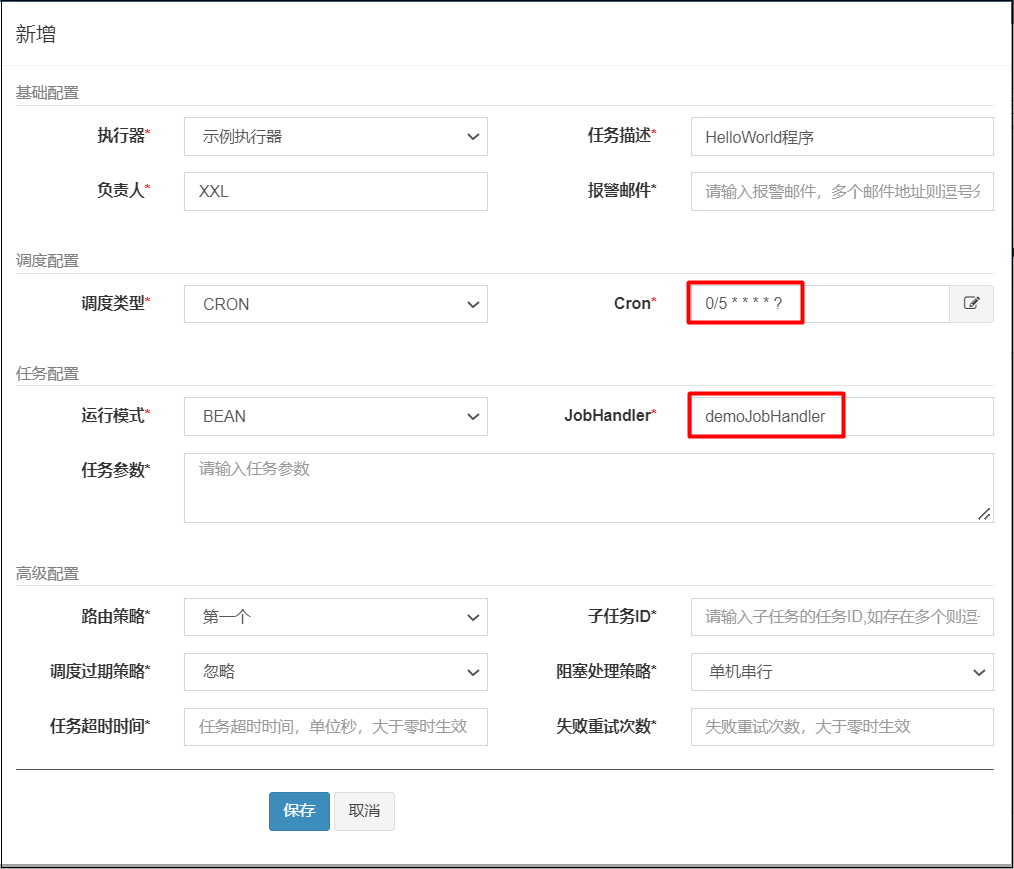
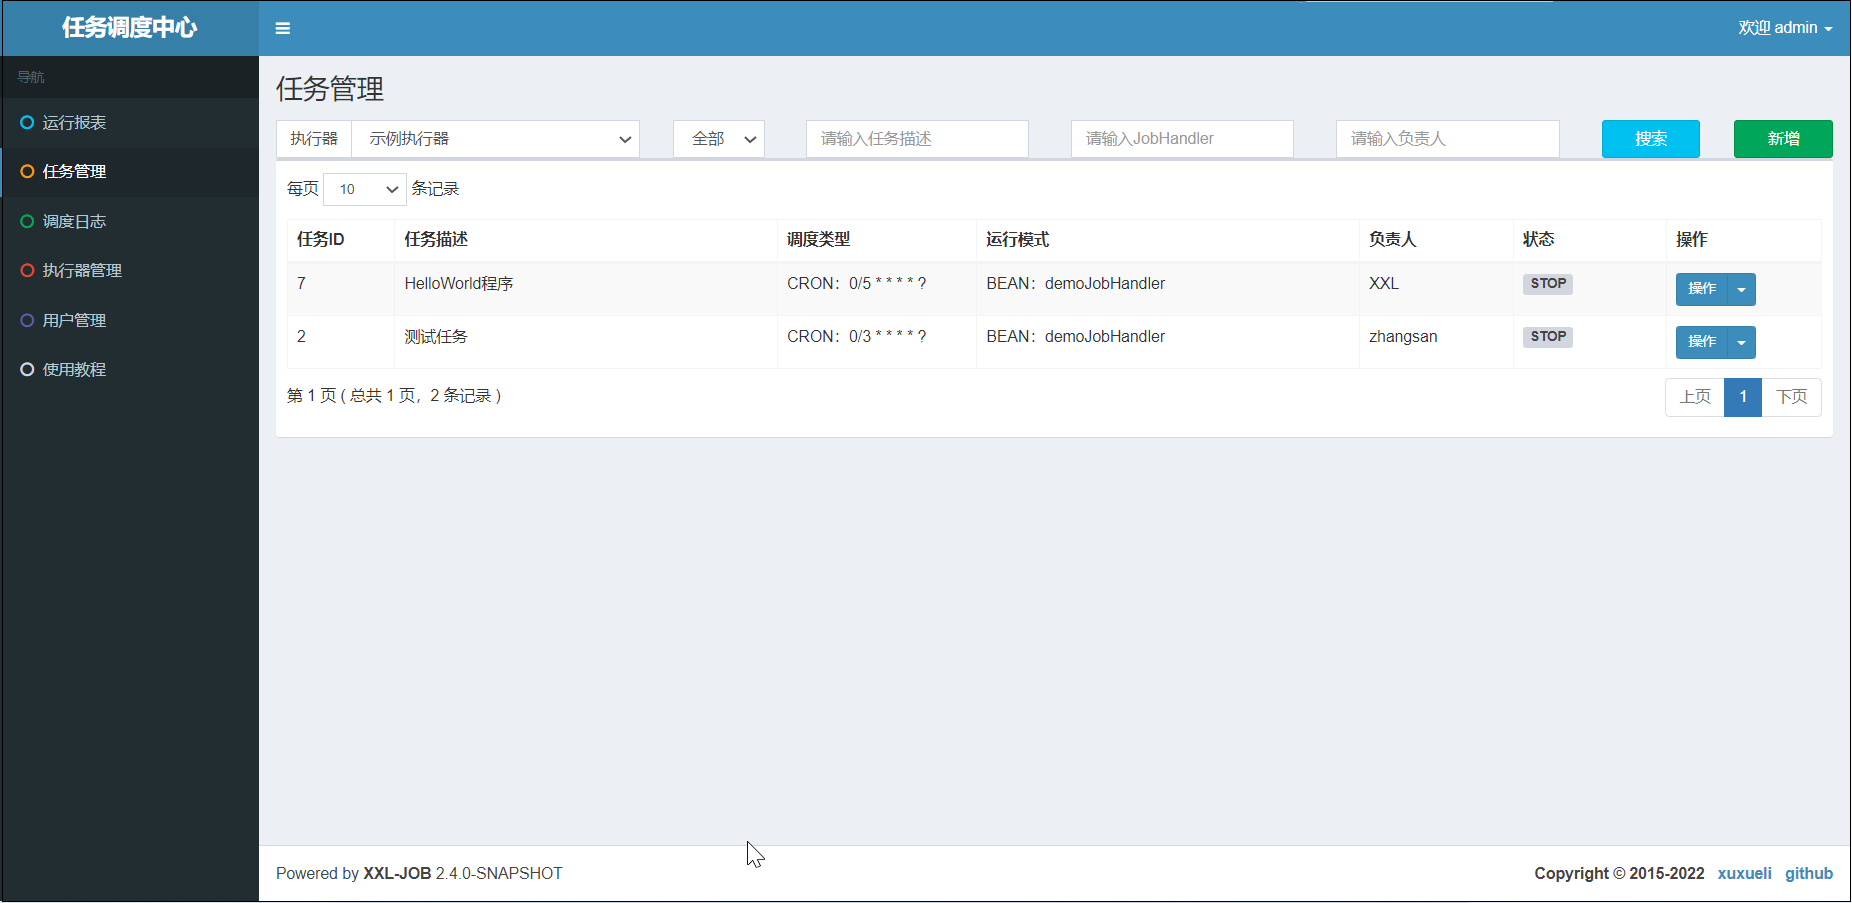
新增后界面如下:
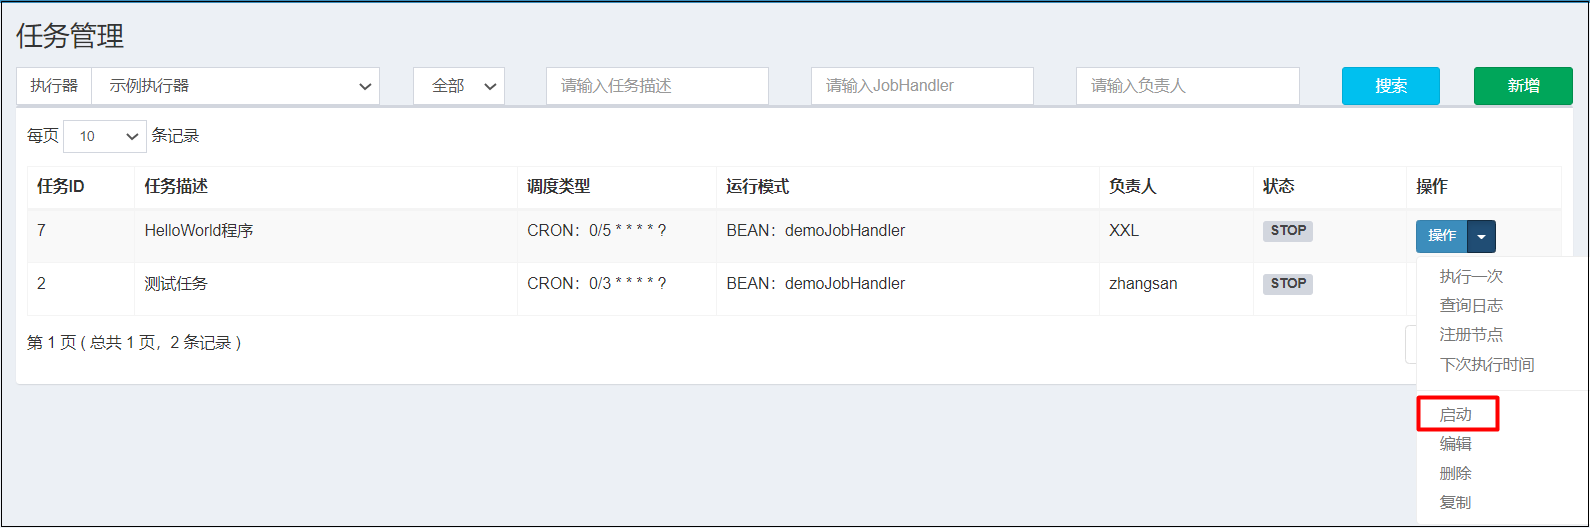
接着启动定时调度任务:
2.5.2 查看日志
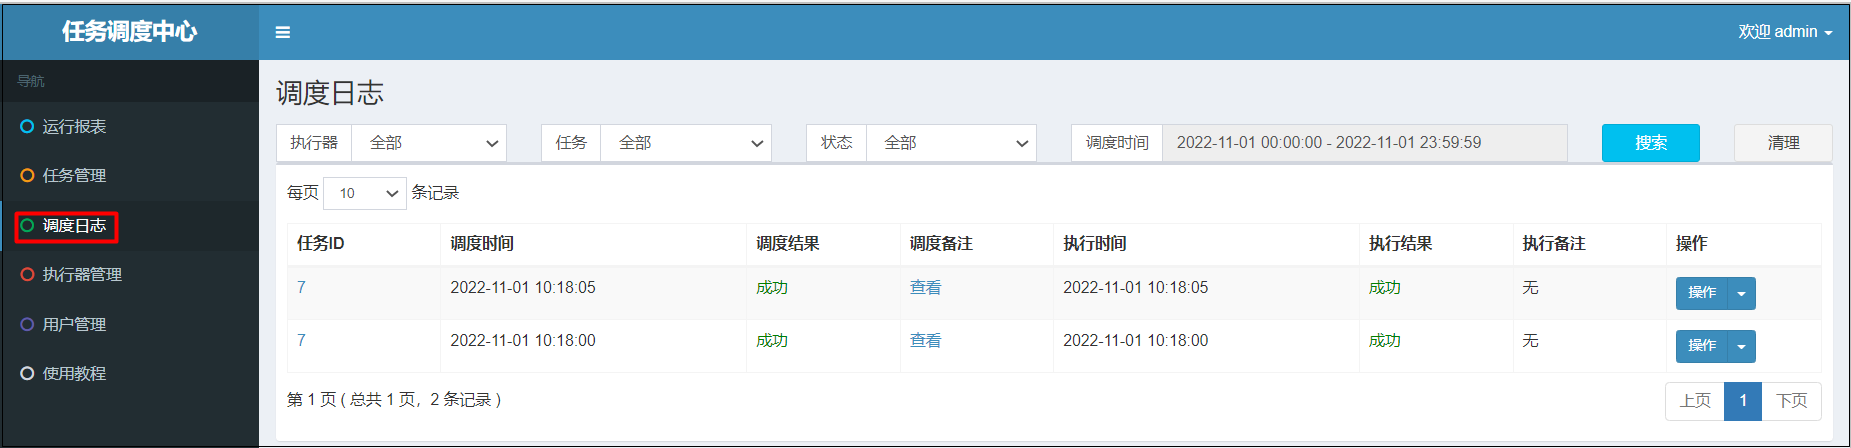
在调度中心的调度日志中就可以看到,任务的执行结果:
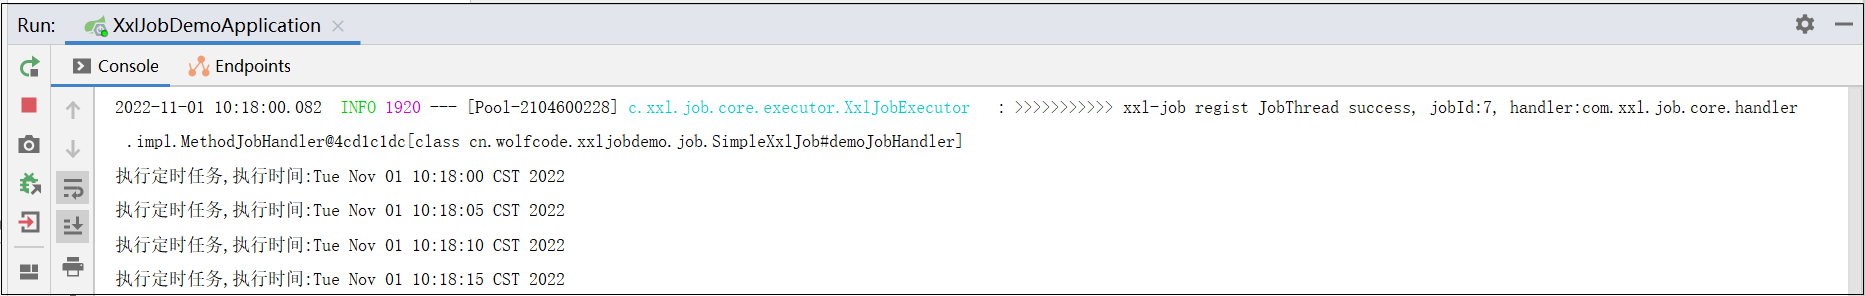
管控台也可以看到任务的执行信息:
2.7.GLUE 模式 (Java)
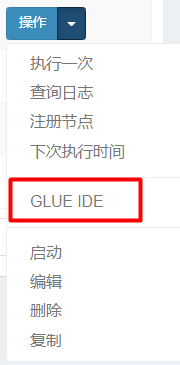
任务以源码方式维护在调度中心,支持通过 Web IDE 在线更新,实时编译和生效,因此不需要指定 JobHandler。“GLUE模式 (Java)” 运行模式的任务实际上是一段继承自 IJobHandler 的 Java 类代码,它在执行器项目中运行,可使用 @Resource/@Autowire 注入执行器里中的其他服务。
添加Service
添加任务配置
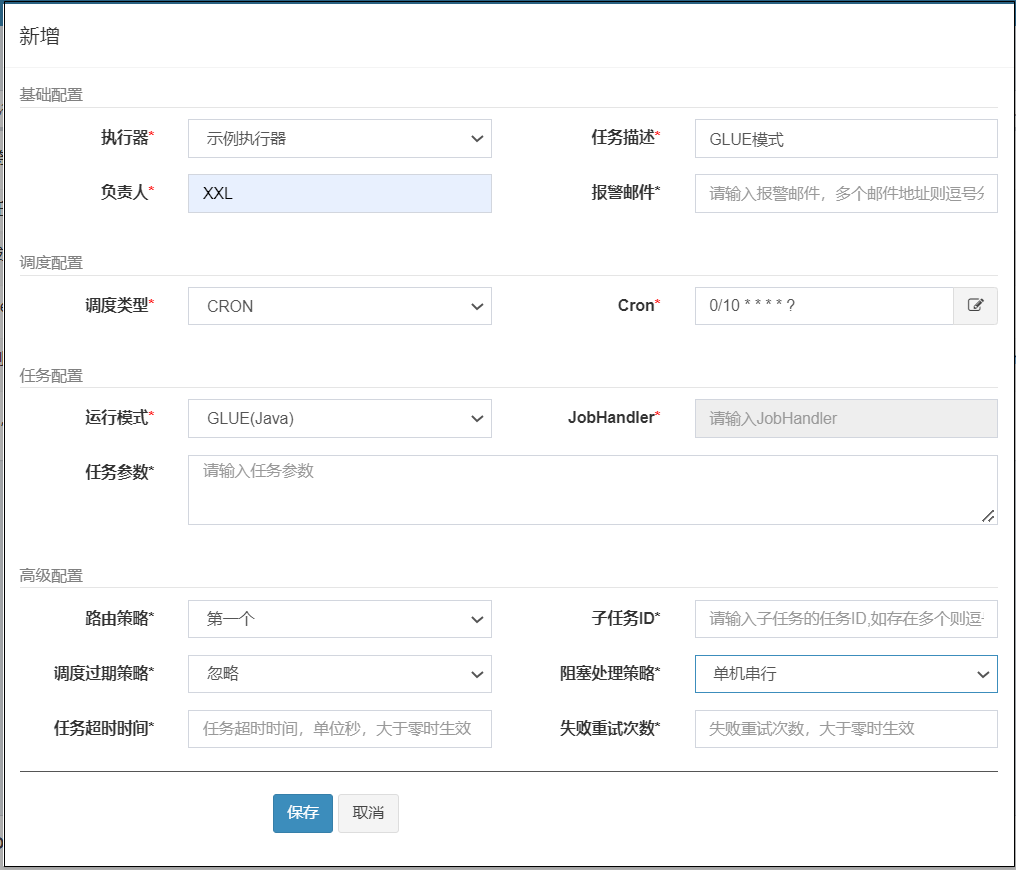
通过GLUE IDE在线编辑代码
编写内容如下:
启动并执行程序
2.8.执行器集群
2.8.1.集群环境搭建
在 IDEA 中设置 SpringBoot 项目运行开启多个集群:
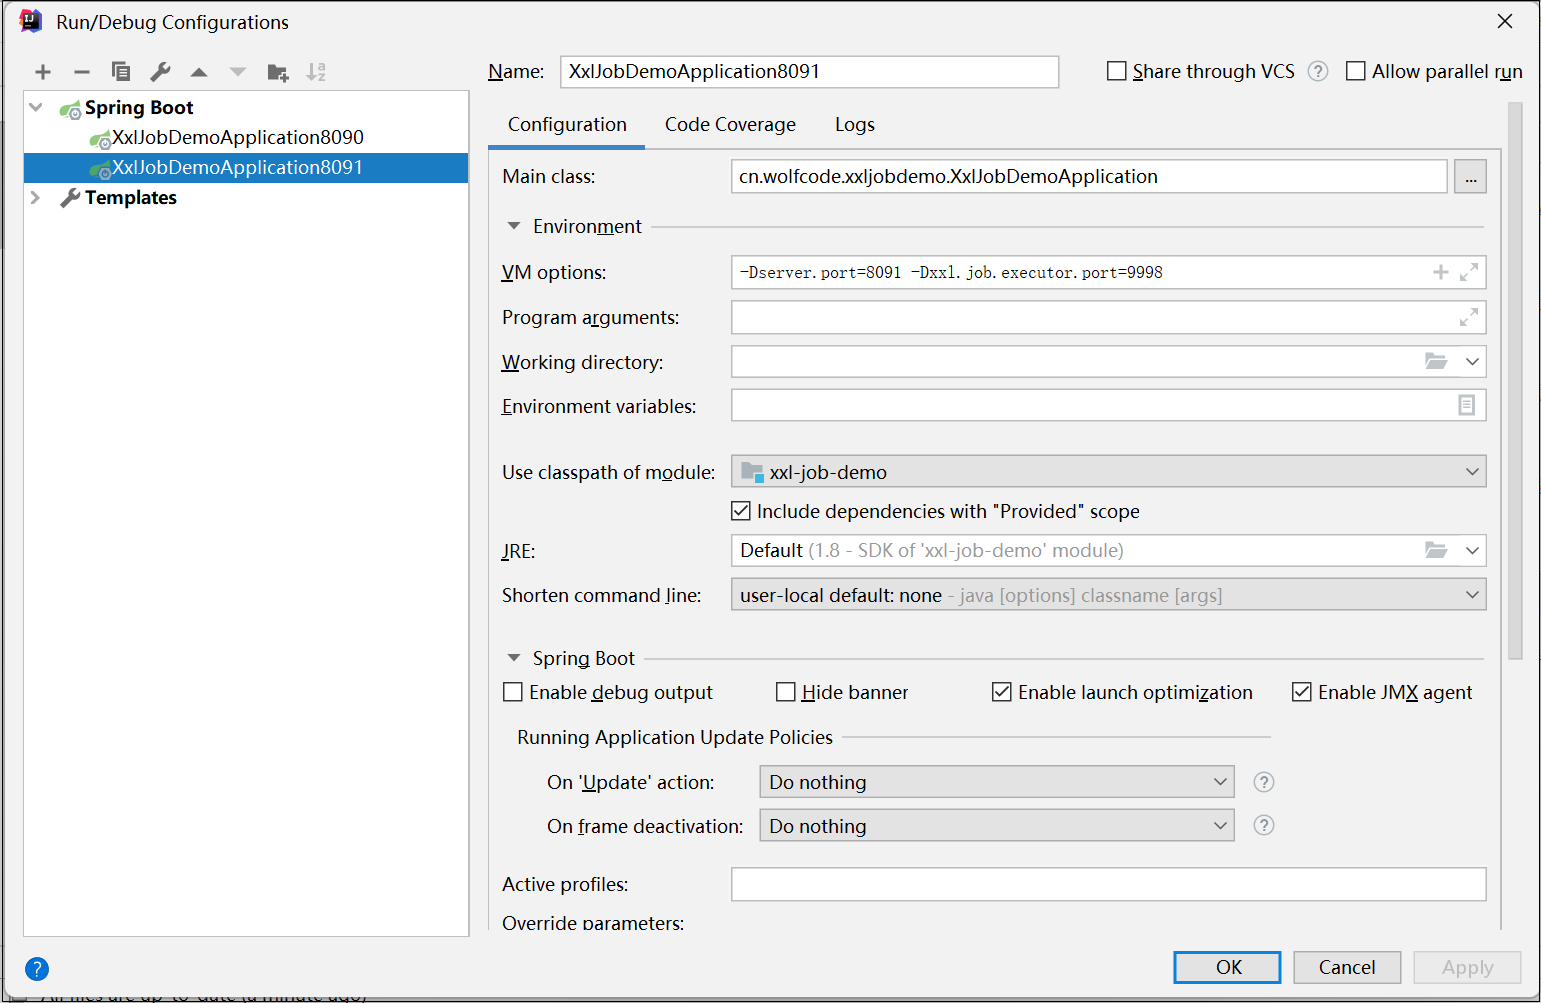
启动两个SpringBoot程序,需要修改Tomcat端口和执行器端口
- Tomcat端口8090程序的命令行参数如下:
- Tomcat 端口 8090 程序的命令行参数如下:
- 在任务管理中,修改路由策略,修改成
轮询:
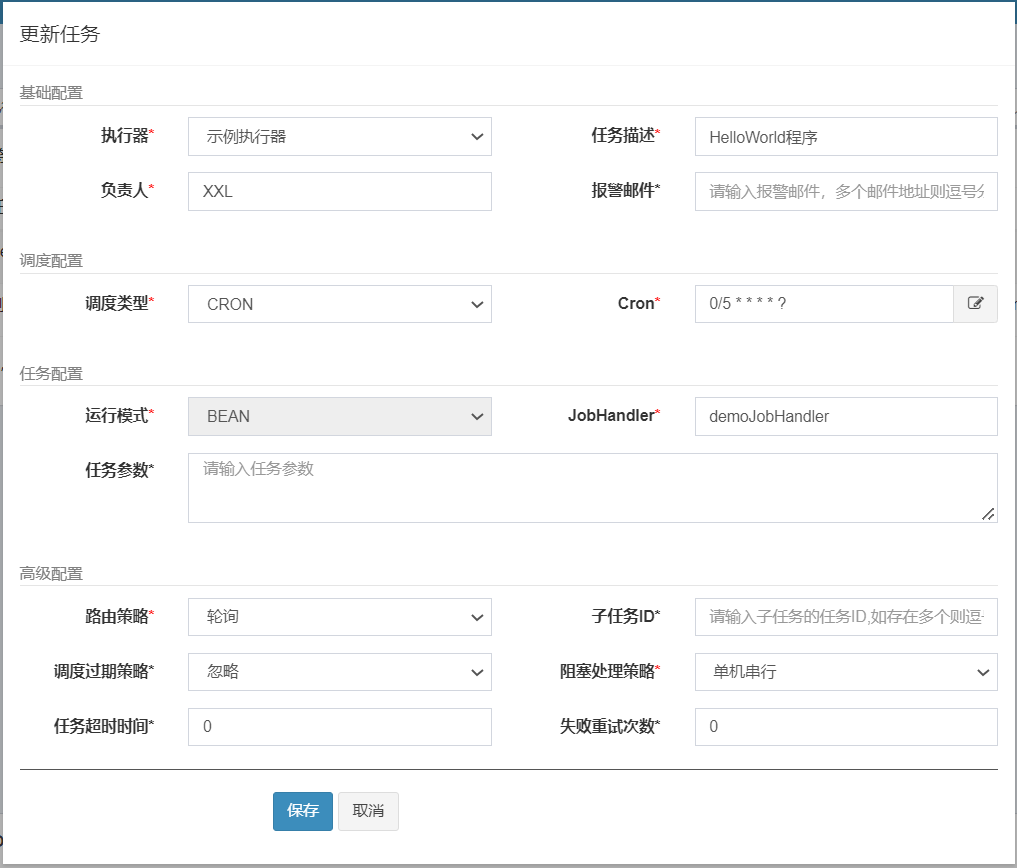
- 重新启动,我们可以看到效果是,定时任务会在这两台机器中进行轮询的执行,8090 端口的控制台日志如下:
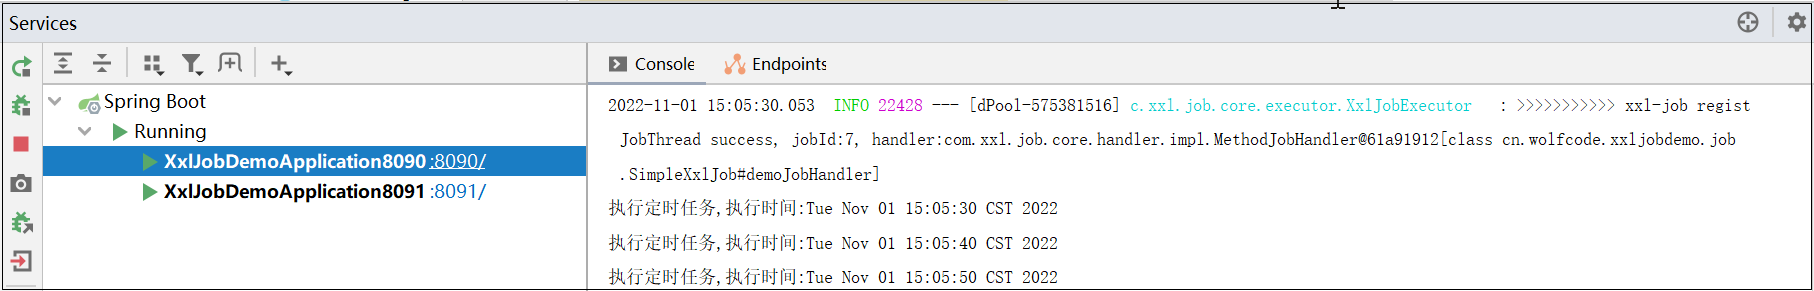
- 8091端口的控制台日志如下:
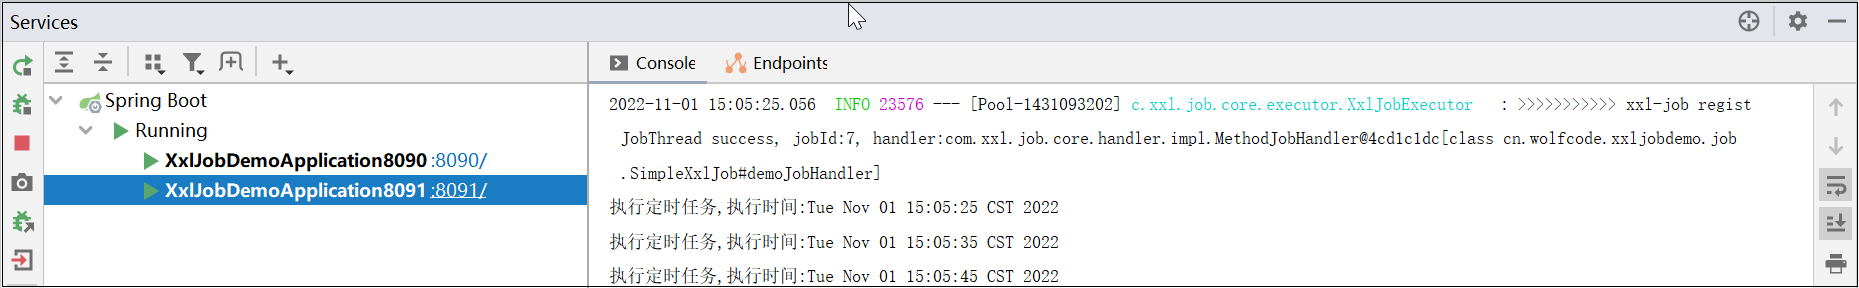
2.8.2.✨调度路由算法讲解
当执行器集群部署时,提供丰富的路由策略,包括:
FIRST (第一个):固定选择第一个机器LAST (最后一个):固定选择最后一个机器;ROUND (轮询):依次的选择在线的机器发起调度;RANDOM (随机):随机选择在线的机器;CONSISTENT_HASH (一致性 HASH):每个任务按照 Hash 算法固定选择某一台机器,且所有任务均匀散列在不同机器上;LEAST_FREQUENTLY_USED (最不经常使用):使用频率最低的机器优先被选举;LEAST_RECENTLY_USED (最近最久未使用):最久未使用的机器优先被选举;FAILOVER (故障转移):按照顺序依次进行心跳检测,第一个心跳检测成功的机器选定为目标执行器并发起调度;BUSYOVER (忙碌转移):按照顺序依次进行空闲检测,第一个空闲检测成功的机器选定为目标执行器并发起调度;SHARDING_BROADCAST (分片广播):广播触发对应集群中所有机器执行一次任务,同时系统自动传递分片参数,可根据分片参数开发分片任务。分片参数包括以下两个:分片序号shardIndex和分片总数:shardTotal,每个执行器从数据表取任务时可以让任务 id 模上分片总数,如果等于分片序号则执行此任务;
3.分片功能讲解
3.1.案例需求讲解
需求:我们现在实现这样的需求,在指定节假日,需要给平台的所有用户去发送祝福的短信。
3.1.1.初始化数据
在数据库中导入 xxl_job_demo.sql 数据。
3.1.2 集成 Druid & MyBatis
添加依赖
添加配置
添加实体类
添加 Mapper 处理类
3.1.3.业务功能实现
任务处理方法实现
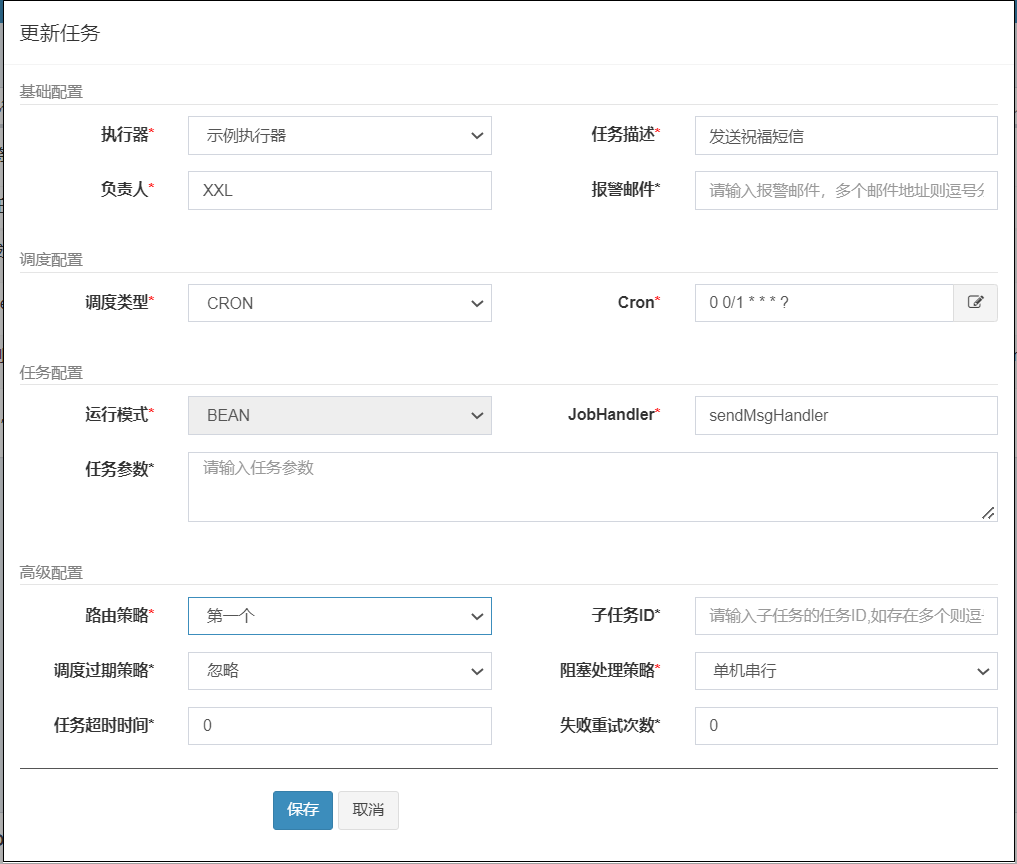
任务配置信息
3.2.分片概念讲解
比如我们的案例中有 2000+ 条数据,如果不采取分片形式的话,任务只会在一台机器上执行,这样的话需要 20+ 秒才能执行完任务。如果采取分片广播的形式的话,一次任务调度将会广播触发对应集群中所有执行器执行一次任务,同时系统自动传递分片参数;可根据分片参数开发分片任务;获取分片参数方式如下:
通过这两个参数,我们可以通过求模取余的方式,分别查询,分别执行,这样的话就可以提高处理的速度。之前 2000+ 条数据只在一台机器上执行需要 20+ 秒才能完成任务,分片后,有两台机器可以共同完成 2000+ 条数据,每台机器处理 1000+ 条数据,这样的话只需要 10+ 秒就能完成任务。
3.3 案例改造成任务分片
Mapper 增加查询方法
任务类方法
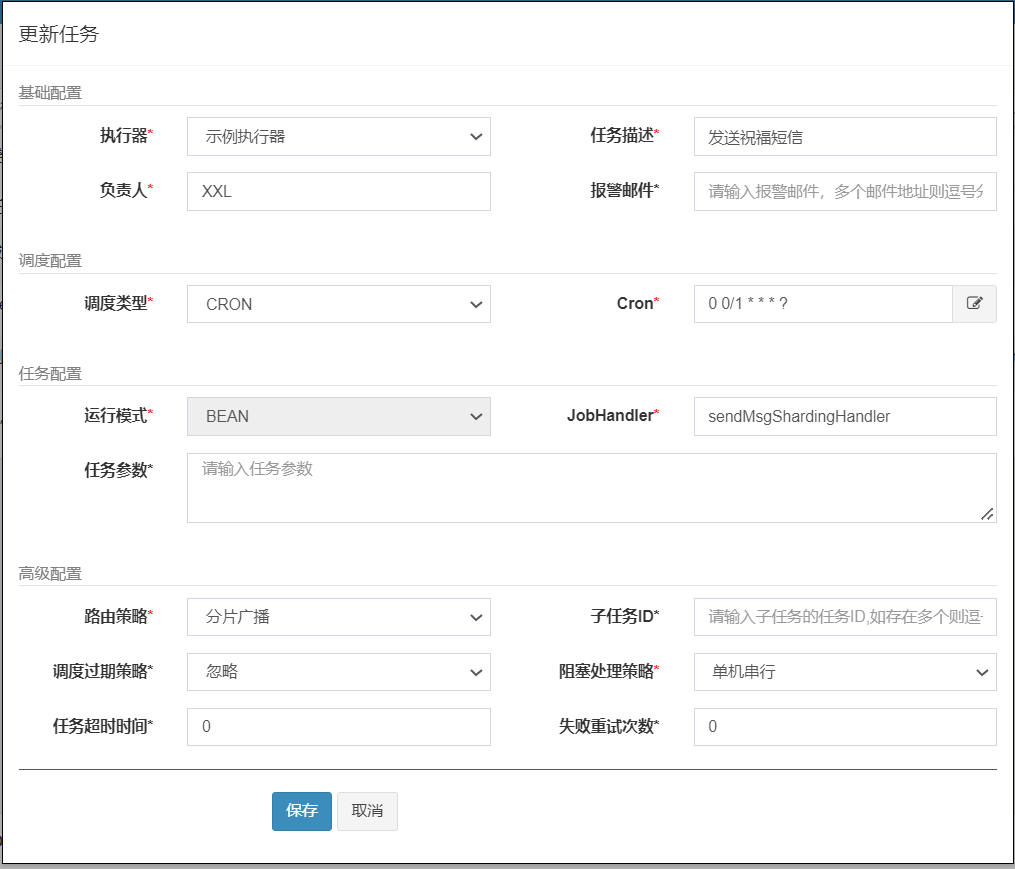
任务设置
原文作者:代码星辰;如有侵权,请联系管理员删除。

