金融级 ETL 系统国产化迁移实战:从 Informatica 到 Apache SeaTunnel

1. 项目背景与挑战
作为某金融科技公司的数据架构负责人,去年我主导完成了公司核心ETL系统从Informatica PowerCenter到国产ETL平台的迁移。这个涉及200+作业流、日均处理TB级数据的核心系统迁移,前后历时5个月,最终实现零数据事故的平滑过渡。今天分享实战中的关键决策、技术细节和踩坑经验。
Informatica作为传统ETL巨头,在企业级数据集成领域占据统治地位已超过20年。其可视化开发界面、稳定的调度引擎和完善的元数据管理,使其成为金融、电信等行业的事实标准。但随着国际形势变化和国产化替代需求,我们不得不面对三个现实问题:
- 许可成本高昂:每年数百万的维护费用对中型企业负担沉重
- 技术栈封闭:难以与新兴的实时计算、AI平台深度集成
- 响应滞后:定制需求需要跨国协作,周期长达数月
国产ETL平台如Kettle、DataX、SeaTunnel等经过多年迭代,在基础功能上已具备替代能力。我们的技术评估显示:在批处理场景下,国产平台的功能覆盖度达到Informatica的85%,而成本仅为1/3,且支持二次开发。
2. 迁移方案设计
2.1 技术选型对比
我们重点评估了三款主流国产ETL工具:
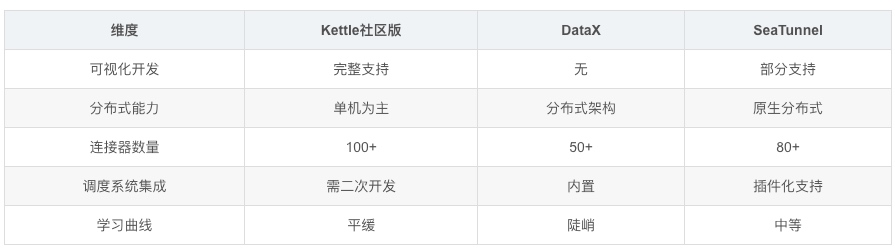
最终选择SeaTunnel作为主要迁移平台,因其:
- 采用Spark/Flink双引擎,适合我们未来的实时数仓规划
- 插件化架构便于扩展自定义数据源
- 活跃的中文社区能快速解决问题
2.2 迁移策略制定
采用"分步迁移+双跑验证"的混合方案:
- 组件解耦 :将Informatica作业拆分为抽取、转换、加载三个独立模块
- 功能映射 :
- 源数据抽取 → SeaTunnel的Source插件
- 复杂转换逻辑 → 用Spark SQL重构
- 调度依赖 → 改用DolphinScheduler编排
- 数据校验 :
# 采用CRC32+抽样对比的双重校验机制
def verify_data(source_df, target_df):
    if source_df.count() != target_df.count():
        return False
    sample_ratio = 0.01
    source_sample = source_df.sample(sample_ratio)
    target_sample = target_df.sample(sample_ratio)
    return source_sample.exceptAll(target_sample).isEmpty()
关键经验:不要试图1:1复刻Informatica作业,而应借迁移机会优化数据流。我们重构了30%存在性能瓶颈的转换逻辑。
3. 核心迁移实施
3.1 元数据迁移
Informatica的Repository包含数千个元数据对象。开发了元数据解析工具:
- 通过PowerCenter CLI导出XML元数据
- 使用XSLT转换关键属性:
<!-- 转换映射表示例 -->
<xsl:template match="SOURCE">
  <connector type="jdbc">
    <property name="url" value="{@DBSERVER}"/>
    <property name="table" value="{@OBJECTNAME}"/>
  </connector>
</xsl:template>
- 生成SeaTunnel的config文件模板
3.2 复杂转换重构
Informatica的Expression、Aggregator等组件需要特殊处理:
- 条件路由 :原使用Router组件
// 转换为Spark代码
df.createTempView("source");
spark.sql("""
  SELECT *,
    CASE
      WHEN amount > 10000 THEN 'VIP'
      ELSE 'NORMAL'
    END AS customer_level
  FROM source
""");
- 缓慢变化维(SCD) :原使用Slowly Changing Dimension向导
-- 采用MERGE INTO语法实现Type2 SCD
MERGE INTO dim_customer t
USING stage_customer s
ON t.customer_id = s.customer_id
WHEN MATCHED AND t.current_flag='Y' AND t.email <> s.email THEN
  UPDATE SET t.current_flag='N', t.end_date=CURRENT_DATE
  INSERT VALUES (s.customer_id, s.email, ..., 'Y', CURRENT_DATE, NULL)
3.3 性能调优实战
遇到最棘手的问题:某个包含20个Joins的作业在SeaTunnel运行时OOM。通过以下优化解决:
- 执行计划分析 :
# 获取Spark物理计划
EXPLAIN EXTENDED
SELECT * FROM fact f JOIN dim1 d1 ON f.id=d1.id ...
- 优化措施 :
- 启用动态分区裁剪:
spark.sql.optimizer.dynamicPartitionPruning=true - 调整广播阈值:
spark.sql.autoBroadcastJoinThreshold=20MB - 对维度表强制广播:
/*+ BROADCAST(dim1) */
- 参数对比 :

4. 验证与切换
4.1 数据一致性保障
建立三级校验体系:
- 记录级校验 :CRC32校验全表数据指纹
SELECT
  SUM(CAST(CRC32(CONCAT_WS('|',col1,col2,...)) AS BIGINT)) AS checksum
FROM table
- 业务指标比对 :关键KPI的环比波动<1%
- 用户验收测试 :让业务部门验证报表数据
4.2 灰度发布方案
采用分业务线逐步切换:
- 先迁移非核心的营销分析数据
- 再迁移风险管控系统
- 最后迁移财务结算系统
每个阶段观察1周,监控:
- 数据延迟
- 资源利用率
- 错误日志
5. 经验总结
5.1 关键成功因素
- 人员培训 :提前2个月组织Informatica开发人员学习Spark和SeaTunnel
- 工具链完善 :
- 开发了作业转换辅助工具
- 建立自动化比对平台
- 厂商支持 :与SeaTunnel核心团队建立直接沟通通道
5.2 避坑指南
- 时区问题 :Informatica默认使用服务器时区,而Spark使用UTC。需要在所有时间字段转换:
FROM_UTC_TIMESTAMP(CAST(col AS TIMESTAMP), 'Asia/Shanghai')
- 字符集陷阱 :Oracle源库的ZHS16GBK编码需要显式指定:
source:
  jdbc:
    connection_options: "oracle.jdbc.convertNlsStrings=true"
- 事务差异 :Informatica默认自动提交,而Spark需要手动控制:
df.write
  .option("isolationLevel", "READ_COMMITTED")
  .mode("overwrite")
  .saveAsTable("target")
迁移后收益量化:
- 硬件成本降低60%(从8台物理服务器到K8s集群)
- 作业平均执行时间缩短40%
- 新增实时数据处理能力
这次迁移给我的核心启示:国产基础软件已经具备替代能力,但需要团队转变技术思维。不是简单工具替换,而是借此机会重构数据架构,为未来的实时化、智能化打下基础。
作者 | 谢丽鹿
原文链接:
https://blog.csdn.net/weixin_29057163/article/details/163529052
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70049562/viewspace-3180702/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 3 月开始贡献,半年成长为 Committer:Apache SeaTunnel 贡献者牛志伟的开源故事
- 喜报!白鲸开源斩获“创客北京2026”创新创业大赛海淀区级赛企业组二等奖
- 记一次连接器改造经历:为什么我把 BigQuery Sink 从待处理流重构为缓冲流?
- 合作再深化,中信证券携手白鲸开源持续升级数据同步能力!
- Kafka Topic 扩容后,Apache SeaTunnel 不重启也能消费新分区数据
- Redis 数据迁移不用写脚本:SeaTunnel 支持 String、Hash、Set、ZSet 四种数据类型
- 不只是调度,Apache DolphinScheduler 如何支撑企业级数仓实践?
- 用 Apache SeaTunnel 同步 DynamoDB 到 Redis,一个配置文件就够
- 实践心得 | 用 Apache SeaTunnel 搞定 PostgreSQL 到平凯数据库云服务的数据迁移
- OSCHINA 对话白鲸开源郭炜:中国基础软件一定要出海
