Apache DolphinScheduler 任务组资源被长时间占用时,怎样让系统自动回收槽位?
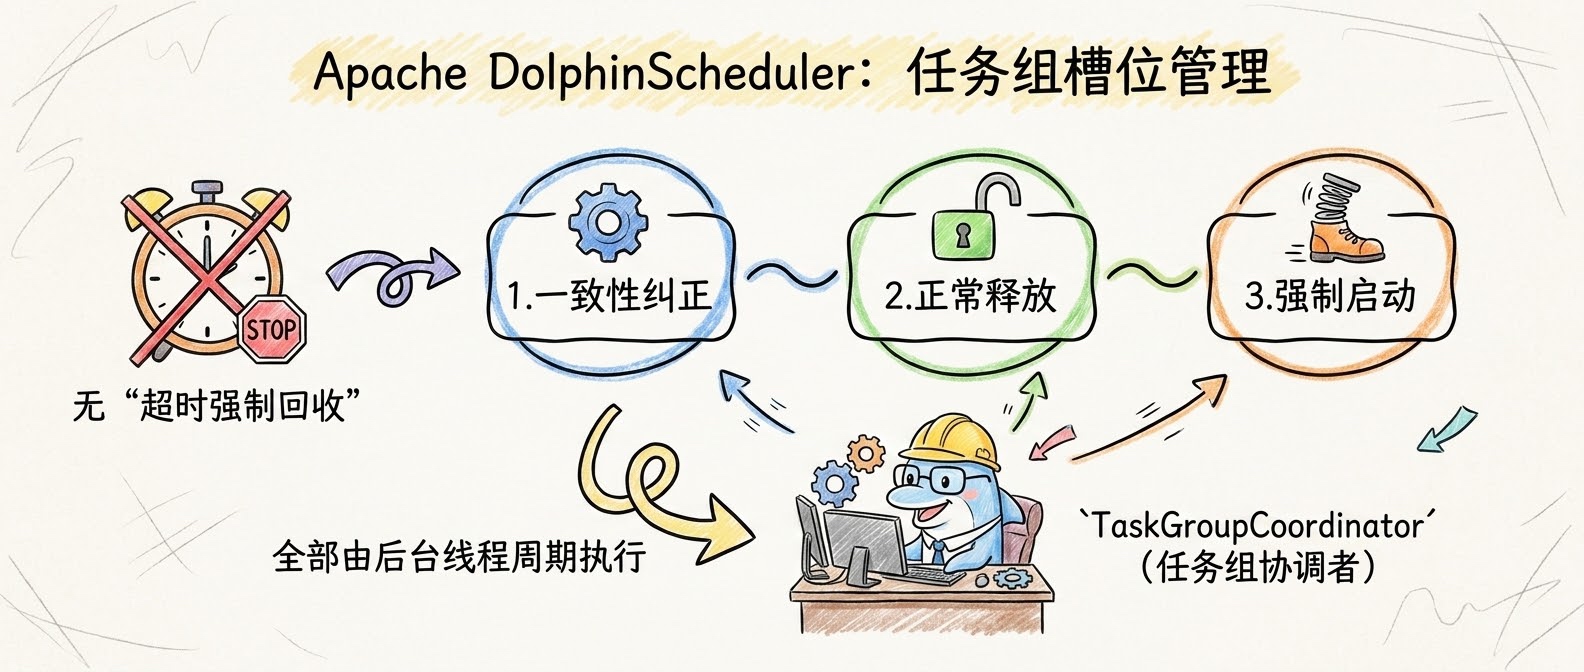
Apache DolphinScheduler 本身并没有针对任务组槽位设计"超时强制回收"的功能;它的"自动回收"机制其实是
一致性纠正 + 正常释放 + 强制启动三种手段的组合,全部由
TaskGroupCoordinator 后台线程周期性执行完成。
如果要解决任务组资源被长时间占用时,想要让系统自动回收槽位,你可以利用
dealWithForceStartTaskGroupQueue 的强制启动逻辑,或者通过监控
amendTaskGroupUseSize 的纠正机制来间接实现"长时间占用后自动放行"的效果。
深度解析
1. 核心组件:
TaskGroupCoordinator
TaskGroupCoordinator 是 Master 端管理任务组槽位的核心组件,实现了
ITaskGroupCoordinator 接口
。它启动一个专用守护线程
TaskGroupCoordinator-Thread,每 5 秒轮询一次,依次执行 4 个关键步骤:
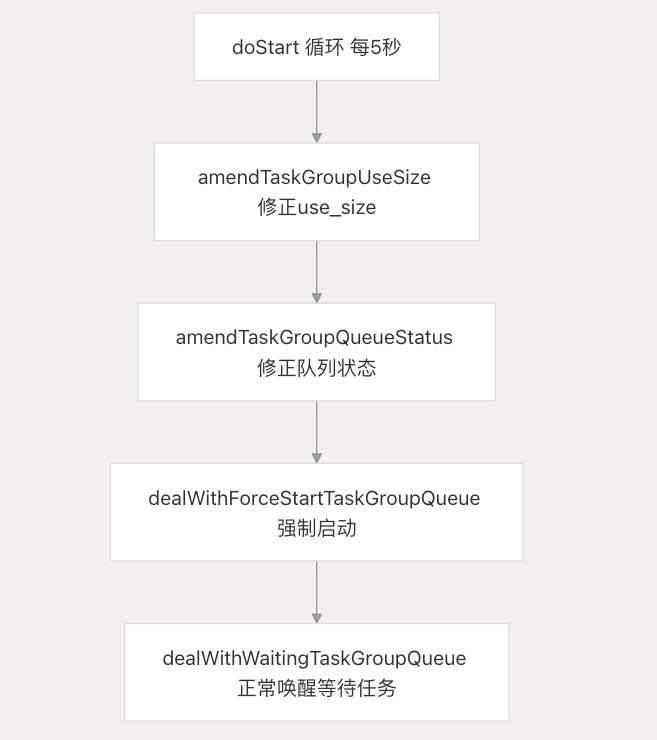
2. 接口设计说明了槽位生命周期
ITaskGroupCoordinator 的类注释清楚地说明了槽位获取/释放的语义:任务实例需要任务组时调用
acquireTaskGroupSlot(非阻塞,只是入队等待),任务完成后调用
releaseTaskGroupSlot 释放槽位。
3. "回收"的第一层含义:正常释放与唤醒
正常情况下,任务实例结束时会调用
releaseTaskGroupSlot,其内部通过
deleteTaskGroupQueueSlot 从队列删除记录、释放槽位。释放后,后台线程的
dealWithWaitingTaskGroupQueue 会扫描每个未满的任务组,按优先级取出等待队列中的任务,尝试原子性地
acquireTaskGroupSlot 数据库更新,成功后通过 RPC
notifyWaitingTaskInstance 唤醒等待的 Master 上的任务实例。
若通知过程失败(例如目标 WorkflowInstance 已经 failover、host 为空,或任务状态已经不是
SUBMITTED_SUCCESS),
notifyWaitingTaskInstance 会抛出
UnsupportedOperationException,这时会直接调用
deleteTaskGroupQueueSlot 释放该无效占用的队列记录,防止槽位被"僵尸"任务长期占用。
4. "回收"的第二层含义:强制启动 (Force Start)
当运维人员在页面上手动点击"强制启动"时,对应的
TaskGroupQueue 记录会被标记
forceStart = YES。后台线程的
dealWithForceStartTaskGroupQueue 会专门查询这些记录,无视资源池上限,直接唤醒对应任务并从队列中删除 。这是目前系统提供的
唯一的人工/半自动"强制回收"入口——本质上是绕过槽位限制而不是真正"回收"被占用的槽位。
5. 是否存在"长时间占用自动超时释放"机制?
amendTaskGroupUseSize 和
amendTaskGroupQueueStatus 这两步从命名上看是做"纠正"(use_size 与实际队列数量对齐、队列状态修正),属于数据一致性维护,而非"占用超时后强制踢出"。若你需要自动超时回收,目前只能:
- 依赖任务本身的超时策略(Task Timeout / 容错机制)让长时间运行的任务本身被杀掉,从而触发
releaseTaskGroupSlot正常释放; - 或利用页面上的"强制启动"功能人工介入,对应
dealWithForceStartTaskGroupQueue。
6. 实操建议
-
查看当前占用情况:任务组管理页面 -> 查看队列,对应文档中的
View Task Group Queue章节。 -
数据库层排查:可以直接查询
t_ds_task_group_queue表,利用queryTheHighestPriorityTasks(按优先级取队首)或queryByTaskId这类 mapper SQL 定位长期处于WAIT_QUEUE或ACQUIRE_SUCCESS但对应任务已经异常结束的记录。 -
手动强制回收:对确认为"僵尸占用"的记录,可通过页面强制启动按钮触发
dealWithForceStartTaskGroupQueue流程,将其从队列中删除并释放槽位。 - 架构层面理解并发控制:任务组功能只对 Worker 执行的任务生效,Master 执行的节点(switch、condition、sub_workflow)不受任务组限制,这点在评估"占用"来源时需要排除。
Notes
- 目前的"自动回收"更准确地说是"状态一致性纠正 + 正常释放通知失败时兜底删除",并非严格意义上的"占用超时强制抢占",请注意这与常见资源池(如连接池、线程池)中的 idle-timeout 回收机制不同。
-
TaskGroupQueueMapper.xml中的updateInQueueLimit1、updateInQueueCAS等 SQL 展示了槽位状态更新采用 CAS 方式保证并发安全,但这些细节偏底层实现,与"长时间占用回收"主题关系较弱,仅供了解并发控制方式参考。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70049562/viewspace-3180068/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 3 月开始贡献,半年成长为 Committer:Apache SeaTunnel 贡献者牛志伟的开源故事
- 喜报!白鲸开源斩获“创客北京2026”创新创业大赛海淀区级赛企业组二等奖
- 记一次连接器改造经历:为什么我把 BigQuery Sink 从待处理流重构为缓冲流?
- 合作再深化,中信证券携手白鲸开源持续升级数据同步能力!
- Kafka Topic 扩容后,Apache SeaTunnel 不重启也能消费新分区数据
- Redis 数据迁移不用写脚本:SeaTunnel 支持 String、Hash、Set、ZSet 四种数据类型
- 不只是调度,Apache DolphinScheduler 如何支撑企业级数仓实践?
- 用 Apache SeaTunnel 同步 DynamoDB 到 Redis,一个配置文件就够
- 实践心得 | 用 Apache SeaTunnel 搞定 PostgreSQL 到平凯数据库云服务的数据迁移
- OSCHINA 对话白鲸开源郭炜:中国基础软件一定要出海
