同程旅行数据通道服务历经多年演进,形成了数据搬运、数据集成、Sqoop、SeaTunnel 四套并存的格局,功能重叠、引擎割裂、整体运维成本居高不下。
本文将分享同程旅行以 Apache SeaTunnel Zeta 引擎为统一底座,在"业务零感知"前提下将数万个存量任务平滑迁移至批流一体化通道的完整实践——从 Sqoop/FlinkSQL 的零改造自动翻译、到基于 LLM 的自然语言建表建任务(Data Copilot),再到数据一致性校验架构,最终实现平台化整合与效率跃升,并展望云原生化与 AI 驱动的智能运维方向。
Meetup 全程回顾: https://weixin.qq.com/sph/AkwdgrLP62
作者简介
周晓晨,目前就职于同程旅行,负责数据平台相关工作,同时也是 Apache SeaTunnel Committer,长期参与 SeaTunnel 社区建设与功能演进。
一、统一数据通道
1.1. 现状
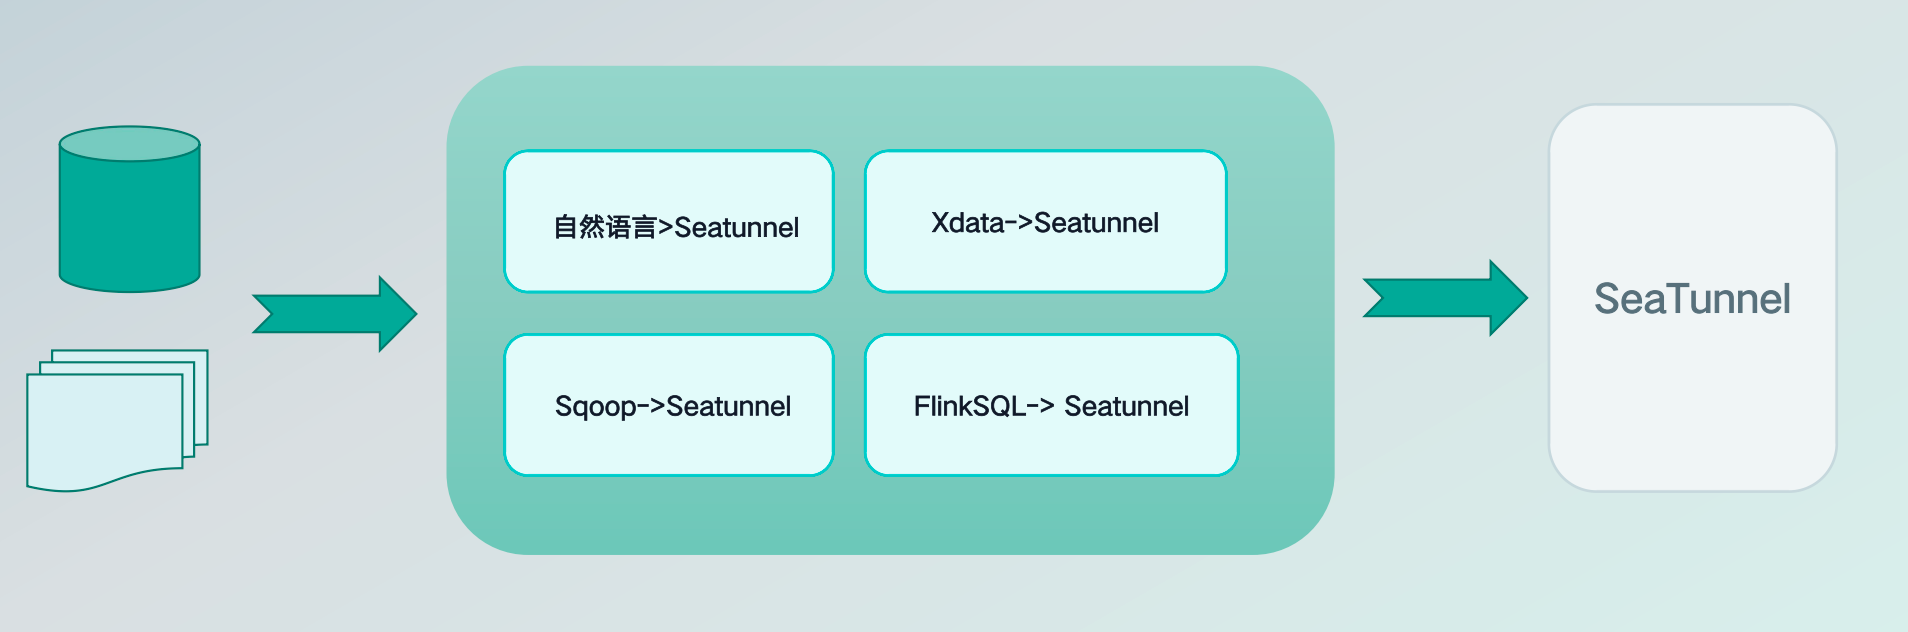
同程旅行现有数据通道服务包括数据搬运、数据集成、Sqoop 和 Seatunnel 共 4 种,存在功能重叠和流程冗余的问题。其中,数据搬运和 Sqoop 分别基于 Flink 1.6 和 MapReduce 引擎,主要用于离线场景下 DB 以及大数据组件之间的数据同步,在处理大规模 DB 类数据搬运任务时,会对公司在线业务库的稳定性造成影响;数据集成服务则面向实时场景,基于 Flink 引擎,支持将 DB 类数据同步至数据湖;而公司大健康业务采用 Seatunnel Zeta 引擎,凭借轻量级架构专注于数据通道场景,在资源使用和同步效率方面进行了针对性优化。
整体来看,现有的数据通道服务亟需进行平台化整合。通过统一功能架构,整合公司现有的 4 种线上数据通道服务,构建基于 SeaTunnel 引擎的批流一体化统一数据通道服务。
1.2. 目标&原则
在重构与迁移过程中,同程旅行严格遵循以下三大核心目标与原则:
1.2.1. 业务无感
重构过程必须对上层业务完全透明,确保历史任务平滑过渡,开发人员的学习和迁移成本降至最低,在正式切换前,支持新老引擎的“双跑”模式,业务侧无需手动重写任何代码即可完成底层引擎的无缝替换。
1.2.2. 数据一致性
数据质量是通道服务的生命线。必须建立完善的校验与兜底机制,保障迁移前后和运行过程中的数据绝对一致。
1.2.3. 效率&稳定性提升
针对原 MapReduce 引擎笨重、Flink 1.6 版本老旧且对在线 DB 冲击大等痛点,充分发挥 SeaTunnel Zeta 引擎的轻量级与高性能优势。
二、任务转换
统一通道的目标与原则确立后,公司的首要挑战是如何让线上数万个存量任务在不改一行代码的前提下,完成从 Sqoop、FlinkSQL 到 SeaTunnel 引擎的底层替换。
2.1. Sqoop/FlinkSQL->SeaTunnel
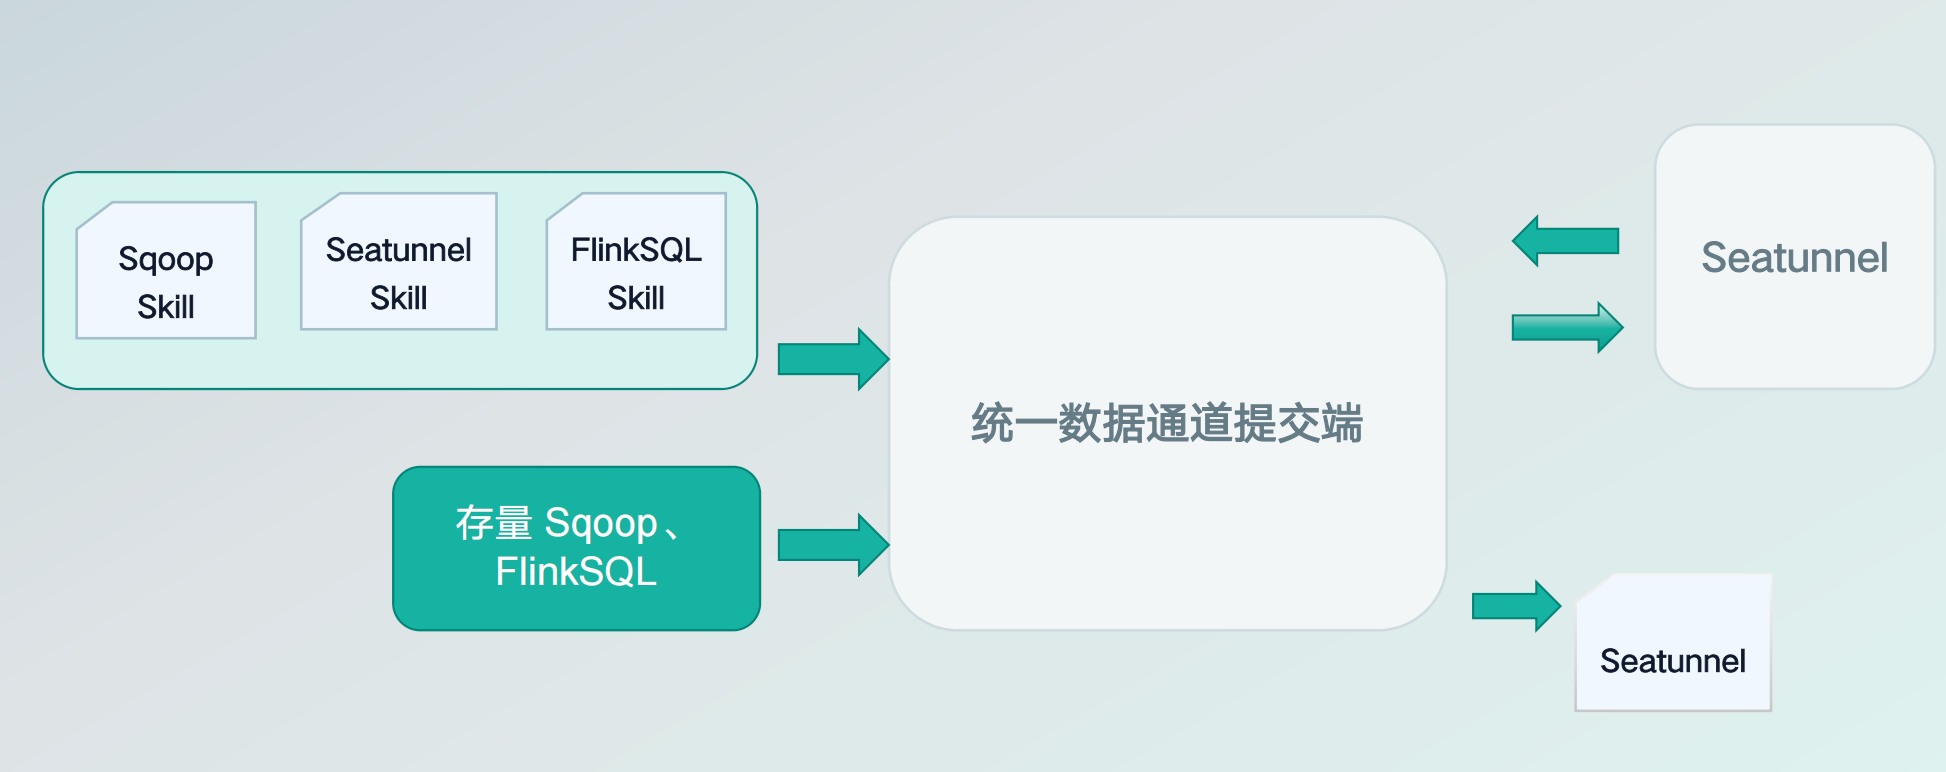
在进行底层数据集成引擎升级时,最大的痛点往往是业务侧的配合成本。我们的核心设计理念是: “业务零感知、零改造”。业务开发人员 无需修改任何一行历史代码 ,继续沿用原有的 Sqoop 脚本或 FlinkSQL 提交习惯。底层全透明地将任务接管并运行在标准的 SeaTunnel 引擎之上。
2.1.1. Skill Layer
- 存量 Sqoop、FlinkSQL: 业务侧数万个历史任务脚本。这些脚本保持原样,无需任何改动。
-
Skill 能力组件池
包含了
Sqoop Skill、FlinkSQL Skill和Seatunnel Skill。识别不同组件的语法和配置参数,并具备将其映射为 SeaTunnel 结构的能力。
2.1.2. 执行层
统一提交端在完成任务翻译后,会生成一份标准的 SeaTunnel 任务配置文件。
-
任务双跑
这是平滑过渡的核心保障。当调度系统触发任务时,统一提交端实际上会
同时提交并运行两个任务
- 线上基线任务: 继续执行原有的 Sqoop / FlinkSQL 任务。这保证了生产环境的数据产出时效和原有逻辑不受任何干扰。
- Seatunnel 灰度任务: 将新生成的 SeaTunnel 配置文件提交至物理集群并行执行,将数据写入测试目录。
- 智能校验与无缝切换: 当双跑任务结束后,触发任务校验规则**。校验规则通过后 ,将该脚本的执行路由切换至 SeaTunnel。
2.2. 自然语言-> Seatunnel
存量迁移解决的是历史包袱,而面向未来的增量任务开发,我们希望进一步打破数据开发的准入门槛——让不熟悉引擎细节的业务人员,也能用自然语言完成数据通道任务的搭建。
2.2.1. 信息补全
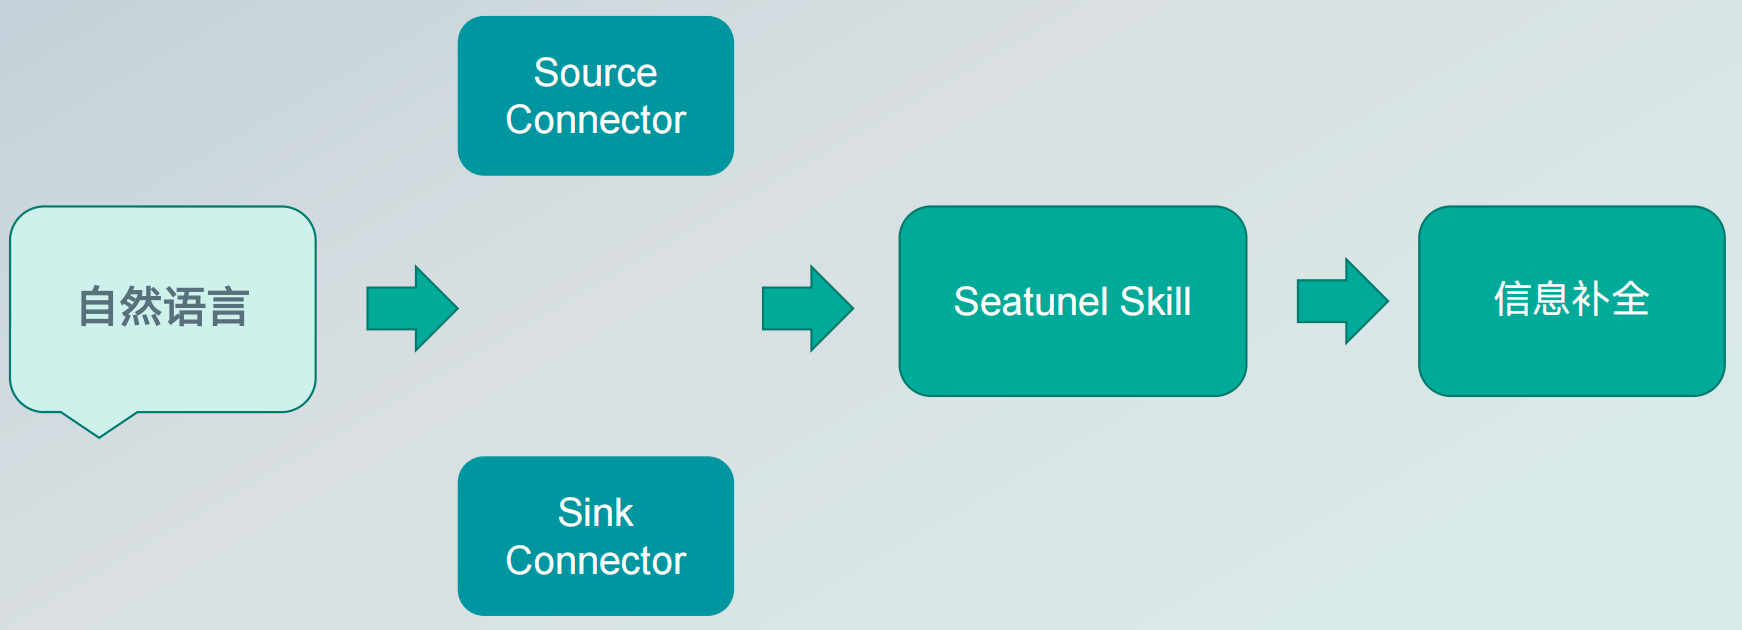
在真实业务场景中,用户输入的自然语言往往是模糊且不完整的(例如:“帮我把昨天核心商品的销售数据同步到数仓”)。针对此问题,同程旅行进行了信息补全相关的工作。
- 上下文感知与智能推断: 提取意图,结合用户的历史行为和全局元数据,对缺失的信息进行智能补全。
-
任务组装:
匹配正确的
Source Connector(如 MySQL 核心商品表)和Sink Connector(如 Hive 数仓),并利用Seatunnel Skill补全并发度、分区策略等底层参数,将自然语言转化为完整的 SeaTunnel 任务配置。
2.2.2. Text2SQL
-
模式链接
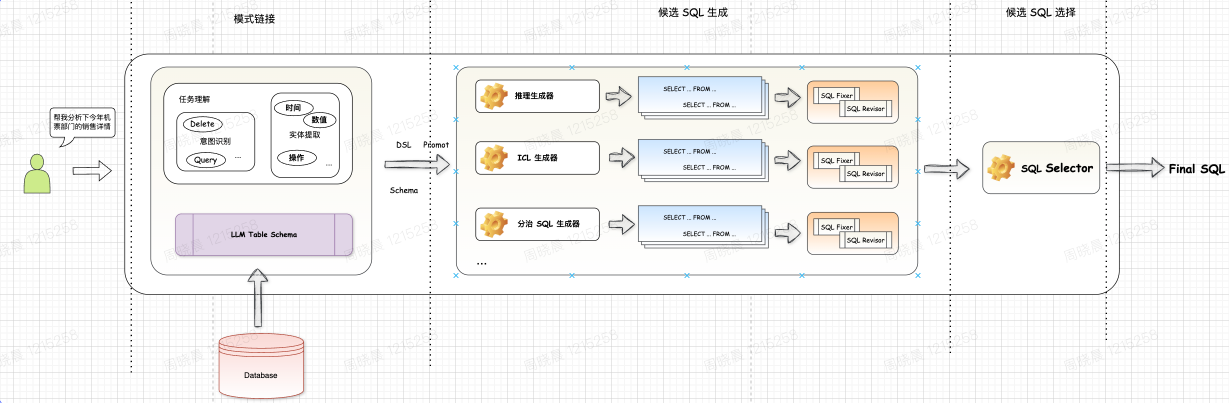
模式链接负责识别自然语言查询中对数据库模式和条件值的引用。 它被证明有助于跨领域的通用性和复杂查询的综合,使其成为几乎所有现有文本到 SQL 方法的关键步骤。
-
候选 SQL 生成生成器
为了保证生成质量,我们不依赖单一模型的输出,而是采用多路并发生成策略:
- 推理生成器 (Reasoning Generator):利用大模型强大的 Zero-shot 逻辑推理能力,直接基于意图和 Schema 生成 SQL。
- ICL 生成 (In-Context Learning):基于 Few-shot 学习,匹配过去成功执行过的高质量 SQL 作为示例,引导大模型生成当前 SQL。
- 分治生成器:面对超复杂长 SQL,将其拆解为多个 CTE子查询进行分布生成。
-
候选 SQL 选择
对多路生成的候选 SQL 进行打分与评估(基于语法正确性、AST 树复杂度、预估执行代价等),最终由
SQL Selector选出一条最优的 Final SQL ,无缝嵌入 SeaTunnel 的 Transform 节点。
2.2.3. Text2ETL
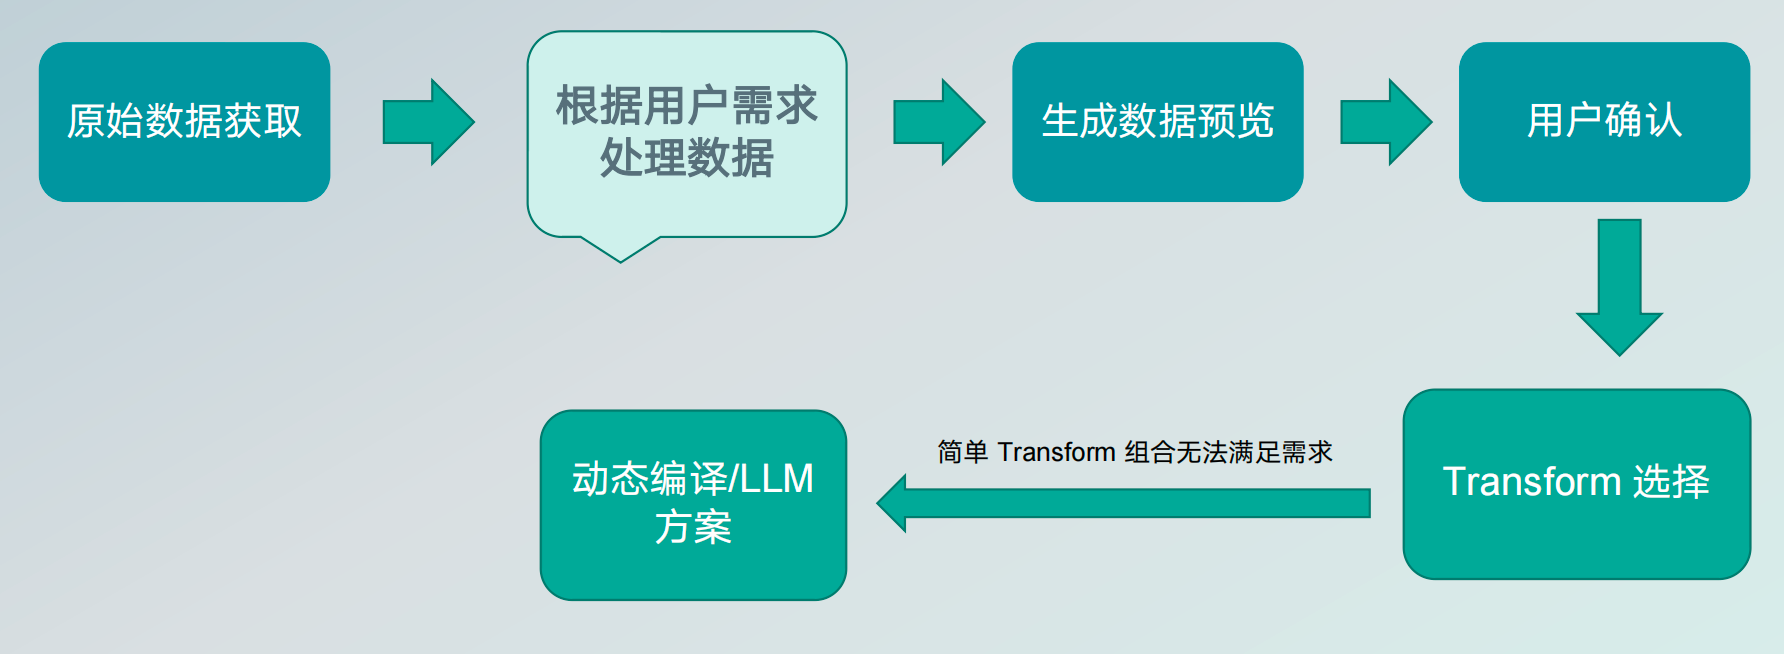
- 交互式预览: 根据自然语言处理数据后,系统会立即生成“数据预览”供用户确认效果。
- Transform 智能路由:
- 常规需求: 自动映射为 SeaTunnel 原生的 Transform 组件(如 Filter, Replace, Split)。
- 动态编译兜底方案: 当遇到极度复杂的脏数据清洗(简单 Transform 组合无法满足需求),系统生成一段 Java/Scala 的 UDF 或 Groovy 脚本。在后台 动态编译 这段代码,并作为插件实时加载到 SeaTunnel 任务中运行。
三、任务数据一致性校验&迁移
任务转换只是迁移的第一步,真正的底线是数据质量。新老引擎在序列化格式、数值精度、时间处理等方面存在固有差异,如何保证迁移前后数据"零偏差、零丢失",是整个工程中最关键的环节。
3.1. 文件类引擎
对于文件系统产生的数据,由于缺乏自身的计算能力,如果将海量文件拉到内存中进行全量比对,极易引发 OOM 且耗时极长。因此基于旁路索引与多级过滤的高效比对架构进行数据验证。

-
数据读取与标准化 (Normalize & Hash):
- 系统并发遍历 Xdata/Sqoop (基线) 和 Seatunnel/Zeta (灰度) 产出的目录。
- 按行读取数据,进行标准化清洗,随后对整行内容计算 Hash 值。
-
构建旁路索引: 为了在发现差异时能够精准定位到具体文件的哪一行,系统在计算 Hash 时,会在外部存储构建一份 有序的旁路索引 。
-
文件级索引 (头部):
记录
fileIndex对应的物理路径(例:fileIndex=0 -> .../part-00000)。 -
数据行索引 (外部排序):
结构为
[hash, fileIndex, lineNo]。该索引按照 hash 值进行全局外部排序,为后续的高效比对打下基础。
-
文件级索引 (头部):
记录
-
多级对比算法:
-
Level 1 - BloomFilter 互筛过滤: 首先为两份数据分别构建布隆过滤器
BloomFilter(Xdata)和BloomFilter(Zeta)。利用布隆过滤器极低的内存占用和极快的查询速度,进行第一轮双向过滤。 -
Level 2 - 双指针排序对比:
对于布隆过滤器无法确认的数据,利用之前按 hash 排好序的数据行索引,采用双指针进行对齐比对。
-
h1 < h2:说明引擎 1 (Xdata) 有此数据而引擎 2 没有,指针p1前进。 -
h1 > h2:说明引擎 2 (Zeta) 多出了数据,指针p2前进。 -
h1 == h2:若 Hash 相同,进一步比对该 Hash 出现的 计数 (Count) ,完美解决数据中存在重复行的问题。
-
-
-
差异回查与定界: 一旦双指针算法发现不一致,系统会利用 二分查找 快速定位到异常的 Hash,并提取出对应的
(fileIndex, lineNo)。开发人员可以直接通过这个坐标, 秒级回查 到原始文件的具体哪一行出现了乱码或截断。 -
校验通过与切换: 全量数据均通过绿色的链路后,系统执行最终 任务切换 。
3.2. 数据表引擎
对于关系型数据库或数据仓库,利用数据库自身的 SQL 引擎进行特征值计算。
SELECT
  sum(murmur_hash3_32(coalesce(CAST(order_serial_no AS string), 'NULL'))) as order_serial_no_hash,
  sum(murmur_hash3_32(coalesce(CAST(platform_code AS string), 'NULL'))) as platform_code_hash,
  ...
FROM ...
四、效率&稳定性提升
数据一致性校验为迁移过程上了保险,但要让统一通道在长期运行中持续释放价值,引擎本身的执行效率与稳定性同样关键。我们从 Connector 增强、并行度智能推测、可观测性完善三个维度进行了系统优化。
4.1. Connector 优化
- Paimon 连接器深度增强:补全 Time 类型支持,实现 LIKE/BETWEEN 谓词下推减少数据扫描,支持动态表选项读取与 sink 分支写入,修复 DECIMAL 类型精度损失与 DataType转换丢字段问题,支持多 Paimon Source 并行读取。
- OLAP 引擎高可用与可靠性:StarRocks 与 Doris 均补齐 FE 节点 HA 能力,StarRocks FE 地址随机选路避免单点,修复 Doris request_table_size < BUCKETS 场景下的数据丢失等。
- 流式消费稳定性:Kafka StreamMode 增加分区过滤防止消费阻塞,RocketMQ 支持跳过解析错误避免任务失败,Milvus Source 修复分区级 load 状态检查遗漏。
- HBase 增强:HBase Source 支持行范围边界查询。
- HDFS ViewFs 兼容:支持 ViewFs schema,解决多命名空间挂载表场景下的 HDFS 访问问题。
4.2. 并行度推测
借鉴 Flink 的自适应批处理机制,我们在 SeaTunnel Zeta 引擎上实现了 智能并行度推测。在任务下发前,底层引擎会轻量级探测源端数据的真实体量(如表总行数、目录大小),以及底层存储的物理分布特征(如 Kafka 的分区数、Paimon Bucket 数量等)。
随后,系统将这些物理拓扑特征与集群空闲资源及目标端限流阈值等进行综合计算,动态推算出最优的并发参数进行任务切分,通过资源的“按需分配”与底层物理特征的完美对齐,提升了集群整体的执行效率与资源利用率。
4.3. 任务可观测完善
- Checkpoint 指标监控
对标 Flink 完善的 Checkpoint 监控体系,我们构建了针对 SeaTunnel Checkpoint 观测能力。重点采集 Checkpoint 端到端耗时、state Size、以及 Checkpoint 失败频率等核心指标。
- Master 选举指标
借鉴 Kafka 的主从选举监控体系,我们实现针对 SeaTunnel Master 节点的选举状态监控指标。重点采集选举耗时、触发切换的频率以及 Active Master 的存活状态等核心数据,通过该指标,当集群出现脑裂或主节点异常频繁切换时,可实现及时告警并辅助排查底层的网络或负载瓶颈。
五、未来规划
随着统一通道的稳定运行,我们将目光投向更深层的演进方向。未来 1-2 年,我们平台的建设将聚焦于两大核心方向: 彻底的云原生化 与 全面拥抱 AI。
5.1. 云原生
落地 K8s 原生资源调度,Worker 节点按需创建与销毁,实现弹性扩缩容;参考业界日志聚合最佳实践,构建 Job 远程存储的日志体系。
5.2. AI + 数据通道
构建 AI 驱动的智能运维闭环——自然语言生成同步任务配置、Job 异常自动根因定位、数据延迟自动调优并行度,让数据通道从人工运维走向自愈自调优。
统一数据通道的建设从四套引擎并存到批流一体,从手工脚本到自然语言建任务,从人工校验到旁路索引自动比对,每一步都在逼近"让数据流动像自来水一样可靠"的目标。而云原生化与 AI 的双轮驱动,将是我们下一段的核心引擎。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70049562/viewspace-3176035/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 3 月开始贡献,半年成长为 Committer:Apache SeaTunnel 贡献者牛志伟的开源故事
- 喜报!白鲸开源斩获“创客北京2026”创新创业大赛海淀区级赛企业组二等奖
- 记一次连接器改造经历:为什么我把 BigQuery Sink 从待处理流重构为缓冲流?
- 合作再深化,中信证券携手白鲸开源持续升级数据同步能力!
- Kafka Topic 扩容后,Apache SeaTunnel 不重启也能消费新分区数据
- Redis 数据迁移不用写脚本:SeaTunnel 支持 String、Hash、Set、ZSet 四种数据类型
- 不只是调度,Apache DolphinScheduler 如何支撑企业级数仓实践?
- 用 Apache SeaTunnel 同步 DynamoDB 到 Redis,一个配置文件就够
- 实践心得 | 用 Apache SeaTunnel 搞定 PostgreSQL 到平凯数据库云服务的数据迁移
- OSCHINA 对话白鲸开源郭炜:中国基础软件一定要出海
