又一 SeaTunnel Committer 诞生!曾毅将力推 Connector 升级与 AI 数据集成落地
嘿,朋友们!最近 Apache SeaTunnel 开源项目可谓喜讯传来,天翼云科技的大数据工程师曾毅受邀成为 Committer 的一员,为项目注入新活力!
在 Apache SeaTunnel 社区,曾毅早已凭借出色能力和深厚技术功底崭露头角。此次当选 Apache SeaTunnel Committer,是对他投身开源社区的高度认可。他在社区中积极参与各类项目开发,不仅贡献高质量代码,比如围绕 Connector 能力增强、引擎适配等方面所做的工作,还凭借丰富经验,完善文档和积极参与社区讨论,为其他开发者排忧解难,用实际行动推动着项目的蓬勃发展。
从初涉开源时的探索求知,到如今成为顶级项目的关键贡献者,曾毅的开源之旅必定有许多动人故事与独到见解。他是如何在开源世界中找准方向?又有哪些经验能为后来者指引道路?
想一探究竟,就赶紧来围观社区对曾毅的走心采访吧!
个人简介
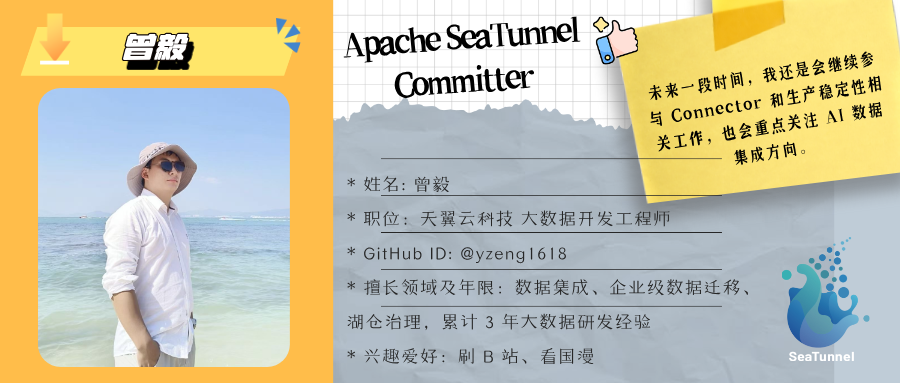
采访实录
- 您参与开源有多长时间了?开源为什么吸引你?
如果以正式向 Apache 项目提交 PR 作为起点,我参与开源大约一年。开源吸引我的地方,主要是能和社区里很多优秀的开发者一起做事。每次 PR Review,Reviewer 都会从命名、边界条件、兼容性、测试覆盖等方面提出建议,这些经验在平时工作里不一定能这么集中地学到。
另外,开源也会让个人贡献产生更大的价值。公司里修一个问题,影响的可能仅仅是一个团队或一个项目;但如果同样的修复合入社区主线,后续就可能被更多用户用到,这种感觉还是很有成就感的。
- 您从何时参与 SeaTunnel 项目的?契机是什么?
我是从 2025 年 4 月开始参与 SeaTunnel 的。4 月 23 日提交了第一条 PR #9213,5 月 16 日通过 #9305 完成第一次合并,正式成为 Contributor。
契机主要来自工作中的真实场景。当时我们基于 Apache SeaTunnel + Flink CDC 构建数据集成产品,底层统一使用 Flink 引擎。在支撑客户同步任务时,遇到了 Oracle BLOB 字段读取后原始格式丢失,以及 Doris Sink 对表名大小写处理不够灵活的问题。我内部修复后觉得这些问题比较通用,就整理成 PR 提给了社区。
- 如今受邀成为 SeaTunnel Committer,总结一下您为社区所做的贡献,包括代码和非代码贡献。
自参与 Apache SeaTunnel 社区以来,我主要围绕 Connector 能力增强、引擎适配、数据同步稳定性、文档完善和社区协作等方向持续贡献。截至目前,我在 apache/seatunnel 仓库累计合并 60 个 PR,涉及 connectors-v2、Zeta、Flink、CDC、Transform-v2、E2E、Docs 等多个模块。
-
代码贡献
-
File Connector 能力增强:围绕 HDFS 大文件读取和文件持续发现做了系统性增强。针对“一个文件对应一个 split”导致大文件并行度不足的问题,实现了 HDFS File Source 的大文件切分读取能力,新增
enable_file_split、file_split_size等配置。text/csv/json文件读取时会结合行分隔符处理,避免破坏记录边界;Parquet 文件则基于 RowGroup 做逻辑切分。 -
文件源持续发现:补充了 FTP、SFTP、Local、HDFS 文件源的 continuous discovery 能力,支持任务运行过程中持续发现新增或更新文件,并支持
scan_interval配置,适合周期性落文件和准实时文件同步场景。 - 常用 Connector 能力建设与问题修复:参与 Hive、JDBC、CDC、Iceberg、Doris、Kafka 等连接器能力增强。例如 Hive Sink 支持 SchemaSaveMode 和 DataSaveMode,补充自动建表、Schema 管理、分区字段和多种存储格式;同时也参与了 JDBC 正则多表读取、PostgreSQL TIMESTAMP_TZ 类型支持、Iceberg 时间类型修复、Doris 大小写兼容、Kafka checkpoint 恢复 offset 修复等工作。
- Flink 版本适配:参与 SeaTunnel 对 Flink 1.20.1 的支持,新增 Flink 1.20 专用 translation layer,使用 Flink 官方 sink2 API 替代较脆弱的反射方案,并补充 starter、构建配置和 E2E 测试基础设施。
- 稳定性与工程质量改进:持续参与 CI 不稳定用例修复、E2E 测试补充、checkpoint 恢复、事务提交、XA XID 重复、空目录读取、CDC snapshot split、Kafka offset restore、Zeta REST API 等问题修复。
-
File Connector 能力增强:围绕 HDFS 大文件读取和文件持续发现做了系统性增强。针对“一个文件对应一个 split”导致大文件并行度不足的问题,实现了 HDFS File Source 的大文件切分读取能力,新增
-
非代码贡献
- 持续完善 SeaTunnel 用户文档和开发者文档,包括连接器中文文档、参数说明、使用示例、E2E 配置说明、onboarding 和 architecture docs 等。
- 积极参与社区 Review 和方案讨论。在多个 PR 中,根据 Reviewer 意见调整实现方案、补充测试和文档,推动 PR 从设计、实现、测试到合入。
- 参与 SeaTunnel 项目这么久,您认为 SeaTunnel 与其他竞品相比的不同点/优势是什么?不足之处是什么?社区有哪些吸引您继续参与的地方?
参与 SeaTunnel 这段时间后,我最大的感受是,它是一个很贴近企业真实数据集成场景的项目。它不是只围绕某一种数据源、某一种计算引擎或者某一种同步方式来做,而是希望把企业里常见的异构数据同步场景统一起来解决。
和一些竞品相比,SeaTunnel 比较明显的优势是 Connector 生态比较丰富。像 JDBC、CDC、Hive、Doris、Kafka、Iceberg、HDFS、FTP/SFTP、Local File 等常见数据源和数据系统,都有比较完整的覆盖。企业里做数据同步时,往往不是单一链路,而是数据库到数仓、数据库到湖仓、文件到 Hive/Doris、CDC 到 Kafka 或 Doris 等多种场景并存。SeaTunnel 能提供相对统一的开发和配置方式,降低重复适配成本。
另一个优势是 多引擎支持。不同公司的大数据技术栈不一样,有些场景更适合 Flink,有些场景会选择 SeaTunnel Zeta 引擎。SeaTunnel 没有把用户绑定在某一个执行引擎上,这点对企业落地比较重要。
不足的话,我觉得 CDC 能力还可以继续完善,尤其是参考 Flink CDC 等同类型项目,SeaTunnel 后续可以在多数据源 schema change 支持、不同 Sink 的一致性、失败恢复稳定性等方面继续加强。文档和最佳实践也可以再优化,特别是生产环境配置、故障排查、性能调优这类内容。另外,AI 数据集成、非结构化数据、向量数据库等方向,也值得继续探索。
社区吸引我继续参与的地方,一方面是 活跃度比较高,很多 issue、PR 和讨论都能得到比较及时的反馈,不会让人觉得是在“单机贡献”。另一方面,我也能明显感觉到自己的贡献是有价值的。很多问题本来是在业务场景里遇到的,修完后贡献到社区,后续其他用户也能直接受益。
还有就是 社区 Review 比较认真。Reviewer 不只是看代码能不能跑,也会关注方案是不是通用、边界有没有考虑清楚、测试和文档有没有补齐。这个过程虽然有时候需要反复修改,但对我个人工程能力提升很大,所以我也愿意继续参与下去。
- 您是否针对 SeaTunnel 的不足之处进行过二次开发?是否已贡献给社区?开发方案是否可以介绍一下?
有的。我最开始参与 SeaTunnel,其实就是因为自己在使用过程中遇到了一些问题。
当时我们基于 SeaTunnel 和 Flink CDC 做数据集成,在实际同步任务里发现了 Oracle BLOB 字段读取格式、Doris Sink 表名大小写处理这类问题。它们看起来都是细节,但放到生产环境里,如果处理不好,就会直接影响同步结果。所以我先在内部验证了一版方案,确认没问题后,就整理成 PR 提给了社区。
后面我做得比较多的是 File Connector。比如 HDFS 大文件读取,以前一个文件对应一个 split,遇到单个大文件时并行度上不去。我补充了大文件切分读取能力,可以通过配置控制是否切分以及切分大小。这里不是简单按字节切开就行,像 text、csv、json 这类文件要考虑行边界,不能把一行数据切坏;Parquet 则更适合按 RowGroup 做切分。
另外,我也补充了 FTP、SFTP、Local、HDFS 文件源的 continuous discovery 能力。这个主要是因为很多文件同步场景不是一次性把文件准备好,而是上游会周期性落文件,所以需要任务运行过程中持续发现新增或更新文件。
还有 Flink 1.20.1 的适配,也是因为我们的集成产品需要统一升级 Flink 版本,所以我参与了 SeaTunnel 对 Flink 1.20.1 的兼容适配,包括 translation layer、starter、构建配置和 E2E 测试等,保证升级后 SeaTunnel 在新 Flink 版本下能正常运行。
这些能力后来基本都贡献给社区了。我的想法比较简单: 如果一个问题只在内部修,后面就要一直维护内部 patch;但如果这个问题比较通用,贡献回社区会更有价值,也能让方案经过社区 Review 后更稳一些。
- 您所在公司是否使用过 SeaTunnel?使用场景是什么?如果未使用过,是否会考虑向公司推荐?推荐的理由是什么?
我们公司是有实际使用 SeaTunnel 的。面向客户的数据集成场景,我们基于开源的 Apache SeaTunnel + Flink CDC,底层统一使用 Flink 引擎,构建了一套数据集成产品,主要支撑海量数据同步到湖仓数据平台。
目前接入的数据源比较多,包括各类数据库、数据仓库、数据湖,也包括 Kafka、HTTP 等数据源。比较典型的数据目标是 Hive、Doris、Iceberg 等,用来支撑客户的数据入湖、入仓和实时/离线同步需求。
从实际使用感受来看,SeaTunnel 比较适合作为数据集成产品的底座。一方面它的 Connector 覆盖比较广,能够适配不同客户的数据源;另一方面,它的配置和扩展方式比较清晰,适合在企业内部做产品化封装。
当然,真正面向客户交付时,我们也会结合具体场景做一些适配和验证,比如复杂类型兼容、任务稳定性、失败恢复、性能表现以及不同目标端的写入能力等。整体来看,SeaTunnel 在异构数据同步和湖仓集成场景里还是比较有价值的。
- 您还希望参与 SeaTunnel 社区能对您的个人成长提供什么样的支持?
我希望通过参与 SeaTunnel 社区,继续提升自己的工程能力、开源协作能力和技术视野。
SeaTunnel 涉及数据源适配、类型转换、任务切分、容错恢复、checkpoint、多引擎适配等很多生产级问题,对我理解大数据系统很有帮助。
同时,开源协作也让我更习惯从通用性、兼容性、文档和测试完整性的角度去思考问题,而不是只解决当前场景。
后续我也希望能多参与 Review 和社区讨论,帮助其他 Contributor 一起完善方案。另外,如果社区在 AI、Agent、非结构化数据、向量数据库等方向有更多探索,我也希望参与其中,积累一些新的实战经验。
- 您对社区 Committer 角色的理解是什么?Committer 应该在社区中做什么/起到什么作用?
我理解 Committer 不只是拥有代码合并权限,更重要的是要对项目质量和社区发展负责。
首先,Committer 还是要 持续贡献。不能只是获得这个身份后就停下来,而是要继续在自己熟悉的模块里发现问题、解决问题,推动能力完善。
其次,Committer 要 认真参与 Review。Review 不是简单看代码格式或者能不能编译通过,更重要的是看方案是否合理、是否足够通用、有没有考虑边界情况、会不会破坏已有兼容性、测试和文档是否完整。很多时候,一个 PR 经过 Review 后,方案会比最初版本更清晰、更可靠。
第三,Committer 应该 帮助新 Contributor 融入社区。很多人第一次参与开源时,不一定熟悉项目结构、提交规范、测试方式和社区沟通流程。如果能得到及时、友好的反馈,他们会更有信心继续贡献。社区要长期发展,不能只依赖少数人,而是需要不断有新人加入。
最后,Committer 也应该 参与一些方向性的建设。比如哪些 Connector 需要重点完善,哪些稳定性问题优先级更高,哪些文档和测试需要补齐,都需要结合社区反馈和真实使用场景一起推进。
- 受邀成为 Apache 软件基金会 Committer,您有什么感想/想对社区说的话,或对项目发展有什么建议?
能够受邀成为 SeaTunnel Committer,我很感谢社区对我之前贡献的认可。对我来说,这既是一种鼓励,也是一份责任。
我最开始参与 SeaTunnel,是因为工作中遇到了一些实际问题。后来参与得多了,发现很多业务问题其实并不是个例,如果能沉淀到社区里,就可以帮助更多用户,这也是我觉得开源很有价值的地方。
在这个过程中,我也很感谢社区里各位 Reviewer 和 Contributor 的帮助。很多 PR 都经过了多轮讨论和修改,虽然过程有时会反复,但最终方案确实会更完善,也让我学到了很多。
对项目发展来说,我希望 SeaTunnel 后续能 继续加强核心 Connector 的生产级能力,比如 CDC、JDBC、File、Hive、Doris、Iceberg 等,同时在稳定性、可观测性、文档和最佳实践方面继续完善。
另外,我这边也会继续关注和参与 AI 相关方向的贡献和实践,比如非结构化数据处理、向量数据库、LLM 数据链路、Agent 自动化等场景,希望后续能结合 SeaTunnel 的数据集成能力做更多探索。
- 未来一段时间,您个人在社区有何计划以推动项目进一步发展?
未来一段时间,我还是会继续参与 Connector 和生产稳定性相关工作,比如常用连接器能力补齐、问题修复和 E2E 测试完善。
同时,我会重点关注 AI 数据集成方向。最近社区也在讨论 Knowledge Sync / RAG 相关能力,希望让 SeaTunnel 能承担企业知识库同步和索引这一层能力,比如文档发现、解析、切分、Embedding、写入 Milvus/Qdrant 等向量数据库,以及支持文档更新、删除、跳过未变化内容等生命周期管理。
我个人也希望在这个方向继续参与设计和实现,把 SeaTunnel 原有的数据同步能力和 AI、RAG 场景结合起来,探索它在企业知识库、非结构化数据同步和向量检索数据准备中的更多可能性。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70049562/viewspace-3173049/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 3 月开始贡献,半年成长为 Committer:Apache SeaTunnel 贡献者牛志伟的开源故事
- 喜报!白鲸开源斩获“创客北京2026”创新创业大赛海淀区级赛企业组二等奖
- 记一次连接器改造经历:为什么我把 BigQuery Sink 从待处理流重构为缓冲流?
- 合作再深化,中信证券携手白鲸开源持续升级数据同步能力!
- Kafka Topic 扩容后,Apache SeaTunnel 不重启也能消费新分区数据
- Redis 数据迁移不用写脚本:SeaTunnel 支持 String、Hash、Set、ZSet 四种数据类型
- 不只是调度,Apache DolphinScheduler 如何支撑企业级数仓实践?
- 用 Apache SeaTunnel 同步 DynamoDB 到 Redis,一个配置文件就够
- 实践心得 | 用 Apache SeaTunnel 搞定 PostgreSQL 到平凯数据库云服务的数据迁移
- OSCHINA 对话白鲸开源郭炜:中国基础软件一定要出海
