[大模型实战 03预备] 云端炼丹房 1:Google Colab 上手指南
核心摘要 (TL;DR)
- 痛点:本地电脑显存不足,跑不动 7B 以上的大模型,或者运行速度如蜗牛。
- 方案:利用 Google Colab 提供的免费 Tesla T4 GPU 算力。
- 技巧:通过挂载 Google Drive,解决 Colab 运行时重置导致模型文件丢失的问题。
- 目标:配置好云端环境,为下一篇“云端运行 RAG”打好地基。
前言
Ollama因为有llama.cpp库和量化技术的加成,是可以在cpu和更日常的电脑上运行的,但是性能是远比不上在专业的显存设备上的。 有高端显卡(NVIDIA 4090/5090/A100/H100),可以在自己的服务器上脱缰运行小规模的大模型。但是对于没有高端显卡设备的友人们也不用担心, 我们可以使用谷歌大善人带给我们的免费GPU算力:爱来自Google Colab。 本篇博文的主要目的就是提前带各位友人们从零上手Colab的核心操作,确保在我们后续的实战过程中的流畅操作。
1. Google Colab
一言概之, Google Colab = Jupyter Notebook + 云端服务器
- Jupyter Notebook:我们知道python是一门动态脚本语言,意味着我们可以一边编写,一边以交互式的方式看到当前结果,然后还能继续往下写。Jupyter Notebook就是一种可以一边写代码,一边写文档,还能实时看到代码运行结果的交互式笔记。
- 云端服务器:区别于在我们本地环境写代码时,代码在我们的本地电脑,换一台电脑就需要重新拉取代码运行,在云端服务器编码是在远程的服务器编码,我们通过自己的电脑,甚至手机或者任何能联网打开浏览器的设备,连接上远程的那台服务器进行代码编写和模型训练。会更为灵活,不受设备限制。
2. 快速介绍
2.1 访问与创建
- 咱们确保有一个Google账户,并且登录
- 访问 Google Colab 官网,就会进入到一个欢迎界面

- 点击菜单栏上 File-> new notebook in drive创建新的笔记本


2.2 界面介绍
在新的notebook界面,我们可以看到
- 文件名:左上角“Untitled0.ipynb”的文件名,可以单击重命名,ipynb就是jupyter notebook的后缀名

- 单元格:页面中心一长条带一个▶按钮的就说单元格,也叫Cell,是我们的核心编码区域, Jupyter notebook的逻辑是“一段一段”执行代码,而非我们平常写代码时候写完一整个文件再执行。

- 快捷操作栏:在单元格上方的位置有一条快捷菜单栏,支持我们添加新的代码块(Code Cell)和文本块(Text Cell),运行全部单元格(Run All)。

- 左侧工具栏: 包含目录速览,查找替换,密钥管理,数据查看等等工具。

- 变量和终端:这里的变量按钮可以查看执行到当前的变量信息,就不用去print变量了,很方便。终端按钮就和Linux终端一样,可以用来执行一些命令。

3. 核心操作
在界面介绍时,咱们快速介绍了一下两种单元格: 代码块和 文本块,接下来可以稍微多了解一点点这两种单元格
3.1 代码块
就是我们的主力战场,编写Python代码的地方,可以快速体验一下使用流程
- 直接输入python代码,然后点击运行(那个▶按钮或者使用快捷键
Shift + Enter)

- 可以看到代码块左侧有一个\[1\],一个绿色的√,代码块下方有输出的打印结果
前面的序号标明代码块的执行顺序,因为我们可以乱序执行,执行完下方代码块再回来执行前面的代码块
3.2 文本块
jupyter notebook是支持直接渲染markdown格式的文档的,所以也有人直接用它当文档。相比于我们用注释去记录,markdown格式的文本块会更直观。
- 点击上面的 ➕Text按钮(或者在当前单元格上方/下方中间浮现显示的快捷按钮)去新增一个文本块
- Shift+Enter快捷键“运行/渲染”它,


4. 开启免费GPU算力
默认状态下Colab是使用的CPU,我们接下来去开启GPU
- 点击顶部菜单栏的 Runtime(运行时)下拉菜单中的 Change runtime type(更改运行时类型)

- 选择 Hardware accelerator(硬件加速器)的 T4 GPU.

- 弹出的窗口警告我们会断联当前运行时,切换到T4GPU的硬件,选择OK

- 保存,然后会发现之前运行过的代码块失活了(前面框框里的数字消失了,所有运行过的代码块需要重新运行)
- 我们来输入以下代码验证
!nvidia-smi
 从返回的表格结果中,能看到咱们的设备是TeslaT4。
在notebook代码块中以
!开头即可运行命令,这里等效为在terminal中运行
nvidia-smi
PS:除了切换文件夹得用
%cd而不是
!cd
5. 下载大模型
我们使用Colab主要是为了使用大模型以及训练大模型,对于Colab而言,模型的下载有个痛点: Colab是临时的,哪怕我们通过命令下载了好几个G的模型,甚至好几十G的模型,但是每次重置运行时的时候,这一切都会灰飞烟灭,消散如烟。为了避免每次都重新下载,浪费时间,我们可以通过挂在Google Drive来保存模型。
5.1 挂载Google Drive
- 我们运行以下代码
from google.colab import drive
drive.mount('/content/drive')
- 然后在弹出授权窗口中授权

- 就能在代码块下方看见已经成功挂载的打印信息

5.2 配置HuggingFace环境变量和Token
在下载受限模型(如 Llama 3)时,你需要 Hugging Face Token。
- 去 Hugging Face Settings 获取 Token。
- 在 Colab 左侧钥匙图标(Secrets)里添加
HF_TOKEN。

5.3 指定缓存路径下载
因为咱们在Colab环境,是国外的魔法环境,我们可以直接使用hugging face来下载模型,我们接下来指定一下模型下载的缓存路径到挂载的Google Drive。
- 咱们先切回CPU环境,因为下载模型并不需要GPU,切回去可以节约一点咱们的额度。
- 输入以下代码然后运行
from google.colab import drive
import os
# 1. 挂载云盘
if not os.path.exists('/content/drive'):
    drive.mount('/content/drive')
# 2. 准备目录
cache_dir = "/content/drive/MyDrive/huggingface_cache"
os.makedirs(cache_dir, exist_ok=True)
# 3. 设置 Token (如果你在左侧 Secrets 设置了 HF_TOKEN,这里自动读取)
# 如果没设置,请手动把下行代码引号里换成你的 token,或者留空试下(Qwen 有时不需要)
my_token = os.getenv('HF_TOKEN') or ""
print("屏幕可能会静止 5-10 分钟,请盯着左边的小圆圈转动即可。")
cmd = f"huggingface-cli download Qwen/Qwen2.5-7B-Instruct --cache-dir {cache_dir} --quiet"
if my_token:
    cmd += f" --token {my_token}"
# 执行命令
result = os.system(cmd)
if result == 0:
    print("\n 下载成功!")
else:
    print("\n 下载失败,请检查网络或 Token。")
- 然后运行下面的命令检验模型是否下载完毕
# check disk usage (查看磁盘占用)
# -s: 汇总大小, -h: 人类可读格式 (GB/MB)
!du -sh /content/drive/MyDrive/huggingface_cache/models--Qwen--Qwen2.5-7B-Instruct
看到的结果应该是15G大小的文件

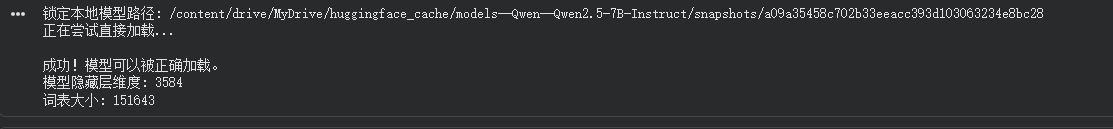
一般情况下,建议模型下载和数据处理都在CPU模式下进行,然后处理完毕存入云盘. 4. 然后新建代码块,运行如下代码,来确认模型是否能够被识别
import os
import glob
from transformers import AutoConfig, AutoTokenizer
# 1. 设置你的缓存根目录
base_cache_path = '/content/drive/MyDrive/huggingface_cache'
# 2. 构造快照目录的通配符路径
# 结构通常是: base / models--ID / snapshots / <哈希值>
snapshot_pattern = os.path.join(
    base_cache_path,
    "models--Qwen--Qwen2.5-7B-Instruct",
    "snapshots",
    "*"  # 这里用 * 匹配那个随机生成的哈希文件夹
)
# 3. 寻找真实的文件夹路径
found_folders = glob.glob(snapshot_pattern)
if not found_folders:
    print(" 错误:找不到 snapshots 文件夹,请检查下载是否成功或路径是否正确。")
else:
    local_model_path = found_folders[0]
    print(f"锁定本地模型路径: {local_model_path}")
    print("正在尝试直接加载...")
    try:
        config = AutoConfig.from_pretrained(local_model_path)
        tokenizer = AutoTokenizer.from_pretrained(local_model_path)
        print("\n成功!模型可以被正确加载。")
        print(f"模型隐藏层维度: {config.hidden_size}")
        print(f"词表大小: {tokenizer.vocab_size}")
    except Exception as e:
        print(f"\n加载依然失败。可能是 Google Drive 的软链接失效了。")
        print(f"错误信息: {e}")
05. 常见问题 (Q&A)
Q: CPU 和 GPU 跑大模型,性能差异到底有多大? A: 差异巨大,就像 法拉利和 拖拉机的区别。
- CPU (中央处理器):像一个知识渊博的教授,计算能力强但只能一个一个任务串行处理。推理大模型时,它需要逐个计算矩阵乘法,生成一个字可能需要好几秒。
- GPU (图形处理器):像一个由几千名小学生组成的方阵,虽然单人能力不如教授,但能同时进行大规模并行计算。大模型的本质是海量的矩阵运算,GPU 可以瞬间完成,生成速度通常是 CPU 的几十倍甚至上百倍。
Q: 那一台 RTX 4090 能运行多大的模型?能微调多大? A: RTX 4090 拥有 24GB 显存,这是核心瓶颈。
- 推理 (运行):
- 4-bit 量化:显存占用 ≈ 参数量 × 0.7。4090 极限可以跑 30B - 34B 参数的模型(如 Yi-34B-Chat-Int4)。
- 全精度 (FP16):显存占用 ≈ 参数量 × 2。4090 最多跑 10B - 12B 参数的模型。
- 微调 (训练):
- 全量微调:想都不要想,需要几百 GB 显存。
- LoRA / QLoRA (轻量微调):这是咱们个人玩家的主流。4090 可以轻松微调 7B - 10B 的模型。
Q: 动态脚本语言 (Python) 和常规预编译语言 (C++/Java) 有什么区别? A:
- 预编译语言 (C++/Java):像写书。写完一整本书(代码),送去印刷厂(编译),最后出来成品书(可执行文件)。执行速度快,但修改麻烦,改一个字要重新印刷。
- 动态脚本语言 (Python):像聊天。你说一句(写一行代码),解释器就执行一句。虽然执行速度稍慢,但胜在 交互性极强。在数据科学和 AI 领域,我们需要频繁查看数据的中间结果(比如查看模型输出的张量形状),Python 的这种特性让它成为了 AI 领域的霸主。
Q: Colab 里的 T4, A100, TPU 都有什么差别? A:
- T4 (免费版标配):入门级推理卡,16GB 显存。跑 7B 模型推理没问题,微调 QLoRA 勉强够用。咱们薅羊毛主要就薅它。
- A100 (付费版):计算卡,40GB/80GB 显存。速度极快,显存极大,适合跑大参数模型或进行严肃的训练任务。Colab Pro/Pro+ 才能刷到。
- TPU (Tensor Processing Unit):Google 专门为机器学习定制的芯片,处理矩阵运算比 GPU 更快,但生态和兼容性(PyTorch 支持)不如 Nvidia GPU 通用,上手门槛稍高。
本文作者: Algieba 本文链接: https://blog.algieba12.cn/llm02-1-online-environment-colab/ 版权声明: 本博客所有文章除特别声明外,均采用 BY-NC-SA 许可协议。转载请注明出处!
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70049457/viewspace-3109878/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- [大模型实战 07 额外篇] 从 ReAct 到 Workflow:基于云端 API 构建事件驱动的智能体
- [大模型实战 07] 基于 LlamaIndex ReAct 框架手搓全自动博客监控 Agent
- [大模型实战 06] 我的模型我做主:在 Kaggle 上用 Unsloth 极速微调 Qwen3
- # [大模型实战 05] 大模型实战的杀手锏: 模型微调
- [大模型实战 04] 从玩具到生产:基于 ChromaDB 打造工程级 RAG 系统
- [大模型实战 03] 拆解 Transformers:从原理图解到 HuggingFace Transformers 实战
- [大模型实战 03预备] 云端炼丹房 2:Kaggle 上手指南
- [大模型实战 02] 图形化的大模型交互: Open WebUI部署指南
- [大模型实战 01] 本地大模型初体验:Ollama 部署与 Python 调用指南
