作者:感仰
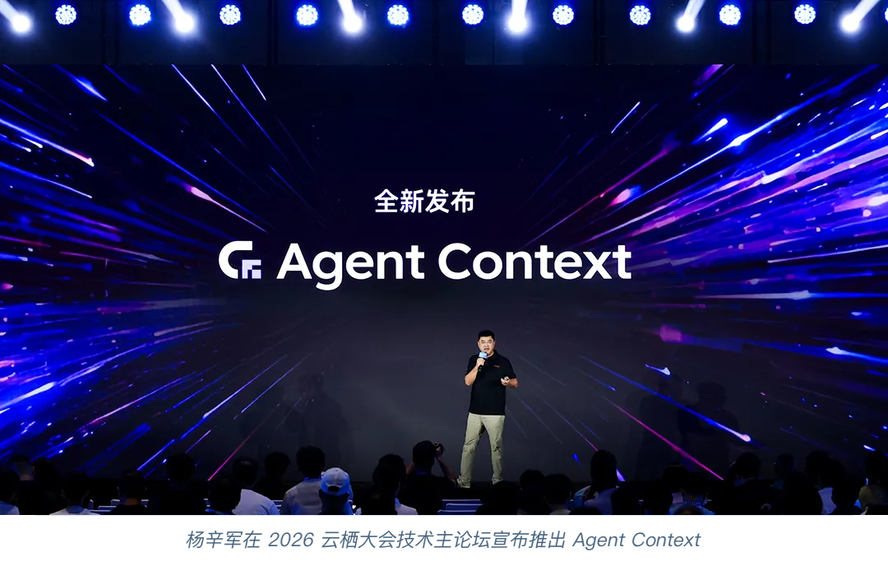
在 2026 云栖大会技术主论坛上, 阿里云智能集团研发副总裁、数据库产品事业部负责人杨辛军发表题为《让 Agent 更具生产力,智能体时代的数据底座全面升级》的主题演讲,并宣布推出 面向企业级 Agent 的上下文服务 Agent Context。
这次发布指向一个正在迅速显现的问题:
模型能力持续增强,Agent 调用工具数量日益增多,但在真实业务场景中,Agent 依然常常“读不懂上下文”——不知道事情从何而来、目前进展到哪一步、该向谁确认,以及哪些能做、哪些不能做。
Agent Context 的定位,是让企业数据以上下文的形式持续服务 Agent: 把散落在文档、系统与协作记录中的企业数据,组织成 Agent 可理解、可使用的 Context。
01 企业数据很多,Agent 能用的 Context 却很少
企业通常已经积累了大量资料,只是它们分散在不同地方:最新规则写在文档中,决策依据留在评审记录里,实际状态保存在业务系统中。用于具体任务前,还要把相关线索联系起来,核对版本和适用范围。这种情况在不同团队的日常工作中都很常见:
- 业务活动策划:业务团队准备下一轮活动,Agent 很快写出了方案。熟悉业务的同事看完,却提醒了一句:“这个渠道上次试过,效果不理想。”团队仍需找回预算限制、历史复盘和评审结论,才能进一步调整方案。
- 研发需求变更:Agent 找到了相关代码,还需要弄清某段旧逻辑为什么保留、另一种设计为什么被否决,以及哪些系统仍然依赖当前实现。这些问题的答案,可能留在几个月前的设计文档和讨论里。
- 运维告警处理:异常日志只提供了部分线索。判断原因还要结合最近的配置变更、系统依赖,以及上次类似故障的处理经验。
这些上下文,单次任务可以通过提示词和附件补充背景。但当多个部门、多个 Agent 同时工作,相同约定就要反复解释,失效版本容易被再次引用,新经验又留在各自的对话里。因此, 团队需要一套能够持续维护、按需使用的上下文服务,减少每次任务开始前的重复准备。
02 Agent Context 解决的不是“存更多数据”,而是“持续供给上下文”
Agent Context 关注的不是单纯把数据存起来,而是对企业数据的整合、组织、关联与治理,使之成为 Agent 可以按需获取、持续使用的上下文。
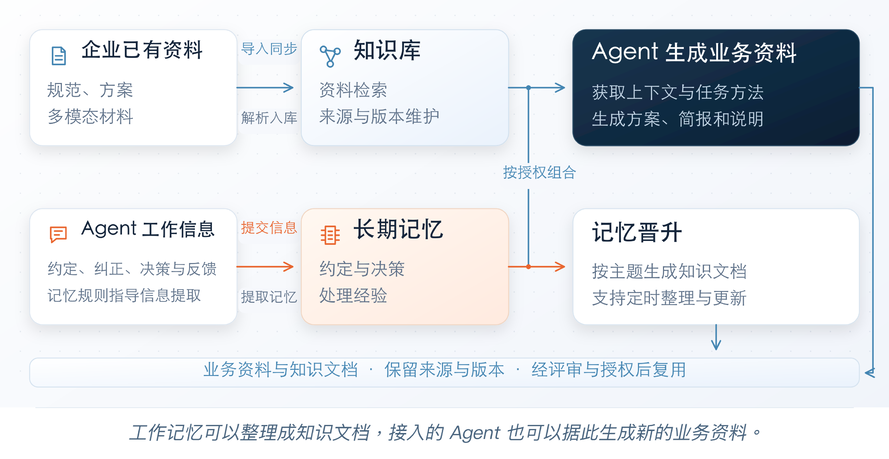
它将企业的知识、记忆与 Skill 统一管理:已有资料进入知识库,工作中值得保留的信息提取为记忆,经过验证的方法连同配套资源整理成 Skill。Agent 按当前身份和任务获取相关内容,团队则持续维护这些内容的来源、版本和使用范围。
任务完成后,其中值得保留的新信息和执行反馈,可以经过整理,补充或修正已有上下文。数据支持任务,任务产生反馈,反馈推动上下文更新,更新后的上下文再服务下一次任务。
在这个体系中,Agent Context 不止为单次任务查找资料,更长期、稳定地为不同 Agent 提供可信、相关且不断更新的上下文。
03 要持续供给企业级上下文,需要哪些能力?
多来源、多模态数据的接入与组织
同一项工作的依据可能分散在文档、图片和音视频中:设计图展示系统关系,故障录屏呈现异常过程,评审录音保留讨论与取舍。关联这些信息,才能更完整地理解工作背景。
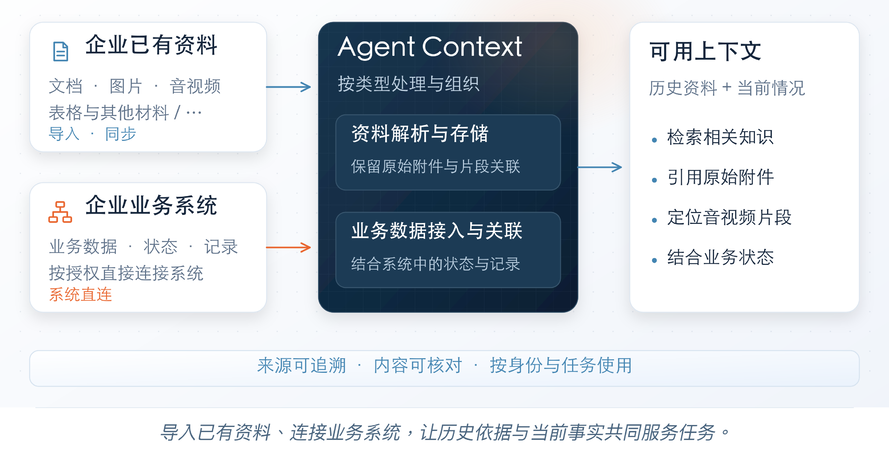
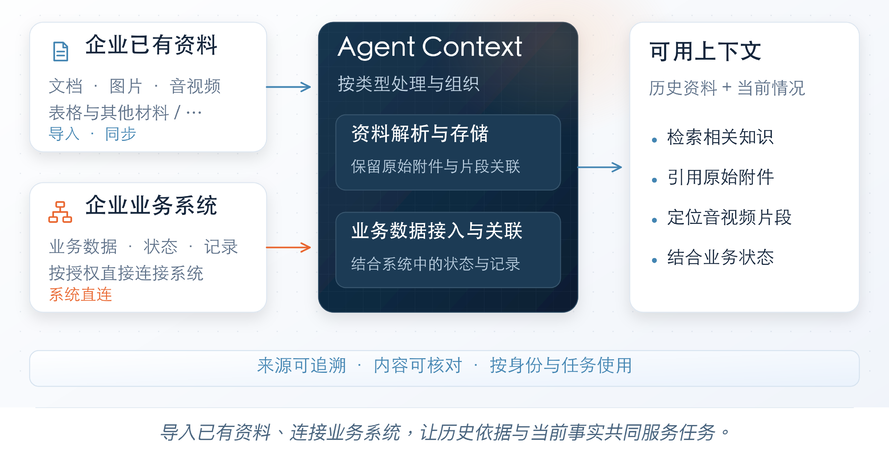
Agent Context 支持导入、同步已有资料,也可直接连接企业业务系统,让 Agent 结合历史材料与系统中持续变化的数据、记录,判断当前情况。
系统按数据类型处理和存储信息,并保留来源关联。资料解析后形成可检索的知识,检索结果可引用原始附件、定位音视频片段,便于核对原始内容。
业务语义与规则的理解
一份研发评审记录里,可能同时出现已经生效的约定和讨论中的备选方案。评估需求变更时,Agent 要先分清两者,还要知道当时的取舍针对哪个版本、受到哪些依赖限制。
在 Agent Context 中,资料附带的版本和适用条件可以帮助限定查找范围,知识图谱则把业务对象、规则与依赖关系关联起来。沿着这些关联,Agent 可以找到相关说明,再回到来源核对,判断一条结论能否用于当前任务。
当不同资料对对象和关系的描述不一致时,还需要统一业务定义。Agent Context 的本体约束能力支持用业务定义的类型、属性和关系规则,规范知识抽取与图谱治理。
上下文数据的持续加工与演进
项目推进或系统升级后,原有说明可能需要修订。Agent Context 的 知识评审提供质量评估和重写建议,并按策略自动通过或转入人工审核,供负责人修订内容、维护版本和适用条件。
排查时补充的适用条件、评审中解释的设计原因等经验,未必立即写进正式文档。Agent 可将相关工作信息提交给服务端,由服务端提取记忆,记忆规则可指导保留已确认的约定和决策依据。
记忆整理梳理信息变化、冲突与重复记录; 遗忘管理可让长期不活跃的内容退出召回,并保留恢复入口。需要纠错时,也可直接修改。
通过这些机制, 上下文可以在系统辅助与人工治理的配合下持续加工和演进。
精细化权限管控与统一治理
上下文被更多团队使用后,共享范围就需要更加清晰。公司统一的指标说明可以授权共用,部门资料、项目决策和个人记忆则需限定访问范围。
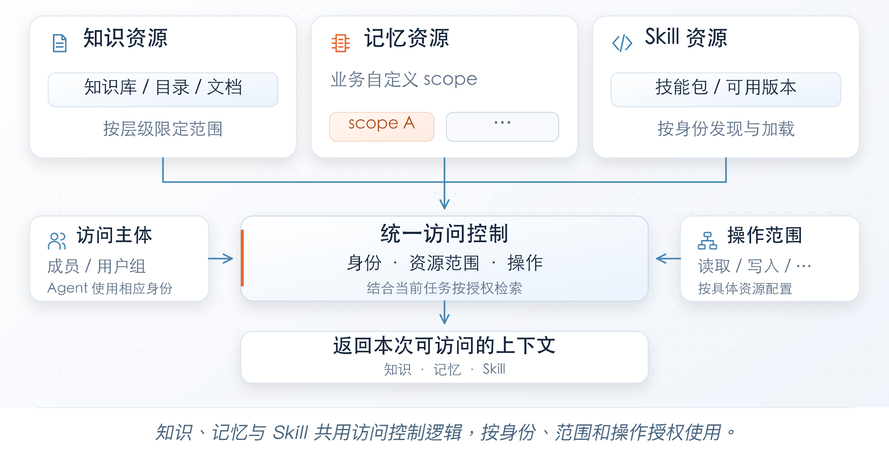
Agent Context 支持将知识权限细化到知识库、目录和文档;记忆可按个人、项目或群聊等业务范围组织和管理,访问时仍需相应授权。
Agent 按当前身份发现和加载有权使用的 Skill 及其版本,实际执行仍遵循已有工具权限。系统结合身份、资源范围和操作权限控制访问;成员职责或资料共享范围变化时,需重新核对权限和维护责任。
04 基于上下文,持续沉淀新的知识与 Skill
日常工作留下的记忆,往往围绕一次对话或一项任务展开。接手的同事要沿用这些经验,还需要了解完整过程:一次故障是如何定位的,哪些办法有效,又适用于什么条件。
通过 Agent Context 的 记忆晋升,相关记忆可整理成主题文档,保留来源和待确认问题,经成员核对、补充后归档到知识库。 定时晋升则按计划整理持续积累的记忆,达到设定质量要求后更新知识文档。归档文档与来源记忆分别维护,修订时仍需核对对应内容。
在授权范围内,这些知识与记忆也可以支持接入的 Agent 生成日常资料,例如更新活动方案、整理项目简报或编写操作指南。新资料保留来源、版本和使用范围,经相应审核后,就能用于后续工作。
工作中反复验证的方法,还可以连同步骤、检查要求与配套文件整理成 Skill。Skill 通过版本管理记录后续修订;接入方式支持技能演进时,任务证据还可以形成创建或改进建议,由当前 Agent 处理、校验并发布。
05 上下文发生变化,可以进一步驱动 Agent 工作
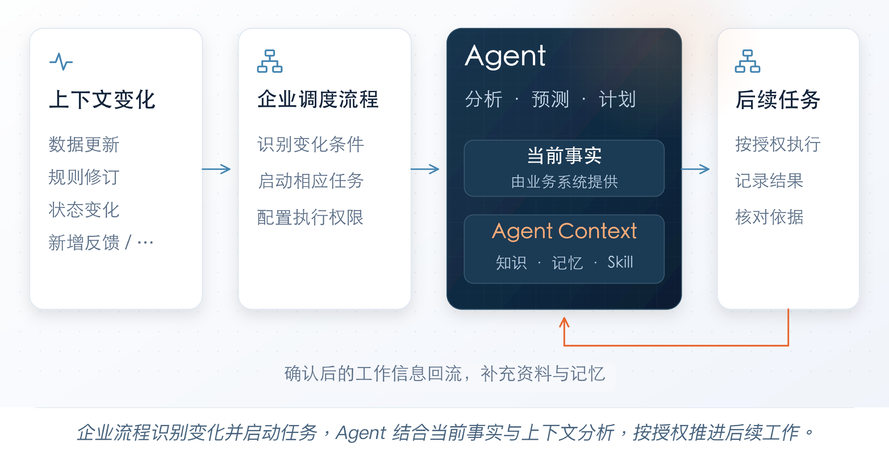
上下文更新之后,也可能产生新的跟进任务。比如,配置变更可能改变故障排查的方向,项目依赖调整可能要求补充验证,渠道表现偏离预期则需要重新评估活动安排。
企业可以在业务流程中配置相应的变化条件和调度规则,在条件满足时启动 Agent。Agent 再结合业务系统中的当前事实,以及 Agent Context 提供的业务规则、历史依据和任务方法,分析影响、修订预测或形成后续计划。
随着任务推进,预测和建议要根据新信息与实际结果继续修订。具体行动遵循企业配置的工具调用和执行权限,过程中确认的新信息再进入资料和记忆,供后续判断使用。
06 模型和 Agent 持续演进,企业的上下文资产应当接得上
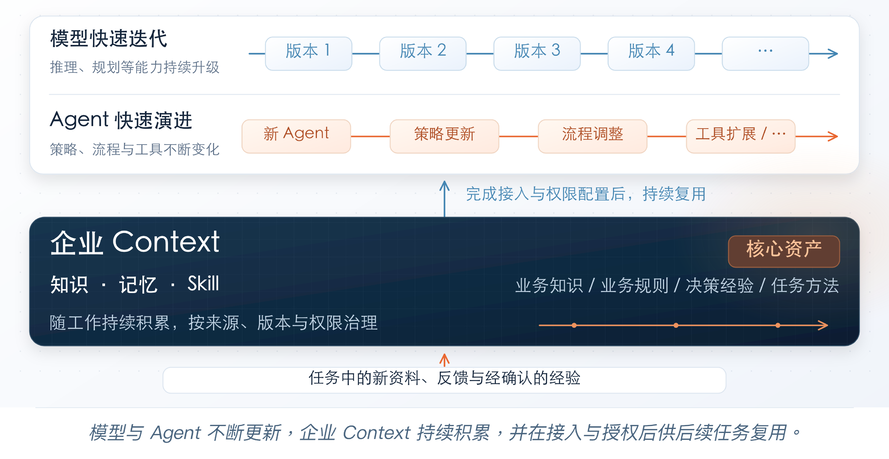
模型和 Agent 的迭代速度很快,企业在使用 Agent 的每一轮工作中,也在持续留下新的资料、经验和方法。随着技术演进,企业会不断调整所使用的模型和工具,但长期形成的业务积累仍然需要保留和使用。
新的工具仍然需要知道:哪些规则有效,历史决策为何作出,过去的经验适用于什么条件。把这些知识组织成可维护、可复用的 Context,就能让企业对自身业务的理解延续下去。 这种来自长期实践、持续丰富的上下文,是企业值得重点建设的核心资产。
Agent Context 为这些资产提供统一的管理和维护。新的模型与 Agent 完成接入和权限配置后,可以继续使用已有上下文,减少更换工具时重新整理业务背景的工作。
结语
企业对业务的理解,来自一次次真实的决策、协作与实践。Agent Context 让这些积累能够被持续维护和复用,使每一次工作留下的经验,都有机会成为下一次行动的依据。模型与 Agent 持续演进,企业积累的知识、经验与方法,应当成为穿越工具迭代的长期资产。
了解与体验 Agent Context
点击此链接 https://www.aliyun.com/activity/database/contextdb ,进入 Agent Context(原 RDS ContextDB)专题页,领取价值 799 元的免费权益!

