近期,PolarDB分布式版(简称“ PolarDB-X ”)正式发布 开源V 2.5.0 版本 , 该版本重点强化 AI 原生能力, 包括 :新增 AI Function(SQL 内直接调用大模型)、HNSW 向量索引等面向 AI 场景的核心能力,让 PolarDB-X 从"分布式关系型数据库"进一步演进为"AI 时代的一体化数据底座"
开源项目地址: https://github.com/polardb/polardbx-sql
PolarDB分布式版简介
PolarDB分布式版是阿里云自主研发的云原生集中式和分布式一体化数据库产品,采用基于存储计算分离的Shared-Nothing系统架构,支持水平扩展、分布式事务、混合负载等能力,具备金融级高可用、高度兼容 MySQL 生态等特点。
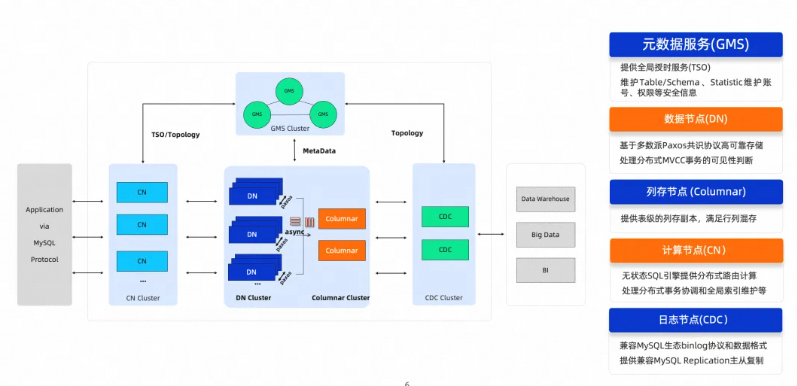
PolarDB分布式版产品架构
PolarDB具备多种产品输出形态:公共云、专有云、DBStack、轻量版(纯软输出)。2021年10月,阿里云宣布对外开源PolarDB-X,采用 全内核开源 的模式,开源内容包含计算引擎、存储引擎、日志引擎、列存引擎等。
本文所有 Demo 均基于 PolarDB-X Zero 创建的企业版实例真实运行产出 。 (向量索引与 AI Function 均可直接使用)。
AI 原生能力:Vector Index + AI Function
随着大模型与 RAG 应用的普及,"向量检索 + 关系数据"一体化正在成为数据库的标配能力。PolarDB-X v2.5.0 从内核层面补齐了 AI 原生的两块拼图:
-
HNSW 向量索引(Vector Index) :DN 新增原生 VECTOR 数据类型与基于 HNSW 算法的向量索引,支持高并发写入,可在同一条 SQL 中完成"关系过滤 + 语义检索",无需外挂向量库。 -
AI Function:
CN/DN 新增一组内置 AI 函数,支持在 SQL 中直接调用大模型完成文本推理、向量化、分类、抽取、摘要、精排乃至 Text2SQL,无需引入 AI SDK 或自建推理服务。
基于PolarDB-X Zero快速体验
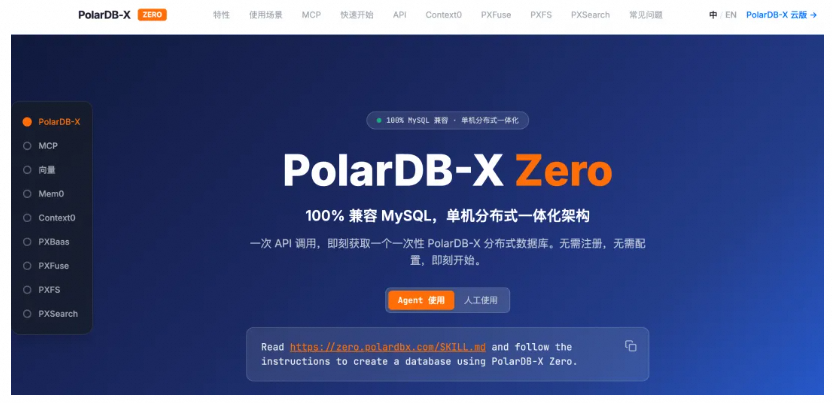
PolarDB-X Zero 是一个 免费、免注册、秒级创建的体验入口,无需阿里云账号与付费,通过 HTTP API 即可一键拉起独立实例。连接后即可确认实例已具备 AI 原生能力(向量索引默认开启、AI 网关自动注册模型)。Zero 实例到期后自动回收,生产使用可一键「转正」到商业版。即可获得高可用多副本、列存只读节点、全球数据库(GDN)等企业级能力。
# 一键创建企业版(分布式)体验实例,有效期最长 30 天
curl -X POST https://zero.polardbx.com/api/v1/instances \
-H "Content-Type: application/json" \
-d '{"tag": "polardbx-v250-demo", "ttlMinutes": 43200, "edition": "enterprise"}'
返回的
connectionString
可直接用于任意 MySQL 兼容客户端 / ORM / 驱动连接:
{ "instance": { "id": "pxzero-xxxxxxxxxxxx", "edition": "enterprise", "connectionString": "mysql://<user>:<password>@pxzero-xxxxxxxxxxxx.polarx.rds.aliyuncs.com:3306", "status": "ready", "expiresAt": "2026-10-20T04:01:23.010Z" }}连接后即可确认实例已具备 AI 原生能力(向量索引默认开启、AI 网关自动注册模型):
SELECT VERSION();SHOW VARIABLES LIKE 'vidx_disabled'; -- OFF,原生向量索引可用SHOW AI MODEL; -- AI 网关已自动注册 LLM / Embedding / Rerank 等模型
Demo场景一:把 PolarDB-X 作为 AI Agent 的记忆库
PolarDB-X 的向量能力已打通主流 AI 开发框架,可作为 Agent 的长期记忆库 / RAG 知识底座:
-
langchain-polardbx:LangChain VectorStore 集成,可直接作为 RAG 检索器 -
llama-index-vector-stores-polardbx:LlamaIndex VectorStore 集成 -
支持 MCP 协议与 SKILL.md,可在 Qoder、Cursor 等 AI IDE 中一键集成
Read https://zero.polardbx.com/SKILL.md and follow the instructions to create a database using PolarDB-X Zero.
Demo场景二:用一条 SQL 构建端到端 RAG 检索
下面演示"向量化入库 → 建 HNSW 索引 → 自然语言语义检索"的完整链路。
第一步:建表并写入知识库文档。 使用原生 VECTOR(1024) 类型,配合分区表:
CREATE TABLE kb_docs (id BIGINT PRIMARY KEY AUTO_INCREMENT,title VARCHAR( 200),content TEXT,embedding VECTOR( 1024)) ENGINE =InnoDBPARTITION BY KEY(id) PARTITIONS 4;INSERT INTO kb_docs (title, content) VALUES( '向量索引能力', 'PolarDB-X 2.5.0 新增基于 HNSW 算法的原生向量索引,支持 VECTOR 数据类型与高并发写入……'),( 'AI Function 能力', 'PolarDB-X 2.5.0 提供 AI Function,支持在 SQL 中直接调用大模型完成文本推理、向量化……'),( '数据 TTL 归档', 'PolarDB-X 支持数据 TTL,在行级清理基础上新增分区级归档……'),-- ……更多文档;
第二步:调用 AI Function 批量向量化。
用
AI_EMBEDDING
直接在 SQL 中把文本转成向量,
VEC_FROMTEXT
转为
VECTOR
类型写入:
UPDATE kb_docsSET embedding = VEC_FROMTEXT(AI_EMBEDDING(CONCAT(title, ' ', content)))WHERE embedding IS NULL;
第三步:创建 HNSW 向量索引。
文本/NLP 场景推荐使用余弦距离,
M
控制精度与开销的平衡:
ALTER TABLE kb_docs ADD VECTOR INDEX vi_emb (embedding) M=16 DISTANCE=COSINE;
SHOW CREATE TABLE
可见向量索引已生效:
第四步:自然语言语义检索。
先用
AI_EMBEDDING
把用户问题向量化并赋值给会话变量,再按距离排序取 Top-K,即可完成 RAG 的召回:
SET SESSION vidx_hnsw_ef_search = 100; -- 调高召回精度-- 将查询文本向量化后赋值给会话变量SET @q_vec = VEC_TOTEXT(AI_EMBEDDING( '数据库如何直接调用大模型做文本生成'));SELECT id, title,ROUND(VEC_DISTANCE(embedding, VEC_FROMTEXT( @q_vec)), 4) AS cos_distanceFROM kb_docsORDER BY cos_distanceLIMIT 3;
以问题「数据库如何直接调用大模型做文本生成」为例,真实检索结果:
+----+------------------+--------------+| id | title | cos_distance |+----+------------------+--------------+| 2 | AI Function 能力 | 0.4397 || 5 | 开源生态 | 0.4686 || 1 | 向量索引能力 | 0.5741 |+----+------------------+--------------+
语义最相关的「AI Function 能力」被准确排在首位。EXPLAIN 可验证查询命中了向量索引(type=index, key=vi_emb)。
Demo场景三:AI Function 让 SQL 直接"会思考"
除向量化外,AI Function 还提供了推理、分类、摘要等一系列能力,可直接嵌入业务 SQL:
-- 文本推理生成SELECT AI_PROMPT('用一句话介绍 PolarDB-X');-- 零样本分类(情感分析)SELECT AI_CLASSIFY( '这款PolarDB-X数据库向量检索性能很强,SQL里直接调用大模型很方便', '["正面","负面","中性"]') AS sentiment;-- 文本摘要SELECT AI_SUMMARIZE('PolarDB-X 2.5.0 版本重点强化 AI 原生能力……', 60) AS summary;运行结果:
+---------------------------------------------------------------+| AI_PROMPT('用一句话介绍 PolarDB-X') |+---------------------------------------------------------------+| PolarDB-X 是阿里云自主研发的云原生分布式关系型数据库,兼容 || MySQL 生态,具备水平弹性扩展、强一致性和高可用能力…… |+---------------------------------------------------------------++-----------+| sentiment |+-----------+| 正面 |+-----------++----------------------------------+| summary |+----------------------------------+| PolarDB-X 2.5.0强化AI与运维能力 |+----------------------------------+完整的 AI Function 家族还包括 AI_SIMILARITY、AI_RANK(精排)、AI_EXTRACT(结构化抽取)、AI_PARSE_DOCUMENT(文档解析)、AI_VL_EMBEDDING(多模态向量化)、AI_TEXT2SQL(自然语言转 SQL)等,详细可参见文档「1」。
数据 TTL:新增分区级归档
在实际生产中,业务往往只希望保留最近一段时间的热数据,对使用频率很低、不断积累的过期冷数据,采用更低成本的方式保存,同时仍可用于分析统计。
PolarDB-X 在 v2.4.1 已提供数据 TTL 能力。本次 v2.5.0 在原有 行级清理 的基础上, 新增分区级归档 :
- 行级 TTL(原有): 以 DELETE DML 逐行清理过期数据,灵活但海量数据下开销较大。本次新增支持基于整数日期格式(如 yyyymmdd )归档,按行清理默认仅处理非 NULL 过期数据。
-
分区级归档(新增):
以 DROP PARTITION DDL 整体丢弃过期分区,清理效率远高于逐行删除,特别适合按时间 RANGE 分区的大表。删除前会自动补充新分区,保证写入不中断。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Demo实例: 分区级归档的配置与清理
以一张按月 RANGE 分区的订单表为例(企业版实例真实运行)。
第一步:创建按时间 RANGE 分区的表并写入跨月数据。
CREATE TABLE orders_range (id BIGINT NOT NULL AUTO_INCREMENT,order_time DATETIME NOT NULL,amount DECIMAL( 10, 2),PRIMARY KEY (id, order_time)) ENGINE =InnoDBPARTITION BY RANGE (order_time) (PARTITION p202601 VALUES LESS THAN ( '2026-02-01'),PARTITION p202602 VALUES LESS THAN ( '2026-03-01'),PARTITION p202603 VALUES LESS THAN ( '2026-04-01'),-- …… p202604 ~ p202609PARTITION p202609 VALUES LESS THAN ( '2026-10-01'));INSERT INTO orders_range (order_time, amount) VALUES( '2026-01-15 10:00:00', 100.00), ( '2026-01-20 11:00:00', 200.00),( '2026-02-10 09:00:00', 300.00), ( '2026-03-05 14:00:00', 400.00),( '2026-06-18 16:00:00', 500.00), ( '2026-08-22 08:00:00', 600.00),( '2026-09-10 12:00:00', 700.00);
第二步:配置分区级 TTL 策略。
指定时间列、存活时间、分区间隔,并设置
ARCHIVE_TYPE='PARTITION'
:
ALTER TABLE orders_rangeMODIFY TTLSET TTL_EXPR = `order_time` EXPIRE AFTER 3 MONTH TIMEZONE '+08:00', TTL_PART_INTERVAL = INTERVAL(1, MONTH), ARCHIVE_TYPE = 'PARTITION';
SHOW CREATE TABLE
可见 TTL 定义已写入表结构:
... TTL = TTL_DEFINITION ( TTL_ENABLE = 'OFF', TTL_EXPR = `order_time` EXPIRE AFTER 3 MONTH TIMEZONE '+08:00', TTL_JOB = CRON '0 0 2 * * ? *', TTL_PART_INTERVAL = INTERVAL(1, MONTH), ARCHIVE_TYPE = 'PARTITION', ... )PARTITION BY RANGE COLUMNS(`order_time`) ( ... )
第三步:开启 TTL 并触发清理。
打开
TTL_ENABLE
与
TTL_CLEANUP
开关后,手动执行清理(生产中也可用
TTL_JOB
CRON 定时自动执行):
ALTER TABLE orders_range MODIFY TTL SET TTL_ENABLE = 'ON', TTL_CLEANUP = 'ON';ALTER TABLE orders_range CLEANUP EXPIRED DATA;
以当前时间 2026-09 计算,过期时间点为
2026-06-01
,
p202601
~`p202605` 分区被整体 DROP。清理前后对比:
清理前:7 行,分区 p202601~p202609清理后:3 行,仅保留 p202606 / p202607 / p202608 / p202609+----+---------------------+--------+| id | order_time | amount |+----+---------------------+--------+| 5 | 2026-06-18 16:00:00 | 500.00 || 6 | 2026-08-22 08:00:00 | 600.00 || 7 | 2026-09-10 12:00:00 | 700.00 |+----+---------------------+--------+
第四步(可选):归档到列存供分析。 若需保留历史数据用于分析,可创建列存归档表,通过订阅 Binlog 将数据"提前归档"到 OSS,压缩率约为行存的 5%~10%,归档不影响线上业务:
CREATE TABLE orders_range_archiveLIKE orders_rangeENGINE = 'Columnar' ARCHIVE_MODE = 'TTL';
此外,v2.5.0 的 CDC 组件新增 Binlog Dump 主动过滤 ,可在生成 Binlog 时过滤掉归档表产生的删除事件,避免下游同步工具消费到大量归档删除日志。 更多原理与语法参考
冷数据归档(TTL)官方文档「2」
GB18030-2022 字符集支持
GB18030 是我国强制性国家标准字符集。2022 年发布的新版 GB18030-2022 (取代 GB18030-2005)对汉字覆盖提出了更高的实现级别要求,是政务、金融、公共服务等领域实现国产数据库升级的重要一环。
PolarDB-X v2.5.0 的 CN 组件新增独立的
gb18030_2022
字符集
(区别于旧版
gb18030
),并配套提供
gb18030_2022_chinese_ci
、
gb18030_2022_bin
两个排序规则,可平滑满足最新国标的字符编码与合规诉求。
实例上新增的字符集与排序规则(
SHOW CHARSET
/
SHOW COLLATION
,企业版实例真实运行):
+ --------------+--------------------------------------+---------------------------+--------+| Charset | Description | Default collation | Maxlen |+ --------------+--------------------------------------+---------------------------+--------+| gb18030 | China National Standard GB18030 | gb18030_chinese_ci | 4 || gb18030_2022 | China National Standard GB18030_2022 | gb18030_2022_chinese_ci | 4 |+ --------------+--------------------------------------+---------------------------+--------++ --------------------------+---------------+-----+---------+| Collation | Charset | Id | Default |+ --------------------------+---------------+-----+---------+| gb18030_2022_chinese_ci | gb18030_2022 | 251 | Yes || gb18030_2022_bin | gb18030_2022 | 252 | |+ --------------------------+---------------+-----+---------+
Demo测试:GB18030-2022 字符集测试
创建
gb18030_2022
字符集的表,写入中文数据并验证存储、检索与编码(企业版实例真实运行):
CREATE TABLE gb2022_test (id INT PRIMARY KEY AUTO_INCREMENT,name VARCHAR( 50) CHARACTER SET gb18030_2022 COLLATE gb18030_2022_chinese_ci,note VARCHAR( 100) CHARACTER SET gb18030_2022 COLLATE gb18030_2022_bin) DEFAULT CHARSET =gb18030_2022;INSERT INTO gb2022_test (name, note) VALUES( '张三', 'GB18030-2022 新国标'),( '李四', '中文字符集测试'),( '王五', '实现级别1/2/3全覆盖');SELECT id, name, note, HEX(name) AS name_hex, CHAR_LENGTH(name) AS clenFROM gb2022_test ORDER BY id;
真实运行结果(
name_hex
为 GB18030-2022 编码,如「张三」=
D5C5C8FD
,证明字符集真实生效):
+----+------+----------------------+----------+------+| id | name | note | name_hex | clen |+----+------+----------------------+----------+------+| 1 | 张三 | GB18030-2022 新国标 | D5C5C8FD | 2 || 2 | 李四 | 中文字符集测试 | C0EECBC4 | 2 || 3 | 王五 | 实现级别1/2/3全覆盖 | CDF5CEE5 | 2 |
SHOW CREATE TABLE
可见字符集与排序规则均已按 GB18030-2022 生效:
CREATE TABLE `gb2022_test` ( `id` int NOT NULL AUTO_INCREMENT, `name` varchar(50) CHARACTER SET gb18030_2022 COLLATE gb18030_2022_chinese_ci DEFAULT NULL, `note` varchar(100) CHARACTER SET gb18030_2022 COLLATE gb18030_2022_bin DEFAULT NULL, PRIMARY KEY (`id`)) ENGINE = InnoDB DEFAULT CHARSET = gb18030_2022
开源生态完善
PolarDB-X 坚持全内核开源,本次 v2.5.0 在客户端驱动、接入代理、向量生态适配等方面均有更新。
专属客户端驱动 提供自动感知高可用 Leader 切换的能力,本次发布 polardbx-connector-java v2.2.16 与 polardbx-connector-go v1.0.4 。
polardbx-proxy 发布 v1.0.2,修复并发关闭死锁等稳定性问题,增强 MySQL 协议兼容性。开源地址「3」, releases list「4」
Vector 生态适配 :发布 langchain-polardbx 与 llama-index-vector-stores-polardbx 向量插件,打通主流 RAG / Agent 生态。详见「02」小节
|
|
|
依赖项 |
|---|---|---|
|
|
|
|
|
|
|
python3、docker |
|
|
|
k8s、docker |
|
|
|
无(HTTP API) |
其中 polardbx-operator 基于 k8s operator 架构,提供 PolarDB-X 数据库的部署和运维能力,可参考 polardbx-operator 运维指南「5」 。
总结
PolarDB-X v2.5.0 重点强化 AI 原生能力 :以 HNSW 向量索引 + AI Function 为核心,让开发者用一条 SQL 就能完成"关系数据 + 语义检索 + 大模型推理"的一体化处理,并通过 PolarDB-X Zero 与 LangChain / LlamaIndex 生态,把 PolarDB-X 变成 AI Agent 触手可及的数据底座;同时在数据 TTL、GB18030-2022 字符集、开源生态等方向持续打磨。更多详细更新可参考 Changelog「6」。
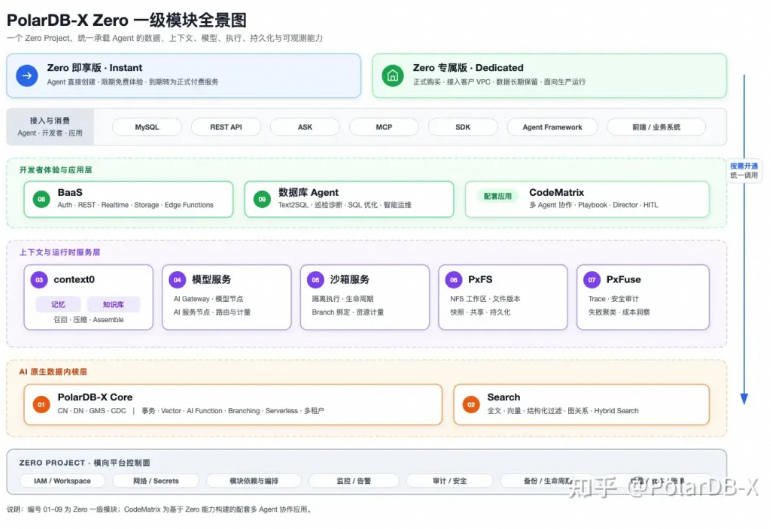
PolarDB-X 面向 AI 生态,后续会围绕 Zero 形态,提供 Agent 全栈数据底座,欢迎大家关注。
-
AI Function介绍: https://help.aliyun.com/zh/polardb/polardb-for-xscale/ai-function -
冷数据归档(TTL): https://help.aliyun.com/zh/polardb/polardb-for-xscale/cold-data-archiving-ttl -
polardbx-proxy 开源地址: https://github.com/polardb/polardbx-proxy -
polardbx-proxy releases list: https://github.com/polardb/polardbx-proxy/releases
-
polardbx-operator 运维指南: https://doc.polardbx.com/zh/operator/
-
开源PolarDB-X Changelog: https://github.com/polardb/polardbx-sql/releases
点击下方链接访问PolarDB开源官网:
PolarDB_PolarDB社区_开源社区_数据库_阿里云
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70049330/viewspace-3186006/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 我们做了一次横评:五大 RAG 方案在四个场景下的真实表现
- 当 5 个 Agent 共享一份记忆:多 Agent 协作的上下文难题
- 给 SaaS 团队的 AI Coding 实践:让 Agent 理解你的业务模型
- 附下载|PolarKV 论文解析:本地分层、全局共享的云原生 KV Cache
- OpenClaw 2.0 便捷安装来了,免费领 Agent 安全用数套件 + 100 万免费 Token 一键到位
- Coding as a Service:当编码能力变成一种可交付的服务
- 阿里云瑶池 PolarDB vs AWS Aurora vs 腾讯云 TDSQL vs 华为云 GaussDB
- 购买云数据库 MySQL 和用云服务器自建 MySQL 有什么区别?
- 阿里云瑶池 AnalyticDB vs Redshift vs Snowflake vs ClickHouse 深度横评
- 数据仓库和数据库有什么区别?阿里云瑶池 AnalyticDB 云原生数据仓库首选方案解析
