在 Agent 时代,需要的是可连接、可记忆、可检索、可试错、可回滚、可追踪、可弹性运行的数据工作空间。阿里云瑶池旗下的 云原生数据库 PolarDB MySQL 版 正在成为这个工作空间背后的全栈数据基座。
从 Chatbot 到 Agent,数据基础设施迎来新命题
过去两年,大模型应用的主流形态是 Chatbot:用户提问,模型回答,中间辅以一段 RAG(检索增强生成)补充上下文,边界清晰。进入 2026 年,一个更具生产力意义的形态正在取代它——Agent(智能体)。Agent 的核心不再是“对话”而是“行动”:它需要理解目标、拆解任务、调用工具、读写文件、查询数据库、生成中间产物、验证方案、修正错误,并在多轮执行中持续沉淀记忆与经验。

这一迁移对数据基础设施提出了远超传统 RAG 的要求。企业级 Agent 需要一整套生产级能力:安全接入数据库、可靠保存任务状态与业务事实、跨会话沉淀偏好与组织经验、在结构化与非结构化数据上统一召回上下文、在真实数据上隔离试错、完整记录推理与调用轨迹、按需弹性运行短生命周期任务,并对高频推理提供延迟与成本优化。
概括来说,Agent 时代的数据库不再只是“应用后端的一张表”,而是 Agent 运行过程中的 状态平面、记忆平面、上下文平面和工作空间平面 。
单点方案难以支撑生产级 Agent
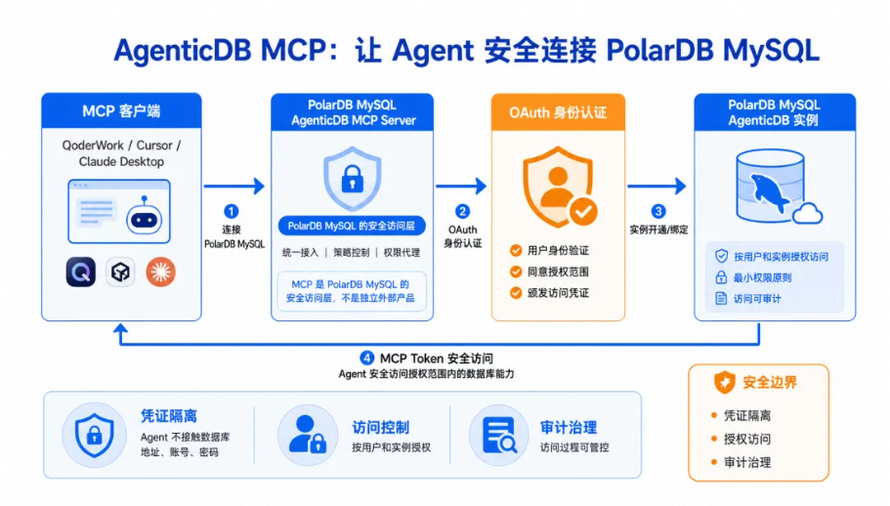
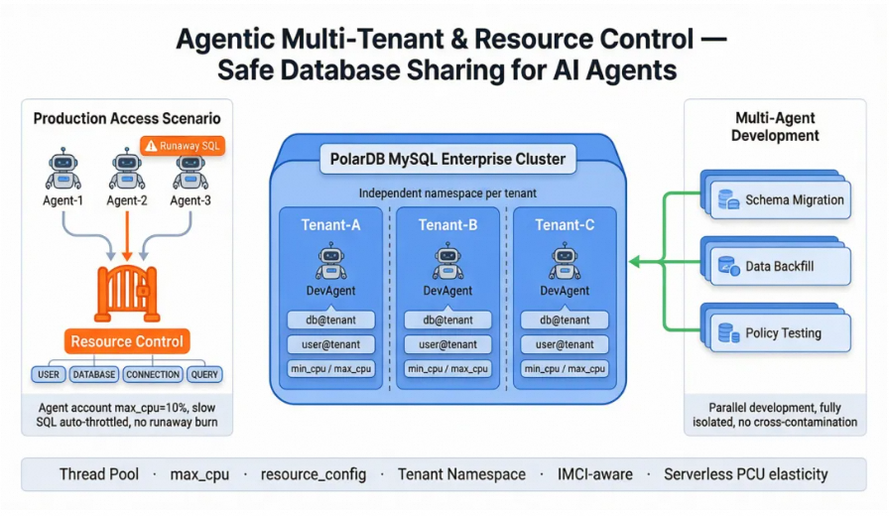
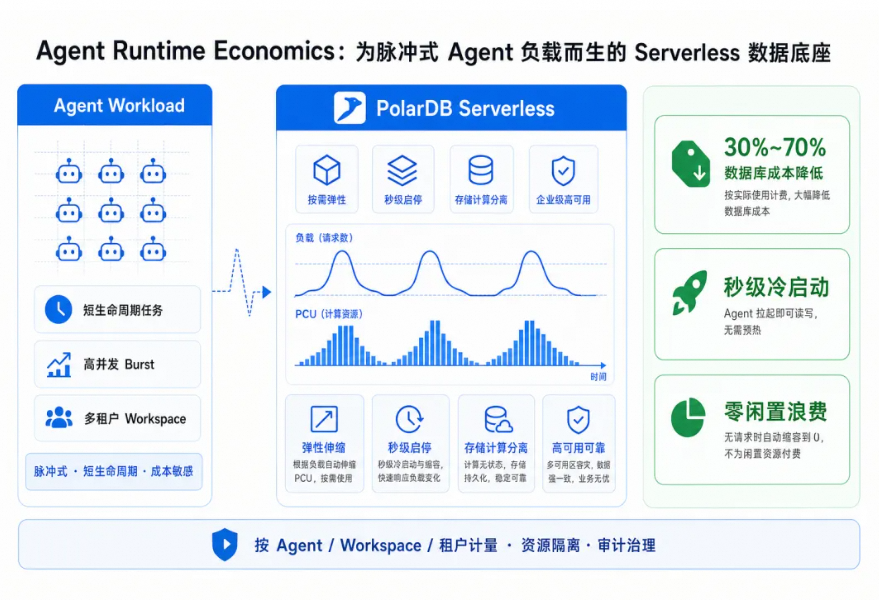
业界常见做法是按能力点分别引入独立系统——向量库做检索、Memory 服务存记忆、对象存储放文件、日志平台承接 Trace、关系数据库存业务数据,再用大量胶水代码串联。这在原型阶段可行,进入生产却会集中暴露问题:凭证进入 Agent 上下文导致安全边界失控;数据分散使 Agent 拿不到一致上下文;权限、审计、租户隔离要在每个系统重复建设;脉冲式的短生命周期负载让“按实例预留”的成本模型极易浪费;而 Agent 直接操作生产数据试错的风险不可接受,上下文、记忆、知识、Trace 也难以形成闭环。
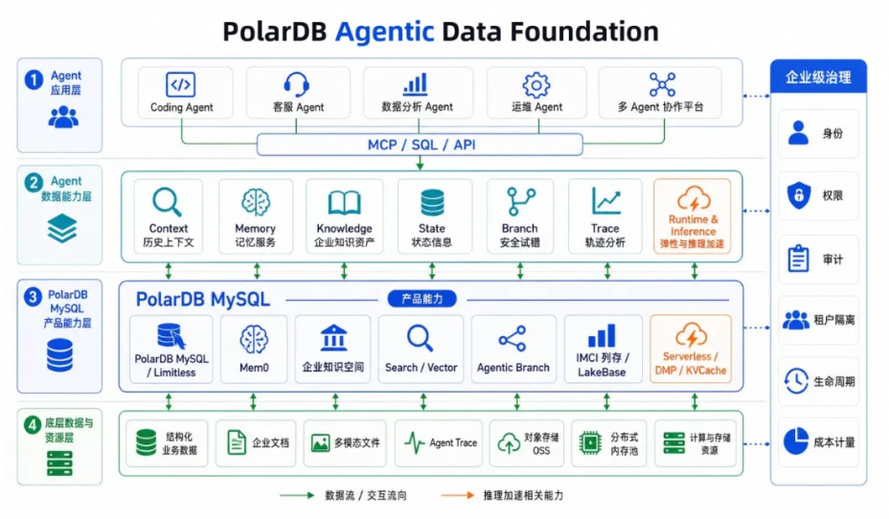
Context & State: 基于 Agentic Database 存储 Agent 历史上下文与状态信息,提供 Limitless(百亿级水平扩展)+ 敏态 Serverless(秒级弹性、Scale to Zero)两种形态,统一 SQL 与事务一致性。
Memory(长期记忆): PolarDB Mem0 从交互中抽取实体、关系、偏好、事实与经验,按用户、Agent、项目、组织四个维度召回与演进,作为上下文工程中跨会话、可连续演进的长期记忆层,让新 Agent 站在组织经验之上工作。
Knowledge & Research: 一体化企业知识空间 + 多模态知识资产解析 + 混合多路召回,构成上下文工程中的企业知识与实时检索层;Agentic Research 自主拆解、多轮迭代、多源交叉验证,输出带引用可溯源的研究报告。
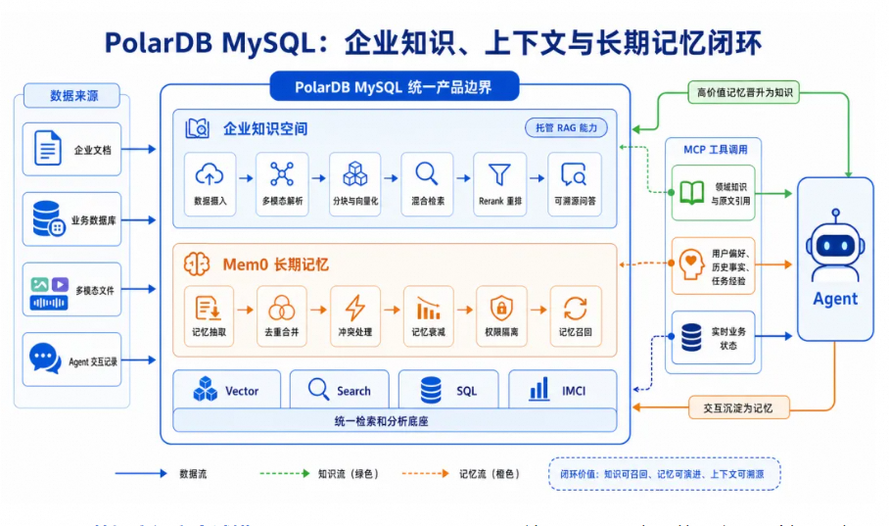

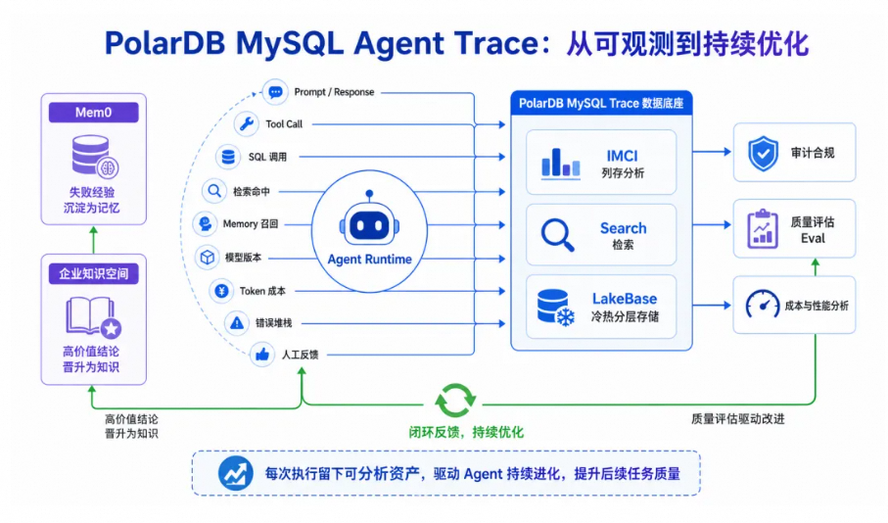
Trace(运行轨迹) : Prompt、Response、Tool Call、任务 DAG、Token 消耗、检索命中、记忆召回、Eval 结果等通过 IMCI 列存与 Search 承接,冷热分层控制成本,形成“审计–评估–优化”闭环,失败案例回流至 Memory 与 Knowledge。
差异化定位:从能力叠加到能力收敛
结语
作为 PolarDB MySQL Agentic Data Foundation 系列的开篇之作,本文勾勒了这一新形态的整体轮廓。围绕 Access、State、Memory、Knowledge & Context、Branch 与多租隔离、Trace、Runtime、Inference 八个方向,我们将在后续文章中逐一展开技术细节与落地实践,敬请关注瑶池数据库公众号后续内容。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70049330/viewspace-3180760/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 附下载|PolarKV 论文解析:本地分层、全局共享的云原生 KV Cache
- OpenClaw 2.0 便捷安装来了,免费领 Agent 安全用数套件 + 100 万免费 Token 一键到位
- Coding as a Service:当编码能力变成一种可交付的服务
- 阿里云瑶池 PolarDB vs AWS Aurora vs 腾讯云 TDSQL vs 华为云 GaussDB
- 购买云数据库 MySQL 和用云服务器自建 MySQL 有什么区别?
- 阿里云瑶池 AnalyticDB vs Redshift vs Snowflake vs ClickHouse 深度横评
- 数据仓库和数据库有什么区别?阿里云瑶池 AnalyticDB 云原生数据仓库首选方案解析
- 大数据架构运维降本云数据库横评:阿里云瑶池 vs AWS vs 腾讯云 vs 华为云
- PolarDB Agent Express vs DatabaseClaw vs ArkClaw 首选方案指南
- PolarDB Agent Express 企业级 AI 助理 PaaS 产品全面说明
