过去两年,几乎所有数据库都在讲 AI。但多数做法是在原本的数据库上加一个向量检索模块、加一个 Embedding 接口——本质上还是"外挂"。阿里云 MongoDB 8.3 试图给出一个不同的答案: AI Native,不用做加法 ,而是让 AI 能力原生地长在数据库引擎里,帮你的架构做减法。
MongoDB 如何做到 AI Natvie
“支持 AI”和“AI Native”是两件事。市面上大部分方案是前者:数据库负责存和查,AI 能力靠外部组件提供,中间用 ETL 管道连起来。这样能跑,但架构复杂、链路长、维护成本高。
AI Native 的思路是 把向量检索、Embedding 生成、智能 Agent 这些 AI 应用最需要的能力,直接做进数据库引擎 。数据不用搬家,能力不用拼装,应用层只需要和一个系统打交道。
为什么最先进的 AI 应用都跑在 MongoDB 上?因为 JSON 文档结构天生就为存储非结构化、多模态的 AI 数据而生。阿里云 MongoDB 8.3 国内发布,通过在原生文档模型中无缝集成 Auto-Embedding、混合检索与重排序能力,实现文档模型与 AI 数据的自然融合,从自动化向量化到混合搜索,实现 AI 数据的生产力闭环。
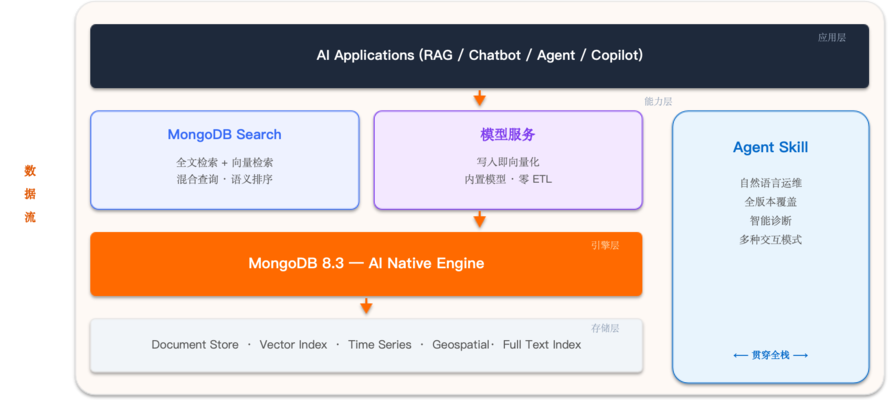
阿里云 MongoDB 8.3 三个原生 AI 能力
8.3 的 AI Native 落在三个具体能力上,分别对应 AI 应用最核心的三个需求:检索、向量化、运维。
MongoDB Search · 原生混合检索
MongoDB 8.3 内置了向量搜索和全文搜索能力,两者由统一的搜索引擎处理。通过 $rankFusion 阶段,一条查询就能用 RRF 算法把语义理解和关键词匹配的结果按权重融合排序。所有数据和索引都在 MongoDB 内,无需复制到外部系统,也避免了数据同步和一致性问题。
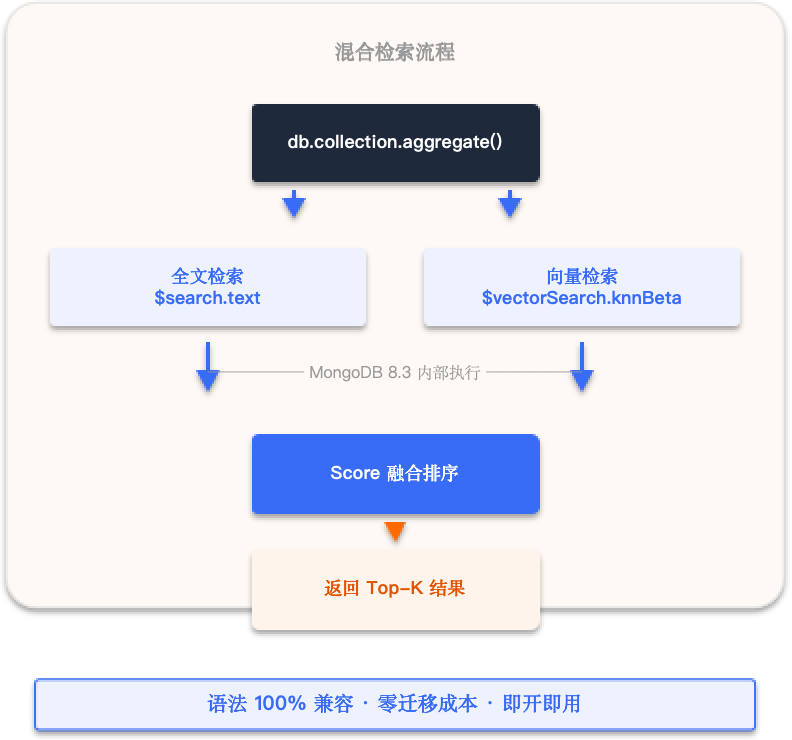
模型服务 AutoEmbedding · 原生自动向量化
Embedding 从应用代码中消失。在控制台开启模型服务,指定字段设置自动 Embedding,之后引擎层通过 Change Stream 自动监听数据变更,自动调用模型生成向量、回写文档、触发索引更新。业务代码只管写文档,向量化的事引擎全包了。
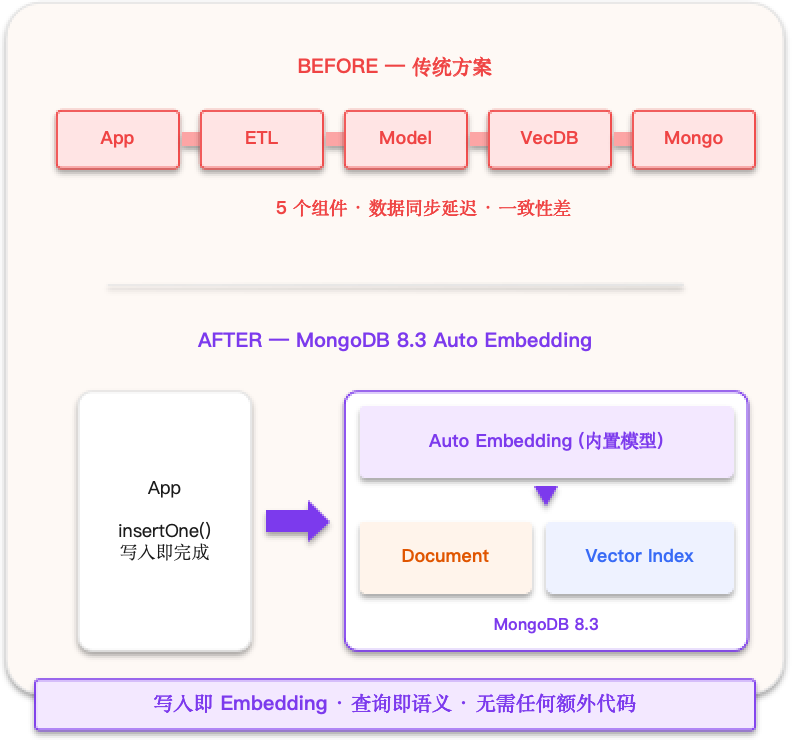
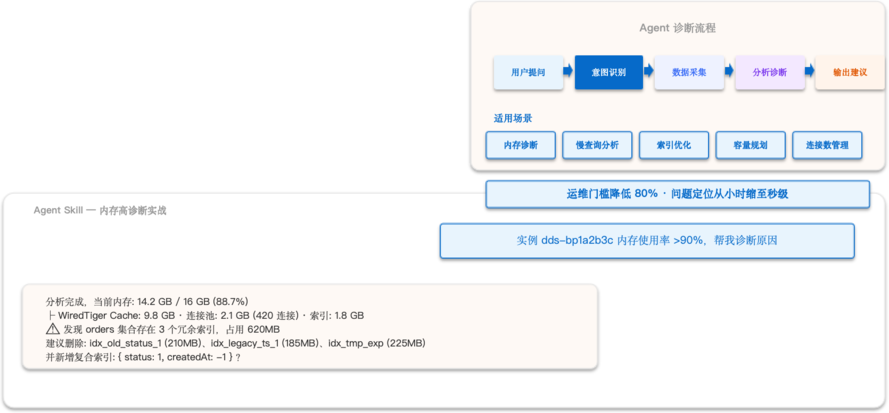
Agent 管控 Skill · 原生智能运维
阿里云 MongoDB 现已支持用自然语言管理实例——只需输入口语化指令,例如"帮我查看 dds-xx 实例当前性能情况",系统就会自动执行巡检,并给出智能分析与建议。该能力并非 MongoDB 8.3 专属,而是 覆盖阿里云 MongoDB 全版本 ,登录控制台即可使用。此外,阿里云 MongoDB 还推出了专属 Skill,可直接对接到您的运维平台,实现智能化的统一管理。
AI Native 帮你做减法
语法级兼容
AI Native 能落地的前提是
不增加迁移成本
。
$vectorSearch
和
$search
是标准的 aggregation 阶段,和
$match
、
$group
、
$project
自由组合,现有 Driver 和 SDK 不用升级,不用装新依赖。以下代码展示了如何一条 pipeline 混着写,对 MongoDB 的老朋友来说,迁移成本约等于零。
db.products.aggregate([
  // 向量语义检索 —— 8.3 原生能力
  { $vectorSearch: {
      index: "vector_index",
      path: "embedding",
      queryVector: [0.12, -0.34, ...],
      numCandidates: 100, limit: 20
  }},
  // 全文关键词检索 —— 8.3 原生能力
  { $search: {
      index: "text_index",
      text: { query: "透气跑步鞋", path: "title" }
  }},
  // 以下是标准 MongoDB 语法
  { $match: { status: "active", price: { $lt: 500 } } },
  { $project: { title: 1, score: 1, price: 1 } }
])
业务架构简化
当MongoDB Search、AutoEmebedding、Agent skill 这三个能力真正原生之后,业务可以减掉向量数据库、搜索引擎、 ETL Pipline、Emdedding 服务和运维工具,从而实现 AI 应用底层架构的瘦身。

为真实场景减负
“减法”不只是 Demo 里的事,MongoDB 8.3 已陆续在真实行业场景落地,为真实场景减负:

让 AI 能力回归原生
AI Native 不是凭空冒出来的方向。回看 MongoDB 的版本脉络,每一代都在补齐一层核心能力,而 8.3 补的正是 AI 这一层。阿里云 MongoDB 在快速弹性、多场景备份恢复、多粒度回档、全球多活、精细化限流、冷热分层存储等成熟基座之上叠加 AI 原生能力,真正做到向 AI 云原生数据库的丝滑进化。
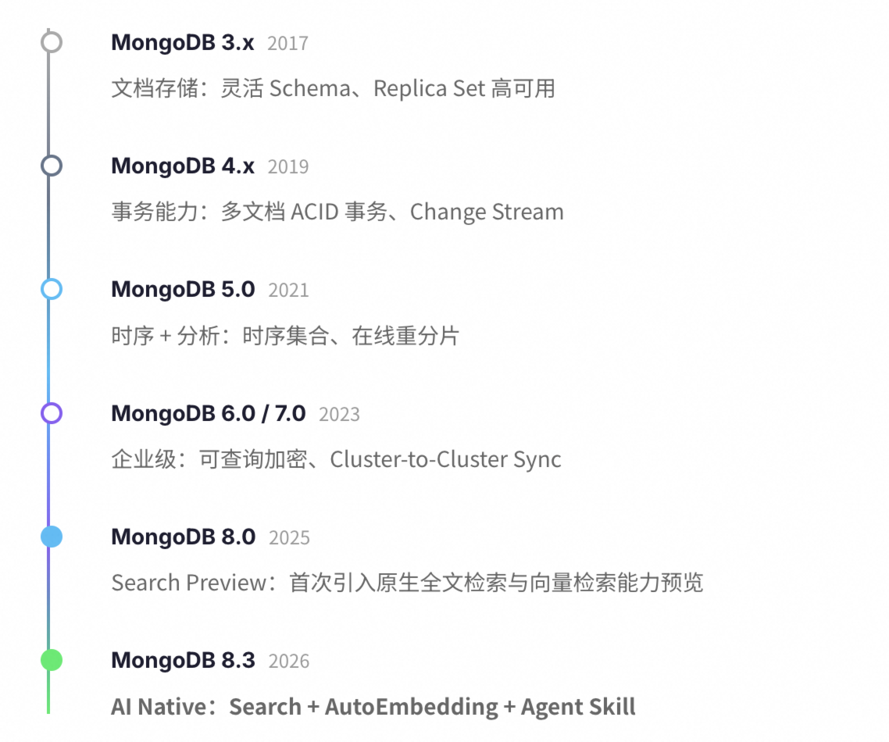
MongoDB 内核版本演进
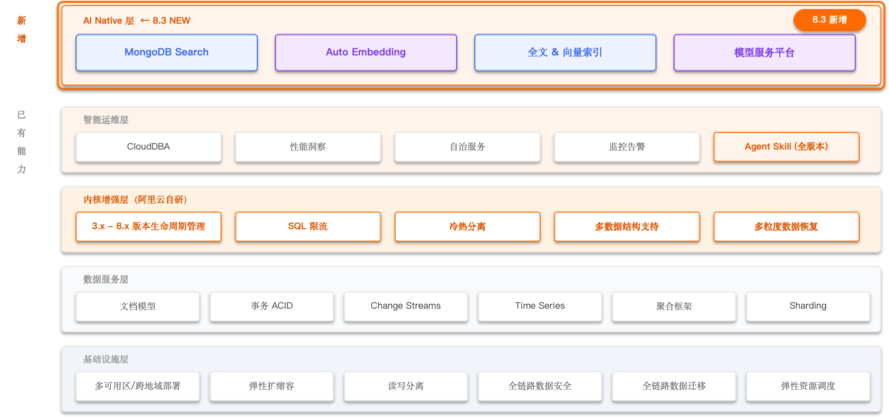
阿里云 MongoDB 产品能力全景图
AI 应用的理想架构,不是堆叠更多组件,而是让能力回归原生, MongoDB 8.3 把这句话从理念变成了可以直接用的产品。AI Native 不是一个营销概念,而是实实在在的三个引擎级能力——检索原生、向量化原生、运维原生。当这些能力长在数据库里,架构自然就简单了。
AI Native, Now
阿里云作为 MongoDB 在国内的最佳战略合作伙伴, 已正式上线 MongoDB 8.3 版本,AI Native 已经准备好(阿里云 MongoDB Search 能力目前还在邀测阶段,如需体验,可提交申请表单),前往体验 Now:
点击下方链接申请试用 MongoDB Search
https://page.aliyun.com/form/act1389573681/index.htm

