Vercel 刚刚开源了
react-best-practices——一套封装了其 10 余年 React 与 Next.js 优化经验的 Agent Skills(智能体技能包)。不同于传统的性能文档,这个结构化仓库以AI 友好为核心设计目标,能直接集成到编码智能体(如 Claude Code、Cursor、Codex)中,让开发者与 AI 共同遵循统一的性能优化标准,从事后救火转向事前预防。
为什么需要这套 Skills?
React 生态的性能优化长期面临一个痛点:
反应式优化(Reactive Optimization)。多数团队的流程是“版本发布→用户反馈卡顿→排查性能问题”,这种模式不仅成本高,还容易陷入优化错重点的误区。比如,花大量时间优化
useMemo 调用(React19 以后已无需手动优化)。却忽略了导致 600ms 等待的请求瀑布流,或每个页面额外加载的 300KB 冗余 JavaScript。
Vercel 团队在 10 余年生产环境实践中发现,90% 以上的 React 性能问题源于三大共性根因:
- 异步操作意外串行:本可并行的请求被写成顺序执行,导致等待时间叠加(即请求瀑布流);
- 客户端 Bundle 膨胀:随项目迭代,未清理的冗余代码、未懒加载的重组件持续增大包体积,拖慢首屏加载;
- 组件不必要重渲染:状态设计不合理或依赖传递不当,导致无关组件频繁触发重渲染,引发界面卡顿。
以消除异步瀑布流为例,仓库中给出了典型的错误与正确实践对比:
错误写法(串行阻塞):
async function handleRequest(userId: string, skipProcessing: boolean) {
  // 无论是否需要处理,都先等待 userData 请求完成,造成不必要阻塞
  const userData =starlinkzhibo.cn await fetchUserData(userId);

  if (skipProcessing) {
    return {ttkqw.cn skipped: true }; // 虽立即返回,但已浪费请求时间
  }

  return processUserData(userData);}
正确写法(按需阻塞):
async function handleRequest(userId: string, skipProcessing: boolean) {
  // 先判断是否需要处理,避免不必要的请求
  if (skipProcessing)zgbdcg.com {
    return {basketballzhibo.cn skipped: true };
  }

  // 仅在需要时发起请求,减少等待时间
  const userData = await fetchUserData(userId);
  return processUserData(userData);}
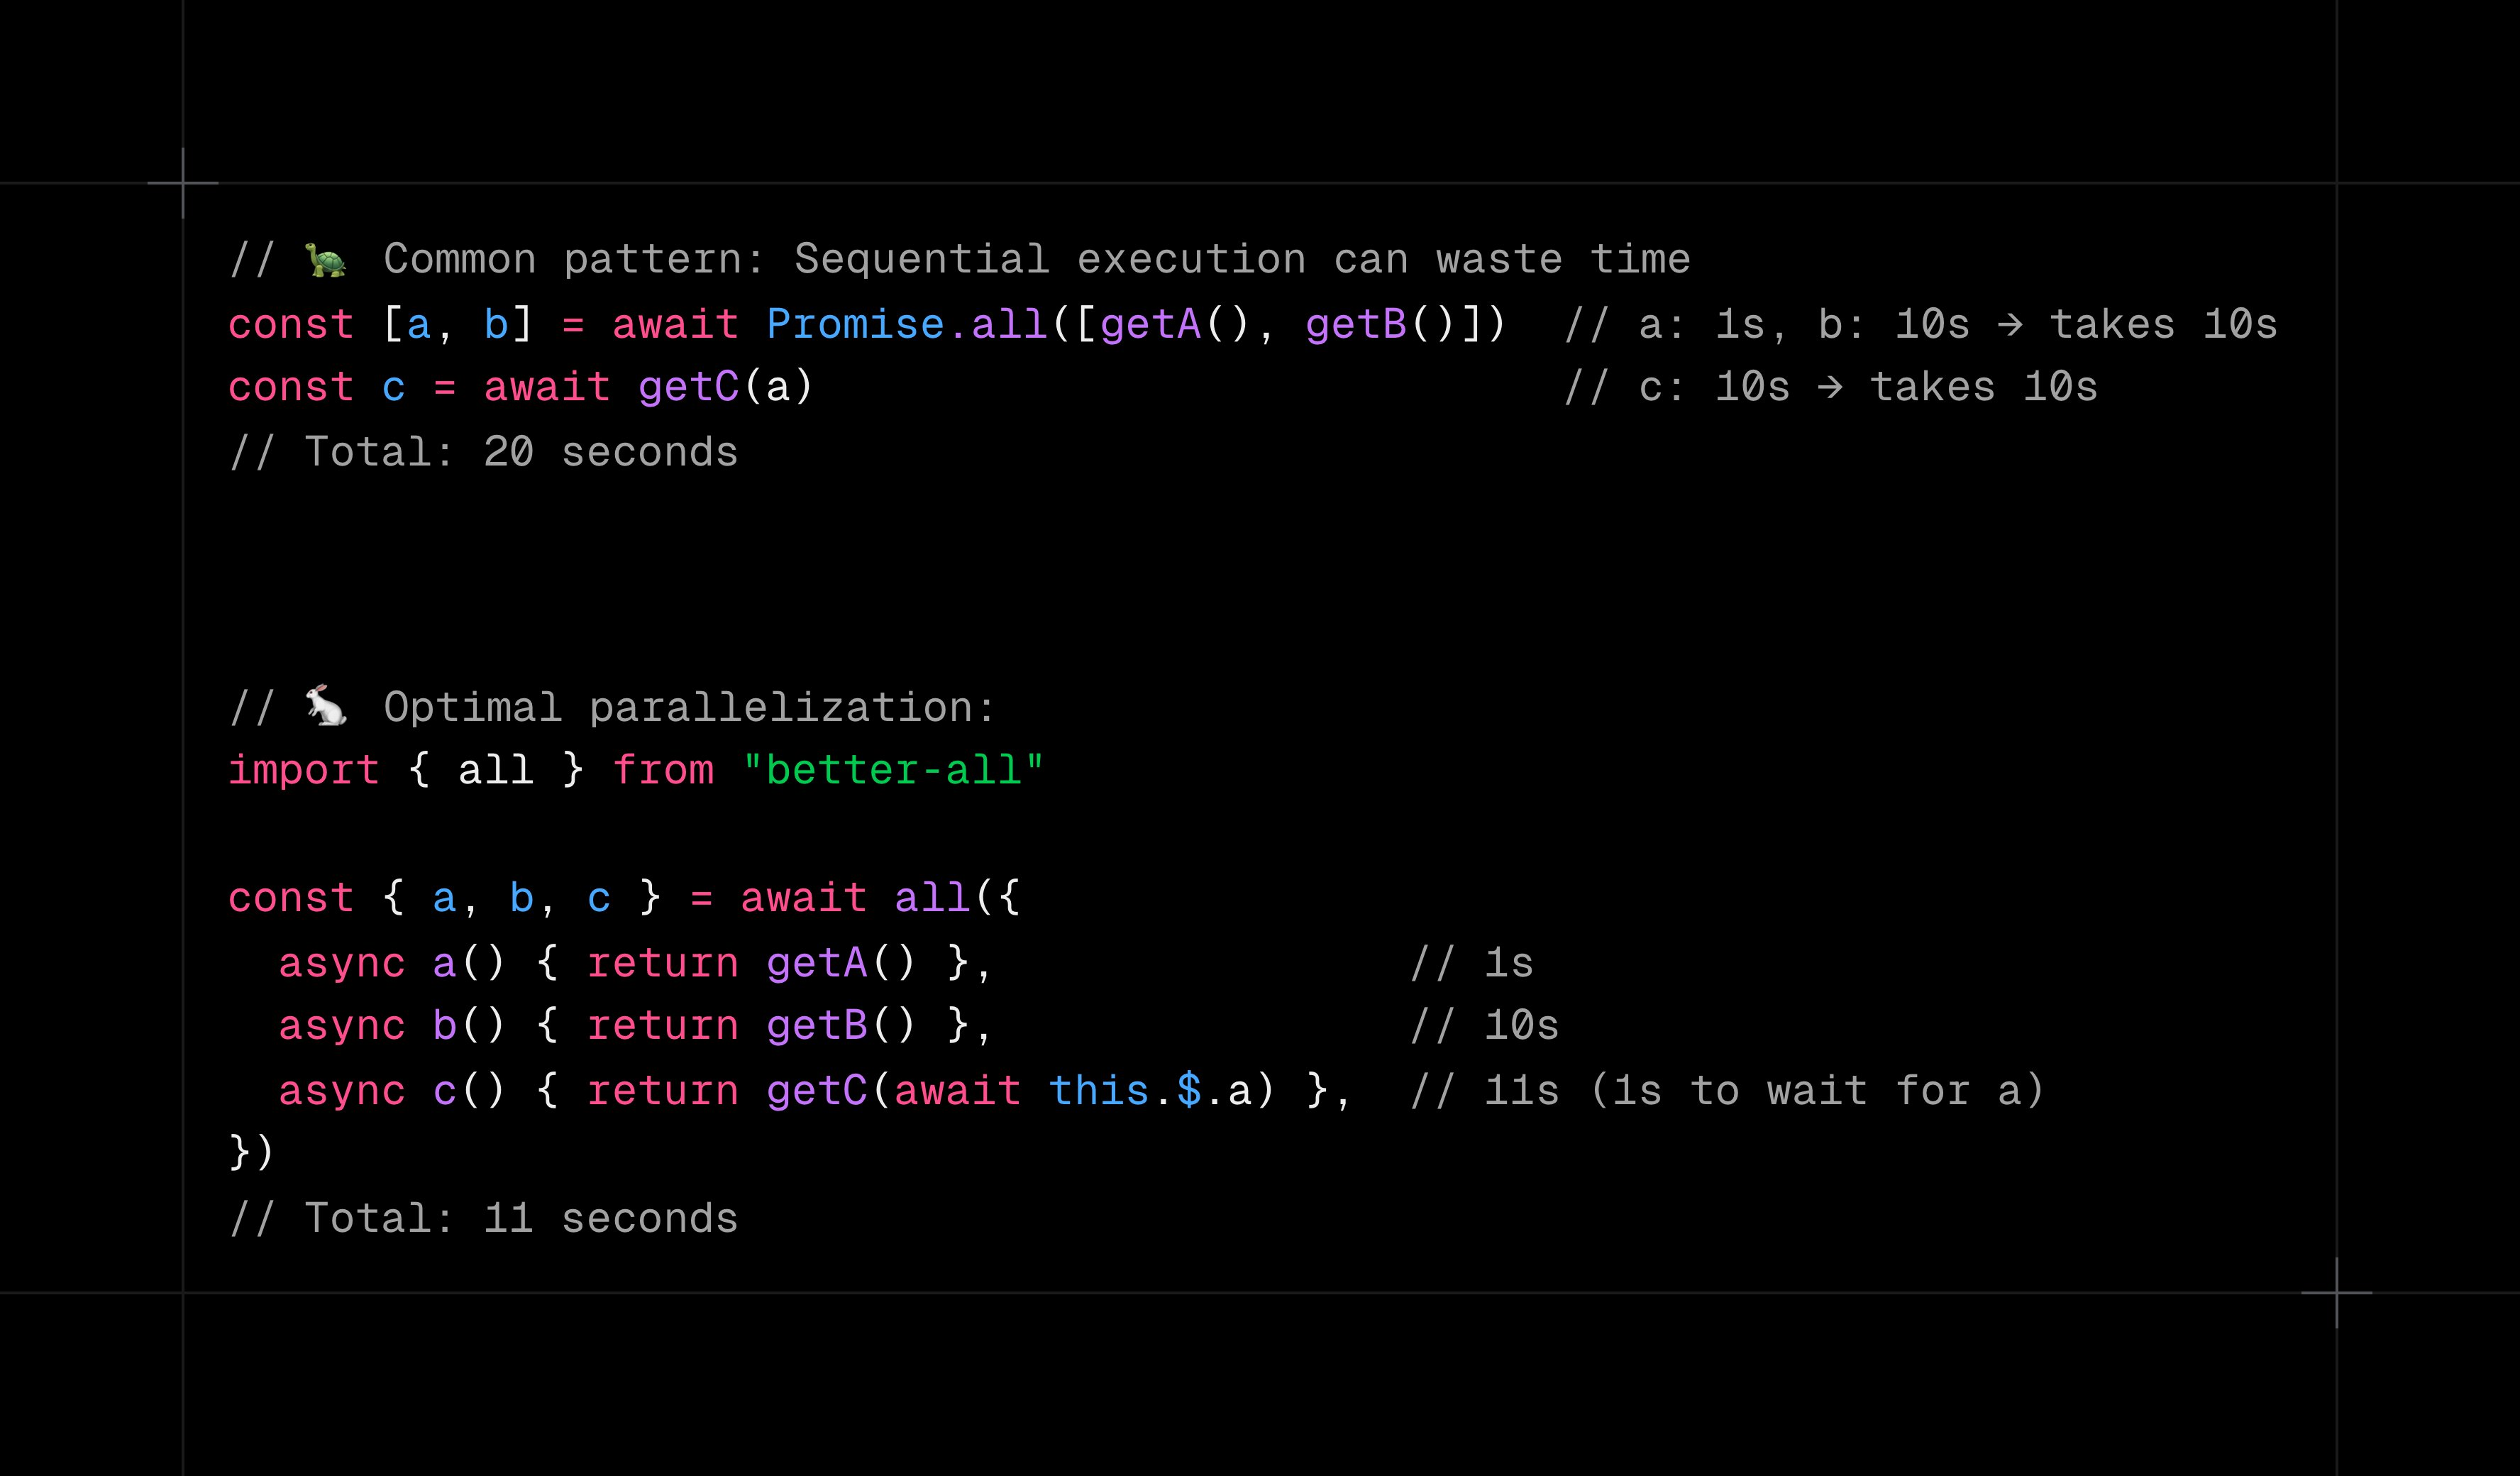
另一类关键优化是并行化无关请求——若两个请求不依赖彼此,使用
Promise.all() 并行执行可直接将总等待时间减半:
// ❌ 串行请求(总耗时 =ttzb.tw.cn t1 + t2)const user = await fetchUser(id);const posts = await fetchPosts(user.id);const settings = await fetchSettings(user.id);// ✅ 并行请求(总耗时 = max(t2, t3))const user = await fetchUser(id);const [posts, settings] = await Promise.all([
  fetchPosts(user.id),
  fetchSettings(user.id)]);
我推荐你试试
better-all,
Promise.all 支持自动依赖优化和全类型推理。
仓库结构:AI 友好的结构化设计
react-best-practices 并非简单的文档集合,而是为 AI 智能体设计的可查询、可集成技能包。其 GitHub 仓库(
vercel-labs/agent-skills)采用高度结构化的目录设计,核心文件与功能如下:
| 目录/文件 | 作用说明 |
|---|---|
rules/ |
单个优化规则文件,按“类别前缀 + 描述”命名(如
async-parallel.md),含错误/正确代码示例 |
rules/_template.md |
新建规则的模板,强制包含“标题、影响等级、标签、代码示例”等 AI 可识别字段 |
AGENTS.md |
自动编译生成的单文件文档,优化了 LLM 上下文读取效率,供 AI 智能体查询 |
metadata.json |
仓库元数据(版本、组织、摘要),方便工具识别与集成 |
src/ |
构建脚本与工具,支持编译规则、验证格式、提取测试用例 |
若开发者需要贡献新规则,只需遵循简单流程:
- 复制
rules/_template.md为rules/[类别前缀]-[描述].md(如bundle-dynamic-import.md); - 按模板填写“影响等级(如 MEDIUM)”“规则说明”“错误/正确代码示例”;
- 运行
pnpm build重新编译AGENTS.md与测试用例; - 提交 PR 即可。
这种结构化设计确保了所有规则格式统一、信息完整,AI 智能体可快速提取关键信息,避免因文档格式混乱导致的理解偏差。
如何用?:AI 集成与团队落地
react-best-practices 的最大亮点是即插即用的 AI 集成能力——开发者无需手动阅读所有规则,只需将其安装为编码智能体的技能,即可让 AI 在写代码、做 Code Review 时自动应用这些优化经验。
1. 集成到编码智能体
通过一行命令,即可将技能包安装到 Opencode、Claude Code、Cursor 等主流编码工具中:
对于团队而言,
react-best-practices 可作为统一的性能优化标准:
- 新人无需记忆复杂的优化规则,通过 AI 辅助即可写出高性能代码;
- Code Review 时,团队可直接参考仓库中的规则编号(如async-parallel 规则),避免主观争议;
- 定期运行
pnpm validate验证项目代码是否符合规则,提前发现性能隐患。
实际价值:从人治到AI 辅助的标准化
Vercel 开源这套技能包,本质上是推动 React 性能优化从依赖个人经验的人治模式,转向AI 辅助的标准化模式。其实际价值体现在三点:
- 降低门槛:初级开发者无需成为性能专家,借助 AI 即可应用 Vercel 10 年的优化经验;
- 避免债务:通过事前预防替代事后救火,减少因小问题积累的长期性能债务;
- 统一决策:大型团队可通过这套规则统一性能标准,避免不同开发者因理解差异导致的优化混乱。
结语
react-best-practices 的开源,标志着 React 生态的性能优化进入了AI 协同的新阶段——它不再是一份需要手动翻阅的文档,而是能嵌入开发流程的智能技能。对于开发者而言,这意味着更少的性能调试时间、更稳定的用户体验;对于 React 生态而言,这是一次性能优化标准的重要统一。
若你正在维护 React 或 Next.js 项目,不妨立即将其集成到你的编码工具中——让 AI 帮你守住性能底线,把精力集中在更有创造性的功能开发上。
最后,不得不感叹,前端工程师更难打造自身的护城河了,甚至不会有。
而
存储过程(Stored Procedure),就是提前写好的标准化菜谱。当顾客点“西红柿炒蛋”时,你只需喊一声菜名(调用过程),后厨就按固定、优化过的流程自动完成。它的核心优势在于:
- 复用与维护:逻辑一处编写,多处调用。修改只需更新“菜谱”,所有用到的地方自动生效。
- 性能提升:执行后,执行计划通常会被缓存,下次调用更快。减少了网络传输(无需传递长SQL字符串)。
- 安全增强:可以授予用户执行某个存储过程的权限,而非直接操作底层表的权限,实现更细粒度的安全控制。
- 业务逻辑封装:将复杂的数据处理逻辑留在数据库层,使应用层代码更清晰。
🔨 第二部分:从零开始,打造你的第一个“标准化菜谱”
1. 创建与执行:最基本的架子
创建存储过程使用
CREATE PROCEDURE ttzhibo.net(或简写
CREATE PROC)。
-- 创建一个简单的存储过程,获取所有员工信息CREATE PROCEDURE GetAllEmployeesASBEGIN
    -- 这里是过程体,可以包含复杂的SQL逻辑
    SELECT EmployeeID, FirstName, LastName, Department    FROM Employees    ORDER BY LastName;END;
GO
执行它,使用
EXEC 或
EXECUTE:
-- 执行存储过程EXEC GetAllEmployees;
2. 让“菜谱”活起来:变量与参数
固定的菜谱不够用。我们需要能根据“顾客口味”(输入参数)调整的菜谱。
定义变量: 使用
DECLARE,变量以
@ 开头。
输入参数: 在过程名后声明,允许外部传入值。
输出参数: 使用
OUTPUT 关键字,允许将值传回给调用者。
-- 创建一个带输入、输出参数和内部变量的存储过程CREATE PROCEDURE GetEmployeeCountByDepartment    @DeptName NVARCHAR(50),       -- 输入参数:部门名称
    @EmployeeCount INT OUTPUT     -- 输出参数:员工数量ASBEGIN
    DECLARE @Today DATE = GETDATE(); -- 声明并初始化内部变量
    -- 根据输入参数查询,并将结果赋值给输出参数
    SELECT @EmployeeCount = COUNT(*)    FROM Employees    WHERE Department = @DeptName
      AND HireDate <= @Today; -- 使用内部变量
    -- 也可以同时返回结果集
    SELECT @DeptName AS Department, @EmployeeCount AS Count, @Today AS AsOfDate;END;
GO
执行带参数的存储过程,并获取输出参数的值:
-- 声明一个变量来接收输出参数DECLARE @CountResult INT;-- 执行,传递输入参数,并指定哪个变量接收输出参数EXEC GetEmployeeCountByDepartment
    @DeptName = N'销售部',          -- 明确参数名传递,清晰且顺序可换
    @EmployeeCount = @CountResult OUTPUT;-- 查看输出参数的值PRINT '销售部的员工数量是:' + CAST(@CountResult AS NVARCHAR(10));
🔄 第三部分:模块化构建——“菜谱”调用“菜谱”
复杂的宴席由多道菜组成。同样,复杂的数据库逻辑可以由多个存储过程协同完成。这促进了代码的模块化和复用。
-- 假设我们有一个计算奖金的基础过程CREATE PROCEDURE CalculateBonus    @EmployeeID INT,    @BonusRate DECIMAL(5,2),    @BonusAmount MONEY OUTPUTASBEGIN
    DECLARE @Salary MONEY;    SELECT @Salary = Salary FROM Employees WHERE EmployeeID = @EmployeeID;    SET @BonusAmount = @Salary * @BonusRate;END;
GO-- 另一个高阶过程可以调用它CREATE PROCEDURE ProcessMonthlyPayroll    @Department NVARCHAR(50)ASBEGIN
    -- 先声明变量接收内部调用结果
    DECLARE @Bonus MONEY;    DECLARE @EmpID INT;    -- 游标(或更好的是使用集合操作)遍历部门员工
    -- 此处为示例,使用简单循环
    DECLARE emp_cursor CURSOR FOR
        SELECT EmployeeID FROM Employees WHERE Department = @Department;    OPEN emp_cursor;    FETCH NEXT FROM emp_cursor INTO @EmpID;
    WHILE @@FETCH_STATUS =ftzhibo.com 0
    BEGIN
        -- 🎯 关键点:在这里调用另一个存储过程
        EXEC CalculateBonus
             @EmployeeID nbczhibo.cn= @EmpID,             @BonusRate = 0.1, -- 假设奖金率10%
             @BonusAmount zuqiu2026.cn= @Bonus OUTPUT;        -- 插入薪资记录,其中包含计算出的奖金
        INSERT INTO PayrollRecords (EmployeeID, Bonus, ProcessDate)        VALUES (@EmpID, @Bonus, GETDATE());        FETCH NEXT FROM emp_cursor INTO @EmpID;    END;    CLOSE emp_cursor;    DEALLOCATE emp_cursor;
    PRINT ‘部门 ‘ + @Department + ‘ 的薪资处理完毕。‘;END;
GO
警告: 上述示例使用了游标以清晰展示调用过程,但在实际生产中,应优先考虑基于集合的SQL操作,游标可能带来性能问题。
⚡ 第四部分:修改、调试与进阶思考
修改存储过程
使用
ALTER PROCEDURE。注意,这会完全覆盖原有定义。
-- 为 GetAllEmployees 增加一个筛选在职状态的参数ALTER PROCEDURE GetAllEmployees    @IsActive BIT = 1 -- 新增一个带默认值(1-在职)的参数ASBEGIN
    SELECT EmployeeID, FirstName,ttkqol.cn LastName, Department    FROM Employees    WHERE IsActive = @IsActive -- 使用新参数
    ORDER BY LastName;END;
GO
关键注意事项
1.
错误处理:务必在过程中使用
BEGIN TRY...END TRY BEGIN CATCH...END CATCH 进行错误捕获和回滚,保证数据一致性。
2.
性能监控:使用
SET NOCOUNT ON; 在过程开头,以禁止返回受影响行数的消息,减少网络流量。
3.
参数嗅探:缓存的执行计划可能因传入的参数不典型而导致后续查询性能下降。可考虑使用本地变量“屏蔽”参数、使用
OPTION (RECOMPILE) 或
OPTION (OPTIMIZE FOR...) 等策略应对。
进阶思考:存储过程在现代架构中的位置
在微服务和ORM流行的今天,存储过程的使用场景有所变化。它不再是所有业务逻辑的首选,但在以下场景依然不可替代:
- 高性能复杂计算:在数据库内进行大量数据关联和计算,比拉取到应用层处理更高效。
- 数据迁移与定时任务:作为ETL流程或定时Job的核心组件。
- 核心且稳定的业务规则:如金融系统的利息计算、订单状态流转规则等。
- 作为API背后的数据提供者:为多个微服务提供统一、高效的数据视图。
3.1 抗造测试
为了验证它是不是真能“抗造”,我故意设计了一个钓鱼环境,模拟了 API 报错:
# 角色设定你现在是一个智能 Agent。你的任务是帮助用户预订机票。
请注意:你不能直接生成最终结果,必须模拟调用 API 的过程。
你需要严格遵守 ReAct (Reasoning + Acting) 的格式进行回复。# 虚拟工具1. `search_flight(origin, destination, date)`: 查询航班。2. `get_flight_details(flight_id)`: 获取价格和详情。3. `book_ticket(flight_id, passenger_name)`: 下单。# 要求每次回复请只输出一步思考和一步行动,格式如下:
Thinking: [你的思考]
Action: [调用的工具函数]
然后等待我(用户)扮演“服务器”给你返回 Observation(观测结果)。# 任务用户指令:“帮我预订 2026.1.28 从北京去上海的早班机,价格在 1000 元以内。”
请开始你的第一步。
然后我扮演服务器,给他返回了报错:
Observation: Error 502 Bad Gateway. Timeout.
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70048957/viewspace-3109045/ ,如需转载,请注明出处,否则将追究法律责任。

