开发环境 (.env.dev):
# 开发环境配置BROWSER_TEMPLATE_NAME=dev-browser-template
SANDBOX_IDLE_TIMEOUT=7200
POOL_SIZE=2
LOG_LEVEL=DEBUG
生产环境 (.env.prod):
# 生产环境配置BROWSER_TEMPLATE_NAME=prod-browser-template
SANDBOX_IDLE_TIMEOUT=300
POOL_SIZE=10
LOG_LEVEL=INFO
ENABLE_METRICS=trueMETRICS_EXPORT_INTERVAL=300
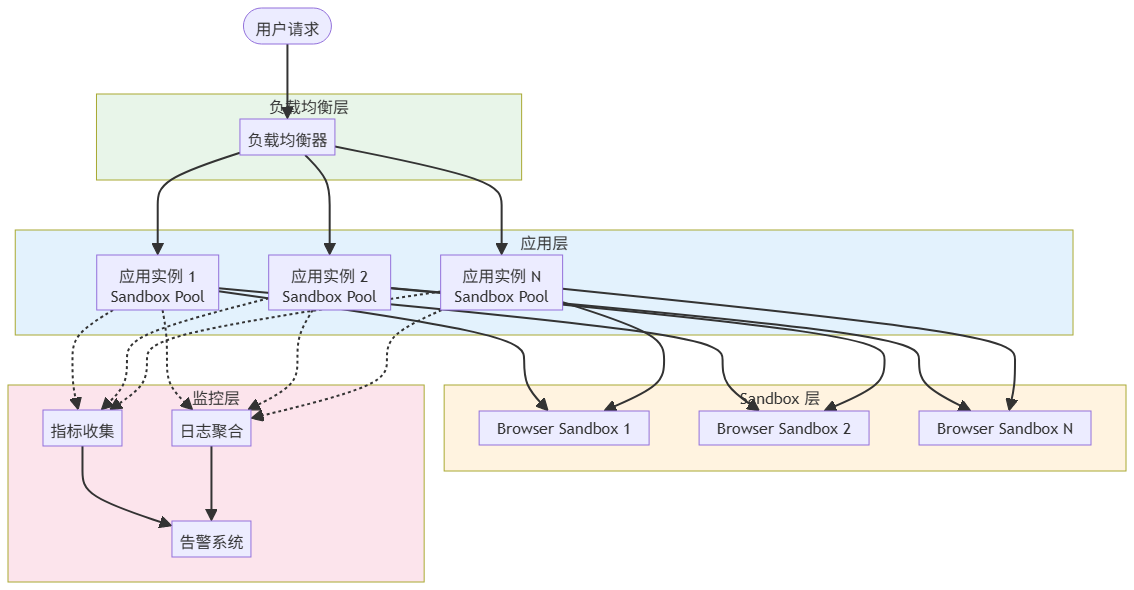
高可用架构
健康检查
from flask import Flask, jsonify
app = Flask(__name__)
manager = SandboxManager()@app.route('/health')def health_check():    """健康检查端点"""
    try:        # 检查 Sandbox 是否可用
        sandbox = manager.get_or_create()
        # 简单的健康检查
        is_healthy = hasattr(sandbox, 'sandbox_id')
        if is_healthy:            return jsonify({                'status': 'healthy',                'sandbox_id': sandbox.sandbox_id,                'timestamp': time.time()
            }), 200
        else:hbchaozan.com            return jsonify({                'status': 'unhealthy',                'error': 'Sandbox not available'
            }), 503
    except Exception as e:        return jsonify({            'status': 'unhealthy',            'error': str(e)
        }), 503@app.route('/metrics')def metrics():    """指标端点"""
    collector = MetricsCollector()    # 返回当前指标
    return jsonify({        'total_sandboxes': len(collector.metrics),        'timestamp': time.time()
    })
故障排查与常见问题
连接问题
问题:无法连接到 Sandbox
排查步骤:
def diagnose_connection(sandbox):    """诊断连接问题"""
    print(f"1. 检查 Sandbox ID: {sandbox.sandbox_id}")    print(f"2. 检查 CDP URL: {sandbox.cdp_url}")
    # 测试 CDP 连接
    try:        with sync_playwright() as p:
            browser = p.chromium.connect_over_cdp(sandbox.cdp_url)            print("✓ CDP 连接成功")
            browser.close()    except Exception as e:        print(f"✗ CDP 连接失败: {e}")
    # 测试 VNC 连接
    print(f"3. VNC URL:chengyiwl.com {sandbox.vnc_url}")    print("提示: 可以在浏览器中打开 VNC URL 测试连接")
超时问题
问题:任务执行超时
解决方案:
def handle_timeout(sandbox, operation, max_retries=3):    """处理超时(带重试)"""
    for attempt in range(max_retries):        try:            return operation(sandbox, timeout=30000)        except TimeoutError:
            logger.warning(f"任务超时(尝试 {attempt + 1}/{max_retries})")            if attempt == max_retries - 1:                # 最后一次尝试失败,重建 Sandbox
                logger.error("多次超时,重建 Sandbox")
                sandbox.delete()
                sandbox = Sandbox.create(
                    template_type=TemplateType.BROWSER,
                    template_name=os.getenv("BROWSER_TEMPLATE_NAME")
                )                return operation(sandbox, timeout=60000)
性能问题
问题:响应速度慢
优化建议:
- 使用连接池:预先创建多个 Sandbox 实例
- 启用 keep_alive:保持浏览器会话,避免重复建立连接
- 合理设置超时:根据任务复杂度调整超时时间
- 并发控制:限制并发请求数,避免资源竞争
# 性能优化配置示例browser_session = BrowserSession(
    cdp_url=sandbox.cdp_url,
    browser_profile=BrowserProfile(
        timeout=30000,          # 30秒超时
        keep_alive=True,        # 保持连接
        disable_security=False  # 保持安全检查
    )
)
错误码参考
| 错误码 | 说明 | 解决方案 |
|---|---|---|
ConnectionError |
连接失败 | 检查网络连接,验证 CDP URL |
TimeoutError |
操作超时 | 增加超时时间,检查任务复杂度 |
AuthenticationError |
认证失败 | 验证 API Key 和访问密钥 |
ResourceExhausted |
资源不足 | 减少并发数,增加资源配额 |
InvalidArgument |
参数错误 | 检查参数格式和有效性 |
总结
通过本指南,您已经掌握了:
- BrowserUse 集成:如何使用 BrowserUse 框架实现智能浏览器自动化
- 生命周期管理:三种 Sandbox 管理模式的选择和实现
- 性能优化:超时配置、复用策略、错误重试机制
- 安全实践:环境变量保护、URL 白名单、日志脱敏
- 可观测性:日志记录、指标收集、监控告警
- 成本优化:按需创建、闲置清理、批量处理
- 生产部署:高可用架构、健康检查、故障排查
立即体验函数计算 AgentRun
函数计算 AgentRun 的无代码到高代码演进能力,现已开放体验:
- 快速创建:访问控制台,60秒创建你的第一个 Agent
- 深度定制:当需要更复杂功能时,一键转换为高代码
- 持续演进:利用函数计算 AgentRun 的基础设施能力,持续优化你的 Agent
从想法到上线,从原型到生产,函数计算 AgentRun 始终是你最好的伙伴。 欢迎加入“函数计算 AgentRun 客户群”,钉钉群号:134570017218。
快速了解函数计算 AgentRun
ssh-hostkey: | 3072 6a:d8:44:60:80:39:7e:f0:2d:08:2f:e5:83:63:f0:70 (RSA) | 256 f2:a6:62:d7:e7:6a:94:be:7b:6b:a5:12:69:2e:fe:d7 (ECDSA) |_ 256 28:e1:0d:04:80:19:be:44:a6:48:73:aa:e8:6a:65:44 (ED25519) 80/tcp open http Apache httpd 2.4.41 ((Ubuntu)) |_http-title: Apache2 Ubuntu Default Page: It works |_http-server-header: Apache/2.4.41 (Ubuntu) | http-methods: |_ Supported Methods: POST OPTIONS HEAD GET 8080/tcp open ttkq-163.com http Apache Tomcat 9.0.53 |_http-favicon: Apache Tomcat |_http-title: Apache Tomcat/9.0.53 | http-methods: |_ Supported Methods: GET HEAD POST OPTIONS Device type: general purpose Running: Linux 4.X|5.X OS CPE: cpe:/o:linux:linux_kernel:4 cpe:/o:linux:linux_kernel:5 OS details: Linux 4.15 - 5.19 Uptime guess: 26.829 days (since Fri Dec 12 14:17:12 2025) Network Distance: 2 hops TCP Sequence Prediction: Difficulty=264 (Good luck!) IP ID Sequence Generation: All zeros
[10:30:28] 302 - 0B - /docs -> /docs/ [10:30:28] 200 - 15KB - /docs/ [10:30:29] 302 - 0B - /examples -> /examples/ [10:30:29] 200 - 1KB - /examples/ [10:30:29] 200 - 1KB - /examples/websocket/index.xhtml [10:30:29] 200 - 14KB - /examples/jsp/index.html [10:30:29] 200 - 6KB - /examples/servlets/index.html [10:30:29] 200 - 1KB - /examples/servlets/servlet/RequestHeaderExample [10:30:29] 200 - 658B - /examples/servlets/servlet/CookieExample [10:30:29] 200 - 687B - /examples/jsp/snp/snoop.jsp [10:30:30] 200 - 21KB - /favicon.ico [10:30:35] 302 - 0B - /manager ttkqw.com -> /manager/ [10:30:35] 302 - 0B - /manager/ -> /manager/html
生命周期和Cookie的携带情况,我们需要一套清晰的、从浏览器到服务器的排查方案。以下是详细的跟踪步骤和方法。
当然这个排查步骤和方法,也适合基本SpringBoot开发的系统,但是服务端的排查需要大家根据实际情况修改后端排查日志、拦截器等方法
整体排查思路
我们的目标是验证以下三个环节是否正常:
-
登录成功时:服务器是否正确生成了Session并返回了包含正确
JSESSIONID的Cookie给浏览器。 -
浏览器端:浏览器是否成功接收并存储了该Cookie。
-
后续请求:浏览器在执行查询等操作时,是否始终在请求头中携带了这个Cookie。
第一步:浏览器端跟踪(客户端验证)
这是最直接、最容易操作的第一步,可以由开发或运维人员在问题电脑上进行。
一、跟踪会话标识(Cookie)的接收与存储
-
开启浏览器开发者工具:使用出现问题的浏览器(如奇安信、Chrome),按
F12打开开发者工具。 -
切换到Network/网络面板:勾选
Preserve log(保留日志) 复选框,防止页面跳转时日志被清空。 -
清空Cookie(可选,为了纯净的测试):在开发者工具的
Application(应用)或Storage(存储)标签页下,找到Cookies,选中当前系统地址的Cookie,将其删除。这可以模拟一次全新的登录。 -
执行登录:
-
在地址栏输入系统单节点地址(如
http://10.15.9.106/...)进行登录。 -
在Network面板中,找到登录请求(通常是
login或j_spring_security_check之类的POST请求)。 -
重点查看登录请求的响应:
-
点击这个登录请求,查看
Response Headers(响应头)。 -
你应该能看到一个
Set-Cookie头,内容类似于JSESSIONID=ABCD1234...; Path=/; HttpOnly。 -
记录下这个
JSESSIONID的值。
-
-
-
验证Cookie存储:
-
切换到
Application/应用标签页。 -
在左侧找到
Cookies->http://10.15.9.106。 -
检查是否存在一个名为
JSESSIONID的Cookie,其值是否与刚才在响应头中看到的一致。
-
至此,我们验证了环节1和2。 如果这里就出问题,那么根源在服务器响应或浏览器安全策略上。
二、跟踪后续请求的Cookie携带情况
-
进行正常操作:登录成功后,在系统内进行一些不会触发闪退的简单操作,比如点击菜单。
-
观察请求:在Network面板中,观察这些操作触发的Ajax或页面请求。
-
检查请求头:随机点击几个后续请求,查看它们的
Request Headers(请求头)。-
必须找到一个
Cookie:头,其内容应包含JSESSIONID=ABCD1234...(即登录时设置的那个值)。 -
确保每个请求都携带了这个Cookie。
-
创建一个类,实现
HttpSessionListener和
HttpSessionAttributeListener接口,并部署到生产环境。这个类可以记录Session的创建、销毁和属性变化。
import javax.servlet.http.HttpSessionEvent;import javax.servlet.http.HttpSessionAttributeListener;import javax.servlet.http.HttpSessionBindingEvent;import java.util.logging.Logger; // 或使用Log4j、Slf4jpublic class SessionDebugListener implements HttpSessionListener, HttpSessionAttributeListener {    private static final Logger logger = Logger.getLogger(SessionDebugListener.class.getName(xiqinhb.com));    @Override
    public void sessionCreated(HttpSessionEvent se) {
        logger.info("!!! Session被创建: ID=" + se.getSession().getId() + ", 时间=" + new java.util.Date());
    }    @Override
    public void sessionDestroyed(HttpSessionEvent se) {        // 这是最关键的信息!会话何时、为何被销毁?
        logger.info("!ttzbw.org.cn!!basketzhibo.cn Session被销毁: ID=" + se.getSession().getId() + ", 时间=" + new java.util.Date() + "。 最后访问时间: " + new java.util.Date(se.getSession().getLastAccessedTime()));        // 可以在这里打印堆栈信息,看是哪个线程触发了销毁
        Thread.dumpStack();
    }    @Override
    public void attributeAdded(HttpSessionBindingEvent event) {        if ("user".equals(event.getName())) { // 监听用户登录属性
            logger.info("!!! 用户登录成功,User对象被存入Session。 SessionID=" + event.getSession().getId() + ", User=" + event.getValue());
        }
    }    @Override
    public void attributeRemoved(HttpSessionBindingEvent event) {        if ("user".equals(event.getName())) { // 监听用户登出属性
            logger.info(ttzbw.mo.cn"!!! 用户登出,User对象从Session移除。 SessionID=" + event.getSession().getId());
        }
    }
}
在
web.xml中注册:
<listener>
    <listener-class>com.yourcompany.SessionDebugListener</listener-class></listener>
2.在过滤器中记录请求:
在一个全局的Filter中(如果已有,则修改它),记录每个请求的Session状态。
public class SessionTrackingFilter implements Filter {    @Override
    public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain) throws IOException, ServletException {        HttpServletRequest req = (HttpServletRequest) request;        HttpServletResponse res = (HttpServletResponse) response;        String sessionId = req.getRequestedSessionId();        boolean sessionValid = req.isRequestedSessionIdValid();
        logger.info("请求进入:ttzbw.org.cn URI=" + req.getRequestURI() +
                   ", SessionID=" + sessionId +
                   ", Session是否有效=" + sessionValid);
        chain.doFilter(request, response);        // 请求处理后,再次检查Session状态
        sessionValid =tiantianzbw.com.cn req.isRequestedSessionIdValid();
        logger.info("请求离开: URI=" + req.getRequestURI() +
                   ", Session是否有效=" + sessionValid);
    }
}
部署这些监听器和过滤器后,重现闪退问题。然后立即查看服务器日志,寻找
!!! Session被销毁这条关键日志。它会告诉你Session被销毁的精确时间,结合堆栈信息,就能定位到是哪个代码路径或配置触发了销毁。
二、分析服务器线程栈
如果怀疑是
会话锁超时,需要在闪退发生时,立刻获取服务器的线程堆栈快照(
jstack <pid>)。分析快照,看是否有线程长时间持有Session锁(状态为
RUNNABLE且正在执行查询SQL),而其他线程在等待这个锁(状态为
BLOCKED)。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70048957/viewspace-3109042/ ,如需转载,请注明出处,否则将追究法律责任。

