OceanBase 故障处理:租户 MemStore 爆掉+ Plan Cache 泄漏,应急 + 升级两步搞定
在企业级数据库运维中,租户不可用、内存异常飙升是足以让运维团队紧张的突发状况。近期我们处理了一起 OceanBase 集群故障,根源指向已知 bug,最终通过应急处理与版本升级彻底解决。今天就把完整排查过程、解决方案及避坑要点分享给大家。
环境信息
OceanBase 构建版本号:3.2.3.3-108050012023070409
集群架构:3-3-3
问题原因
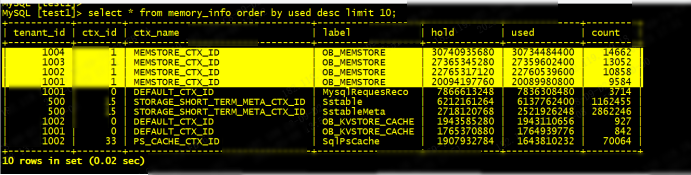
项目组首先反馈测试租户 SQL 执行失败,登录对应的测试租户,查看
memory_info表,发现当前租户的memstore爆掉。
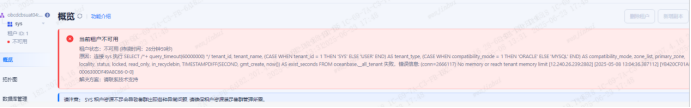
集群出现不可用告警,sys租户页面也显示当前租户不可用,但是sys租户仍然可以登录。
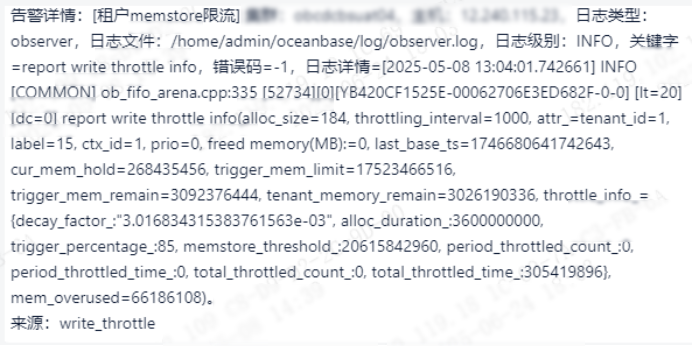
并且有租户memstore限流,4013等告警。
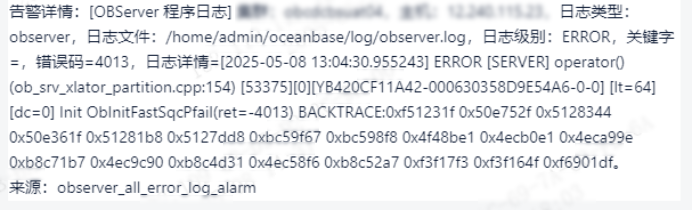
重启当前节点后,登录sys租户排查其他节点内存情况,仍然有问题,
ob_sql_phy_plan的mod内存使用仍然在不断增加且较高。
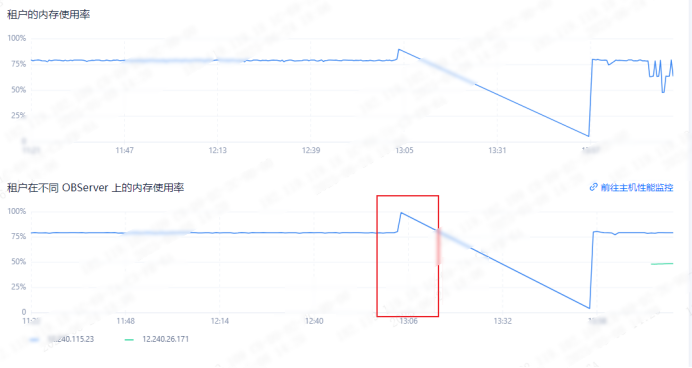
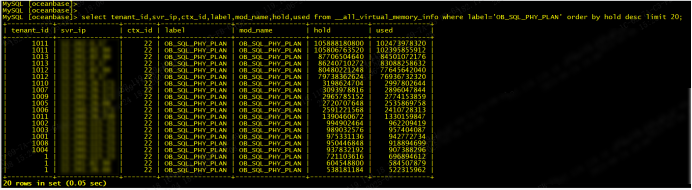
该现象和 Unit迁移后plan cache内存泄漏的已知bug高度吻合。
登录sys租户,通过下面的sql排查当前集群有问题的机器。
select distinct svr_ip from oceanbase.__all_virtual_memory_info
where ctx_name=
'PLAN_CACHE_CTX_ID' and mod_name =
'OB_SQL_PHY_PLAN' and used>10000000000;
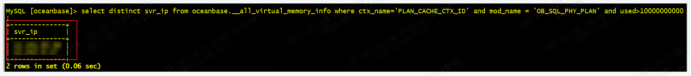
拉取所有环境的sys租户的连接串,排查有问题的集群。
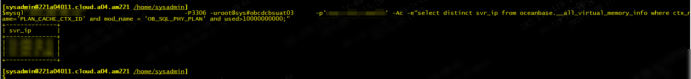
将所有有问题节点,轮询重启后问题解决。
解决方案
1.依次重启内存泄漏的observer
2.升级到问题修复的版本,3.2.3bp10(oceanbase-3.2.3.3-110000092023091219)之后的版本以修复该问题。
参考资料
OceanBase官网对该问题的记录
https://www.oceanbase.com/knowledge-base/oceanbase-database-1000000000481973?back=kb
如果大家在实操中遇到其他问题,欢迎在评论区留言交流!下次见~

瑞蓝创 OceanBase OBCP V4 精英训练营
点击下方链接立即了解详情
https://mp.weixin.qq.com/s/GUFSs1Zf-l9oNi8ZN8VvRA
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70047467/viewspace-3099287/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- JDBC 报错 No more data to read from socket 排查手册
- OceanBase 物化视图实践:增量刷新、并行调优、MLOG 机制拆解
- OceanBase ODP 主备租户读写分离配置指南
- OMS 4.3.2 迁移坑:OBOracle 同名 PK/UK 引发全量迁移错误
- 使用OceanBase物化视图时,你可能会遇到需要考虑的场景决策
- 性能暴涨2000倍!OceanBase 4.4.2.1 解决分区DDL业务雪崩难题
- OceanBase 4.3 适配 gh-ost 在线无锁 DDL 指南
- 海量数据迁移神器: OceanBase 分区交换(Exchange Partition)
- OceanBase SSL 传输链路加密配置与排错全指南
- OceanBase列存:HTAP混合负载的性能利器
