@[toc]
---
## 每日一句正能量
> “全情投入此刻,因为这是你唯一真正拥有的。”
过去是记忆,未来是想象,只有此刻是真实的。但人偏偏花最多的时间活在过去和未来。全情投入不是要你做得完美,而是吃饭时就吃饭,走路时就走路,听人说话时就真的在听。
## 摘要
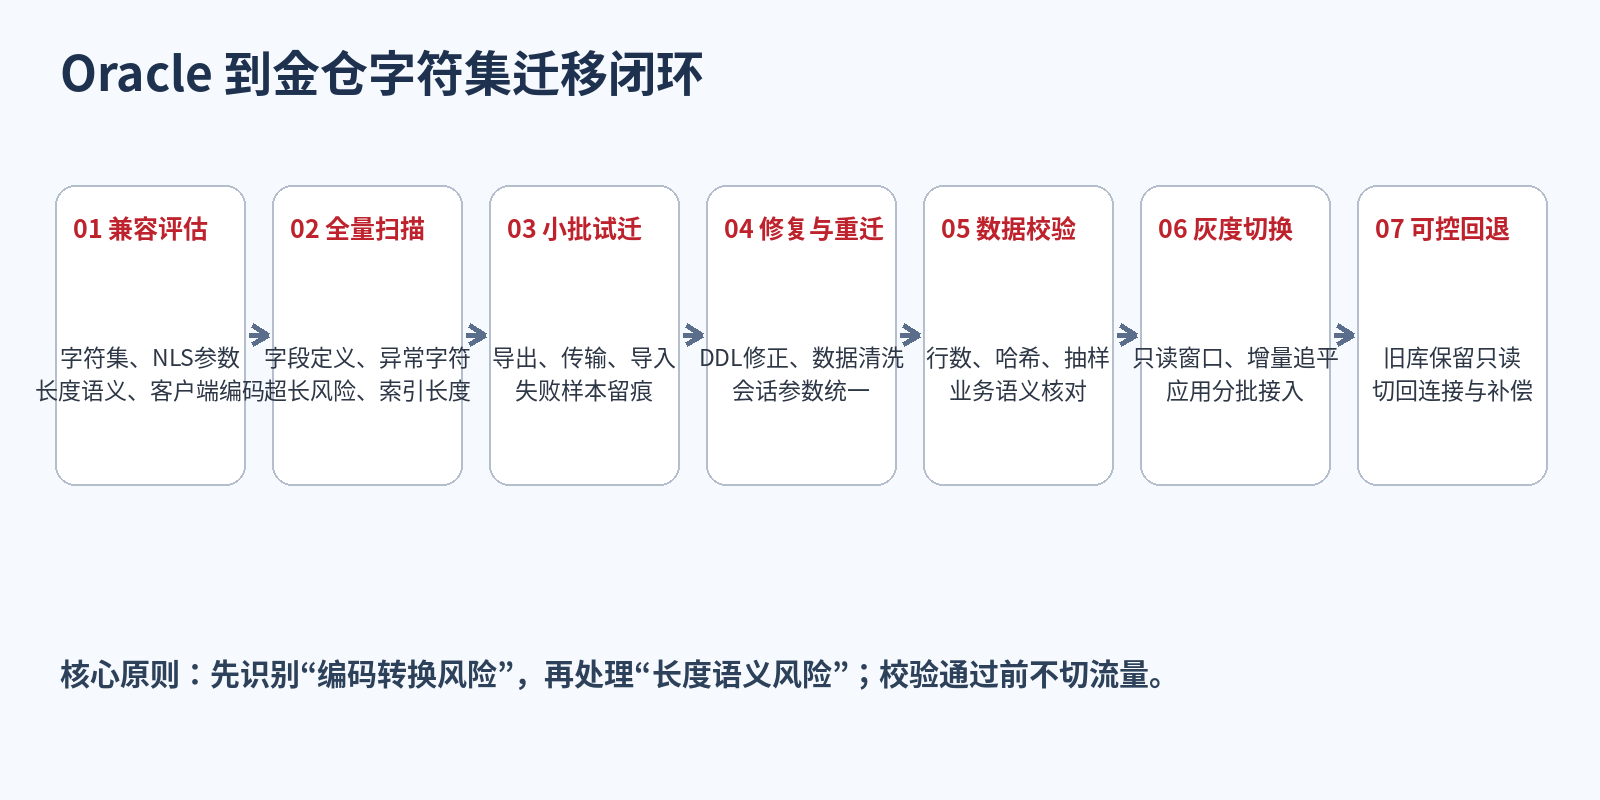
字符集问题往往不是在“导入失败”时才出现。更隐蔽的风险是:数据能够导入,应用也能查询,但中文被替换、固定长度字段尾部多出空格、唯一索引因语义变化失效,或者同一个字段在不同客户端显示出不同结果。本文以跨系统核心业务库迁移为背景,给出一套从兼容评估、问题扫描、小批试迁、修复实施、全量校验到灰度切换与回退的闭环方法。
本次演练重点处理四类问题:源端数据库字符集与目标端编码映射、Oracle `NLS_LENGTH_SEMANTICS` 的 BYTE/CHAR 差异、客户端编码链路不一致,以及多字节字符扩张造成的字段和索引长度风险。最终交付物包括字符集扫描 SQL、问题清单模板、修复 SQL、数据校验矩阵和回退方案。实践表明,字符集迁移不能只看数据库初始化编码,也不能只比较表行数;必须同时验证“字段定义、原始字节、业务语义和应用链路”。
**迁移流程图**
---
## 1. 背景与问题
某核心业务系统原运行在 Oracle 19c,库内包含客户、订单、合同、产品和审计日志等数据。迁移目标是 KingbaseES V8R6,要求在有限停机窗口内完成全量迁移与增量追平,并满足三个基本目标:
1. 中文、少数民族文字、生僻字、全角符号等内容不乱码、不丢失;
2. `CHAR`、`VARCHAR2` 等字段不因 BYTE/CHAR 语义变化发生截断或补空格异常;
3. 迁移前后的关键业务数据可量化核对,出现问题能够快速回退。
早期试迁中出现了四种典型现象。
**第一,部分中文在命令行工具中显示为乱码,但在图形化客户端中正常。**
这说明数据本身未必损坏,问题可能位于客户端、驱动或终端显示链路。如果不先区分“存储乱码”和“显示乱码”,很容易对正确数据进行二次转码,反而造成不可逆破坏。
**第二,个别备注字段导入失败,提示长度超限。**
Oracle 中同样写作 `VARCHAR2(100)` 的字段,可能是 `100 BYTE`,也可能是 `100 CHAR`。中文在 UTF-8 中通常占多个字节。迁移时如果只机械复制数字 100,而没有复制长度语义,字段实际容量就可能发生变化。
**第三,固定长度编码字段迁移后比较结果异常。**
例如源端 `CHAR(8 BYTE)` 与目标端默认 CHAR 语义不一致,可能造成尾部空格、比较行为或驱动取值表现不同。金仓官方迁移文档也特别提示,应核对 Oracle 的 `NLS_LENGTH_SEMANTICS`,并让目标端参数与源端保持一致,否则迁移 `CHAR` 类型时可能出现多余空格。
**第四,部分唯一索引在目标端重建失败。**
根因不是索引语法,而是字符规范化、尾部空格处理或历史混合编码导致原本“看起来不同”的值在目标环境中变成相同值。此类问题必须先定位重复数据,再决定清洗规则,不能直接删除约束绕过。
因此,本次迁移将“字符集”拆成五层检查:
- 数据库服务端编码;
- Oracle NLS 参数与字段级长度语义;
- 导出、传输和导入工具的编码行为;
- JDBC、ODBC、命令行和操作系统终端编码;
- 数据内容本身是否包含非法字节、控制字符或历史错误转码。
---
## 2. 环境与数据
### 2.1 演练环境
| 项目 | 源端 | 目标端 |
|---|---|---|
| 数据库 | Oracle Database 19c | KingbaseES V8R6 |
| 数据库字符集 | AL32UTF8 | UTF8 |
| 国家字符集 | AL16UTF16 | 不按 Oracle 国家字符集机制一一映射 |
| 长度语义 | 以源端实际查询结果为准 | 显式设置为与源端一致 |
| 迁移方式 | 全量导出 + 目标导入 + 增量追平 | 接收迁移数据 |
| 客户端 | SQL*Plus、JDBC、导出工具 | ksql、JDBC、迁移工具 |
KingbaseES 支持多种服务端和客户端编码,数据库编码在建库时确定。官方 Oracle 迁移实践建议,目标数据库字符集应与 Oracle 源库字符集保持一致或完成明确、可验证的兼容映射。本文示例采用 Oracle `AL32UTF8` 到金仓 `UTF8` 的方案,但“名称相近”不代表可以跳过扫描:仍需验证非法字符、长度扩张、排序规则和客户端编码。
### 2.2 样例数据范围
演练库约包含:
- 约 320 GB 业务数据;
- 1280 张业务表;
- 86 张核心表;
- 约 4.2 亿行记录;
- 18 个大字段表;
- 2300 余个索引;
- 多个 Java 应用和批处理任务。
正式迁移前,先建立“问题数据集”,覆盖以下边界字符:
```text
普通中文:金仓数据库迁移验证
生僻字:𠮷、龘
全角符号:ABC123
组合字符:é(字母与重音组合)
Emoji:😀、🚀
控制字符:回车、换行、制表符
尾部空格:ABC···
中英文混排:订单Order-2025-0001
```
这组数据不是为了展示字符,而是用来回答三个问题:
1. 源端能否正确存储和返回;
2. 迁移工具是否发生隐式转换;
3. 目标端及应用驱动能否按相同业务含义读取。
---
## 3. 复现过程
### 3.1 查询 Oracle 字符集与 NLS 参数
首先记录数据库级和会话级参数,避免只看一个视图就下结论。
```sql
-- 数据库字符集与国家字符集
SELECT parameter, value
FROM nls_database_parameters
WHERE parameter IN (
'NLS_CHARACTERSET',
'NLS_NCHAR_CHARACTERSET',
'NLS_LENGTH_SEMANTICS',
'NLS_LANGUAGE',
'NLS_TERRITORY'
)
ORDER BY parameter;
-- 当前会话参数
SELECT parameter, value
FROM nls_session_parameters
WHERE parameter IN (
'NLS_LANGUAGE',
'NLS_TERRITORY',
'NLS_LENGTH_SEMANTICS',
'NLS_DATE_LANGUAGE'
)
ORDER BY parameter;
-- 实例参数
SHOW PARAMETER nls_length_semantics;
```
需要特别注意:`NLS_LENGTH_SEMANTICS` 决定未显式指定 BYTE/CHAR 时新建字符列的默认语义,但已存在字段的真实定义仍应从数据字典读取,不能仅凭实例参数推断。
### 3.2 扫描字段级长度语义
以下 SQL 用于找出所有 CHAR/VARCHAR2/NCHAR/NVARCHAR2 字段,并区分 BYTE 与 CHAR。
```sql
SELECT
owner,
table_name,
column_name,
data_type,
data_length,
char_length,
char_used,
nullable
FROM dba_tab_columns
WHERE owner IN ('BIZ_CORE', 'BIZ_ORDER')
AND data_type IN ('CHAR', 'VARCHAR2', 'NCHAR', 'NVARCHAR2')
ORDER BY owner, table_name, column_id;
```
字段解释:
- `DATA_LENGTH`:字段允许的字节长度;
- `CHAR_LENGTH`:字段声明的字符长度;
- `CHAR_USED='B'`:BYTE 语义;
- `CHAR_USED='C'`:CHAR 语义。
进一步筛选高风险字段:
```sql
SELECT
owner,
table_name,
column_name,
data_type,
data_length,
char_length,
char_used
FROM dba_tab_columns
WHERE owner IN ('BIZ_CORE', 'BIZ_ORDER')
AND data_type IN ('CHAR', 'VARCHAR2')
AND (
char_used = 'B'
OR data_length <> char_length
)
ORDER BY data_length DESC;
```
这里不能简单地把所有 BYTE 字段改成 CHAR。对于外部系统编码、固定报文、银行卡号、机构码等字段,BYTE 语义可能正是业务设计。正确做法是逐字段分类:
| 分类 | 示例 | 建议 |
|---|---|---|
| 业务自然语言 | 姓名、地址、备注 | 优先按字符容量评估 |
| 固定代码 | 机构码、产品码 | 保持源端语义,验证尾部空格 |
| 外部报文 | 定长接口字段 | 以接口协议字节数为准 |
| 索引字段 | 名称、证件号 | 同时评估索引键长度和重复值 |
| 大字段 | CLOB/NCLOB | 单独验证工具映射和换行符 |
### 3.3 扫描实际内容长度
字段定义安全,不代表已有数据安全。下面的 SQL 用于比较字符长度和字节长度。由于表名和列名需要动态拼接,建议生成 SQL 后由 DBA 审核执行。
```sql
SELECT
'SELECT ''' || owner || '.' || table_name || '.' || column_name ||
''' AS object_name, ' ||
'MAX(LENGTH("' || column_name || '")) AS max_char_len, ' ||
'MAX(LENGTHB("' || column_name || '")) AS max_byte_len ' ||
'FROM "' || owner || '"."' || table_name || '";' AS scan_sql
FROM dba_tab_columns
WHERE owner IN ('BIZ_CORE', 'BIZ_ORDER')
AND data_type IN ('CHAR', 'VARCHAR2', 'NCHAR', 'NVARCHAR2')
ORDER BY owner, table_name, column_id;
```
对核心表可以直接执行:
```sql
SELECT
MAX(LENGTH(customer_name)) AS max_char_len,
MAX(LENGTHB(customer_name)) AS max_byte_len,
COUNT(*) AS row_count
FROM biz_core.t_customer;
```
如果字段定义为 `VARCHAR2(60 BYTE)`,而 `MAX(LENGTHB(customer_name))` 已接近 60,那么迁移、清洗或字符规范化后都有截断风险。此时应提前扩列,而不是等导入时报错。
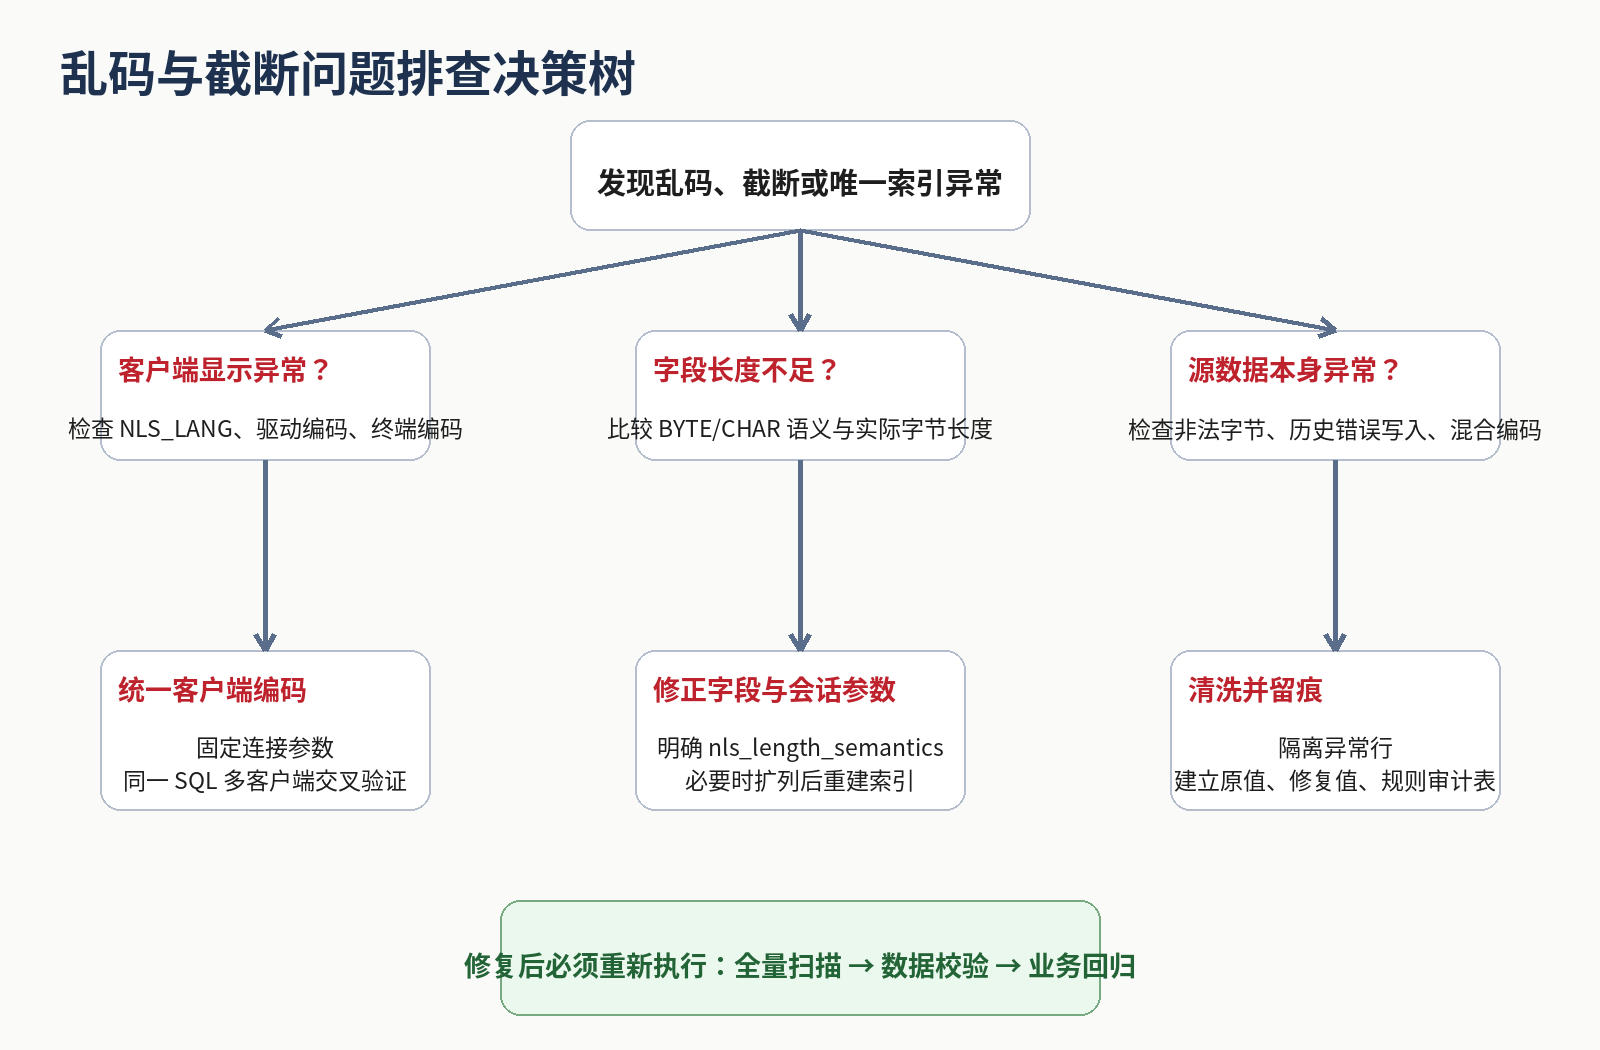
### 3.4 定位乱码还是显示异常
发现乱码后,不要立刻更新数据。先做三组对照:
```sql
SELECT
id,
customer_name,
LENGTH(customer_name) AS char_len,
LENGTHB(customer_name) AS byte_len,
DUMP(customer_name, 1016) AS hex_dump
FROM biz_core.t_customer
WHERE id = :id;
```
对照方法:
1. 在 Oracle 原生客户端查看;
2. 在 JDBC 程序中以 UTF-8 输出到文件;
3. 在目标端导入后查看字符、字符长度、字节长度和十六进制。
如果十六进制内容一致、图形化客户端正常而终端异常,优先检查终端编码和客户端参数。Oracle 官方文档指出,`NLS_LANG` 的字符集部分应反映客户端操作系统编码,正确设置后才能完成客户端编码与数据库字符集之间的转换。
**乱码排查决策树**
### 3.5 扫描控制字符和不可见字符
业务数据中经常混入换行、回车、制表符和不可见控制字符。它们不一定非法,但会影响 CSV、中间文件、日志和比较结果。
```sql
SELECT
id,
remark,
LENGTH(remark) AS char_len,
LENGTHB(remark) AS byte_len
FROM biz_order.t_order
WHERE REGEXP_LIKE(remark, '[[:cntrl:]]');
```
对外部文件迁移,还应检查字段分隔符、记录分隔符、转义符和引号规则,防止“数据库字符集正确,但文件解析错位”。
---
## 4. 方案实施
### 4.1 建立兼容评估清单
迁移开始前,先形成书面清单,至少包含:
```text
[ ] Oracle NLS_CHARACTERSET
[ ] Oracle NLS_NCHAR_CHARACTERSET
[ ] Oracle NLS_LENGTH_SEMANTICS
[ ] 字段级 CHAR_USED 分布
[ ] 最大字符长度与最大字节长度
[ ] CLOB/NCLOB 映射
[ ] 客户端和驱动编码
[ ] 导出文件编码
[ ] 目标库编码、区域与排序规则
[ ] 索引键长度与重复值
[ ] 非法字符和控制字符
[ ] 回退触发条件与责任人
```
目标库创建时,应显式确认编码、区域设置和长度语义,不依赖默认值。示意命令如下,具体参数以实际版本文档为准:
```sql
-- 连接目标库后确认服务端编码
SHOW server_encoding;
-- 确认客户端编码
SHOW client_encoding;
-- Oracle 兼容模式下确认长度语义
SHOW nls_length_semantics;
-- 迁移会话显式设置
SET client_encoding = 'UTF8';
SET nls_length_semantics = 'BYTE'; -- 示例:应与源端和字段策略一致
```
这里采用“会话显式设置”而不是只改全局默认,原因是迁移工具、DDL 执行账号和应用账号可能使用不同连接。每条迁移链路都应在日志中记录实际参数。
### 4.2 先迁结构,再迁小批数据
结构迁移后,先不要导入全量。选取四类表做小批试迁:
- 字段类型最多的表;
- 中文和大字段最集中的表;
- 索引最多、约束最复杂的表;
- 业务最关键的表。
每张表抽取边界数据:
```sql
SELECT *
FROM (
SELECT t.*
FROM biz_order.t_order t
WHERE remark IS NOT NULL
ORDER BY LENGTHB(remark) DESC
)
WHERE ROWNUM <= 1000;
```
小批试迁应保留:
- 导出日志;
- 导入日志;
- 失败行主键;
- 源值十六进制;
- 目标值十六进制;
- 修复规则;
- 修复前后对比。
### 4.3 修复长度语义不一致
假设源端字段为:
```sql
remark VARCHAR2(300 BYTE)
```
而目标端迁移脚本生成了默认 CHAR 语义的 `VARCHAR(300)`。此时不能仅凭“目标更宽”判断安全,因为索引长度、应用校验和接口协议可能发生变化。
推荐策略:
1. 固定代码和报文字段:保持 BYTE 语义;
2. 自然语言字段:结合实际最大字节长度,评估是否改为 CHAR 或扩容;
3. 有索引字段:先评估目标索引键上限,再调整字段;
4. 修改 DDL 后重新创建约束和索引;
5. 禁止在未备份原值的情况下直接截断数据。
示意修复 SQL:
```sql
-- 示例:先扩容,避免导入截断
ALTER TABLE biz_order.t_order
ALTER COLUMN remark TYPE VARCHAR(600);
-- 示例:修复前创建异常数据备份表
CREATE TABLE mig_audit.t_order_remark_backup AS
SELECT id, remark, CURRENT_TIMESTAMP AS backup_time
FROM biz_order.t_order
WHERE LENGTH(remark) > 300;
```
对于固定长度 `CHAR` 字段,应单独验证尾部空格:
```sql
SELECT
code,
LENGTH(code) AS char_len,
OCTET_LENGTH(code) AS byte_len,
code = RTRIM(code) AS equals_trimmed
FROM biz_core.t_product
ORDER BY product_id
FETCH FIRST 100 ROWS ONLY;
```
### 4.4 修复历史错误编码
发现“文字已经被错误转码后存入源库”时,必须先确认原始字节和正确目标文本。禁止使用多次 `CONVERT` 或字符串替换反复试错。
建议建立审计表:
```sql
CREATE TABLE mig_audit.charset_fix_log (
table_name VARCHAR(128) NOT NULL,
pk_value VARCHAR(256) NOT NULL,
column_name VARCHAR(128) NOT NULL,
old_value TEXT,
new_value TEXT,
fix_rule VARCHAR(500) NOT NULL,
operator_name VARCHAR(128) NOT NULL,
fixed_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
reviewed_by VARCHAR(128),
PRIMARY KEY (table_name, pk_value, column_name)
);
```
修复流程:
1. 将异常行隔离到备份表;
2. 通过上游文件、业务凭证或历史系统确认正确值;
3. 生成可审查的 `UPDATE`;
4. 双人复核后执行;
5. 保留原值、修复值、规则和审批记录;
6. 重新执行字符、数据和业务校验。
### 4.5 全量迁移与增量追平
全量迁移建议分表、分批执行。每一批次记录:
```text
批次号
源表
目标表
开始时间
结束时间
源端行数
目标端行数
失败行数
重试次数
校验状态
异常说明
```
切换前进入受控窗口:
1. 停止非必要批处理;
2. 记录增量起点;
3. 完成最后一轮增量同步;
4. 核对核心表行数与哈希;
5. 执行业务只读回归;
6. 分应用节点灰度切换;
7. 观察错误率、连接数、延迟和业务指标;
8. 达到观察时长后再扩大流量。
---
## 5. 结果对比
### 5.1 结构与数据校验
只比较 `COUNT(*)` 不足以证明无损迁移。推荐采用七层校验。
**数据校验矩阵**
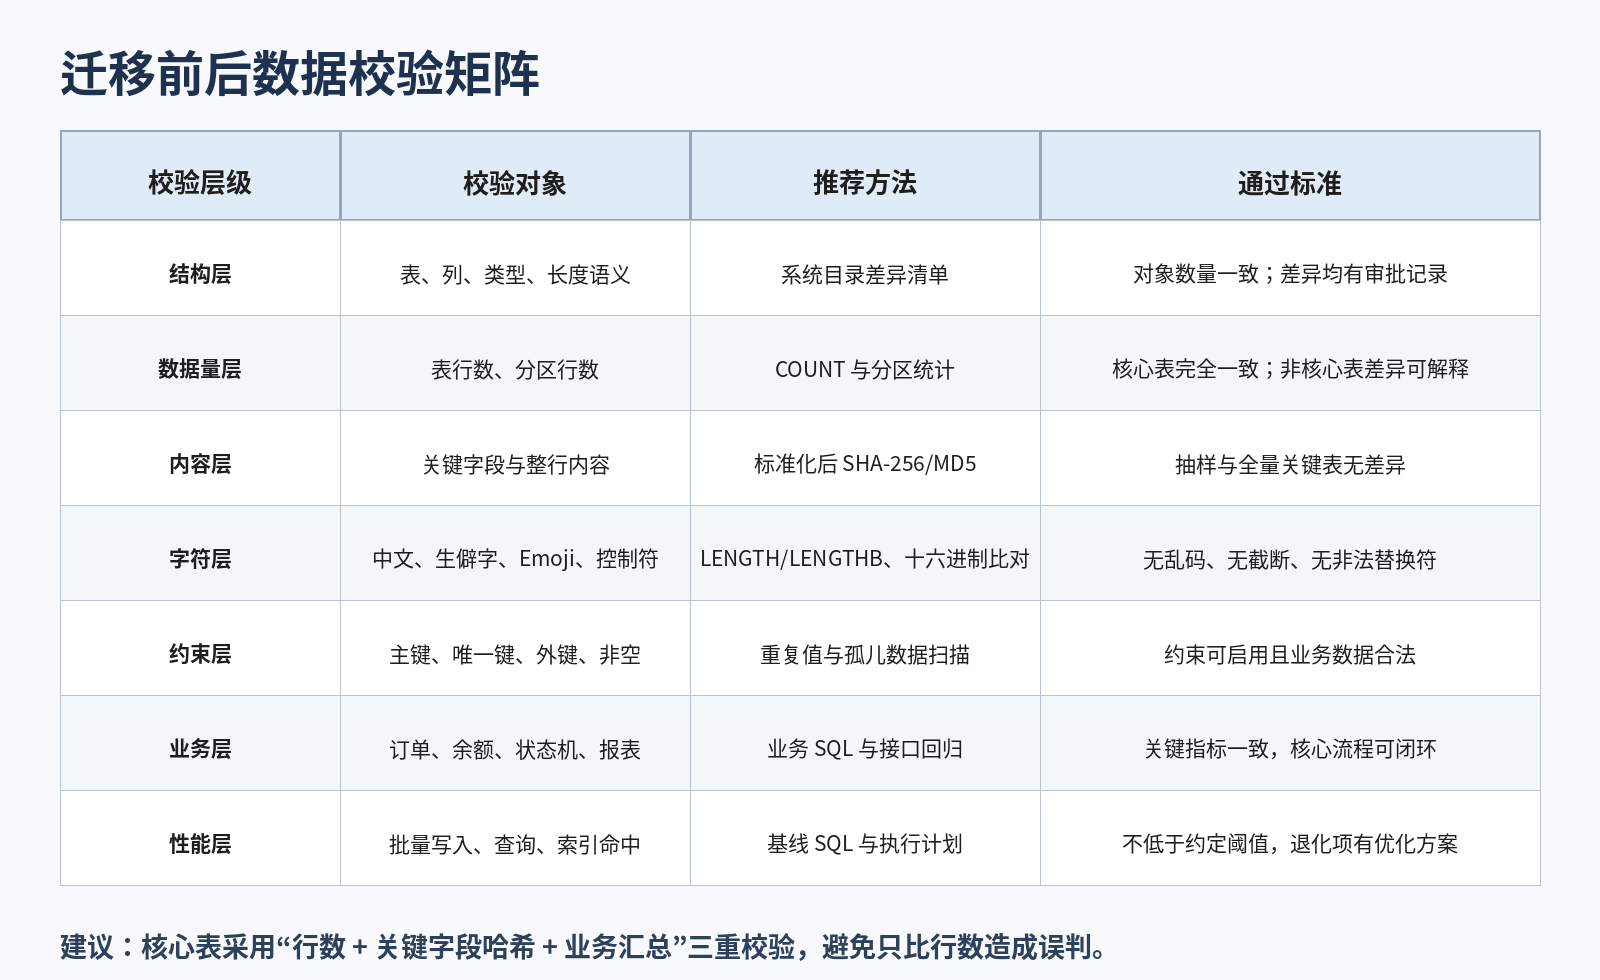
核心表可采用“分片哈希”,避免一次聚合造成长事务或内存压力。示意方法如下。
Oracle 侧:
```sql
SELECT
MOD(id, 128) AS bucket_id,
COUNT(*) AS row_count,
SUM(ORA_HASH(
NVL(TO_CHAR(id), '#') || '|' ||
NVL(customer_name, '#') || '|' ||
NVL(status, '#')
)) AS hash_sum
FROM biz_core.t_customer
GROUP BY MOD(id, 128)
ORDER BY bucket_id;
```
目标侧应使用等价的标准化表达式。注意:Oracle `ORA_HASH` 与目标数据库哈希函数算法不同,不能直接比较函数结果。更稳妥的方法是:
- 在两端将字段按相同规则序列化;
- 统一空值标记、时间格式、数值格式和大小写;
- 使用相同的 SHA-256 或 MD5 算法;
- 分桶统计并比较;
- 对差异桶逐行定位。
目标侧示意:
```sql
SELECT
MOD(id, 128) AS bucket_id,
COUNT(*) AS row_count,
MD5(
STRING_AGG(
COALESCE(id::text, '#') || '|' ||
COALESCE(customer_name, '#') || '|' ||
COALESCE(status, '#'),
'' ORDER BY id
)
) AS bucket_hash
FROM biz_core.t_customer
GROUP BY MOD(id, 128)
ORDER BY bucket_id;
```
生产环境大表不建议直接对全表 `STRING_AGG`。可按主键范围、分区或固定桶拆分,并控制并发和资源占用。
### 5.2 字符专项校验
对问题数据集逐项比对:
```sql
SELECT
sample_id,
sample_text,
LENGTH(sample_text) AS char_len,
OCTET_LENGTH(sample_text) AS byte_len,
ENCODE(CONVERT_TO(sample_text, 'UTF8'), 'hex') AS utf8_hex
FROM mig_test.charset_sample
ORDER BY sample_id;
```
通过标准:
- 源端与目标端文本业务含义一致;
- 字符数量符合预期;
- UTF-8 十六进制符合预期;
- 无替换字符 `�`;
- 无意外问号、方框或空字符串;
- 尾部空格规则与业务设计一致;
- JDBC、ksql 和应用页面显示一致。
### 5.3 示例问题清单
| 编号 | 问题 | 根因 | 处理 | 验证 |
|---|---|---|---|---|
| C-001 | 命令行中文乱码 | 终端编码与客户端编码不一致 | 固定 UTF-8,重连会话 | 图形客户端、文件和终端三方一致 |
| C-002 | 备注字段导入失败 | BYTE/CHAR 语义复制错误 | 扩列并显式设置语义 | 最大字节长度与边界样本通过 |
| C-003 | 产品码尾部空格 | CHAR 默认语义不同 | 按源端重建字段并验证驱动 | 等值比较与接口回归通过 |
| C-004 | 唯一索引重建失败 | 历史数据含不可见字符 | 审计后清洗、重建索引 | 重复扫描为零 |
| C-005 | CSV 行错位 | 内容含换行且转义规则不统一 | 改用可靠导出格式或统一转义 | 文件行数与数据库行数一致 |
---
## 6. 风险、回退与复盘
### 6.1 主要风险
**风险一:把显示问题误判为存储问题。**
应通过多客户端、十六进制和长度函数交叉验证,未确认前不更新数据。
**风险二:只看数据库字符集,不看字段长度语义。**
字符集兼容不代表字段容量兼容。迁移前必须扫描 `CHAR_USED`、最大字节长度和索引字段。
**风险三:只比行数。**
两端行数相等,仍可能存在字段截断、空值变化、时间格式变化和乱码。核心表至少采用行数、内容哈希、业务汇总三重校验。
**风险四:客户端链路不统一。**
迁移工具、JDBC 驱动、命令行和操作系统终端必须分别验证,不能用一个客户端的正确结果代替整条链路。
**风险五:修复操作不可审计。**
所有数据清洗必须保留原值、规则、执行人、复核人和时间,支持反向恢复。
### 6.2 回退方案
回退不是“恢复一次备份”这么简单,而是切换前就设计好的业务动作。
**灰度切换与回退架构图**
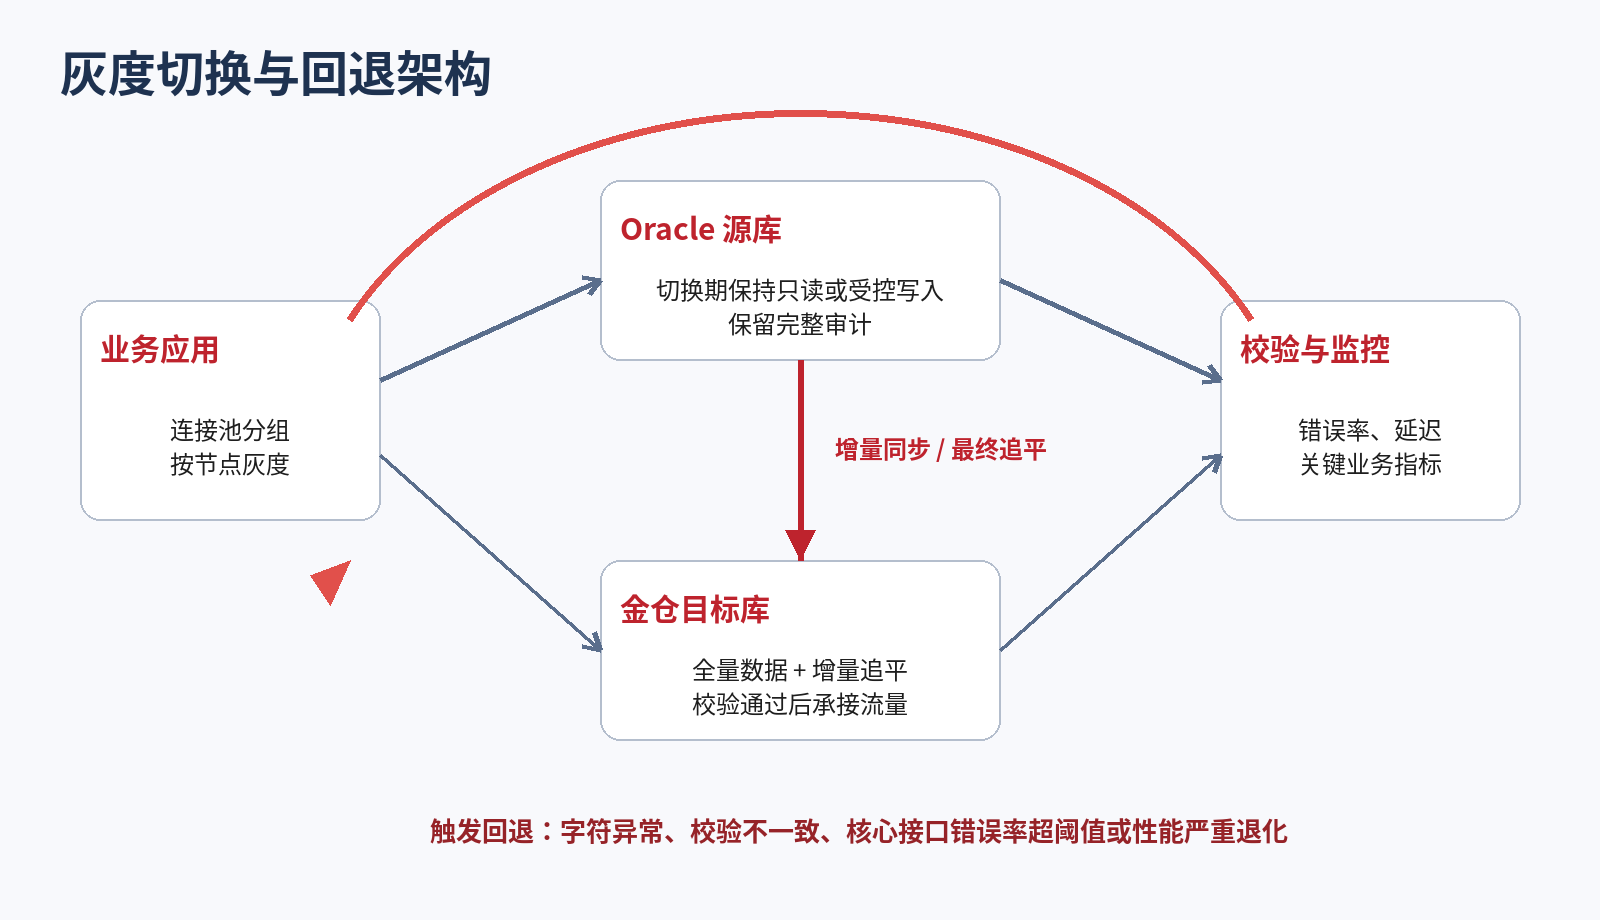
建议设置明确触发条件:
- 核心表校验不一致;
- 出现未解释的乱码或截断;
- 核心接口错误率超过阈值;
- 关键 SQL 性能严重退化;
- 增量同步延迟无法在窗口内收敛;
- 业务账务或状态机无法闭环。
回退步骤:
1. 立即停止扩大目标库流量;
2. 将已切换应用节点切回 Oracle;
3. 冻结目标库写入,保留现场;
4. 根据双写或审计日志识别目标库新增数据;
5. 经业务确认后实施反向补偿;
6. Oracle 恢复主写;
7. 对差异和根因重新评估;
8. 修复后重新小批试迁,禁止直接再次全量切换。
### 6.3 复盘结论
这次演练最重要的经验不是某条参数,而是排查顺序:
> **先确认数据原始字节,再确认数据库与字段语义,然后确认迁移工具,最后确认应用显示。**
字符集迁移的技术难点通常集中在边界数据,而不是普通中文。生僻字、组合字符、Emoji、不可见控制字符、固定长度字段和历史错误编码,才是决定迁移质量的部分。
第二个经验是:目标库参数要显式化。数据库编码、客户端编码和长度语义应写进建库脚本、迁移会话脚本和验收报告,不能依赖“默认值应该没问题”。
第三个经验是:校验必须可复现。每个问题都要能关联到表、主键、字段、源值、目标值、修复规则和验证结果。只有这样,所谓“无损迁移”才不是口头承诺,而是可审计的工程结论。
---
## 附录 A:一键生成字符字段扫描 SQL
```sql
SET PAGESIZE 0
SET FEEDBACK OFF
SET HEADING OFF
SET LINESIZE 32767
SET LONG 1000000
SET TRIMSPOOL ON
SPOOL charset_column_scan.sql
SELECT
'SELECT ''' || owner || '.' || table_name || '.' || column_name ||
''' AS object_name, COUNT(*) AS row_count, ' ||
'MAX(LENGTH("' || column_name || '")) AS max_char_len, ' ||
'MAX(LENGTHB("' || column_name || '")) AS max_byte_len ' ||
'FROM "' || owner || '"."' || table_name || '";'
FROM dba_tab_columns
WHERE owner IN ('BIZ_CORE', 'BIZ_ORDER')
AND data_type IN ('CHAR', 'VARCHAR2', 'NCHAR', 'NVARCHAR2')
ORDER BY owner, table_name, column_id;
SPOOL OFF
```
## 附录 B:问题清单模板
```markdown
| 问题编号 | 发现阶段 | 表名 | 主键 | 字段 | 现象 | 源端定义 | 目标定义 | 根因 | 修复方案 | 复核人 | 状态 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| C-001 | 小批试迁 | | | | | | | | | | |
```
## 附录 C:上线前检查
```text
[ ] 字符集和长度语义扫描已完成
[ ] 所有高风险字段有处理结论
[ ] 异常字符均有主键级清单
[ ] 结构差异已审批
[ ] 核心表完成三重校验
[ ] JDBC、批处理、报表和页面回归通过
[ ] 增量同步已追平
[ ] 回退脚本完成演练
[ ] 源库保留周期已确认
[ ] 上线责任人与业务确认人已签字
```
---
欢迎 👍点赞✍评论⭐收藏,欢迎指正
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70047341/viewspace-3176753/ ,如需转载,请注明出处,否则将追究法律责任。

