OceanBase 向量数据库使用指南
AI 时代已经到来,如何用好 AI 时代的数据底座 “向量数据库”,也已经成为了如今 DBA 和 AI 应用开发者必知必会的东西。
为了大家更好地使用 OceanBase 向量数据库, OceanBase 中负责研发向量能力的高级技术专家 舸灏以及一众研发同学,共同为大家写了这篇《OceanBase 向量数据库使用指南》。
推荐大家先收藏本文,以备不时之需。
欢迎大家关注 OceanBase 社区公众号 “老纪的技术唠嗑局”,在这个公众号中,会持续为大家更新与 #数据库、 #AI、 #OceanBase 相关的技术内容!
这篇文章是一篇超级干货,旨在为具备向量数据库和向量索引基础知识的用户,提供对 OceanBase 向量能力进行性能优化的指导。
说明:
阅读本文需要的前置知识: 《浅入了解向量数据库》 。
还不了解向量数据库的朋友们可以先看这篇~
当向量数据量低于百万级别时,建议采用 OceanBase 数据库的默认参数配置。
而当数据量突破百万,且有更高性能提升需求时,就强烈建议去认真阅读本文的内容了。
向量索引使用基础
创建向量索引
OceanBase 支持随建表创建索引和建表后再创建索引。
-- 随表创建向量索引


CREATE

TABLE

test
(


id

bigint
(
20
)
NOT

NULL
,


  label
varchar
(
256
)
NOT

NULL
,


  embedding VECTOR(
768
)
DEFAULT

NULL
,


  PRIMARY
KEY
 (
id
),


  VECTOR
INDEX
 vec_idx (embedding)
WITH
 (DISTANCE=COSINE,
TYPE
=HNSW)


);
-- 写入数据后再创建索引


CREATE
TABLE
test
(


  id
bigint
(
20
)
NOT
NULL
,


  label
varchar
(
256
)
NOT
NULL
,


  embedding VECTOR(
768
)
DEFAULT
NULL
,


  PRIMARY
KEY
 (
id
)


);


CREATE
 VECTOR
INDEX
 vec_idx
on
test
(embedding)
WITH
 (DISTANCE=COSINE,
TYPE
=HNSW);
如果已有的数据量较多,例如达到百万及以上,建议是先建表,导入完数据,再多线程并发创建索引。 创建完索引后,新增或修改的向量是能够被立即查询的,但是写入性能会受到一定的影响。这与 OceanBase 当前支持的索引增量策略有关。
由于向量索引在构建过程中需要进行大量的浮点数计算,业界不少实现采用了异步模式,数据先写入,暂不创建索引,待查询时采用暴力搜索增量数据,或者等待异步构建完成增量索引后并加载到内存中才可查询。这种方式增量数据无法被实时查询,或对查询性能的影响较大。
大部分用户场景下对数据新增或修改的需求是每天或每隔一段时间写入一批数据,而实时进行 DML 的 TPS 虽然不高,但都希望写入即可见。因此 OceanBase 优先支持了同步模式,新增数据会在写入时立刻进入增量索引,通过向量索引可以立即查询到。为了保证较好的写入性能,增量部分目前没有进行量化压缩。 HNSW 索引在增量数据达到已有数据 20% 时,后台任务会自动进行索引重建,将增量数据量化并将增量和原有数据合并到一起以压缩索引内存占用并提高性能。IVF 索引并不需要通过重建来恢复性能,如果新增的数据较多,可能会导致聚类特征发生变化,建议新增数据达到 30% 时主动进行重建。
并发构建索引
并行构建向量索引的方法和并行构建其它索引的方法相同,需要通过 parallel hint 进行指定。在构建索引时,如果业务负载不高, 建议将并行度设置为租户 CPU 数量的两倍 。
CREATE

/*+ PARALLEL(16) */
 VECTOR
INDEX
 vec_idx


ON

test
(embedding)


WITH
 (distance=cosine,
type
=HNSW);
注意:在数据量达到千万以上时,建议设置 alter system set _px_object_sampling = 5000; 以提高采样结果的准确度,使得构建中各线程的负载尽可能的均匀,提高构建速度。
创建索引时索引参数
在创建向量索引时,除了指定索引构建参数 m, ef_construction, nlist,也可指定默认查询参数 ef_search, nprobes。查询参数会作为查询时的默认参数使用。
CREATE

/*+ PARALLEL(16) */
 VECTOR
INDEX
 vec_idx


ON

test
(embedding)


WITH
 (distance=cosine,


type
=HNSW,


      lib=vsag,


      m=
16
,


      ef_construction=
200
);
每个参数的具体作用会在第 3 节进行说明。
如果需要在查询时修改查询参数,请参考 1.2 节相关内容。
IVF/IVFPQ 索引是基于磁盘(表)的索引,因此存储编码策略会影响索引性能。 建议在使用 IVF 索引时启用 CSEncoding 编码,需要在创建表时指定 ROW_FORMAT,并设置 BLOCK_SIZE
CREATE

TABLE
test
(


  id
bigint
(
20
)
NOT
NULL
,


  label
varchar
(
256
)
NOT
NULL
,


  embedding VECTOR(
768
)
DEFAULT
NULL
,


  PRIMARY
KEY
 (
id
)


) ROW_FORMAT = COMPRESSED;


create
/*+ parallel(16) */
 VECTOR
INDEX
 vec_idx


ON
test
(embedding)
with
 (


  distance=cosine,
type
=IVF_PQ, lib=OB,


  M=
384
, SAMPLE_PER_NLIST=
256
, NBITS=
8
, NLIST=
1000
)


block_size=
1048576
;
使用向量索引进行查询
使用向量索引进行查询的方法和使用其他索引有所不同,其他索引是通过 where 条件指定搜索范围,满足条件的数据会被精确的过滤出来。而 向量索引的用途是进行相关性的近似搜索,并按照向量距离值从小到大排序, 它并没有精确过滤的语义(虽然通过条件索引构建和查询参数,可以将召回率拉到 99% 以上)。因此使用索引查询时,必须使用如下语法:
select


  id, label,


  cosine_distance(embedding, @query_vector)
as
 distance


from
 test


order by distance approximate limit
10
;
需要注意的是, 如果不指定近似关键词 APPROXIMATE 或 APPROX,将不会使用向量索引,而是基于表上数据进行扫描和精确计算。
为过滤条件字段创建标量索引
在实际业务中,纯向量的查询不一定能满足需要,例如需要查询符合某些特定条件的数据,且需要按照向量的相似度来排序,这类场景就需要进行标量和向量的混合检索。在过去的系统中,因为数据库能力有限,需要分别进行向量和标量查询,这会带来 2 个方面的影响:
-
性能的衰退; -
可能带来召回率的下降。
例如先进行标量查询,再将查询出来的向量进行距离计算和排序,可能导致大量多余的向量计算,性能不佳。如果先进行向量搜索,则可能因为第一次的向量查询没有返回足够多的数据满足标量条件,导致有数据遗漏,从而引起召回率的下降。为解决召回率下降的问题,往往引入在外部的迭代查询,但在外部的迭代查询不能使用代价更低的执行计划以及在查询中不能叠加过滤,导致无意中扫描了更多的数据,也使得性能不佳。
OceanBase 自 4.3.5 版本开始实现标量和向量的混合检索,并支持在执行期间算法的自适应选择,优化器可以给出不同的执行计划,分别根据标量的过滤性和向量的过滤性,分别计算出每种执行计划的物理代价,从而选出最优的计划,从而可以保证尽可能高的性能和召回率,例如,当标量条件过滤性较好时,会自动选择前过滤算法。
使用标量过滤条件的方法是在向量索引查询中直接带上标量过滤条件 。OceanBase 为标量和向量的混合检索实现了多种查询算法,例如前过滤和迭代式过滤算法,可以保证尽可能高的性能和召回率。在 HNSW / HNSWSQ / HNSWBQ 索引上,还实现了执行期算法的自适应选择(IVF / IVFPQ 的自适应将在下个版本提供),这是为了应对代价估计和实际数据的差异,在查询执行时,OceanBase 也会通过执行中的统计信息来修正后续的执行流程。
select

id
, label, cosine_distance(embedding, @query_vector)
as
 distance


from

test


where

id
 <
1000

and
 label=
'red'


order

by
 distance approximate
limit

10
;
如果标量条件的选择性较好,OceanBase 会选择前过滤算法,并利用最佳的标量索引。因此在标量字段上创建索引可以加速查询性能。 例如对于上面的查询,假设 label='red' 能过滤掉大部分数据,比 id < 1000 的过滤性更好,可以在 label 列上创建标量索引。
CREATE

INDEX
 label_idx
on

test
(label);
创建完标量索引后,不需要对查询语句进行任何修改。
通过 hint 指定索引查询策略优先级
对于 HNSW / HNSWSQ / HNSWBQ 索引,hint 可以指定使用算法的优先级。这在一些标量和向量混合查询的场景能用来提高性能。OceanBase 具有计划缓存的能力,相同模式的 SQL 会命中同样的执行计划,对于向量索引来说,需要通过标量条件过滤性的好坏来选择不同的执行策略,如果已知某类查询,大部分场景下标量条件的过滤性非常好,那么可以指定向量检索优先使用前过滤算法,反之则使用迭代式过滤。
hint 语法与 index hint 相同,形式是
/*+index(表名 索引名)*/
。使用 approximate 关键词指定向量索引的查询时,如果 index hint 指定的索引名是标量索引,那么就优先使用前过滤;如果 index hint 指定的索引名是向量索引本身,则会优先使用迭代式过滤。
select

/*+index(test label_idx)*/


id
, label,


  cosine_distance(embedding, @query_vector)
as
 distance


from

test


where

id
 <
1000

and
 label=
'red'


order

by
 distance approximate
limit

10
;
通过 explain 可以观察到执行计划会显示自适应查询(前过滤):
select

/*+index(test vec_idx)*/

id
, label, cosine_distance(embedding, @query_vector)
as
 distance


from

test


where

id
 <
1000

and
 label=
'red'


order

by
 distance approximate
limit

10
;
通过 explain 可以观察到执行计划会显示自适应查询(迭代式):
对于 IVF/IVFPQ 算法同样可以通过 hint 进行指定,但定 hint 后执行方法就不再改变,IVF/IVFPQ 的自适应算法选择将在 435BP5 提供。
通过 PARAMETERS 调整查询参数
在使用 HNSW / HNSWSQ / HNSWBQ 索引进行查询时,可以通过 PARAMETERS 进行语句级的调整。当前支持的语句级查询参数包括 ef_search,refine_k(仅 HNSWBQ)
select


id
, label,


  cosine_distance(embedding, @query_vector)
as
 distance


from
test


where
id
 <
1000
and
 label=
'red'


order
by
 distance approximate
limit
10


PARAMETERS
 (ef_search=
200
);
除了在创建索引时指定查询参数,和通过 PARAMETERS 设置语句级查询参数,还可以通过 session 变量进行设置,例如 HNSW 索引可以 set ob_hnsw_ef_search = 100,IVF 索引可以 set ob_ivf_nprobes = 10;
参数的优先级从大到小是:PARAMETERS > Session 变量 > 创建索引时的参数。
各参数的作用将在本文第 3 节详细介绍。
向量索引内存相关配置
OceanBase 向量索引提供了向量索引内存相关的配置参数,主要是 ob_vector_memory_limit_percentage 和load_vector_index_on_follower,通常情况下使用默认值即可。
ob_vector_memory_limit_percentage
这个配置项用于控制向量索引能使用的内存占租户总内存的百分比。
4.3.5BP3 版本之前,这个配置项需要用户手动配置为大于 0 的值,否则不能使用向量索引功能,建议值是 30%。 从 4.3.5 BP3 开始,该配置项的默认值为 0,表示自适应模式,如无特殊需要,用户可以不再关注这一配置项。 自适应策略是:租户实际内存为 8 GB 及以下时,向量索引最多占用租户 40% 的内存;租户实际内存为 8 GB 以上时,向量索引最多占用租户 50% 的内存。为租户预留足够的内存,是为了保证其查询业务负载,或 DML 的稳定性。
ALTER

SYSTEM

SET
 ob_vector_memory_limit_percentage =
60
;
load_vector_index_on_follower
这个配置项从 4.3.5 BP3 才开始提供,用于指定 follower 是否自动同步加载内存向量索引,默认值为 true,follower 也会加载向量索引到内存中。关闭配置项之后,follower 上面的向量索引将不会自动加载到内存中。如果不需要弱读,可将此配置项关闭以减少向量索引占用的内存。
ALTER

SYSTEM

SET
 load_vector_index_on_follower =
false
;
配置项不会同步到备库,在主备库的场景下,主库和备库都需要单独设置。
索引类型选择
OceanBase 提供了多种向量索引算法,用户可以依据使用场景的不同选择合适的索引。
首先索引分为两大类:
-
基于图的 HNSW 索引及其量化索引 HNSW_SQ 和 HNSW_BQ; -
基于磁盘的 IVF 索引及其量化索引 IVF_PQ
图索需要常驻内存,但是性能会高于磁盘索引,磁盘索引在缓存足够的情况下也可提供较好的性能,极端情况下可以完全不依赖常驻内存。 在 OceanBase 中,可以通过以下 SQL 进行内存用量的估算。
SELECT
 dbms_vector.index_vector_memory_advisor、


  (
'HNSW'
,
1000000
,
768
,
'FLOAT32'
,
'M=16, DISTANCE=COSINE'
);


+
---------------------------------------------------------+


| dbms_vector.index_vector_memory_advisor                 |


|   ('HNSW',1000000,768,'FLOAT32','M=16,DISTANCE=COSINE') |


+
---------------------------------------------------------+


| Suggested minimum vector memory is 7.3 GB               |


+
---------------------------------------------------------+


1 row in
set
 (
0.004
 sec)
详细用法请参考:
-
INDEX_VECTOR_MEMORY_ESTIMATE [1] -
INDEX_VECTOR_MEMORY_ADVISOR [2]
以下对索引类型的选择给出建议。
HNSW用于高性能场景
内存图索引的性能会明显高于磁盘索引,但由于需要常驻内存,因此内存成本高,且需要数据总量动态平衡,如果数据明显增多则需要扩容。
-
内存足够的情况下(通常是百万级数据量)要求最高召回率和高性能,使用 HNSW 索引 -
内存较为充足的情况下(通常是百万~千万数据量)要求高召回和高性能,使用 HNSW_SQ 索引,占用内存约为 HNSW 索引的 1/4 ~ 1/3 -
内存相对数据量较少的情况下(通常是千万~亿数据量)要求高召回和较高性能,使用 HNSW_BQ 索引,占用内存约为 HNSW 索引的 1/30
这几种索引中 HNSW_SQ 的性能最高,HNSW 的召回率最高,但在标准数据集下都可以通过调节参数获得 99% 的召回率。具体参数作用会在下一节介绍。
IVF 用于高容量场景
磁盘索引用于高容量场景,可以做到完全不依赖常驻内存,对数据量非常大或者 只增不删的场景 ,如果性能可以满足需要,就建议使用磁盘索引。
-
IVF 索引的构建会相对更快,但构建过程中的内存占用也相对更高,相比 IVF_PQ 索引查询会慢一些,召回会更高。 -
IVF_PQ 索引的构建会慢一些,但构建过程中的内存占用也相对低,但比 IVF 的查询性能更高,召回率略低。
需要注意,高压缩率的量化算法,例如 HNSW_BQ 和 IVF_PQ,在低维向量下的召回率上限可能较低 ,建议 HNSW_BQ 使用在 512 维及以上的向量上,IVF_PQ 使用在 128 维及以上的向量上。
参数建议
|
|
|
|
|---|---|---|
|
(内存占用最多) |
|
|
|
(内存占用较少) |
|
千万数据量:m = 32,ef_construct = 400,ef_search = 350 |
|
(内存占用少,性能好) |
|
千万数据量:m = 32,ef_construct = 400,ef_search = 1000,refine_k=10 亿级数据量:使用分区表,m = 32,ef_construct = 400,ef_search = 1000,refine_k=10 |
|
(内存占用极少) |
|
千万数据量:nlist=3000, m=向量维度 / 2,nprobes = 20 亿级数据量:使用分区表,nlist=3000, m=向量维度 / 2,nprobes = 20 |
如果当前数据量较少,例如几百万,但是最终会达到千万级,可以按照最终的数据量来进行设置,对参数的详细解释以及调优在下面的章节进行介绍。
索引参数说明和调优
HNSW 及其量化算法参数说明
|
|
|
|
|
|
|
|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
ef_construction
必须大于 m |
|
|
|
|
|
|
|
|
|
|
|
|
|
如果查询时没有设置,则使用创建索引时的值; 如果查询时设置了,则使用查询时设置的值。 |
|
|
|
|
|
|
如果集群是从旧版本升级到 V4.3.5 BP3 版本,则该参数默认值为 fp32。 |
|
|
|
|
|
|
|
HNSW 类索引参数调优
不同索引类型对应不同的内存成本,性能和召回率指标。在不同的数据量下,推荐的索引构建和查询参数也不相同。本节给出百万和千万数据量下,768 维度向量,HNSW / HNSWSQ / HNSWBQ 索引的建议配置,以及同环境的测试结果共参考。对于亿级别的向量数据,请参考本文后续章节选用 IVFPQ 索引,或分区表下的 HNSWBQ 索引。可以按照最终数据量来配置索引参数。
百万级数据量
-
构建参数
m = 16,ef_construct = 200,HNSWBQ索引其它参数采用默认值。
-
内存占用
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
在分区表场景下,OB 会依据租户内存大小控制并发构建的分区数,因此对于 HNSWBQ 索引,可以配置租户内存为 HNSWBQ 索引查询时占用量 + 单分区 SQ 索引占用量。 细节请参考本文第 4 节。
-
召回率
放大 ef_search 和 refine_k(仅 HNSWBQ),可以通过更多的向量计算来提高召回率,但相应的会降低查询性能。在不同
TopN
下可将参数设置为下表中的建议值,如果需要进一步提升召回率,则可将参数值设置得更大一些。
注意,召回率和数据特征有直接关系,下表给出的是 768 维标准数据集下,召回率达到 0.95 左右的建议值。
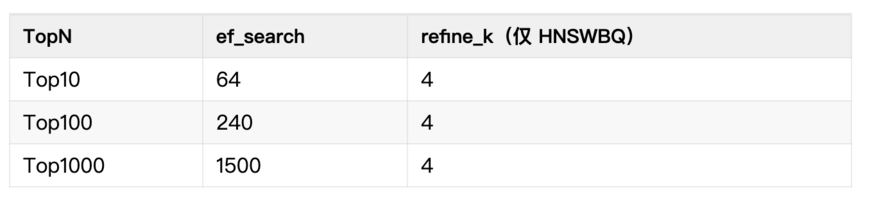
需要说明的是,几种索引算法的极限召回率不同,在本节设置建议的构建参数下,将 ef_search 设置为 1000,qps 会降低到 0.95 召回率下的 1/3,但能只有 HNSW 能达到 0.99 以上的召回率。BQ 索引可以通过进一步增加 refine_k 来提高召回率,但性能也会进一步下降。
-
使用 HNSW 索引,召回率是 0.991(ef_search=1000)
-
使用 HNSWSQ 索引,召回率是 0.9786(ef_search=1000)
-
使用 HNSWBQ 索引,召回率是 0.9897(ef_search=1000,refine k=10)
-
同参数下性能比较
本地相同环境下的性能测试对比:(检索 Top 100,ef_search = 240, HNSWBQ 中额外设置 refine_k = 4)
可以看到性能 HNSWSQ > HNSW > HNSWBQ
基础召回率(不带 filter) HNSW > HNSWSQ > HNSWBQ
带 filter 条件下,HNSW 在召回率整体上略高于 HNSWSQ,HNSWBQ 因在带 filter 场景下内部做了更多的向量查询和 refine,虽然 Recall 看上去较高,但是性能衰减也比前两种算法更大。
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
千万级数据量
-
构建参数
m = 32,ef_construct = 400,HNSWBQ 索引其它参数采用默认值。
-
内存占用
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
-
召回率
放大 ef_search 和 refine_k(仅 HNSWBQ),可以通过更多的向量计算来提高召回率,但相应的会降低查询性能。在不同 TopN 下可将参数设置为下表中的建议值,如果需要进一步提升召回率,则可将参数值设置得更大一些。
注意,召回率和数据特征有直接关系,下表给出的是 768 维标准数据集下,召回率达到 0.95 左右的建议值。
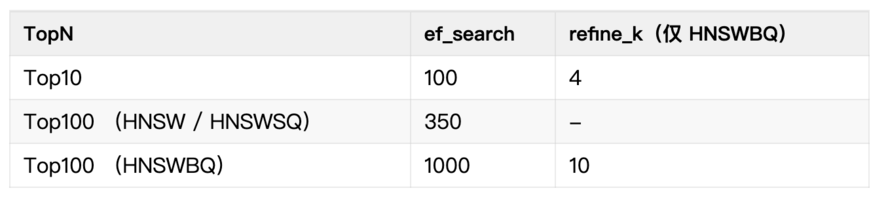
HNSWBQ 索引性能参考,测试机器和前面百万数据量相同(检索 Top 100,HNSW ef_search = 350,HNSW BQ ef_search = 1000,refine_k = 10)
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
亿级数据量
如果最终数据量会超过一亿,建议结合分区表来使用 HNSWSQ 或 HNSWBQ 索引,或者使用 IVF PQ 索引。
IVF及其量化算法参数说明
|
|
|
|
|
|
|
|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
IVF类索引参数调优
千万数据量
-
构建参数
-
IVF_FLAT -
NLIST = 3000 -
IVF_PQ -
NLIST = 3000,M = dim / 2
考虑平衡聚类中心个数以及每个聚类中心的数据量,一般建议采用 sqrt(数据量)作为 NLIST 的取值。在 IVFPQ 场景下,M 值取向量维度(dim)的一半即可。
如果是多分区表的场景,因为 IVF 索引目前都是 local index,每个分区会构建自己的 IVF 索引,所以建议根据平均数据量来估算 NLIST 的值。例如 1000W 768 维的场景,在 10 分区的情况下,平均每个分区是百万数据,那应该根据 sqrt(100w) = 1000 来设置 NLIST 的值。
-
内存占用
IVF 索引对内存的要求是比较低的,以 1000W 768 维场景为例子,采用推荐参数的情况下,内存开销可以参考下面的表格:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
其中表格中内存开销的构建开销部分的内存是指只有索引构建的过程中才会占用的内存,在完成索引构建之后就会释放掉。而常驻内存是指构建完成之后 IVF 向量索引会一直占用的内存大小。
对于 IVFPQ 来说,distance = l2 的情况下,会需要额外的内存来缓存预计算结果,对比 distance = ip / cos 的情况下会使用更多的常驻内存,所以一般情况下会更推荐使用 distance = ip / cos。
-
召回率
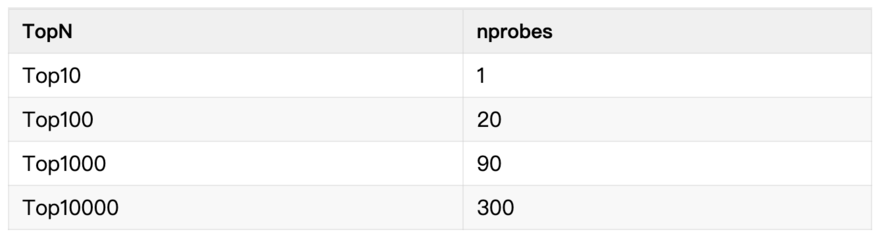
IVF 类索引的查询根据 nprobes 的取值来决定召回率以及性能。nprobes 越大,IVF 会搜索更多的聚类中心,计算更多的数据,召回率会越高,相应性能会降低。
在不同 TopN 下可将参数设置为下表中的建议值,预期可以得到 0.9 左右的召回率,如果需要进一步提升召回率,则可将参数值设置得更大一些。 注意,召回率和数据特征有直接关系,下表给出的只是标准数据集下的建议值。
亿级数据量
从上亿数据量开始,建议考虑采用分区表的场景来使用 IVF 类索引。因为随着数据量增加和 NLIST 的增大,单个 IVF 索引的查询开销会越来越大,拆分成多个分区,多个小数据量的 IVF 索引可以通过并行查询的方式来提升性能以及 recall。
-
构建参数
-
IVF_FLAT -
NLIST = 3000 -
IVF_PQ -
NLIST = 3000,M = dim / 2
IVF 索引是 local index,每个分区都会构造一个 IVF 索引,所以在多分区表的场景下,是使用分区数据量来设置参数,例如 1 亿 10 分区的场景,每个分区平均是 1000W 数据量,所以这里参数跟千万级数据量是一样的,是以分区数据量来设置构建参数。
-
内存占用
对于 IVF 的多分区的内存占用,由于 IVF 索引是 local index,每个分区都会构造一个 IVF 索引,所以对于常驻开销来,实际的内存占用需要乘上分区数,例如下面表格中的 IVF_FLAT,预估常驻内存是 10.5M,由于有 10 个分区,所以实际内存占用是 10.5 * 10 = 105 M。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
-
召回率
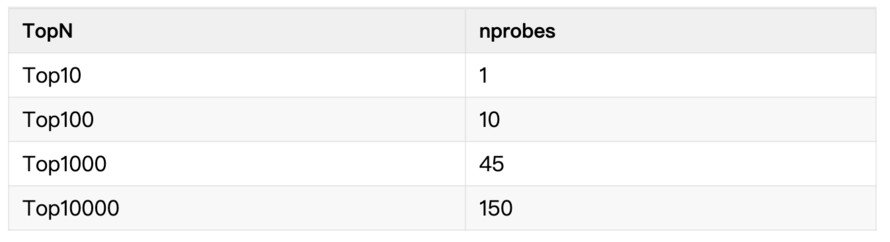
IVF 类索引的查询根据 nprobes 的取值来决定召回率以及性能。nprobes 越大,IVF 会搜索更多的聚类中心,计算更多的数据,召回率会越高,相应性能会降低。
在分区表场景,因为每个分区都是一个单独的 IVF 索引,所以查询如果落在了多个分区上面的话,实际上是每个分区单独做了一个 IVF 索引查询,返回了 TopN 条数据,然后汇总所有分区的结果再做一次 rerank,所以在实际准确率上面会比单分区场景更高,相应的可以用更低的 nprobes 达到和单分区表相同的召回率。
在不同 TopN 下可将参数设置为下表中的建议值,预期可以得到 0.9 左右的召回率,如果需要进一步提升召回率,则可将参数值设置得更大一些。 注意,召回率和数据特征有直接关系,下表给出的只是标准数据集下的建议值。
使用分区表
使用分区表的主要目的是为了解决大数据量的场景,其次是如果查询条件可以用于做分区建,那么通过分区裁剪可以提升查询性能。在以下两种场景下建议使用分区表:
-
数据量达到几千万或亿级以上。 -
查询条件中有明确的标量列可以用作分区裁剪。例如在前问所给的例子中,如果 label 字段总是会出现在 where 条件中,那么就可以考虑以 label 作为 key 分区创建分区表。
使用建议
-
分区划分
在使用向量索引时,分区并不是越多越好。向量索引不同于一般的标量索引,以 HNSW 索引为例,在相同配置参数下,包含 100W 向量的 HNSW 索引查询 TopK,和包含 200W 向量的 HNSW 索引查询 TopK,所需的计算代价比较接近。因此在不能进行分区裁剪的条件下,分区表的向量索引性能可能还不如非分区表。而过大的单分区,会使得索引重建变慢,与标量进行混合查询时的性能也会受一定影响。 因此在使用分区表时,建议将单个分区内的数据量维持在两千万以下,分区建优选选择可以做分区裁剪的列。
-
算法选择
在大数据量下建议选择 HNSWBQ 或 IVFPQ 索引,如需要使用其他索引,请按参考下面的内存占用进行估算。
-
内存占用
对于 HNSW 索引,HNSWBQ 索引,租户内存需要大于 HNSWBQ 索引查询时占用量 + 单分区 SQ 索引占用量 , 例如对于 1 亿数据 ,采用 10 分区,每分区内大致 1000 万向量。单分区需要 48GB 的构建内存,查询时十个分区的 HNSWBQ 占用 54GB 的内存,那么租户至少需要 102GB,考虑到部分增量数据不会实时量化压缩, 建议租户内存配置到 128GB。 其他数据量可以按此进行估计。
对于 IVF_FLAT,IVFPQ 索引,租户内存需要大于单个分区构建需要的内存 + 单分区常驻内存 * 分区数。例如对于 1 亿数据,采用 10 分区,每个分区大致 1000 万向量。单分区需要 2.7GB 的构建内存,查询时十个分区的 IVFPQ 占用 110M 内存,那么租户最少需要 3G 内存用户向量索引。这个场景下建议租户内存配置到 6G。其他数据量可以按此进行估计。
-
构建和查询参数
索引构建,查询参数按照单分区内的最大数据量来设定
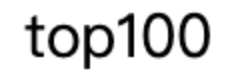
,对于 HNSW / HNSWSQ / HNSWBQ 索引请参考 3.1.1 节,对于 IVF / IVFPQ 索引请参考 3.2.1 节。例如对于 HNSWBQ 索引,1 亿向量,采用 10 分区,那么可以设置 m = 32,ef_construct = 400,查询
 是设置查询参数为 ef_search=1000,refine_k = 10。
-
性能和召回率
如果查询能分区裁剪到单分区,性能和召回率与单分区下的一致,请参考前文单分区下的情况。
如果不能完全裁剪到单分区,那么 qps 可以按照单 observer 节点上的分区数进行估计,例如 observer 上有 3 个分区,那么 qps 参考单分区性能降低到 1/3,由于查询了更多的候选结果,召回率会比单分区情况下高。
INDEX_VECTOR_MEMORY_ESTIMATE: https://www.oceanbase.com/docs/common-oceanbase-database-cn-1000000003532842
[2]INDEX_VECTOR_MEMORY_ADVISOR: https://www.oceanbase.com/docs/common-oceanbase-database-cn-1000000003532843
推荐阅读
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70047136/viewspace-3096454/ ,如需转载,请注明出处,否则将追究法律责任。

