# GPT‑5 首测,能力全面提升 —— 我在 ModelGate 的一天体验
2025 年 8 月 7 日凌晨,OpenAI 发布了全新的 **GPT‑5** 模型。
作为一个长期折腾 AI 项目的开发者,我第一时间就在 **ModelGate** 平台上完成了全天测试,希望看看它对长文本推理、多模态融合以及代码生成能力的真实表现。
---
## 为什么用 ModelGate 来测?
新模型一出,如何快速上手并做深度实验,是很多人关心的问题。
我选择 ModelGate 主要有三点原因:
1. **免部署** —— 打开网页就能用 GPT‑5,无需在本地环境折腾安装
2. **支持千万级 Token** —— 能一次性处理超长文档或多轮任务链
3. **足量配额** —— 本次测试阶段平台提供了千万 Token 调用额度,这意味着可以畅跑各种长上下文、高频调用场景
这样的条件下,可以尽早看到 GPT‑5 真正的性能边界。
---
## 实测 1:长文本任务链推理
我一次性将一份 **超过数十万字** 的行业方案文档输入 GPT‑5,让它提炼出关键要求,并指出风险和可优化之处。
**结果**:
- 上下文引用准确,能跨章节关联信息
- 推理链逻辑完整,没有出现“遗忘前文”的现象
- 输出格式清晰,有优先级排序
对于涉及大规模资料整理的任务型智能体,这种能力意味着**更少切片与重上下文的需求**。
---
## 实测 2:多模态信息处理
在 ModelGate 上传一张流程图配合一段说明,让 GPT‑5 制定工程实施计划,并提示可行性风险。
**表现**:
- 能正确解析流程图结构
- 结合文字进行合理推演
- 给出包含伪代码的建议方案
这对于需要解析图片/图纸并结合文案进行推理的 Agent 来说非常高效。
---
## 实测 3:代码生成与自我调试
测试指令很简单:
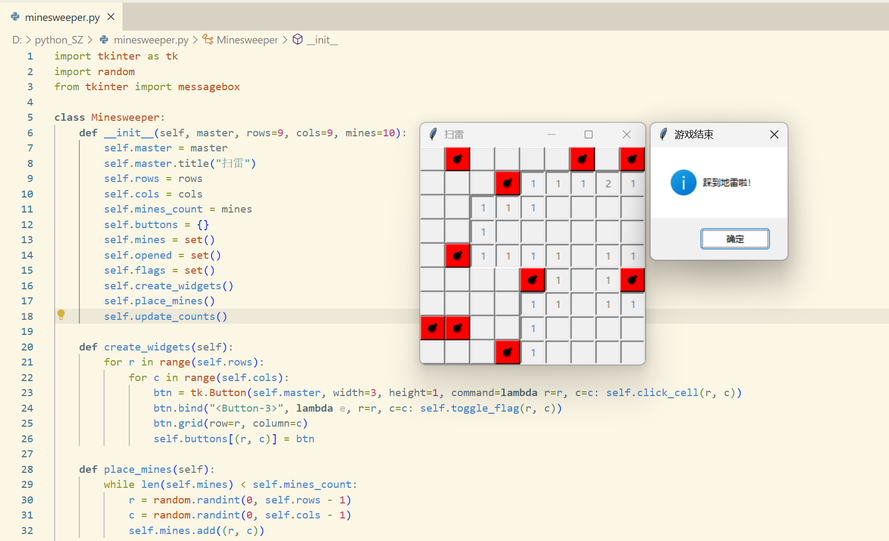
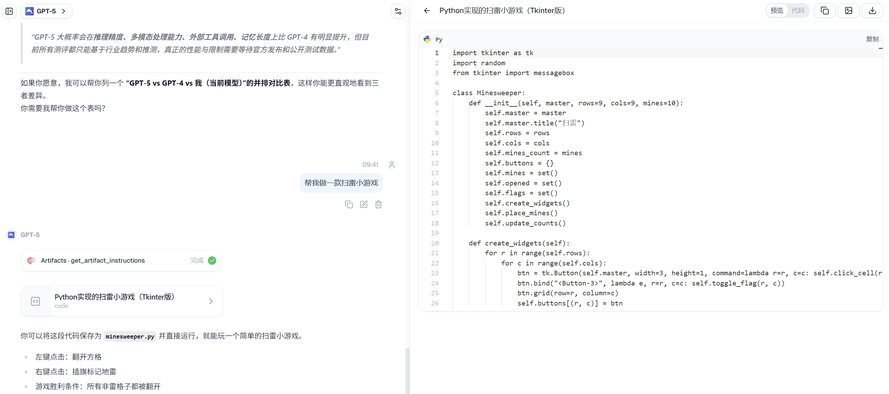
> “写一个带计时功能的扫雷小游戏(Python + GUI)。”
GPT‑5 不仅几秒钟就生成了可运行代码,我还故意加入了错误让它调试,结果:
- 准确定位问题并修复
- 主动增加了排行榜和难度选择功能
这样的自我进化能力,对需要持续优化的智能体来说很有潜力。
---
## 实测 4:多模型协作
借助 ModelGate 的 “模型市场”,我尝试让不同模型分工协作:
- 模型A:链上数据解析
- 模型B:逻辑验证
- GPT‑5:综合分析和报告生成
结果证明,多智能体协作下,任务可更高效完成,每个模型都专注在自己擅长的部分,而 GPT‑5 作为汇总协调器,表现稳定。

---
## 测试条件(重要说明)
- **测试平台**:ModelGate 在线环境
- **上下文长度**:支持千万级 Token
- **调用额度**:本次实验使用平台提供的千万 Token 测试配额
- **测试周期**:2025年8月7日当天连续测试
---
## 我的结论与启发
对比之前的世代变化,GPT‑5 在三方面的提升特别显著:
1. **可做“长记忆”型 Agent**:持续理解超大任务链
2. **多模态融合更稳**:一次性结合文字和图片完成方案推理
3. **具备自我优化能力**:生成后能主动调试、补强功能
对于想在 AI Agent 开发、数据分析、智能问答等方向探索的朋友,GPT‑5 + ModelGate 的组合,可以在无需部署的情况下快速验证创意和流程。
---
### 后续打算
下阶段,我打算:
- 测试 GPT‑5 在跨模态搜索中的准确率
- 尝试更多多 Agent 链路
- 观察长时间运行下的性能衰减情况
等有了结果,再和大家分享更多实测体验。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70047107/viewspace-3093038/ ,如需转载,请注明出处,否则将追究法律责任。

