自定义协议解码
抓到一段私有 / 自研的 socket 协议,内置格式都认不出、只剩一堆字节?自定义解码器让你 用一小段脚本教工具怎么读它——把连成一片的字节流切成一条条消息、剥掉协议头、需要时解压,剩下的交给工具自动识别成结构化。
这一篇面向要动手写解码器的用户,会把「函数怎么写、什么时候被调用、返回值代表什么」讲清楚。
一、它是什么:一个逐帧解码钩子
你写一个 解码钩子,工具把某条连接的字节喂给它,反复问一句话:「从这里开始,能切出一条完整消息吗?」你切出来一条、告诉它用掉了多少字节,它就用剩下的再问一次——直到切完。
如果你写过网络框架里的 累积式字节解码器,这就是同一套心智模型: 面对一条源源不断的字节流,自己决定消息边界。两点关键约定:
- 不用操心方向:一条连接的 发送流和 接收流,工具会分开各跑一遍你的钩子,并自动给每条切出来的消息标好方向。你的脚本只管「怎么切」。
- 切出来就不用管渲染:你 push 出去的每条消息,工具会 再做一次自动识别——里面是 protobuf / JSON / plist 就继续解成结构化。你只负责拆帧、剥头、解压。
二、解码函数:
decode(buf, out)
整个解码器就是一个函数:
1function decode(buf, out) {2 // buf: 当前待解析的字节流;out: 输出收集器;返回:这次消费掉的字节数3}
入参、出参、返回值——分别是什么
buf(入参)— 待解析的字节流
-
类型:
ArrayBuffer。内容是「从你上次消费结束的位置,到目前末尾」的全部剩余字节。 -
属性
buf.byteLength:当前还剩多少字节(每轮调用都可能变大——这一层就是让你判断「够不够切一条」)。 - 它是
原始字节缓冲,不是
Uint8Array, 不能直接下标取字节(buf[0]得到的是undefined)。读字节请用下面第三节的内置辅助(u8/u16be/sub…),或自己包一层视图:new Uint8Array(buf)、new DataView(buf)。
out(出参)— 输出收集器
- 类型:一个普通数组。
-
方法
out.push(消息字节):推出 一条消息;一次调用里可以 push 多条。 - 「消息字节」可以是:内置辅助返回的
ArrayBuffer(如sub(...)、gunzip(...)),或一个 字符串。其它类型会被忽略。
返回值 — 你消费了多少字节
-
类型:整数(
number),表示你从buf开头用掉的字节数。 -
> 0:吃掉开头这么多字节、切出了消息 → 工具丢掉它们,用 剩下的再调你一次。 -
0/ 不写return/ 返回负数:表示「开头还凑不齐一条完整消息」或「切不动了」→ 工具 停止循环,把剩余字节**原样(raw)**展示。 - 返回值会被 自动夹在缓冲长度以内(防越界),但请如实返回你真正用掉的字节数。
什么时候被调用(生命周期)
- 工具对一条连接的
发送流、
接收流各跑一遍。每一遍里,
decode会被 循环调用:每次把「剩余未消费的字节」交给你,你切一条、返回消费数,如此往复,直到你返回 0。 - 消息在「确认消费」之后才登场:只有当你返回 > 0,本次 push 的消息才会真正显示。 如果你 push 了却返回 0,循环停止、这次 push 会被丢弃——所以「推一条消息」一定要配上「返回它占了多少字节」。
- 循环结束后, 没被消费的尾部字节不会丢,会作为一条原始数据展示(比如最后半条不完整的消息)。
状态与幂等
- 每条流(方向)用一份 独立、全新的脚本环境;发送流和接收流互不串味。
- 需要跨多次调用记点状态(计数、上一条的类型……)时,把变量写在
decode外层即可——它在 同一条流的多次调用间保留,换方向或重新解码时重置。 - 解码是对 已经抓到的数据做的, 可以反复重解:改完脚本保存,再点一次就用新规则重跑同一条连接。
出错也不会搞砸
- 脚本抛异常、或单次执行超时,都会被当成「这次没消费」,剩余字节按原始数据展示—— 不会中断抓包、也不会丢数据。
- 换句话说:写坏了顶多是「没解开、看到原始字节」,不会把连接搞崩。放心大胆改。
- 而且
报错不会被吞掉:异常 / 超时会显示在结果上方的
调试输出面板里(见第五节),并标明来自发送
↑还是接收↓,照着改就是。
三、内置辅助(脚本里直接可用)
常见的取字节、读整数、转文本、解压都已内置,省得自己造:
| 类别 | 签名 | 说明 |
|---|---|---|
| 取子段 |
sub(buf, off[, len]) |
从
off 起截取(省略
len 则到末尾),返回
ArrayBuffer |
| 读整数 |
u8(buf, off) /
u16be /
u16le /
u32be /
u32le
(buf, off) |
按大端 / 小端读无符号整数 |
| 转文本 |
hex(buf) /
ascii(buf) |
转十六进制字符串 / 转文本 |
| 判压缩 |
gzipMagic(buf) |
是不是 gzip(返回布尔) |
| 解压 |
gunzip /
inflate /
unzstd /
lz4dtx
(buf) |
解压;解不动时原样返回,不报错 |
| 调试 |
log(...args) /
console.log(...args) |
打印到调试面板(见第五节) |
标准的字节读写能力(
DataView、
Uint8Array 等)也能直接用。
四、示例
① 长度前缀
[4 字节大端长度][负载] —— 最常见的私有协议形态:
1function decode(buf, out) {2 if (buf.byteLength < 4) return 0 // 长度头还没到齐,先等3 const total = 4 + u32be(buf, 0) // 整条 = 4 字节头 + 负载4 if (buf.byteLength < total) return 0 // 整条还没到齐,先等5 out.push(sub(buf, 4, total - 4)) // 剥掉头,把负载交给自动识别6 return total // 用掉这一条,接着切下一条7}
② 按分隔符 / 按行 —— 用换行等标志切帧:
1function decode(buf, out) {2 const i = ascii(buf).indexOf('\n')3 if (i < 0) return 0 // 还没遇到换行,等4 out.push(sub(buf, 0, i)) // 推这一行(不含换行)5 return i + 1 // 连换行一起消费掉6}
③ 整条一次性处理 —— 整条流当作一条消息,比如整包解压:
1function decode(buf, out) {2 out.push(gzipMagic(buf) ? gunzip(buf) : buf) // 是 gzip 就解开3 return buf.byteLength // 全部消费,循环随即结束4}
④ 按类型分派 —— 头里带个类型字段,不同类型不同处理:
1function decode(buf, out) {2 if (buf.byteLength < 4) return 03 const total = 4 + u32be(buf, 0)4 if (buf.byteLength < total) return 05 const type = u8(buf, 4) // 首字节是消息类型6 const body = sub(buf, 5, total - 5)7 out.push(type === 2 ? gunzip(body) : body) // 类型 2 是压缩过的8 return total9}
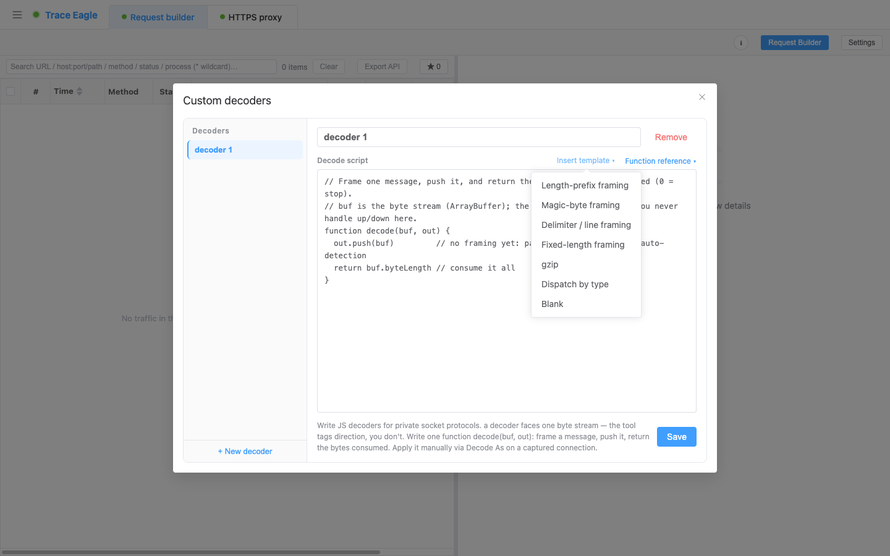
编辑器里这些套路都有 现成模板,插入一个改几个数字就能跑。
五、怎么用、怎么调
-
写与存:在解码器编辑器里新建、命名、保存;插入模板起步,内置函数随手有速查。
-
应用:抓到一条看不懂的连接,右键选「 解码为」→ 你写好的解码器,整条连接的收发立刻按你的规则拆开展示。
-
调试 / 看变量:在
decode里用log(...)或console.log(...)打印任意值——字节数、类型字段、hex(sub(buf, 0, 8))等等;输出会显示在「解码为」结果 上方的「调试输出」面板里,每行标着来自发送↑还是接收↓。脚本报错、超时也会显示在同一面板、同样标明方向。用它边打印边定位,比盲改快得多。沙箱里 没有浏览器 / Node 的
console全套——只有console.log和等价的log被接到这个面板;TextDecoder、fetch、setTimeout等都没有。要把字节读成文本用ascii(buf)。 -
边改边看: 不用重新抓包。脚本改完保存,再点一次「解码为」,同一条连接立刻用新规则重解——反复迭代,直到拆得满意。
-
接着看结构:解出来的每一段会 再交给自动识别,protobuf / JSON / plist 会被进一步解成结构化,配合 数据查看与解码 的多视图查看。
-
解码器可命名、保存成一份清单,随时新增、修改、删除。
六、什么时候用
- 抓到自研 / 私有的 socket 协议(常见形态:长度前缀 + protobuf / JSON / 二进制),内置格式都认不出时,写个解码器把它拆开、还原成可读结构。
- 想把一段裹着自定义头、或压过一道的字节,还原成能看懂的内容。
七、API 参考
集中速查:解码入口、内置辅助函数、运行环境。凡接收
buf 的函数,参数都接受
ArrayBuffer 或字符串。
解码入口
decode(buf, out) → number
| 作用 | 解码器的唯一入口,
必须实现。从
buf 头部切出消息、
push 到
out,返回本次消费的字节数。 |
buf |
ArrayBuffer —— 待解析的剩余字节流。用
buf.byteLength 看长度;
不能下标取字节,用下方辅助或
new DataView(buf) /
new Uint8Array(buf)。 |
out |
Array —— 输出收集器。
out.push(bytes) 推出一条消息(
bytes 为
ArrayBuffer 或字符串;其它类型忽略);一次可 push 多条。 |
| 返回 |
number —— 从
buf 头部消费的字节数。
> 0 继续;
0 / 负数 / 不返回 → 停止,剩余字节原样展示。 |
| 调用方式 | 对连接的发送流、接收流各跑一遍;每遍
反复调用,每次传入剩余未消费字节,直到返回
0。 |
内置辅助函数
取子段
| 签名 | 返回 | 说明 |
|---|---|---|
sub(buf, off) |
ArrayBuffer |
从
off 截到末尾 |
sub(buf, off, len) |
ArrayBuffer |
从
off 起截取
len 字节;
off /
len 越界自动夹紧,不报错 |
读整数(无符号;
off 越界时返回
0)
| 签名 | 返回 | 说明 |
|---|---|---|
u8(buf, off) |
number |
读 1 字节 |
u16be(buf, off) /
u16le(buf, off) |
number |
读 2 字节,大端 / 小端 |
u32be(buf, off) /
u32le(buf, off) |
number |
读 4 字节,大端 / 小端 |
转文本
| 签名 | 返回 | 说明 |
|---|---|---|
hex(buf) |
string |
转小写十六进制 |
ascii(buf) |
string |
按文本读出(适合 ASCII / 文本内容) |
压缩 / 解压(解不动时原样返回;单次解压上限约 16 MB)
| 签名 | 返回 | 说明 |
|---|---|---|
gzipMagic(buf) |
boolean |
是否以 gzip 魔数开头 |
gunzip(buf) |
ArrayBuffer |
gzip 解压 |
inflate(buf) |
ArrayBuffer |
zlib / deflate 解压 |
unzstd(buf) |
ArrayBuffer |
zstd 解压 |
lz4dtx(buf) |
ArrayBuffer |
分块 LZ4 流解压 |
调试
| 签名 | 返回 | 说明 |
|---|---|---|
log(...args) |
— | 把各参数拼成一行打印到「调试输出」面板;
ArrayBuffer 会以十六进制显示 |
console.log(...args) |
— | 同
log(方便习惯了
console.log 的人) |
运行环境
-
标准 JavaScript:
ArrayBuffer、定型数组(Uint8Array等)、DataView、JSON、Math、RegExp、Date等常见内置对象都可用——需要更底层地读写字节时,new DataView(buf)/new Uint8Array(buf)随手可用。 -
调试:
log(...)/console.log(...)打印到「调试输出」面板;脚本报错、超时也会打到那里,并标明来自发送↑还是接收↓。 -
不提供其余浏览器 / Node 专有能力:
console除log外的方法、TextDecoder/TextEncoder、fetch、setTimeout、require等均不可用。要把字节读成文本,用ascii(buf)。 - 每次
decode调用有 执行时间上限:死循环或超时会被中断、当作「未消费」,不会卡住工具。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70046796/viewspace-3179501/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- iOS如何解决苹果审核4.3问题(马甲包混淆)完整攻略
- 详细指南:如何在iOS设备上下载TestFlight上架的应用程序步骤解析
- 深入理解iOS性能监控:CPU、内存与FPS监控原理详解
- 怎么在 Windows 上用 GameMaker 打包 iOS 游戏并上架 App Store?
- JA3/JA4 指纹是什么?改了 UA、换了 IP 还是被认出来的问题所在
- iOS开发编程软件推荐:从Xcode到Kxapp,5款常用工具详解
- FlutterBoost代码混淆与加固终极指南:保护你的混合应用安全
- Swift开发环境搭建指南 快速配置iOS开发环境
- 怎么给 Cordova / Capacitor / Ionic 项目签名打包成 iOS 应用并上架 App Store?
- iOS 开发时如何使用 AI 编程助手,VS Code 开发 Swift
