智能体(AI Agent)开发实战之【LangChain】(三)基于RAG实现本地知识库问答优化
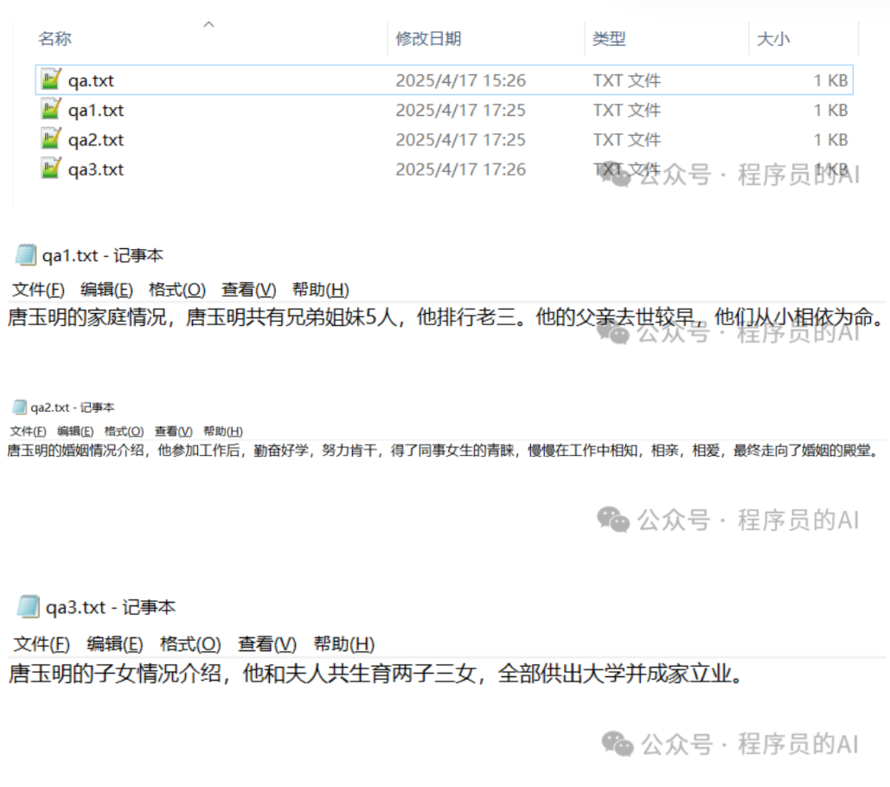
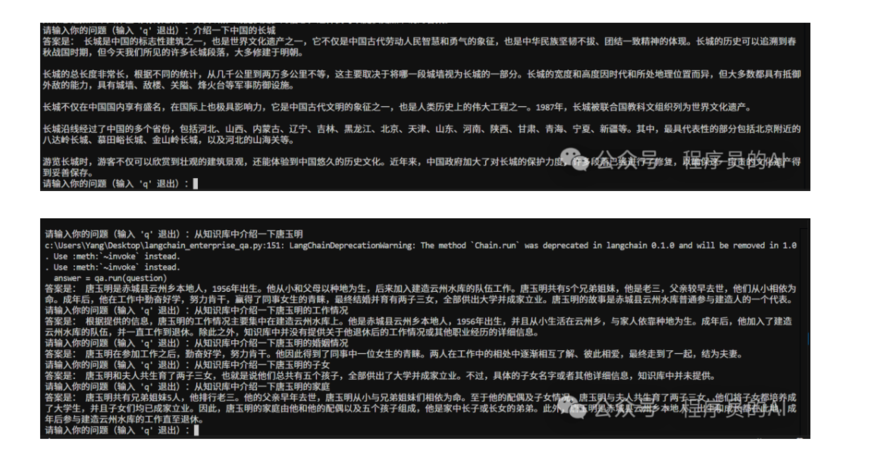
上一篇介绍了基于RAG实现简单的知识库问答功能,使用了两个向量数据库Chroma和FAISS,测试了功能情况。这篇文章继续优化,引入开源嵌入大模型all-MiniLM-L6-v2,并改造为先用大模型回答,再根据问题关键词从内部 知识库查询问答结果。
一、
嵌入大模型all-MiniLM-L6-v2介绍
1.创建 HuggingFaceEmbeddings实例
model_path = r"E:\models\all-MiniLM-L6-v2"
model_kwargs = {'device': 'cpu'}
encode_kwargs = {'normalize_embeddings': True}
embeddings = HuggingFaceEmbeddings(
    model_name=model_path,
    model_kwargs=model_kwargs,
    encode_kwargs=encode_kwargs
)
# 使用 Chroma 创建向量数据库并存储文档向量vectorstore = Chroma.from_documents(docs, embeddings)
2.问答优化
# 获取用户输入的问题
question = input("请输入你的问题(输入 'q' 退出):")
   if question.lower() == 'q':
      break
   else:
      if "知识库" not in question:
          response = chat_model.invoke(question)
          print("答案是:", response.content)
      else:
           answer = qa.run(question)
           print("答案是:", answer)
运行效果如下图所示:
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70046654/viewspace-3088665/ ,如需转载,请注明出处,否则将追究法律责任。

请登录后发表评论
登录
全部评论
