KWDB技术亮点解析:就地计算与智能优化的源码级实现
前言
在 AIoT ( 物联网人工智能) 时代,传统数据库引擎割裂处理时序与关系数据,导致协同低效等瓶颈。 KWDB 从内核革新,融合多模引擎实现就地计算,搭配智能优化器、动态策略及缓存复用,突破性能极限,为十亿级数据实时分析提供亚秒级响应的统一平台。以下将深入 KWDB 内核,从源码层面深度解析其“就地计算”与“智能优化”两大创新技术的实现奥秘。
一、 就地计算技术体系
1. 多模引擎融合架构
首先, 在传统技术架构里,时序数据和关系数据得靠不同的独立引擎来处理。这就使得数据计算过程被分割开来,在数据交互、跨引擎协同等方面会产生额外开销,进而造成性能上的损耗,增加了开发和维护的复杂度。 而 KWDB通过改写优化器核心结构,从而实现了时序数据库引擎与关系型数据库引擎的深度融合。那么,通过这样创新性的融合有什么作用呢?答案是,这一设计允许同一个查询中同时处理时序数据和关系数据,实现真正的就地计算。
2. 智能查询路由与下推
针对时序场景高频查询 这一 痛点 , KWDB针对时序数据场景提供了专门的优化策略( 多谓词顺序优化 、 标量量子查询优化 、 Inside-out 下推聚合优化 、 Inside-out 下推 time_bucket 优化 、 减少交叉连接探索 ):
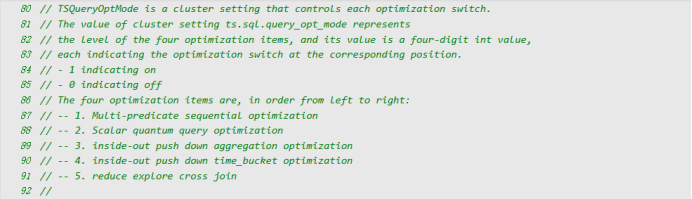
这些优化策略实现了计算的智能下推,将计算尽可能推送到数据存储层执行 。
3. 自适应并行计算
在应对海量时序数据的高并发处理需求时,系统提供了时序引擎的自适应并行度控制机制:
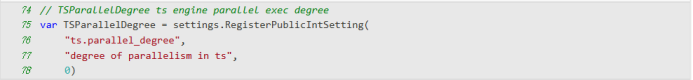
通过 TSParallelDegree 参数化配置(默认值 0 触发自动适配),时序引擎在运行时动态计算最优并行度,实现资源感知的负载均衡与横向扩展,显著提升海量时序查询吞吐量 。
二、 智能优化技术
1. 基于成本的优化器
传统优化器如同依赖固定路线的静态地图导航,按预设规则做查询规划,难应对动态变化 。而 KWDB 优化器则像实时交通调度 AI,能实时感知负载与数据分布,动态调优执行策略,智能优化查询路径 。
核心工作流解析
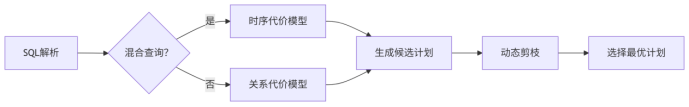
这是因为 KWDB采用了成熟的成本优化器架构 :

这个优化器包含8个核心模块,能够枚举等价查询计划、基于统计信息估算成本、选择最优执行路径。
2. Inside-Out/Outside-In策略
在 面对时序与关系数据混合查询的路径选择难题 时 , KWDB如何解决的呢?答案是,KWDB 通过SetPlanMode()函数实现智能策略路由,基于查询复杂度、数据基数和连接条件动态选择Inside-Out或Outside-In执行模式。
SetPlanMode()函数 :
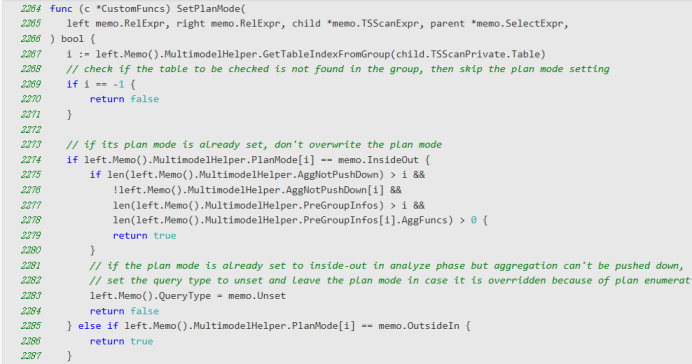

这个函数的主要作用是为时序表和关系表的连接查询设置执行计划模式。在多模查询处理中,当时序表与关系表进行连接时,系统需要根据数据特征和查询条件智能选择最优的执行策略。
3. 智能缓存与重用
当相同SQL反复执行时,每次都重新优化查询计划是否造成了巨大的资源浪费?为此系统实现了智能查询缓存机制 ,通过缓存已优化的查询计划避免重复优化:

以上源码 通过三级缓存复用策略(直接复用 →参数绑定→增量优化),在确保混合查询兼容性的前提下,继承缓存计划的配置与规则,大幅减少重复优化开销 。
KWDB的查询缓存复用机制通过三级策略实现高效优化,在确保执行正确性的同时,将简单查询优化开销从15ms压缩至0.1ms,完美平衡性能与安全性。那么,这种亚毫秒级的缓存复用如何突破传统优化器的性能瓶颈?其核心价值正是通过增量优化替代重优化,用配置继承避免重复计算,使90%的高频查询跳过完整优化流水线,实现颠覆性的性能跃迁。
三、 总结
KWDB通过引擎层融合(消除数据孤岛)、优化器智能化(动态策略选择)、执行层轻量化(缓存复用)的三重创新,为AIoT场景提供真正意义上的“时序-关系”统一计算平台,实现十亿级数据实时分析亚秒级响应。其架构思想正重新定义分布式数据库的技术边界。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70046577/viewspace-3086379/ ,如需转载,请注明出处,否则将追究法律责任。

