【关键词】复合索引、IN 参数、执行计划、性能调优
【问题描述】
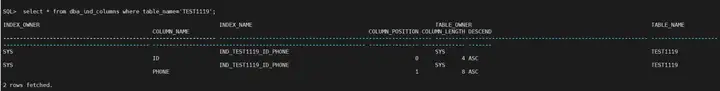
测试表数据量约 200 万,在 ID 和 PHONE 字段上建立了复合索引:
CREATE INDEX IND_TEST1119_ID_PHONE ON TEST1119(ID, PHONE);执行以下 SQL 时性能较差:
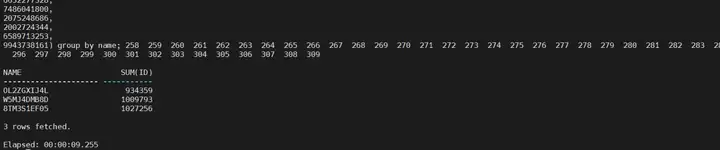
SELECT name, SUM(id)
FROM test1119
WHERE id > 50000 AND phone IN (…大于300个参数…)
GROUP BY name;
尝试使用 NO_INDEX_FFS HINT 后依然无效,执行时间仍然偏长。
【问题分析】
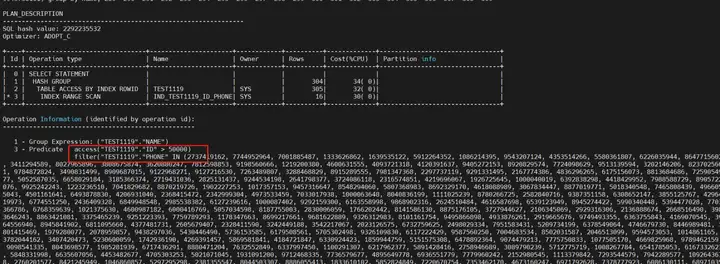
通过执行计划分析发现:
优化器使用了复合索引;
先用索引过滤 id > 50000.再对 phone in (...) 进行 filter;
因 in 参数过多,过滤代价过高,导致性能下降;
无法通过 hint 强制规避执行路径问题。
【解决思路】
复合索引的顺序会影响执行计划的使用策略。若 id 在前、phone 在后,则优化器优先处理 id 过滤条件。
但本场景下,phone in (...) 是主过滤条件,应将其放在复合索引前面。
【推荐做法】
步骤一:将原有复合索引设为不可见
ALTER INDEX IND_TEST1119_ID_PHONE INVISIBLE;步骤二:新建以PHONE 为首的复合索引
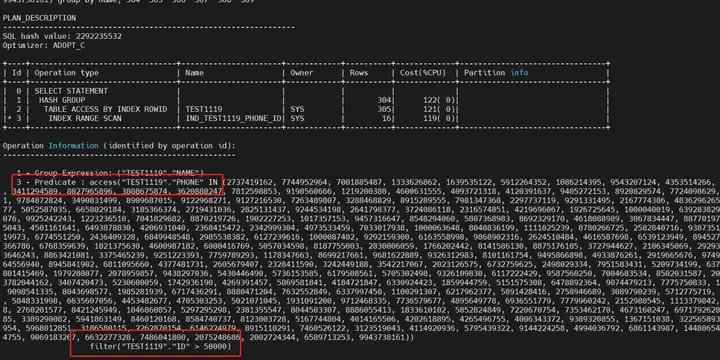
CREATE INDEX IND_TEST1119_PHONE_ID ON TEST1119(PHONE, ID);步骤三:观察执行计划变化
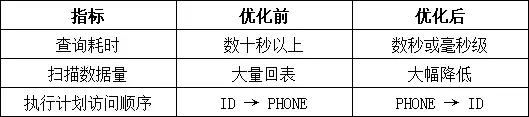
此时执行计划将优先按 phone in (...) 条件定位,再结合 id > 50000 筛选,命中数据量显著减少,性能提升明显。
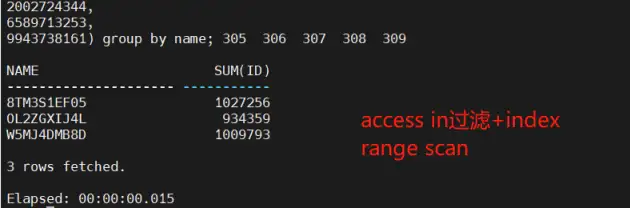
【实测效果对比】
【适用版本】
问题存在于 YashanDB 所有当前版本;
建议提前设计索引顺序,提升 IN 大量过滤场景的响应效率。
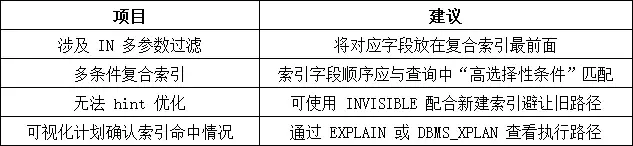
【总结建议】
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70045450/viewspace-3084067/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- YashanDB|YAS-02605:不是 Master 节点无法执行恢复?共享集群下的角色限制
- YashanDB|YAS-02547:归档恢复报错“日志存在间断”?归档序号不连续所致
- YashanDB|YAS-02507:执行增量备份失败?缺少基础备份
- YashanDB|YAS-02287:审计策略无法删除?因为还在启用中
- YashanDB|报错 YAS-00402:failed to connect socket?可能是监听地址设置问题
- YashanDB 登录提示账户被锁?快速解锁 sys 用户的方法
- Python 查询 GBK 编码的 YashanDB CLOB 字段数据被截断的原因与修复
- YashanDB 使用 listagg 报 YAS-02511 的原因及解决方案
- YashanDB 使用 imp 导入时报 YAS-08023 的原因与处理办法
- 通过 JDBC 向 YashanDB 批量插入空间数据的标准写法
