YashanDB|用 yasldr 批量导入时报内存不足?一文搞懂 bulkload 内存分配逻辑
【问题背景】
某现场在通过 yasldr 工具将 NewCIS 报表数据(约 300GB)导入 YashanDB 分布式环境时,遇到频繁报错:
failed to allocate 6812396 bytes memory quota for init bulkload quota导入任务中断,影响测试与业务数据入库。
【环境信息】
YashanDB 版本:23.2.4.100 Enterprise Edition
部署拓扑:1mm + 1cn + 3dn
硬件配置:125GB 内存 / 32 核 CPU / 2TB HDD
导入方式:yasldr,单进程、32线程、bulkload 模式
【问题分析】
bulkload 模式下的内存分配逻辑
每个导入线程能使用的内存大小受以下公式控制:
可用总内存 = COLUMNAR_MATERIAL_PERCENT × COLUMNAR_VM_BUFFER_SIZE × BULKLOAD_MAX_MEM_PERCENTCOLUMNAR_VM_BUFFER_SIZE = 19375MB(配置)
COLUMNAR_MATERIAL_PERCENT = 80%(默认)
BULKLOAD_MAX_MEM_PERCENT = 80%(默认)
即:
总可用内存 = 80% × 19375M × 80% ≈ 12400MB在设置 8 个 yasldr 实例、每实例 32 个线程时,总线程数达:
8 × 32 = 256平均每个线程的内存仅为:
12400MB / 256 ≈ 48.4MB这远远无法满足高数据密度(如每行 20KB)的批量写入。
【规避建议】
方法一:降低线程数量
减小 yasldr 启动时的线程数,如控制在 8~16 以内,可显著提升单线程可分配内存。
方法二:调大内存参数(推荐)
可在导入前调整以下参数:
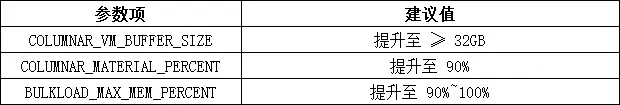
根据资源情况灵活设置, 建议每线程内存不得低于 300MB,否则容易因数据行较大而失败。
【实时监控建议】
YashanDB 提供视图 dV$bulkloadStat 可用于观察当前导入线程状态、资源占用、异常计数等,便于动态排查。
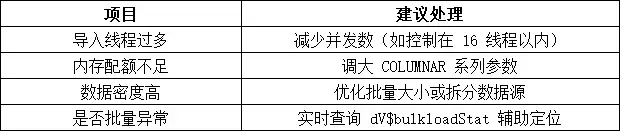
SELECT * FROM dV$bulkloadStat;【总结】
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70045450/viewspace-3083762/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- YashanDB|YAS-02605:不是 Master 节点无法执行恢复?共享集群下的角色限制
- YashanDB|YAS-02547:归档恢复报错“日志存在间断”?归档序号不连续所致
- YashanDB|YAS-02507:执行增量备份失败?缺少基础备份
- YashanDB|YAS-02287:审计策略无法删除?因为还在启用中
- YashanDB|报错 YAS-00402:failed to connect socket?可能是监听地址设置问题
- YashanDB 登录提示账户被锁?快速解锁 sys 用户的方法
- Python 查询 GBK 编码的 YashanDB CLOB 字段数据被截断的原因与修复
- YashanDB 使用 listagg 报 YAS-02511 的原因及解决方案
- YashanDB 使用 imp 导入时报 YAS-08023 的原因与处理办法
- 通过 JDBC 向 YashanDB 批量插入空间数据的标准写法
