YashanDB|Kettle 同步大表报错 “无法创建 Java 虚拟机”?别忘了调整内存
【问题描述】
在使用 Kettle(Pentaho Data Integration)进行大表数据同步时,部分用户遇到如下错误:
ERROR: Could not create the Java Virtual Machine!该错误通常在启动 .ktr 或 .kjb 任务执行文件(如 pan.sh / kitchen.sh)时出现,导致整个数据同步流程无法进行。
【问题原因】
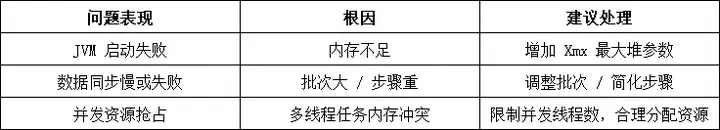
该报错说明: JVM 内存不足,虚拟机无法启动。
这在同步超大数据表或并发量较高任务时较常见,特别是未手动分配足够堆内存时,容易触发默认 JVM 限制。
【解决方法】
方法一:增加 JVM 堆内存(推荐)
打开 Kettle 启动脚本配置:
Windows:Spoon.bat
Linux:pan.sh / kitchen.sh
修改或新增如下配置(以设置最大堆为 2G 为例):
set PENTAHO_DI_JAVA_OPTIONS="-Xms1024m" "-Xmx2048m" "-XX:MaxPermSize=512m" "-Dfile.encoding=UTF8"-Xms:初始堆大小
-Xmx:最大堆大小
MaxPermSize:方法区大小(JDK 8 可省略)
UTF8:避免中文乱码
提示:根据服务器内存情况合理设置,一般推荐至少为 1G~2G。
方法二:优化同步转换设计
减少中间步骤,简化流程;
控制每批处理的数据量(batch size);
避免对全表做无筛选读取操作;
尽量使用“表输入 + 表输出”直通流模式,减少缓存开销。
方法三:配置并发线程数
在命令行执行同步任务时,可以通过 PARALLELISM 参数控制并发线程数量,避免因线程数过多造成资源抢占:
time PENTAHO_DI_JAVA_OPTIONS=-DPARALLELISM=4 sh /home/kettle/data-integration/pan.sh \
-file=/home/kettle/data-integration/test/dir_ktr1/public.T1.ktr \
> /home/kettle/data-integration/test/logs1/public.T1.log
PARALLELISM=4 表示使用 4 个并行线程;
该参数适用于多表同步、分区任务等。
【适用版本】
适用于所有版本的 Kettle + YashanDB 组合使用场景;
无需修改 YashanDB,本问题发生于 Kettle 层。
【总结建议】
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70045450/viewspace-3083650/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- YashanDB|YAS-02605:不是 Master 节点无法执行恢复?共享集群下的角色限制
- YashanDB|YAS-02547:归档恢复报错“日志存在间断”?归档序号不连续所致
- YashanDB|YAS-02507:执行增量备份失败?缺少基础备份
- YashanDB|YAS-02287:审计策略无法删除?因为还在启用中
- YashanDB|报错 YAS-00402:failed to connect socket?可能是监听地址设置问题
- YashanDB 登录提示账户被锁?快速解锁 sys 用户的方法
- Python 查询 GBK 编码的 YashanDB CLOB 字段数据被截断的原因与修复
- YashanDB 使用 listagg 报 YAS-02511 的原因及解决方案
- YashanDB 使用 imp 导入时报 YAS-08023 的原因与处理办法
- 通过 JDBC 向 YashanDB 批量插入空间数据的标准写法
