前言
在衡量数据库性能的诸多指标中,插入数据的能力占据着举足轻重的地位。插入数据是数据库最基本也是最频繁的操作之一,它就像人体的呼吸,顺畅与否直接关系到整个系统的生命力。一个插入能力卓越的数据库,能够迅速高效地将源源不断的数据纳入其中,为后续的查询、分析等操作奠定坚实基础。相反,若数据库在插入数据时表现不佳,出现延迟、卡顿甚至崩溃等问题,那么即使它在其他方面具备一定优势,也难以满足现代业务对数据实时性和高效性的要求。
前置文章:
1、安装裸机版本kwdb: https://blog.itpub.net/70045375/viewspace-3079855/
2、使用KDC连接kwdb: https://blog.itpub.net/70045375/viewspace-3080324/
关系型数据库准备
这里我们先创建一个数据库,再创建对应的表,我这里留下DDL语句,方便实用。
DDL:
CREATE DATABASE save_shop;
use save_shop;
CREATE TABLE IF NOT EXISTS users (
    user_id BIGSERIAL PRIMARY KEY,
    username VARCHAR(50) NOT NULL UNIQUE,
    password VARCHAR(255) NOT NULL,
    email VARCHAR(100),
    phone VARCHAR(20),
    status SMALLINT DEFAULT 1,
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
    updated_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
    CONSTRAINT chk_status CHECK (status IN (0, 1))
);
COMMENT ON TABLE users IS '用户表';
COMMENT ON COLUMN users.status IS '1:正常,0:禁用';
CREATE INDEX idx_username ON users (username);
CREATE INDEX idx_email ON users (email);
CREATE INDEX idx_phone ON users (phone);
运行效果
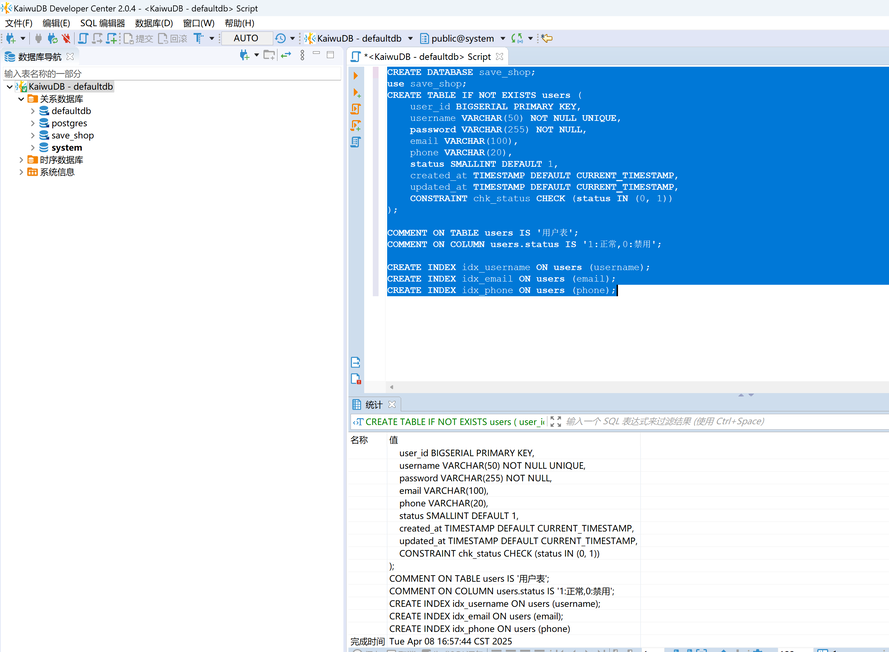
SQL准备
基础测试语句
INSERT INTO users (username, password, email, phone, status)VALUES ('admin', '123123', '123@123.com', '15512345678', 1);
select * from users;
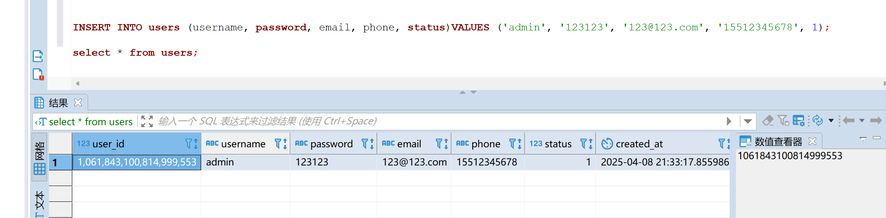
插入是没有问题的,写一个存储过程看看。
存储过程
-- 创建一个函数来插入 100 万条随机数据
CREATE OR REPLACE FUNCTION insert_million_users()
RETURNS void AS $$
DECLARE
    counter INTEGER := 0;
BEGIN
    -- 开始一个循环,插入 100 万条数据
    WHILE counter < 1000000 LOOP
        INSERT INTO users (username, password, email, phone, status)
        VALUES (
            -- 生成随机用户名
            'user_' || counter,
            -- 生成随机密码,这里简单用 123456 替代,可根据需求修改
            'password_' || counter,
            -- 生成随机邮箱
            'user_' || counter || '@example.com',
            -- 生成随机电话号码
            '1' || lpad((random() * 999999999)::text, 9, '0'),
            -- 随机生成状态(0 或 1)
            floor(random() * 2)::smallint
        );
        counter := counter + 1;
    END LOOP;
    RETURN;
END;
$$ LANGUAGE plpgsql;
-- 调用函数
SELECT insert_million_users();
-- 查询插入的数据
SELECT * FROM users LIMIT 10;
发现不支持:
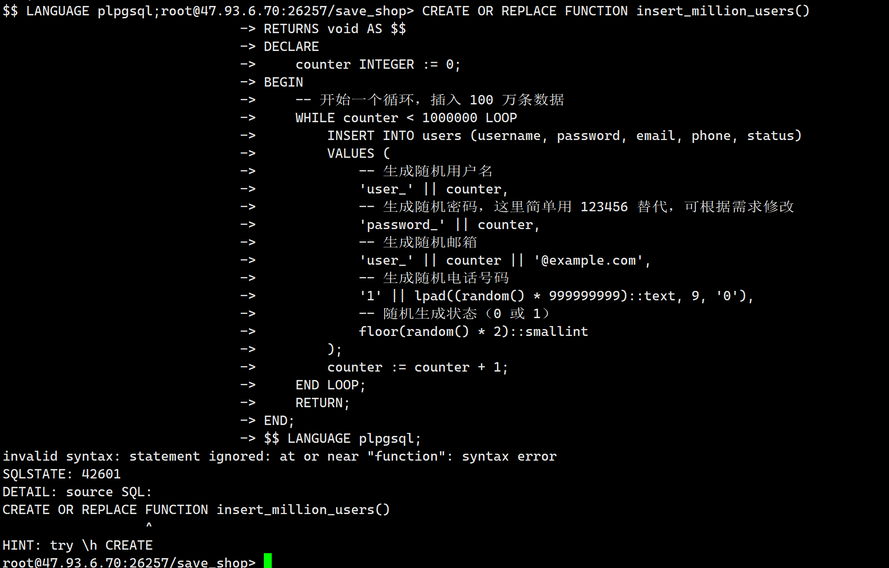
并且我在官网上查询了,发现是没有存储过程这个信息的。
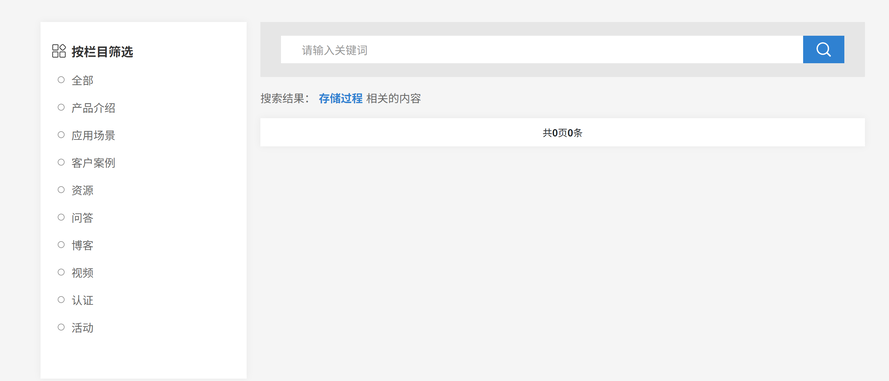 不能使用存储过程我尝试着使用函数试试,但是也发现没有,所以我们就只能换路子了。
Python代码准备
这里的环境挺麻烦,我搞了好几回,终于搞定了。
我这里使用的是psycopg2来操作的,因为3有一个包我始终没安装成功。这里单独介绍一些psycopg2.
Psycopg 是 PostgreSQL 数据库适配器,专为 Python 编程语言而设计。Psycopg 完全遵循 Python DB API 2.0 规范,支持线程安全,允许多个线程共享同一连接,特别适合高并发和多线程的应用场景。
KWDB 支持用户通过 Psycopg 2 连接数据库,并执行创建、插入和查询操作。本示例演示了如何通过 Psycopg 2 驱动连接和使用 KWDB。
本示例使用的 Python 版本为 Python 3.10。
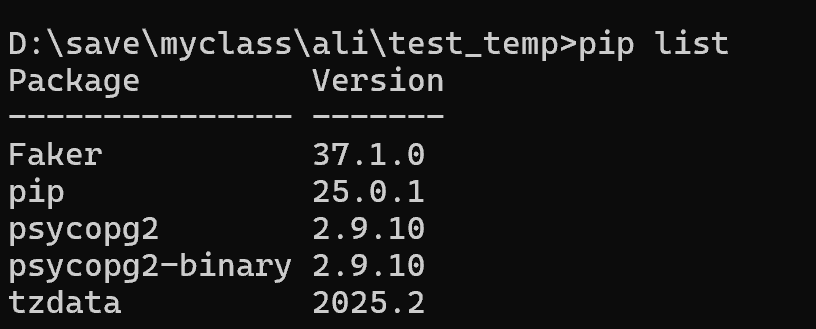
环境需求:
命令:
pip install faker
pip install psycopg2
pip install psycopg2-binary
代码:
#!/usr/bin/env python3
# -*- coding: UTF-8 -*-
import psycopg2
import random
import string
from faker import Faker
# 初始化 Faker 实例,用于生成随机数据
fake = Faker()
def main():
    try:
        con = psycopg2.connect(database="save_shop", user="root", password="your pwd", host="47.93.6.70",port="26257")
        print("Connected!")
        con.set_session(autocommit=True)
        cur = con.cursor()
    except psycopg2.Error as e:
        print(f"Failed to connect to Kaiwudb: {e}")
    try:
    # 生成随机用户名
        username = ''.join(random.choices(string.ascii_lowercase, k=8))
        # 生成随机密码
        password = ''.join(random.choices(string.ascii_letters + string.digits, k=12))
        # 生成随机邮箱
        email = fake.email()
        # 生成随机电话号码
        phone = fake.phone_number()[:20]
        # 随机生成状态(0 或 1)
        status = random.randint(0, 1)
        # 插入数据的 SQL 语句
        insert_query = """
        INSERT INTO users (username, password, email, phone, status)
        VALUES (%s, %s, %s, %s, %s);
        """
        cur.execute(insert_query, (username, password, email, phone, status))
    except psycopg2.Error as e:
        print(f"Failed to insert data: {e}")
    sql = "SELECT * from save_shop.users"
    try:
        cur.execute(sql)
        rows = cur.fetchall()
        for row in rows:
            print(row)
    except psycopg2.Error as e:
        print(f"Failed to insert data: {e}")
    cur.close()
    con.close()
    return
if __name__ == "__main__":
    main()
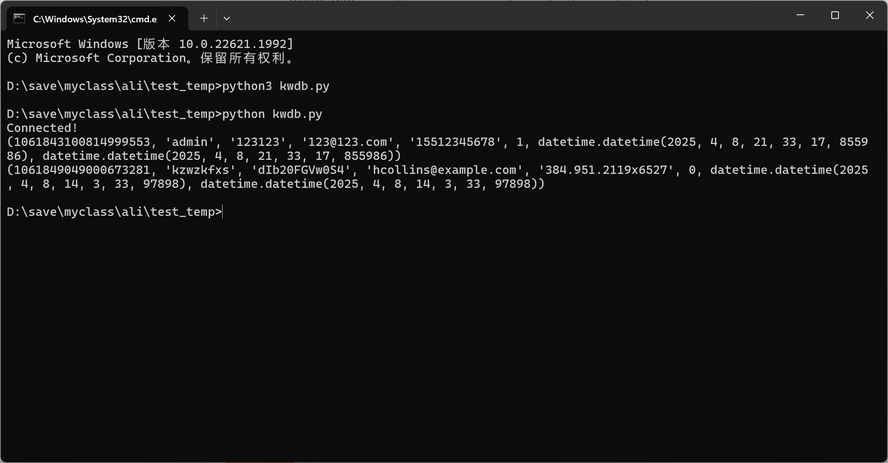
测试效果:
百万输入插入,这里要改一下代码:
#!/usr/bin/env python3
# -*- coding: UTF-8 -*-
import psycopg2
import random
import string
from faker import Faker
import time
# 初始化 Faker 实例,用于生成随机数据
fake = Faker()
def main():
    try:
        con = psycopg2.connect(database="save_shop", user="root", password="qwe8403000",
                               host="47.93.6.70", port="26257")
        print("Connected!")
        con.set_session(autocommit=True)
        cur = con.cursor()
    except psycopg2.Error as e:
        print(f"Failed to connect to the database: {e}")
        return
    insert_query = """
    INSERT INTO users (username, password, email, phone, status)
    VALUES (%s, %s, %s, %s, %s);
    """
    start_time = time.time()
    try:
        for _ in range(10000):
            # 生成随机用户名
            username = ''.join(random.choices(string.ascii_lowercase, k=8))
            # 生成随机密码
            password = ''.join(random.choices(string.ascii_letters + string.digits, k=12))
            # 生成随机邮箱
            email = fake.email()
            # 生成随机电话号码
            phone = fake.phone_number()[:20]
            # 随机生成状态(0 或 1)
            status = random.randint(0, 1)
            cur.execute(insert_query, (username, password, email, phone, status))
            end_time = time.time()
            elapsed_time = end_time - start_time
            print(f"{_} 条.")
        print(f"共計:{elapsed_time:.2f} 秒.")
    except psycopg2.Error as e:
        print(f"Failed to insert data: {e}")
    try:
        sql = "SELECT * FROM users LIMIT 10"
        cur.execute(sql)
        rows = cur.fetchall()
        for row in rows:
            print(row)
    except psycopg2.Error as e:
        print(f"Failed to query data: {e}")
    cur.close()
    con.close()
if __name__ == "__main__":
    main()
我这里的代码大家能看到,我加了万次的循环以及时间的获取。
慢慢插入中,这里就一个字,等了。
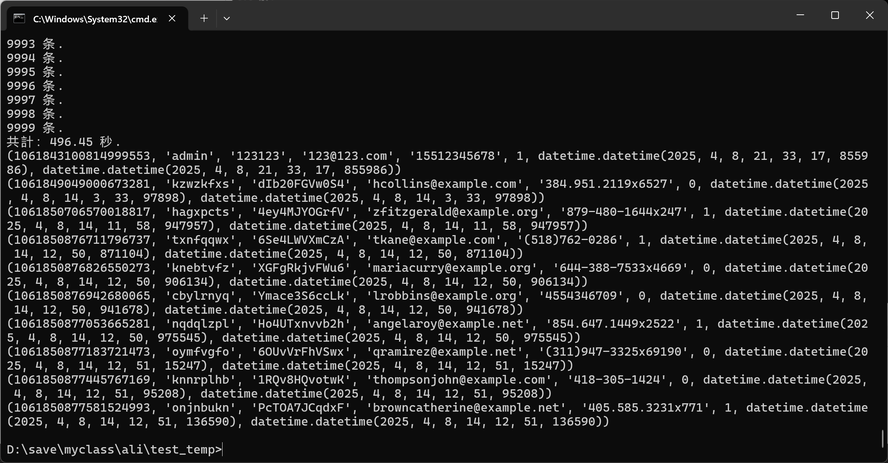
我进行了多次测试。
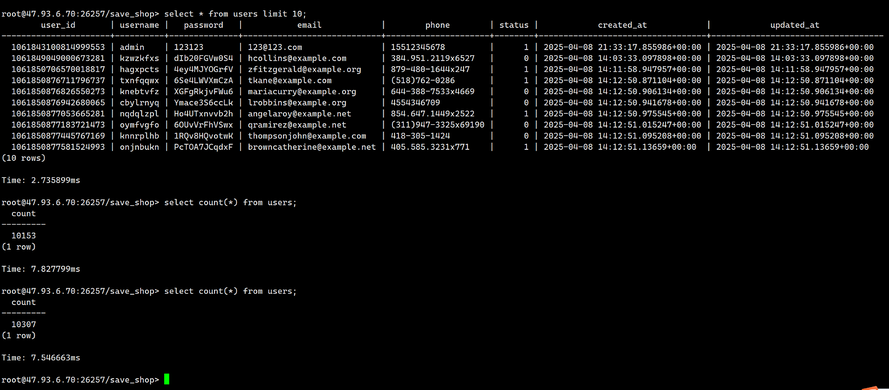
相对的时间消耗还是比较多的。
时序型数据库准备
这里建库的时候要有 TS 的声明:CREATE TS DATABASE ts_db;
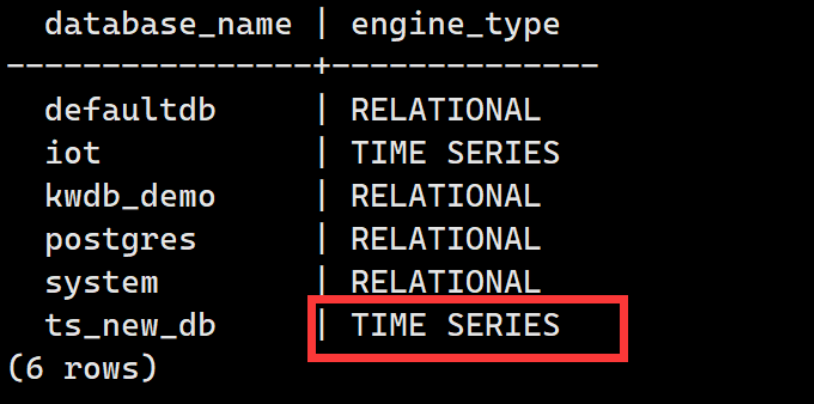
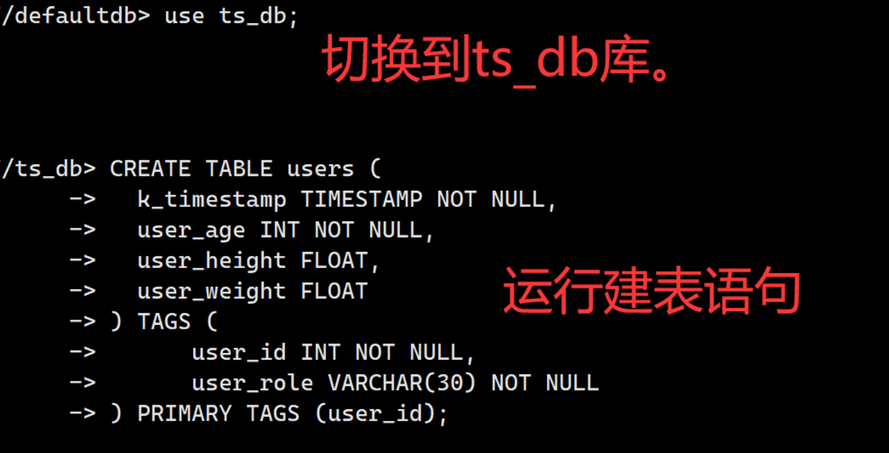
DDL语句
CREATE TABLE users (
  k_timestamp TIMESTAMP NOT NULL,
  user_age INT NOT NULL,
  user_height FLOAT,
  user_weight FLOAT
) TAGS (
      user_id INT NOT NULL,
      user_role VARCHAR(30) NOT NULL)
PRIMARY TAGS (user_id);
确认创建成功
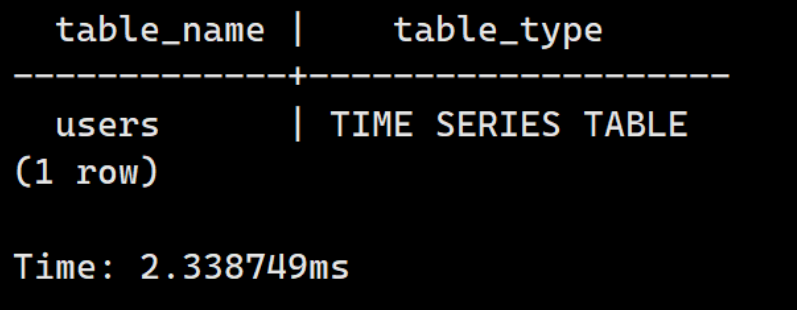
数据插入测试:
INSERT INTO users (k_timestamp, user_age, user_height, user_weight, user_id, user_role)VALUES ('2025-04-16T12:00:00Z', 30, 175.5, 70.0, 1, '张三');
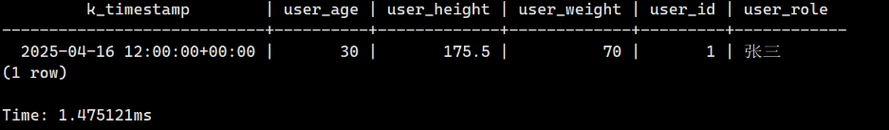
插入时间可以看到,比关系型数据库快乐很多了,才1.4毫秒,那么接下来我这里批量的使用Python写入一下看看。
我写的50条,再换算一下就知道1万的数据了。
 # 生成50条测试数据(时间戳间隔1分钟)
    base_time = '2024-07-01 10:00:00'
    data = [
        (            f'2024-07-01 10:{i:02d}:00',            220.0 + i*0.1,
            3.0 + i*0.02,
            20.5 + i*0.3,
            123 + i
        )
        for i in range(50)
    ]
运行数据:
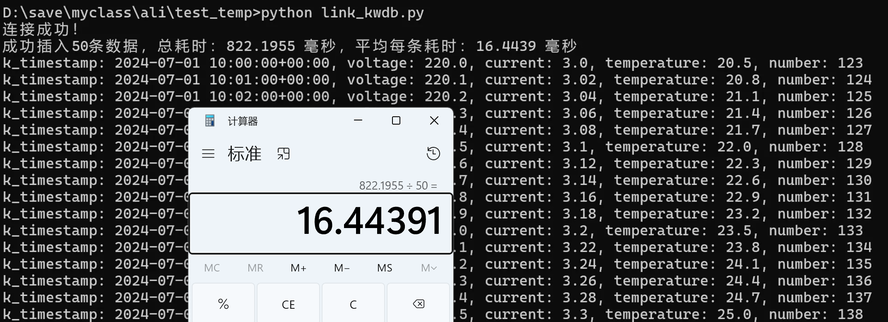
能看到,使用时序数据插入的速度就快出来很多了,总量测出来是822.1955/50约等于16毫秒再乘以1万也才164.43秒,效果比关系型数据库的496.45秒节约出2倍多的时间,两者差异十分明显。
总结
本文围绕 KWDB 数据库插入性能展开深入测试与研究,旨在评估其在数据插入方面的表现,为开发者和数据库使用者提供实践参考。测试过程中遇到诸多环境配置和代码实现的问题,经探索优化后取得一定成果,整体可总结为以下几方面:
我这里还单独的下载了【PostgreSQL\17】,感觉缺啥就装啥,但是实际上还得根据实际情况理解,我最开始测试的是:psycopg3,但是3的环境问题好多,问题是:
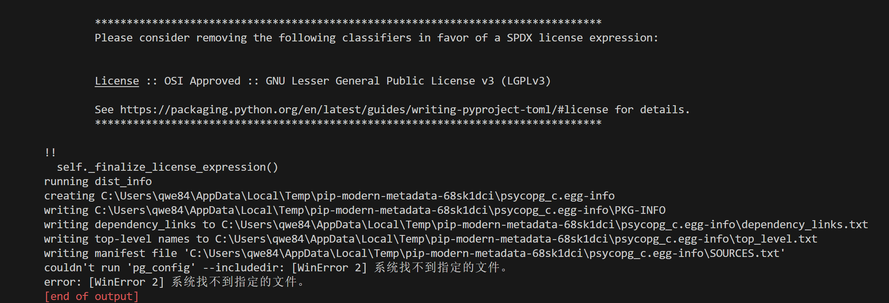
最后换成了psycopg2,就能运行了。坑我为大家填上了,希望能对大家有所帮助。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70045375/viewspace-3080344/ ,如需转载,请注明出处,否则将追究法律责任。

