
点击上方蓝字关注我们
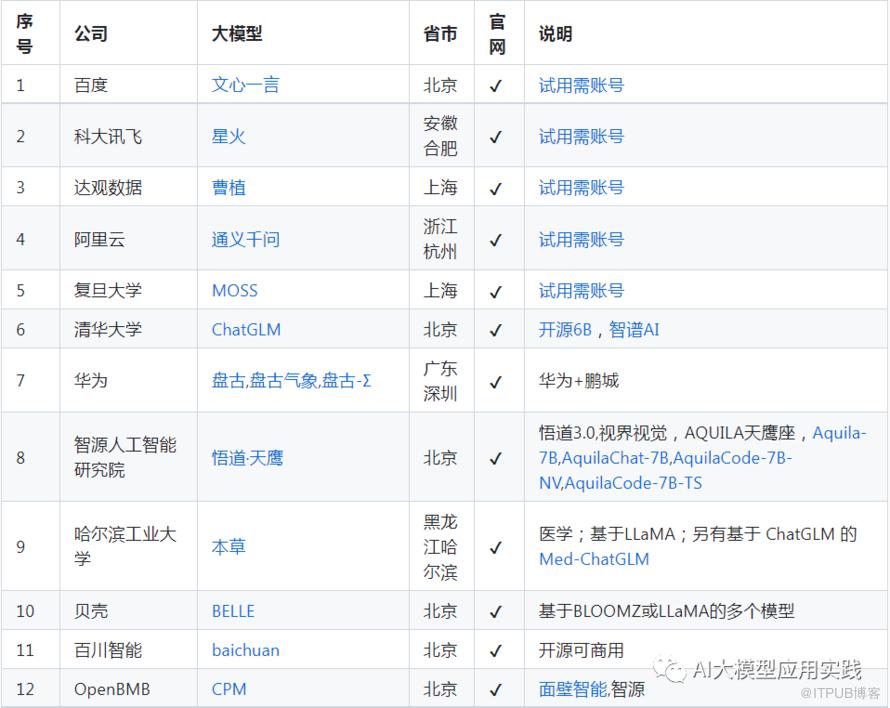
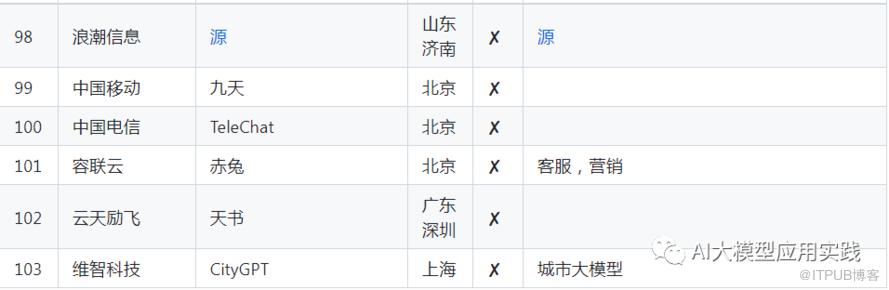
LLM现状:百“模“大战正酣
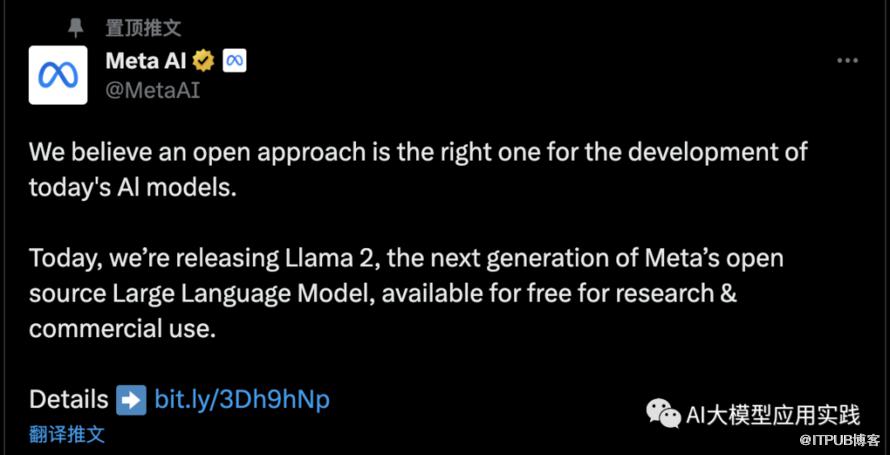
搅局者:LlaMa-2,全免费,可商用
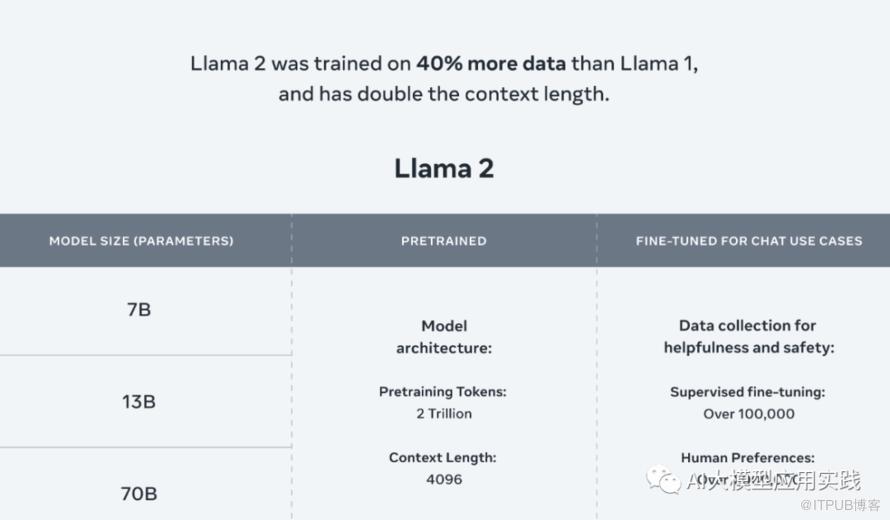
LlaMa-2暂时一共发布了 70 亿、130 亿和 700 亿三种参数规模的模型 LlaMa-2训练数据比第一代增加40%,上下文长度拓展到4K token 官方宣称同等参数规模LlaMa-2在大模型基准测试超越所有开源大模型 700亿参数模型在能力上接近chatGPT-3.5,在代码能力上有一定差距 借助于人类反馈强化训练,同步推出适用于对话的LlaMa-2-chat系列模型
此外,根据本人实测,中文能力是拉垮的,但是相信很快会有开源社区推出专门基于中文预料训练的中文LlaMa-2模型。
当然,也是最重要的:完全商用免费!(7亿活跃用户以上需要申请)。
未来:LlaMa-2重塑大模型竞争新格局?
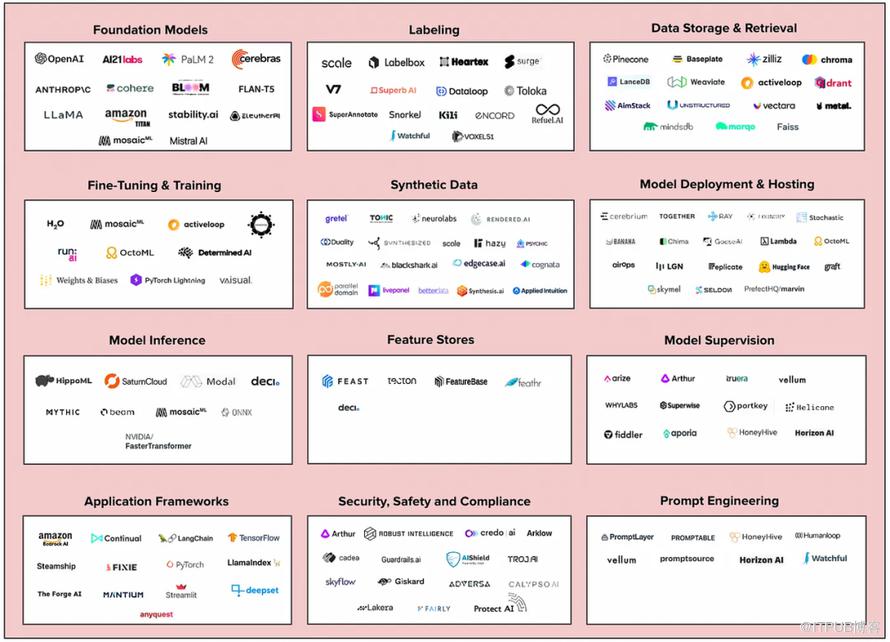
大模型生态有望从混战走向有序的分工。专业的、强大的、基础大模型成本高昂,由meta这样的实力雄厚的大厂来提供,而在此基础上的二次甚至三次训练的微调模型,则由专业的公司甚至开源社区针对特定的服务区域、行业场景、领域特征在此基础上完成,从而提高整体行业效率。当然,我们也完全有理由期待国内的大厂能够释放出更强大的针对中文领域的开源大模型,推动中文大模型的应用发展。


Meta 在宣布 Llama2 开源后解释说,选择开源对于当今人工智能模型的发展是正确的,尤其是在技术迅速发展的生产领域,通过公开提供人工智能模型,它们可以惠及所有人ーー而不仅仅是少数几家大公司。

可能会出现大量基于LlaMa-2基础模型的行业模型,商用模型的使用成本会降低。由于LlaMa-2免费商用的特点,加上其接近GPT-3.5的性能,很多应用开发商与终端用户会选择基于LlaMa-2模型权重来训练出垂直的行业模型,替代现有的一些开源模型,昂贵的、不开放的、无法掌控的一些商业大公司的大模型依然会存在,但是需要更加灵活的部署方案,特别是针对大型企业应用领域,比如提供私有化部署方案。 会有更多的商业大模型公司选择开源方案。由于大模型护城河的打破,大模型平民化时代的到来。可能会有更多的商业公司也会选择开放出自己的大模型,比如选择训练参数较低的版本进行开源,用来吸引更多的用户来使用,通过这种更加灵活的竞争战略来获得占据大模型市场的主动权,而不会轻易地让出一大块市场给LlaMa-2这样的全开源模型。 -
大模型的应用,特别是在ToB领域得到巨大的推动与机会。免费的基础模型让更多的公司完全没有重新发明轮子的动力,而现有的商业在线大模型面临成本高、安全性不足、并发能力不足等问题。他们会选择替换现有的底层基础模型,通过新的LlaMa-2,并结合类似Langchain这样的大模型应用框架,可以开发更具有想象力的、更安全、全可控大模型上层应用或插件,这有利于大模型在B端的深入应用,从而促进大模型生态链的进一步完善与发展。
结束语:大模型的苹果与安卓时代?
一个技术足够领先的巨头忽然出现,这时候出现了一个开源可二次开发的产品,虽然在初期技术上略显稚嫩,但在一大帮围绕着其生态的商业公司、开源社区、个人开发者的努力下,不断迭代升级,最终形成相互对峙,互相促进的良性竞争态势,这一幕是否熟悉?这一iPhone与安卓的经典历史对决局面是否会在大模型时代再次重现?让我们拭目以待吧。

【End】

原文作者:AI大模型应用实践;如有侵权,请联系管理员删除。

请登录后发表评论
登录
全部评论
最新文章
- 多模态RAG实战:复杂的PPT文档如何处理?一文掌握关键技巧。
- 实操干货!MCP全解析,一步步教你借助第三方MCP Server开发Agent
- 中学生就能看懂:从零开始理解LLM内部原理【七】| “概率”从哪里来?
- 手把手教你实现自己的“Manus”:构建基于容器的多用户Agent应用【下】
- 手把手教你实现自己的“Manus”:构建基于容器的多用户Agent应用【上】
- DeepSeek-R1 x Agentic RAG:构建带"深度思考"开关的知识研究助理|深度长文
- DeepSeek-R1如何为企业级RAG赋能“深度思考”:换个模型就够吗?
- 中学生就能看懂:从零开始理解LLM内部原理【六】|什么是“自注意力”?
- Web Agent技术揭秘:如何让DeepSeek接管与控制你的浏览器?
- 如何完美解锁DeepSeek-R1的结构化输出能力(基于LangChain)?
