“First

点击上方蓝字关注我们

九月底,OpenAI发布了具有强大视觉能力的GPT-4V,具备了理解与分析客户输入图像的能力。而在9 月 29 日微软则作为其合作与先行测试者发布了长达 166 页的 GPT-4V(视觉)的研究论文《大型多模态的新时代:GPT-4V(ision)的初步探索(The Dawn of LMMs:Preliminary Explorations with GPT-4V(ision))》(原论文:https://arxiv.org/abs/2309.17421 ),这是一个很好的全面认识GPT-4V的敲门砖。基于我们的理解,这里整理出该报告的“中文浓缩版“,帮助全面认识与了解GPT-4V的能力与使用。当然,猎奇不是目的,更多的是希望能够启发我们思考未来GPT-4V等多模态模型(LMMs)的应用场景与方向,特别是在GPT-4V的API开放以后,相信未来会有更多的创新AI应用涌现。
按照原报告的顺序,内容大致分为几个部分:
GPT-4V的输入模式与提示方式
GPT-4V的多模态能力展示
GPT-4V的一些新兴应用亮点
-
利用现有LLM技术增强GPT-4V
GPT-4V的输入模式与提示方式
作为增强的多模态模型,其最重要的直观变化就是输入模式的变化:能够接受图像信息的输入(在实际操作中,一般通过上传图片文件,或者接受互联网图片链接来实现)。

GPT-4V的输入模式

除了传统的GPT-4的文本输入模式以外,GPT-4V可以有两种输入模式:
单个图像-文本对:即提供单个图像,或者单个图像-文本对信息,用来执行各种任务,文本可以是描述图像的信息,也可以是请求的任务信息
交错图像-文本输入:带有问题或者指令的多个图像;或者有多个图片并结合文字的网页。比如下图中左边的“根据多个图片计算税费”,右边的“根据下图的价格单计算上图中啤酒的总价“

根据账单计算我支付的税金
根据价格表计算下桌子上啤酒的价格

GPT-4V的提示技术

我们都知道提示(Prompt)对于大模型的重要性,GPT-4V的主要工作模式与提示技术有以下几种:
简单文本指令
针对图片发出直接的文本指令。比如:“用10个字描述图片内容” 或者 “ 描述图片中的规律”等。文本指令可以在要求大模型响应时进行独特的限定,比如:
输出格式限定:比如把驾驶证图片中的信息提取成JSON格式,方便计算机后续处理
精心设计获得最优化输出的提示。这部分和我们在使用普通大模型时的经验一致,即精心设计的提示能够获得更高质量的输出。比如下面这个例子中,不同的提示输出,AI输出的苹果数量是不一致的:
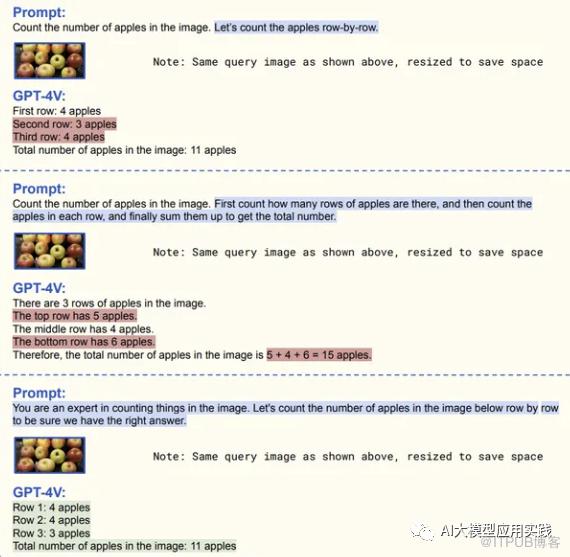
最终获得正确输出的Prompt:你是一个计算图片中物体数量的专家,让我们来一行一行的计算下图中苹果的数量,以获得正确结果。
增加视觉指示与参考文本
用通俗的语言来说,就是给图像增加帮助理解或者需要针对性提问的可视化“标记”,比如箭头、圆圈、甚至手绘标注。同时针对这些“标注”给予一定的文字提示。这是一种非常重要且有趣的提示方式,比如你可以像下图这样框出一些图像区域并提问,或者直接手绘标注并做针对性提问:
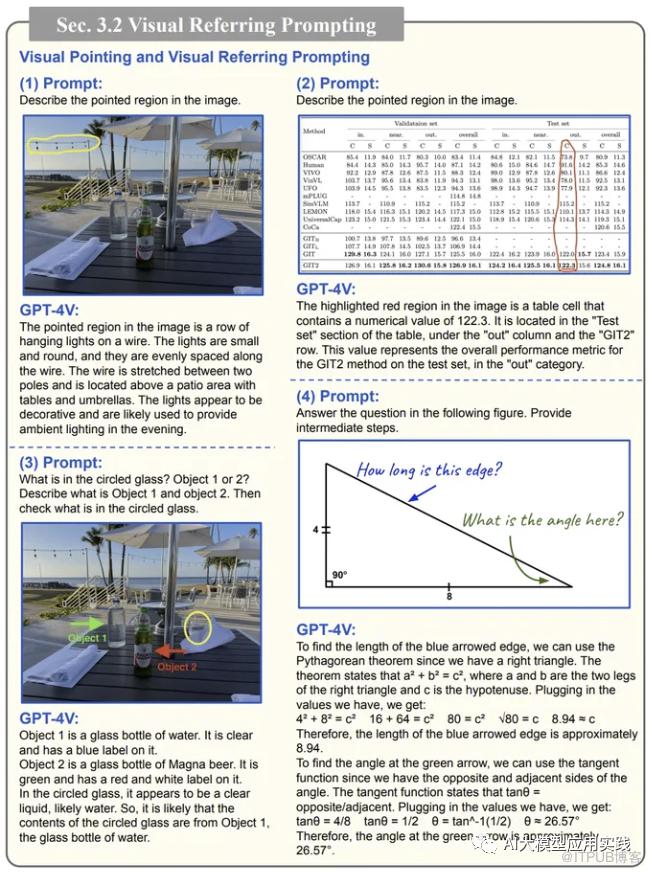
描述图中圈出的区域
描述表格中圈出的区域
图中圈出的物体是物体1还是物体2
-
根据图中的知识回答问题,提供中间步骤
混合多个图像、指示与文本
在提示中混合多个图像、子图像、文本描述、视觉指示等,用尽量模拟人类学习的过程来提示AI,并最终获得输出,下面是一个具体的例子,这个例子最终要求AI推理新的图案(选择题),但在推理之前,通过完整的图片、子图(其中一个小图)、结合视觉指示与文字说明,教导了AI的推理过程,GPT-4V最终给出了正确的答案。不得不说,这个反应了GPT-4V在混合多种图案/视觉指示/文本输入的理解与推理方面强大的能力,大大提升了模型的通用性和灵活性。

找到图片中的图形规律,并参考相关例子的说明,用来推测后面一列中缺少的图片
携带上下文的少量示例的提示
这是在LLM(大语言模型)中常用的一种提示手段,即在大模型推理之前给他一个/多个学习的“例子”:前置一些与输入格式相同的上下文示例,并说明期望的输出,然后让大模型根据参考的“例子”来推理并输出。现在GPT-4V同样也可以具备类似能力:给出一些示例,即具有类似格式的“图像-文本”对,然后让GPT-4V参考后解答问题。(我们认为这种提示其实是多图像/文本混合提示的一种特例)
这是一个通过多次迭代优化才最终让GPT-4V能够准确识别车速表的例子:
 参考两个例子判断当前车速表上的速度值
当然,这种上下文提示对于LLM与LMM(大型多模态模型)的能力重要性毋庸置疑,但是对提示设计的要求较高,需要给出非常细致的推理中间过程解释与提示。
GPT-4V多模态能力展示
在这个部分报告中对GPT-4V的多模态能力进行了较为详细的实例说明,我们无法对所有的实例进行逐个展示,仅通过表格的方式对GPT-4V的多模态能力做总结,并尽量用容易理解的文字说明简单用例。
1、基础的视觉理解与语言输出能力
理解、解释、分析视觉(图片)信息,并做语言输出,实际用例包括:
| 领域 |
用例 |
| 图像描述 |
图片中的名人、地标、食物识别 |
| 解释医学影像,比如解读CT影像或者验血报告 | |
| 车标、品牌Logo等识别 | |
| 照片中场景识别分析,比如识别图片中的交通违规 | |
| 识别对图片的“反事实”描述与要求,如不存在的颜色 | |
定位/计数/标注 |
识别图像中的特定物体并计数,如图中有几个苹果? |
| 对图像中的特定物体定位并框注,比如标注图中汽车 | |
| 识别密集图像中的个体并生成描述,如描述图中名人 | |
|
笑话与梗图科学问题 常识推理 |
理解特定事件、文化、流行趋势下的幽默梗图 |
| 回答图片中的科学问题,比如地理、生物问题 | |
| 多模态尝试推理,如根据照片推测场景 | |
| 视觉线索发现与推理,类似侦探检测现场 | |
|
文本OCR 图表理解 |
识别图片中的手写与印刷文本 |
| 识别图片中的数学与几何问题 | |
| 理解流程图并生成程序代码 | |
| 理解表格、各种数据分析图表,并回答问题 | |
| 理解设计图、海报、试卷等并解释或回答问题 | |
多语言/多文化理解 |
不同语言的提示和输出文本 |
| 理解多语言场景文本,比如中英文混合的广告牌 | |
| 理解图片的文化背景并用对应语言描述 | |
| 基于视觉的代码能力 |
根据手写数学方程生成LaTex代码 |
| 根据表格生成对应Markdown描述 | |
| 根据图表生成对应Python语言代码 |
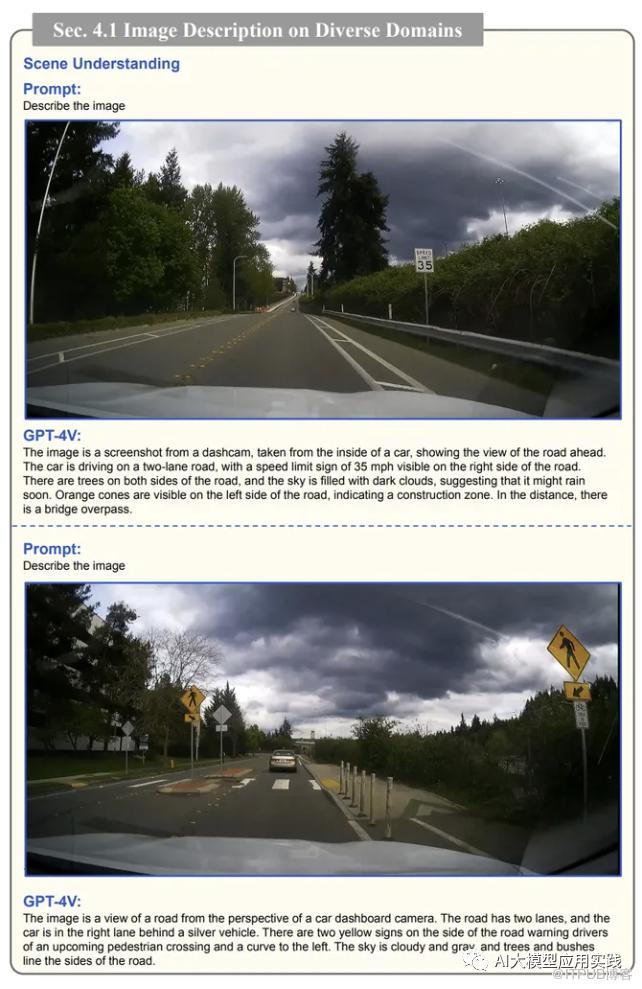
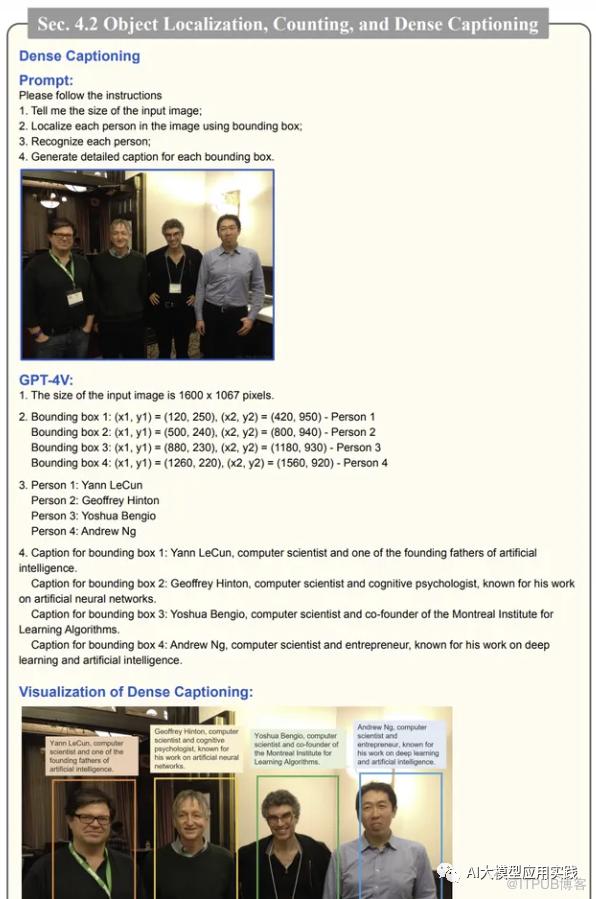
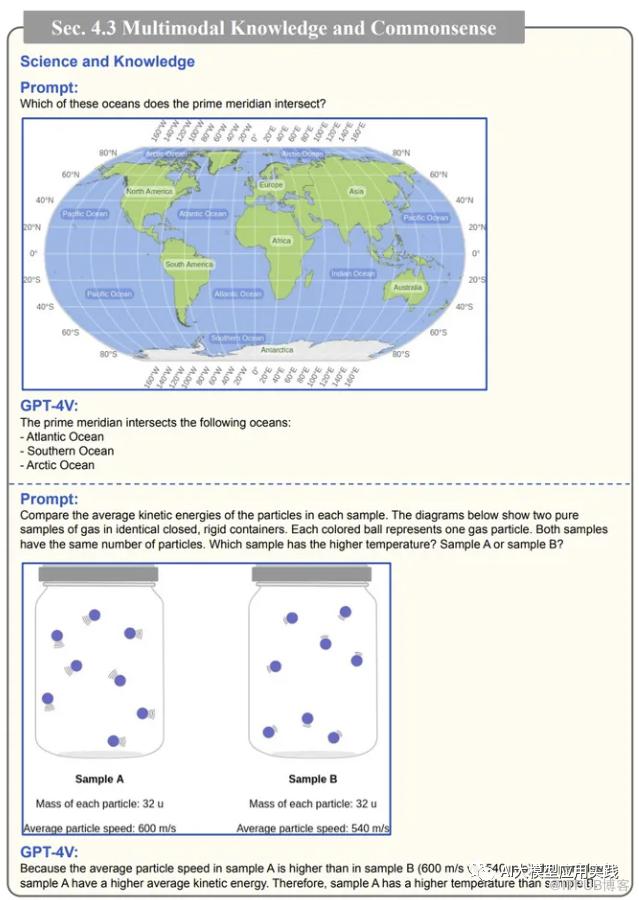
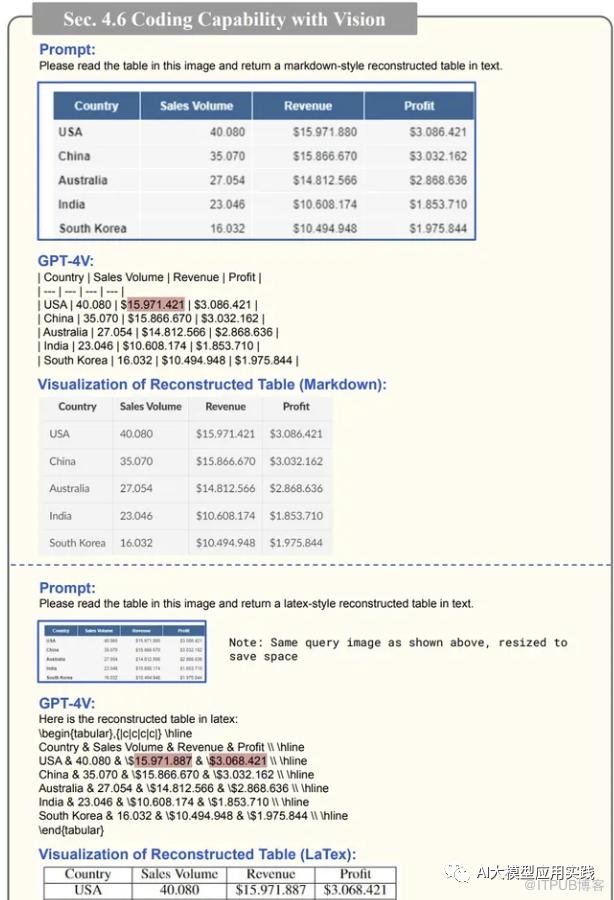
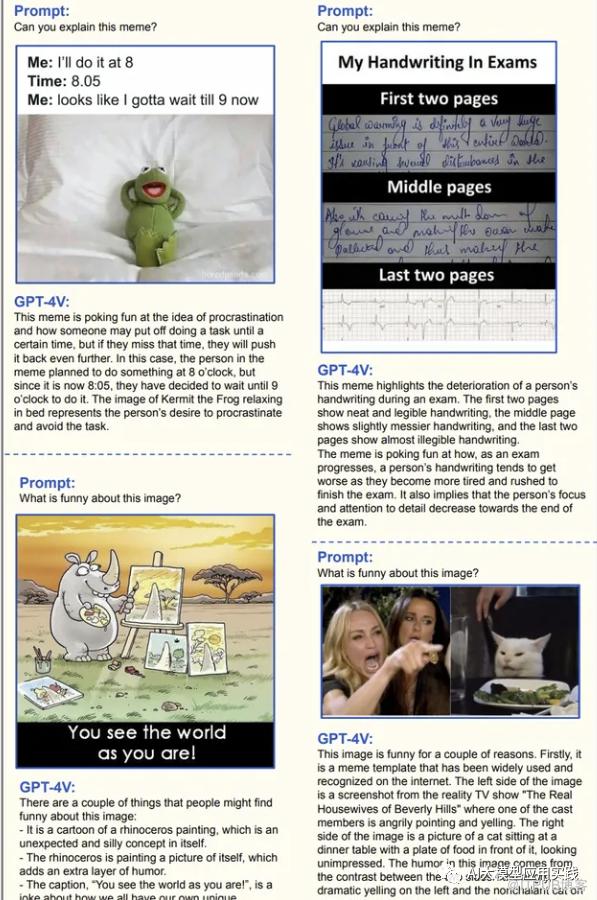
<-- 左右滑动查看多个用例 -->
2、根据视觉参考提示进行输出
根据图片中的指示/标注、文本提示进行输出的能力。
| 领域 |
用例 |
| 理解指向输入 | 根据视觉指示/标注/坐标分析图片特定区域 |
| 视觉指示提示 |
根据视觉指示+参考提示完成任务 |
| 生成指向输出 |
生成指向性输出,如在图片中找到某物并返回坐标 |
3、视频(连续多帧图片)理解
针对视频场景下的连续多帧图片进行相关的理解、分析、推理能力,可以想象,这部分在未来针对视频模态的内容AI能力的释放具有较大的想象空间。
| 领域 | 用例 |
| 连续图像场景理解 | 多图像序列理解,如根据视频帧序列分析所处场景 |
| 视频理解与推理 |
分析多帧图片并按照时间做正确排序 |
| 根据多帧图片来预测下一步可能发生的未来事件 | |
| 在连续的多帧图片中定位某个描述的时刻 | |
| 视频+标注理解 |
根据多个图像帧与标注进行理解与分析 |

基于多帧视频图片,理解并推测未来可能发生的动作
4、抽象视觉推理与智力测试
| 领域 | 用例 |
| 抽象视觉刺激 |
从抽象的图片中推理语义,比如七巧板图案、卡通字符 |
| 发现和关联对象 | 把多个部件组成一个有意义的对象,比如拼图 |
| 智力测试 |
找出多个图案中和其他图片不一样的图案 |
| 根据图片中子图片的规律推理出下一个子图片 |
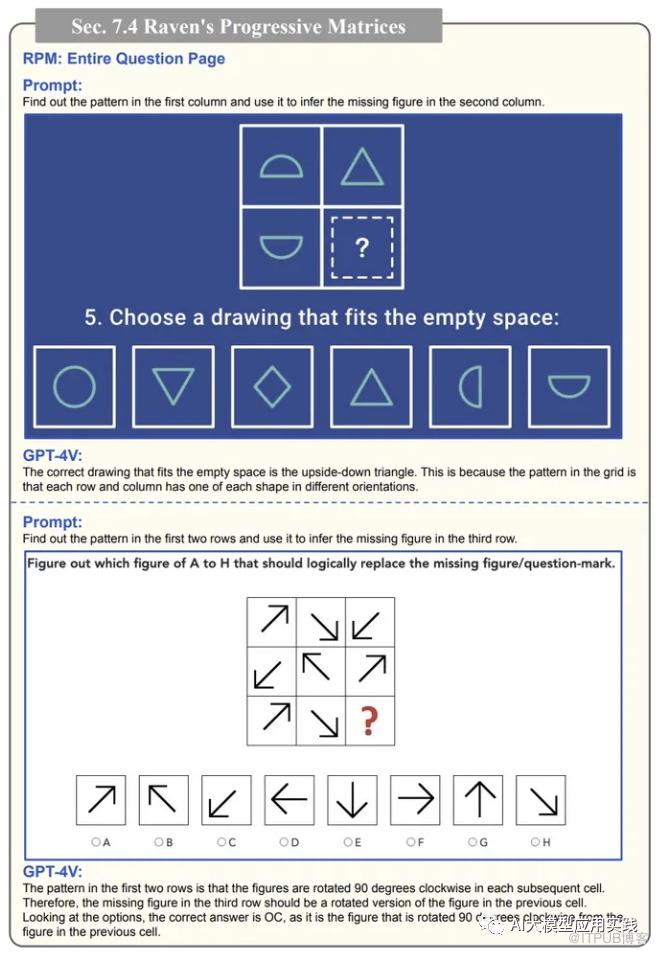
根据图片规律推理出消失的图案(智力测试考题)
5、情商测试
| 领域 | 用例 |
| 读取面部情感 | 从图片中人类表情识别人类情感,并做解释 |
| 理解视觉内容与人类情感关系 |
识别视觉内容,并推测人类的情感反应 |
| 根据图片内容与社会标准判断图像美学 | |
| 情感条件输出 |
根据图片与输入的情感要求输出内容,比如描述一张图片让人感到幽默风趣 |
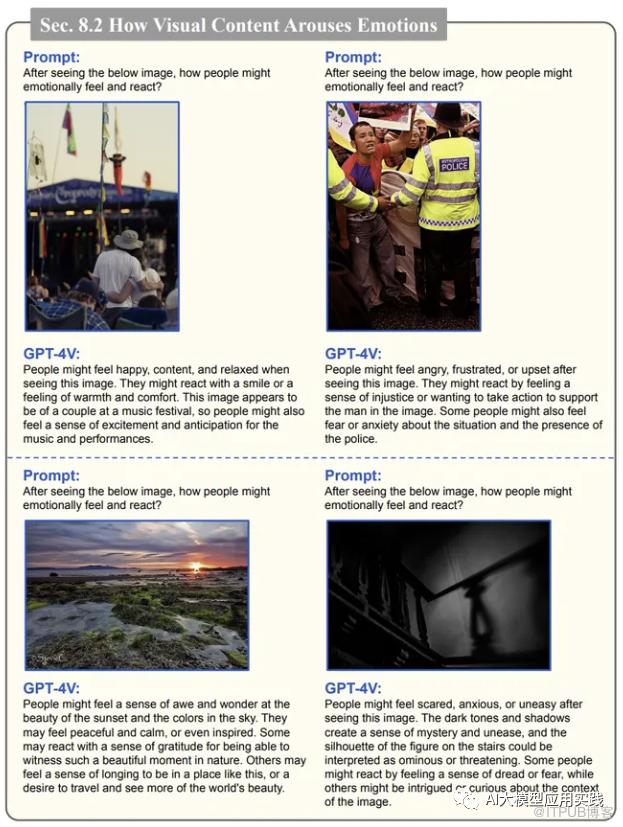
根据图片判断人类可能的情感反应(悲伤、愤怒、高兴等)
GPT-4V的高价值应用场景
本部分主要展示基于GPT-4V强大的视觉理解与推理能力可能启用的高价值应用场景和新用例,这些场景与用例在GPT-4V的能力加持下将会更加便捷和容易,同时结合可能的插件与工具,将能实现更多的应用协作与创新。
缺陷检测
利用GPT-4V检测产品质量或者使用中产生的缺陷,比如汽车的保险杠的凹陷、零件的受损等;也可以通过提供对比图案,帮助AI发现缺陷。比如:
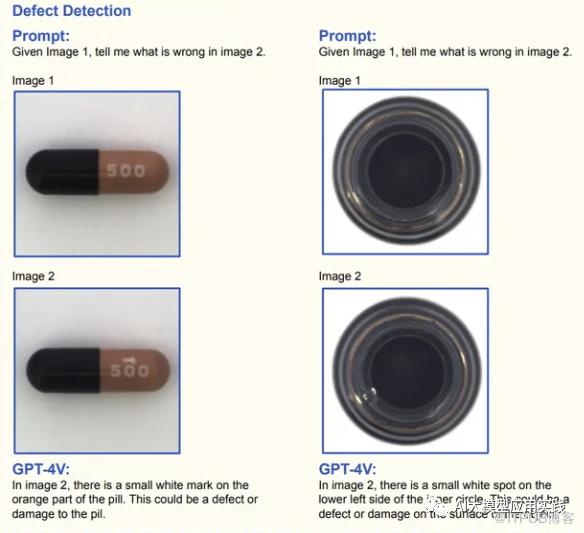
通过提供比较图片,要求检测图片2中的问题和缺陷
安全检查
比如对建筑工地上的摄影图片进行检测,发现没有使用或者不充分使用安全措施(比如头盔、安全带、手套等)的现象等。
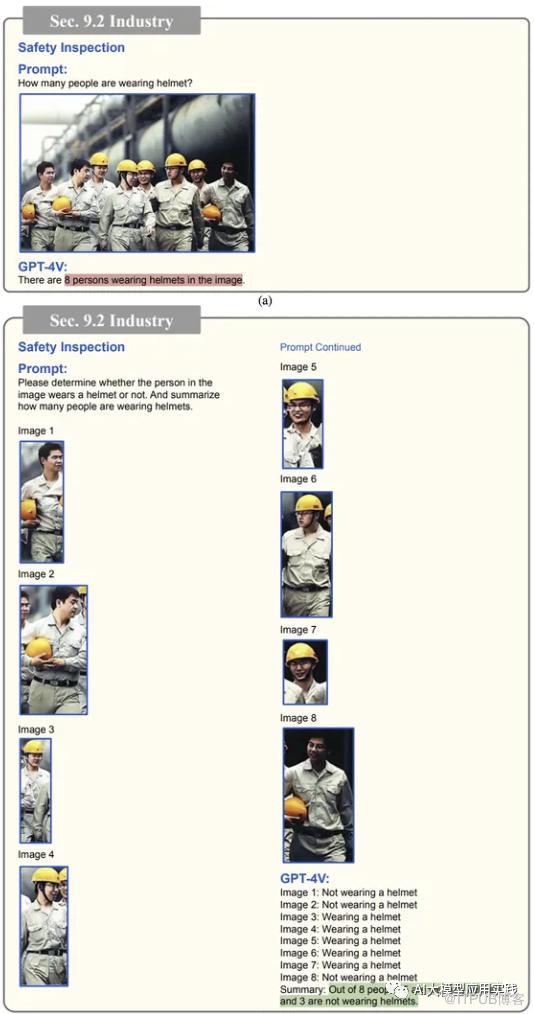
识别图片中哪些人没有戴安全帽?
杂货结账
通过给予AI足够的提示与学习,让AI来识别杂货蓝中的物品,并进行自动结账,可以极大的加快目前常见的结账方式,比如扫条形码。
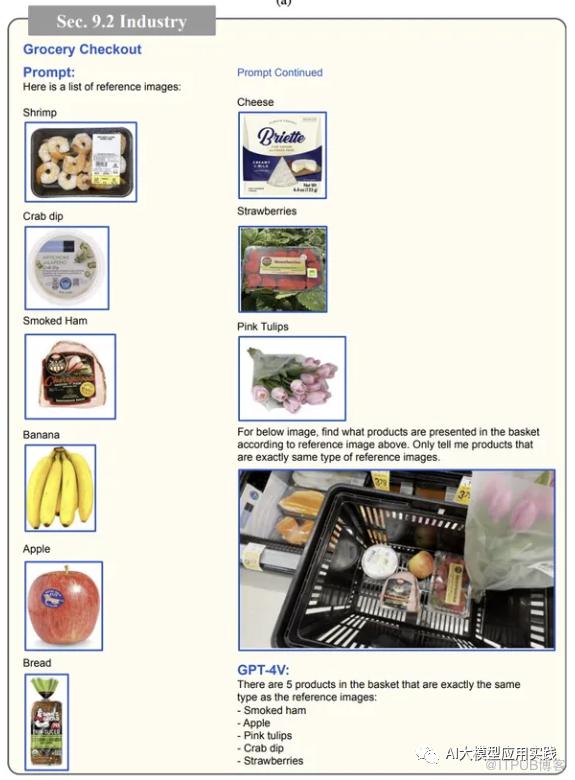
提供参考的产品图片,要求识别图片并判断产品信息和数量
医疗辅助诊断
根据医学图像,生成完整的医学报告。虽然这是一个需要极大的专业知识的领域,但是可以大大减少专业人士起草报告的工作量。而且在 生成报告时,甚至可以参考先前的医学诊断历史来判断。
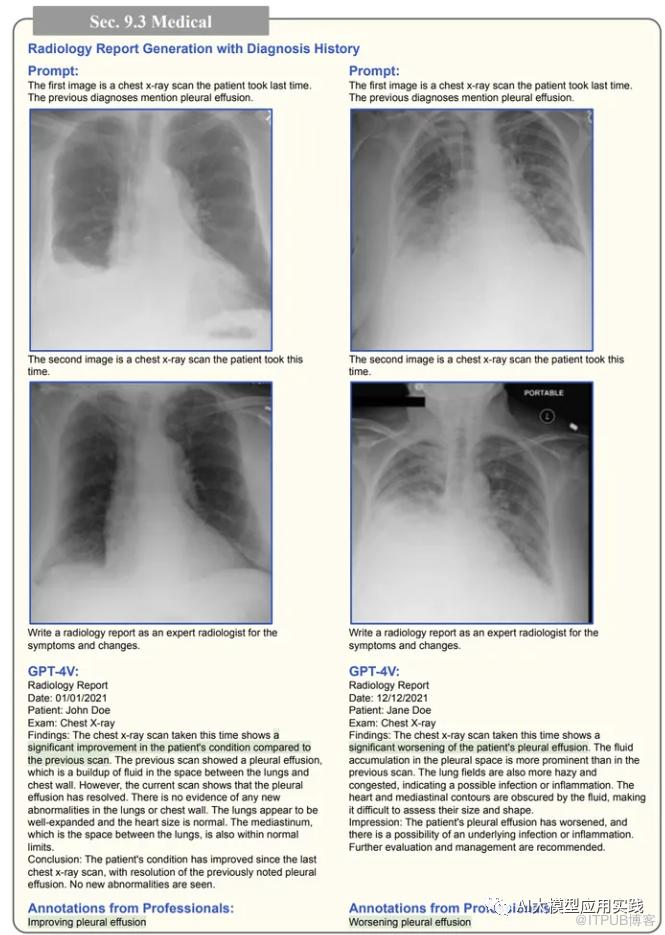
提供连续的医疗影像,要求AI编写医疗报告
汽车保险
比如:根据汽车损坏的图像进行定损,甚至估算修理的成本;或者识别图像中的车辆信息(制造商、型号等),并生成事故保险报告。

根据汽车损毁图片进行识别生成事故保险报告
图片组织与搜索
比如,可以根据家庭成员的照片,对家庭相册中的合影生成明确提及成员名字的标题来增强相册,帮助更好的组织照片。此外,可以用于自然语言的照片搜索,比如你可以搜索“有Linda、Sam和狗在一起”的照片。
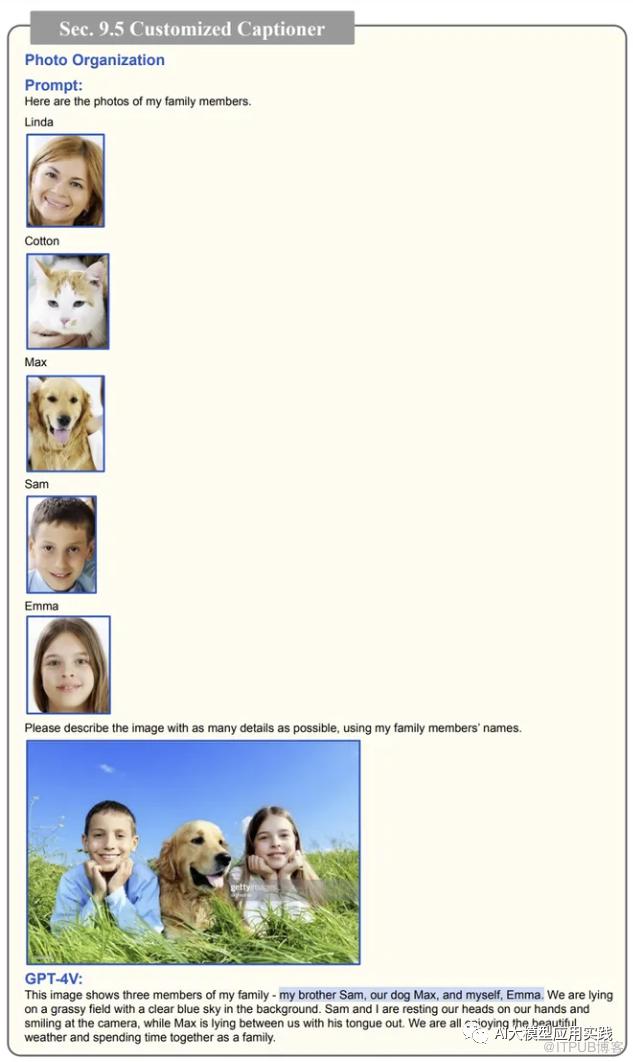
提供参考照片,要求识别图中人物,生成个性化标题
图片标注与分割
在复杂的图片中标注感兴趣的对象,并进行标注,比如为每个对象生成详细的标题与说明,并根据图片内容丰富上下文(参考上文中的图片多人标识)。
图像生成的评估
利用GPT-4V评估一段描述文本与图像之间的匹配程度。比如,你利用LlaVa来生成描述图像的一段文本,或者利用MidJourney来根据文本生成一个图像。然后你可以让GPT-4V来判断文本和图像之间的“距离”或者相似性。比如:

对AI生成的图片和文本描述进行相似度判断,用1-10分来评判
AI图像编辑的优化提示生成
在利用AI编辑图片时,需要优化自己的文字提示。现在,你可以利用GPT-4V为图像编辑生成特定的优化的文本提示,然后你可以利用这个文本提示来编辑图片。比如:

生成AI编辑优化的提示文本
具象智能体/机器人的应用
利用GPT-4V来实现多模态的理解,并实现与所在的动态环境的物理交互,这在具象化智能体(比如人形机器人)中有很好的应用。比如让你家用机器人识别家庭咖啡机的操作按钮图片,并能够推理每个按钮的操作功能与使用它。
这是一个更具体的例子:提供一个虚拟房屋游览的入口图像(比如客厅入口处的一张照片),要求AI能够根据任务“走到厨房并从冰箱取出一件物品”这样的提示,自行判断下一步的动作;然后根据下一步动作后能够看到的图像,做下一步的推理,这样可以实现机器人的自动视觉导航。
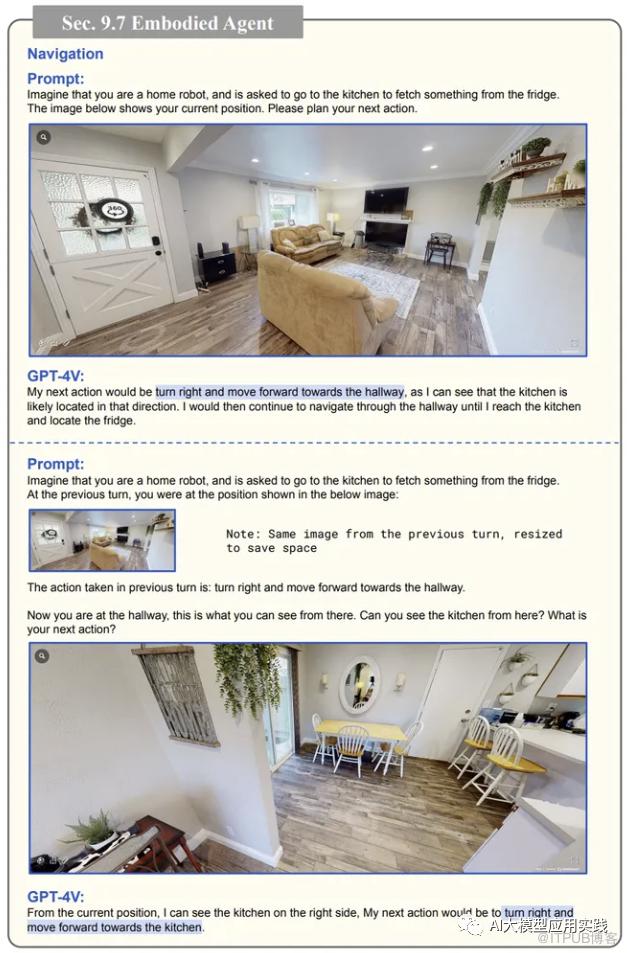
机器人根据看到的图形推理出行走路径
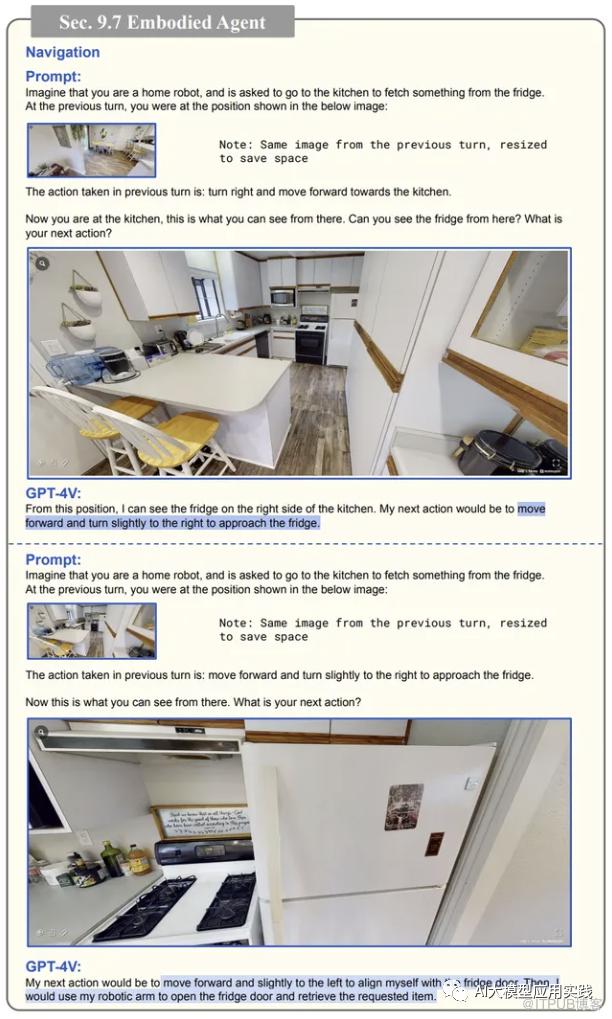
通过多次迭代和推理后,机器人最终完成了任务:走到了厨房的冰箱前
计算机操作界面导航
这对实现完成自动化数字任务的AI Agent非常重要:通过GPT-4V实现计算机或智能手机的界面(GUI)交互与导航。想象一下,AI根据当前当前计算机屏幕,以及设定的目标任务(比如看一下今天的新闻)、能够进行的操作(比如鼠标点击与键盘输入),然后预测下一步的操作,最后能够成功的导航到具体的网页完成任务,当然在实际的实现中,需要将AI的输出转化为具体的操作。


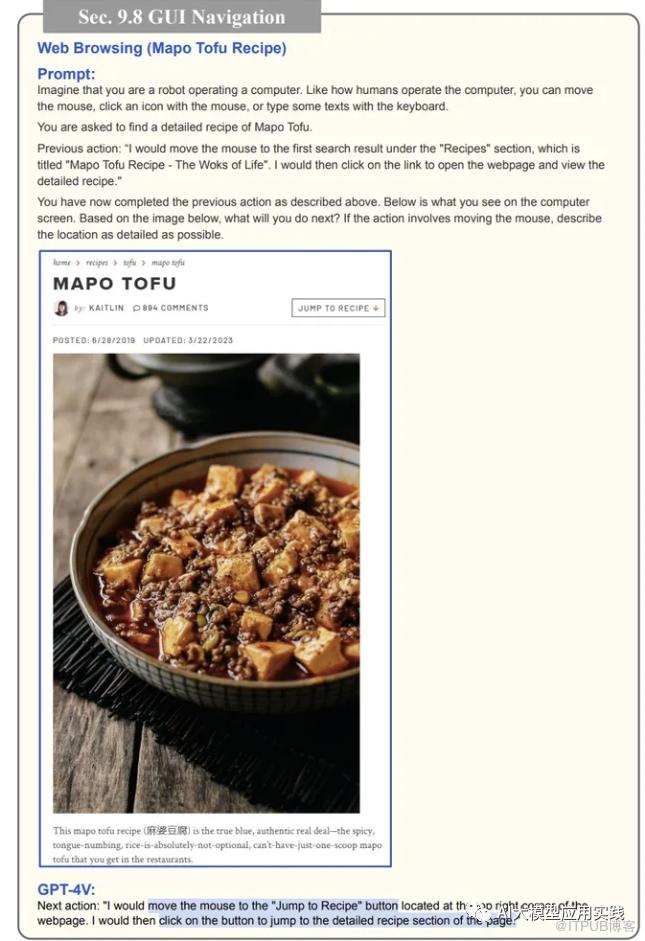
该例子演示一个GPT-4V根据提示内容与看到的屏幕图片,自行完成操作步骤,并完成打印一份“麻婆豆腐菜谱”的任务。当然这里是一种操作可行性的验证,实际实现还需要较多的应用层工作,比如你需要不断把屏幕图像输入到AI,并根据AI的输出反馈到物理操作。
利用LLMs增强智能体
本部分简单介绍在LLM(大语言模型)中一些比较成熟的技巧或者用法如何拓展到多模态的GPT-4V等LMM上,比如插件、检索增强提示、自我反思、思维链提示等,从而实现对LMM能力的进一步增强。
使用插件来增强GPT-4V
比如在大语言模型中常用的利用搜索引擎的插件来增加LLM的回答能力。那么在GPT-4V中,一样可以引入这样的插件来增强其对实时信息的了解并获得回复。
多模态链式处理
你可以通过LLM语言模型与多模态处理的插件进行集成,实现LLM中常见的思维链提示工程的ReAct(推理与行动)模式,让AI进行“一步一步”的推理并完成更复杂的多模态任务。这样充分利用了语言模型与多模态模型的结合,具备了更全面的理解与分析能力。比如下图,AI通过“思考-行动-观察“的思维链来推理出图片中戴安全帽的人数:

借助于LLM与多模态的插件,通过思考-行动-观察思维链来完成任务
自我反思与纠错
让GPT-4V进行自我反思与double-check,来提高输出的质量。
检索增强生成(RAG)
检索增强生成在大语言模型LLM中已经得到很多验证与应用,即把检索(通常为基于向量的语义搜索)出的参考知识整合到提示中来增强输出,减少大模型的幻觉(编造),比如用于提高基于私有知识/领域知识库的问答与输出准确性。这在未来的多模态模型中的应用也同样重要,比如上文的通过GPT-4V识别并收银结账的例子,其实就是一个检索增强的例子:你把参考的产品图片-文本-价格放入到提示中,一起交给GPT-4V,以增强AI的输出质量,这样他才能准确计算出价格。
结束语
以上就是微软的这篇GPT-4V的详细报告中的核心内容提炼,重点在于对GPT-4V的视觉能力与应用场景进行展示。当然,我们也能发现在一些领域GPT-4V还不够成熟完善,或者较依赖于使用者的输入。文中也对未来的LMM(多模态模型)的研究方向做了展望,比如能够输出混合的图像-文本内容,以实现全面的多模态的理解和输出等。此外,我们在自行测试中也发现,当前GPT-4V在OCR(图片文字识别)能力上对于中文的支持较为不足,错误率较高,希望未来有改善吧。
END
点击下方体验AI助手
原文作者:AI大模型应用实践;如有侵权,请联系管理员删除。

最新文章
- 多模态RAG实战:复杂的PPT文档如何处理?一文掌握关键技巧。
- 实操干货!MCP全解析,一步步教你借助第三方MCP Server开发Agent
- 中学生就能看懂:从零开始理解LLM内部原理【七】| “概率”从哪里来?
- 手把手教你实现自己的“Manus”:构建基于容器的多用户Agent应用【下】
- 手把手教你实现自己的“Manus”:构建基于容器的多用户Agent应用【上】
- DeepSeek-R1 x Agentic RAG:构建带"深度思考"开关的知识研究助理|深度长文
- DeepSeek-R1如何为企业级RAG赋能“深度思考”:换个模型就够吗?
- 中学生就能看懂:从零开始理解LLM内部原理【六】|什么是“自注意力”?
- Web Agent技术揭秘:如何让DeepSeek接管与控制你的浏览器?
- 如何完美解锁DeepSeek-R1的结构化输出能力(基于LangChain)?
