在直播、视频社交、短视频等场景中,“美颜”通常被认为只是给视频增加一个滤镜。但从软件开发的角度来看,一套完整的视频美颜SDK实际上涉及视频采集、人脸检测、关键点定位、图像分割、纹理处理、几何变形以及实时渲染等多个环节。
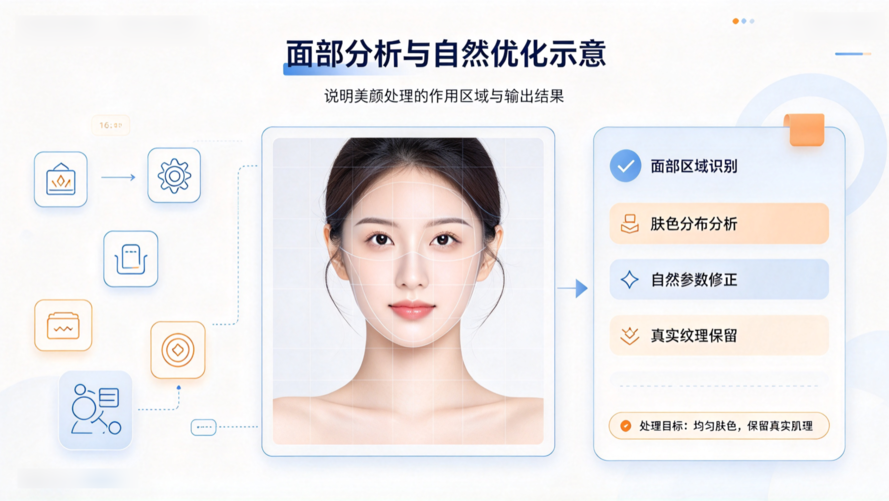
如果把摄像头输出的一帧原始图像记为
Frame,最终呈现在直播画面中的结果并不是简单的:
Frame → Filter → Output
更接近下面这样的处理链路:
Camera
   ↓
Video Frame
   ↓
预处理
   ↓
Face Detection
   ↓
Face Landmark
   ↓
Mask / ROI
   ↓
Skin Retouch
   ↓
Face Reshape
   ↓
Filter / Makeup / Sticker
   ↓
GPU Rendering
   ↓
Encoder
   ↓
Live Streaming
其中任何一个环节出现明显延迟,都可能直接影响最终直播体验。
一、视频美颜首先处理的是视频帧
以移动端摄像头为例,摄像头会持续输出 YUV、NV12、NV21 等格式的视频数据。SDK首先需要完成颜色空间转换或者直接在GPU中对YUV纹理进行处理。
以常见的YUV420为例,亮度信息主要位于Y分量,色彩信息则由U、V分量提供。
如果需要转换到RGB,可以使用类似下面的计算:
float R = Y + 1.402f * (V - 128.0f);
float G = Y - 0.344f * (U - 128.0f)
            - 0.714f * (V - 128.0f);
float B = Y + 1.772f * (U - 128.0f);
实际项目中通常不会简单地使用CPU逐像素转换,因为直播视频具有较高帧率,例如30FPS甚至60FPS,如果每一帧都进行大量CPU计算,很容易产生性能瓶颈。
因此,移动端实时美颜往往会将部分处理放到GPU,通过OpenGL ES、Metal或者其他图形计算能力完成纹理处理。
二、人脸检测:首先确定“哪里是人脸”
视频帧进入美颜模块之后,并不是直接对整张图片进行处理。
第一步通常是进行人脸检测。
可以将检测结果抽象成:
struct FaceRect {
    float left;
    float top;
    float right;
    float bottom;
    float confidence;
};
检测算法输入一帧图像:
std::vector<FaceRect> faces =
    detector.detect(frame);
如果检测到多个人脸,SDK还需要根据置信度、位置等信息确定需要处理的目标。
例如:
Face 1 → confidence 0.98
Face 2 → confidence 0.91
Face 3 → confidence 0.37
通常会根据实际业务场景设置阈值:
if (face.confidence < 0.5f) {
    return;
}
当然,真实商业SDK中的检测模型远比这个示例复杂,还需要考虑侧脸、遮挡、快速运动、不同光照以及不同设备性能等情况。
三、关键点定位决定了美型能做到什么程度
仅仅知道“脸在哪里”还不够。
如果要实现大眼、瘦脸、下巴调整、嘴型调整等功能,系统还需要知道眼睛、鼻子、嘴巴以及脸部轮廓具体位于什么位置。
因此,检测之后通常还会进行人脸关键点定位。
例如可以抽象成:
struct Landmark {
    float x;
    float y;
};
std::vector<Landmark> points =
    landmarkDetector.detect(frame, face);
最终可能得到几十甚至上百个人脸关键点。
这些点可以进一步构成:
左眼区域
右眼区域
鼻部区域
嘴唇区域
脸颊区域
下颌轮廓
眉毛区域
关键点并不是单纯为了“画点”,而是给后续算法提供几何参考。
例如,计算两眼中心距离:
float eyeDistance =
    distance(leftEyeCenter, rightEyeCenter);
再根据眼睛区域进行局部变形,就可以实现类似“大眼”的效果。
四、磨皮的核心不是简单模糊
最容易被误解的功能之一就是磨皮。
如果直接对整张人脸执行Gaussian Blur:
blur(faceImage, radius);
虽然皮肤纹理会被削弱,但眼睛、眉毛、嘴唇等高频细节同样会受到影响,最终画面容易出现明显的塑料感。
实际的实时美颜通常需要先确定皮肤区域,再对皮肤区域进行针对性处理。
可以将皮肤Mask表示为:
Mask skinMask = detectSkinRegion(frame, face);
然后按照Mask控制处理强度:
for (pixel : frame) {
    float alpha = skinMask[pixel];
    output[pixel] =
        original[pixel] * (1.0f - alpha)
        + smooth[pixel] * alpha;
}
这里的
alpha 可以理解为该像素参与磨皮的权重。
皮肤区域权重较高,而眼睛、眉毛、嘴唇等区域权重则可以降低。
这也是为什么成熟的美颜算法通常不是简单地“整张脸模糊”。
五、瘦脸和大眼实际上属于几何变形
与磨皮不同,美型更多涉及图像几何变换。
例如瘦脸,本质上可以理解为改变脸部轮廓附近像素的空间映射关系:
Source Coordinate
       ↓
Warp Function
       ↓
Destination Coordinate
简单抽象为:
Point warp(Point p, FaceModel model)
{
    // 根据人脸模型计算新的坐标
    return transformedPoint;
}
例如对于距离脸部中心较近的像素,可以设置不同的位移权重:
float weight = calculateWeight(p, faceCenter);
Point result;
result.x = p.x + offsetX * weight;
result.y = p.y + offsetY * weight;
真正的算法实现会更加复杂,可能涉及局部坐标系、三角网格、径向变形或者其他Warp算法。
如果使用三角网格,可以将人脸区域划分为多个Triangle:
P1 -------- P2
 | \        |
 |   \      |
 |     \    |
 |       \  |
 P3 -------- P4
移动关键点后,再重新计算三角形顶点对应的纹理坐标,从而实现局部几何变形。
六、滤镜为什么可以实时运行?
滤镜通常属于像素级处理。
例如最简单的亮度调整:
rgb.r *= brightness;
rgb.g *= brightness;
rgb.b *= brightness;
或者进行颜色矩阵变换:
R'   [a b c]   R
G' = [d e f] × G
B'   [g h i]   B
在GPU中,可以通过Fragment Shader直接完成。
例如一个非常简化的GLSL示例:
precision mediump float;
uniform sampler2D uTexture;
uniform float uBrightness;
varying vec2 vTexCoord;
void main()
{
    vec4 color = texture2D(uTexture, vTexCoord);
    color.rgb += uBrightness;
    gl_FragColor = color;
}
这种方式的优势在于,大量像素可以交给GPU并行计算,而不是由CPU逐个处理。
对于直播场景来说,这一点非常重要。
七、贴纸和妆容依赖实时人脸追踪
为什么直播中的眼镜、耳饰、口红或者动态贴纸可以跟着人物移动?
核心原因仍然是人脸关键点和追踪。
例如眼镜可以根据双眼关键点计算位置:
Point center =
    (leftEyeCenter + rightEyeCenter) * 0.5f;
float angle =
    atan2(rightEyeCenter.y - leftEyeCenter.y,
           rightEyeCenter.x - leftEyeCenter.x);
通过两个眼睛的位置,可以得到贴纸中心、旋转角度以及大致缩放比例。
随后将贴纸纹理按照计算出的Transform矩阵进行渲染:
Translation
     +
Rotation
     +
Scale
     ↓
Sticker Transform
     ↓
GPU Rendering
因此,所谓“贴纸跟脸走”,本质上是一个持续更新的实时坐标变换过程。
八、真正的难点是性能,而不是单独实现某一个算法
假设一套美颜流程包含:
人脸检测
+
关键点
+
皮肤分割
+
磨皮
+
美型
+
滤镜
+
贴纸
如果每个模块都独立读取和写入一次完整图像,就可能产生大量内存拷贝。
假设一帧1080P RGBA图像:
1920 × 1080 × 4
≈ 8.3 MB
如果多个模块反复创建临时Buffer,内存带宽压力会迅速增加。
因此,在实际SDK设计中,经常需要考虑:
Texture复用
Buffer复用
减少CPU/GPU拷贝
GPU Pipeline
异步处理
线程调度
模型量化
不同分辨率策略
例如可以设计成:
Camera Texture
      ↓
Face Detection
      ↓
Landmark
      ↓
Beauty Shader
      ↓
Reshape Shader
      ↓
Filter Shader
      ↓
Sticker Shader
      ↓
Output Texture
尽可能让多个处理阶段直接在GPU纹理之间完成,而不是每一步都把数据拉回CPU。
九、最后还要进入编码和推流链路
美颜处理完成之后,得到的依然只是一帧视频图像。
如果用于直播,还需要进入编码模块。
典型流程可以表示为:
Camera
 ↓
Beauty SDK
 ↓
Processed Frame
 ↓
H.264 / H.265 Encoder
 ↓
Packet
 ↓
RTMP / WebRTC / SRT
 ↓
Streaming Server
 ↓
Player
因此,一个真正用于直播APP的视频美颜SDK,实际上处于“摄像头采集”和“视频编码推流”之间。
这也意味着SDK不仅要考虑美颜效果,还必须处理分辨率、帧率、时间戳、线程同步以及不同设备兼容性等工程问题。
十、从开发角度重新理解“美颜SDK”
如果只从用户角度看,美颜可能就是一个按钮:
美颜:ON
但从开发角度看,它背后可能是一条完整的实时计算Pipeline:
视频采集
    ↓
颜色空间处理
    ↓
人脸检测
    ↓
关键点定位
    ↓
人脸追踪
    ↓
区域Mask
    ↓
皮肤处理
    ↓
几何变形
    ↓
滤镜
    ↓
妆容/贴纸
    ↓
GPU渲染
    ↓
视频编码
    ↓
直播推流
其中每一个节点都可能成为性能瓶颈。
因此,视频美颜SDK真正需要解决的问题,并不是“能不能把脸变漂亮”,而是如何在有限的移动端算力下,让算法效果、实时性、稳定性和画面质量达到一个合理的平衡。
对于直播APP开发者来说,理解这条处理链路也很重要。因为当出现“美颜延迟”“脸部跟踪漂移”“画面卡顿”“高端机正常、低端机掉帧”等问题时,真正需要排查的往往并不是某一个简单的按钮,而是从视频采集到GPU渲染、再到编码推流的整个实时处理链路。
这也是视频美颜SDK与普通图片滤镜之间最明显的技术区别。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70044776/viewspace-3184322/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 直播APP女主播的美颜功能是如何实现的?视频美颜SDK开发详解
- 视频美颜SDK如何融入直播推流链路?开发者需要了解这些技术细节
- 直播APP开发选择美颜sdk还是自研?从技术投入角度分析
- 实时美颜SDK、编码、推流如何协同工作?直播APP完整技术链路解析
- Android与iOS直播APP美颜有什么区别?视频美颜SDK开发详解
- 开发直播APP时,美颜功能最难解决的技术问题有哪些?
- 直播APP开发实战:从摄像头调用到视频美颜sdk集成
- 视频美颜SDK选型从哪里入手?一份面向直播APP开发者的指南
- 视频美颜SDK如何应用于直播APP?功能模块与接入流程详解
- 美颜效果、流畅度、功耗如何平衡?直播APP开发中的技术难题
