这可能是最简短的线程池分析文章了。
顶层设计,定义执行接口
Interface Executor(){
void execute(Runnable command);

}
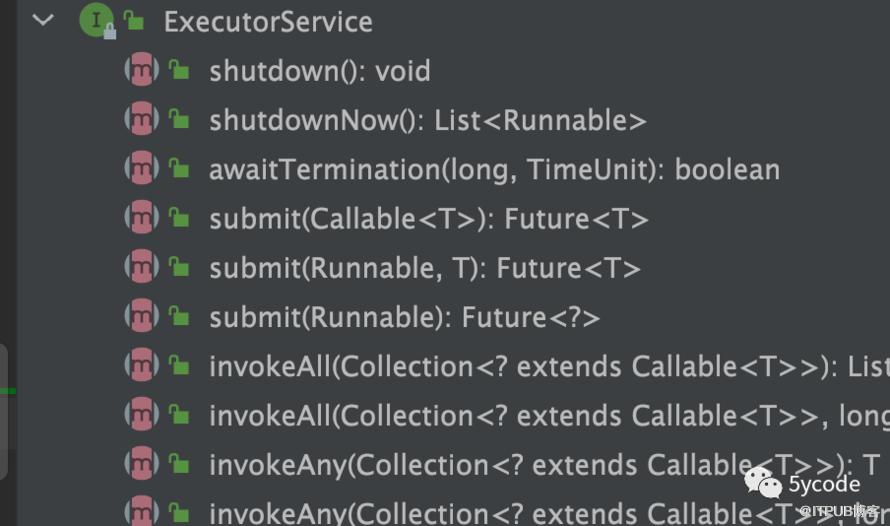
ExecutorService,定义控制接口
interface ExecutorService extends Executor{

}
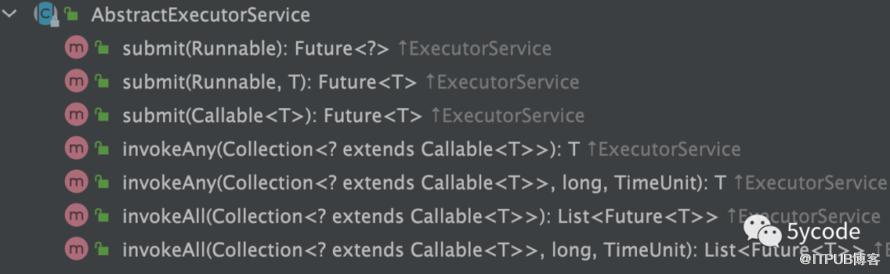
抽象实现ExecutorService中的大部分方法
abstract class AbstractExecutorService implements ExecutorService{
//此处把ExecutorService中的提交方法都实现了
}
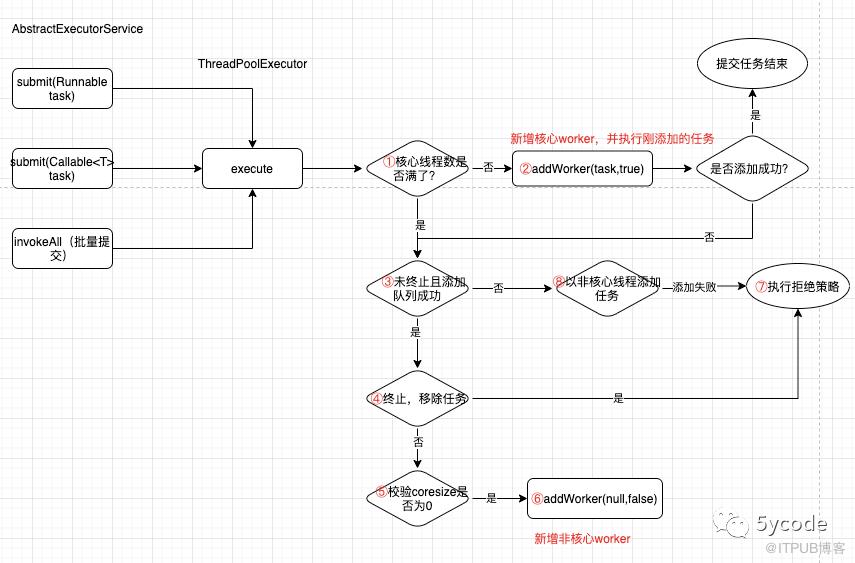
我们看下提交中的核心
public void execute(Runnable command) {if (command == null)throw new NullPointerException();int c = ctl.get();if (workerCountOf(c) < corePoolSize) { // ①//核心线程数没有满就继续添加核心线程if (addWorker(command, true)) // ②return;c = ctl.get();}if (isRunning(c) && workQueue.offer(command)) { // ③int recheck = ctl.get();if (! isRunning(recheck) && remove(command))// ④reject(command); //⑦else if (workerCountOf(recheck) == 0) // ⑤//如果worker为0,则添加一个非核心worker,所以线程池里至少有一个线程addWorker(null, false);// ⑥}//队列满了以后,添加非核心线程else if (!addWorker(command, false))// ⑧reject(command);//⑦}
这里就会有几道常见的面试题
1,什么时候用核心线程,什么时候启用非核心线程?
添加任务时优先使用核心线程,核心线程满了以后,任务放入队列中。只要队列不填满,就一直使用核心线程执行任务(代码①②)。
当队列满了以后开始使用增加非核心线程来执行队列中的任务(代码⑧)。
2,0个核心线程,2个非核心线程,队列100,添加99个任务是否会执行?
会执行,添加队列成功后,如果worker的数量为0,会添加非核心线程执行任务(见代码⑤⑥)
3,队列满了会怎么样?
队列满了,会优先启用非核心线程执行任务,如果非核心线程也满了,那就执行拒绝策略。
4,submit 和execute的区别是?
submit将执行任务包装成了RunnableFuture,最终返回了Future,executor 方法执行无返回值。
addworker实现
ThreadPoolExecutor extends AbstractExecutorService{//保存所有的执行线程(worker)HashSet<Worker> workers = new HashSet<Worker>();//存放待执行的任务,这块具体由指定的队列实现BlockingQueue<Runnable> workQueue;public ThreadPoolExecutor(int corePoolSize,int maximumPoolSize,long keepAliveTime,TimeUnit unit,BlockingQueue<Runnable> workQueue,ThreadFactory threadFactory,RejectedExecutionHandler handler){}//添加执行workerprivate boolean addWorker(Runnable firstTask, boolean core) {//这里每次都会基础校验和cas校验,防止并发无法创建线程,retry:for(;;){for(;;){if (compareAndIncrementWorkerCount(c))break retry;c = ctl.get(); // Re-read ctlif (runStateOf(c) != rs)continue retry;}}try{//创建一个workerw = new Worker(firstTask);final Thread t = w.thread;try{//加锁校验,添加到workers集合中workers.add(w);}//添加成功,将对应的线程启动,执行任务t.start();}finally{//失败执行进行释放资源addWorkerFailed(Worker w)}}//Worker 是对任务和线程的封装private final class Worker extends AbstractQueuedSynchronizer implements Runnable{//线程启动后会循环执行任务public void run() {runWorker(this);}}//循环执行final void runWorker(Worker w) {try{while (task != null || (task = getTask()) != null) {//执行前的可扩展点beforeExecute(wt, task);try{//执行任务task.run();}finally{//执行后的可扩展点,这块也把异常给吃了afterExecute(task, thrown);}}//这里会对执行的任务进行统计}finally{//异常或者是循环退出都会走这里processWorkerExit(w, completedAbruptly);}}//获取执行任务,此处决定runWorker的状态private Runnable getTask() {//worker的淘汰策略:允许超时或者工作线程>核心线程boolean timed = allowCoreThreadTimeOut || wc > corePoolSize;//满足淘汰策略且...,就返回null,交由processWorkerExit去处理线程if ((wc > maximumPoolSize || (timed && timedOut))&& (wc > 1 || workQueue.isEmpty())) {if (compareAndDecrementWorkerCount(c))return null;continue;}// 满足淘汰策略,就等一定的时间poll(),不满足,就一直等待take()Runnable r = timed ?workQueue.poll(keepAliveTime, TimeUnit.NANOSECONDS) :workQueue.take();}//处理任务退出(循环获取不到任务的时候)private void processWorkerExit(Worker w, boolean completedAbruptly) {//异常退出的,不能调整线程数的if (completedAbruptly) // If abrupt, then workerCount wasn't adjusteddecrementWorkerCount();//不管成功或失败,都执行以下逻辑//1,计数,2,减去一个线程completedTaskCount += w.completedTasks;//将线程移除,并不关心是否非核心workers.remove(w);//如果是还是运行状态if (!completedAbruptly) {//正常终止的,处理逻辑int min = allowCoreThreadTimeOut ? 0 : corePoolSize;//核心线程为0 ,最小值也是1if (min == 0 && ! workQueue.isEmpty())min = 1;//总线程数大于min就不再添加if (workerCountOf(c) >= min)return; // replacement not needed} //异常退出一定还会添加worker,正常退出一般不会再添加线程,除非核心线程数为0addWorker(null, false);}}

这里涉及到几个点:
1,任务异常以后虽然有throw异常,但是外面有好几个finally代码;
2,在finally中,进行了任务的统计以及worker移除;
3,如果还有等待处理的任务,最少添加一个worker(不管核心线程数是否为0)
这里会引申出来几个面试题:
1, 线程池中核心线程数如何设置?
cpu密集型:一般为核心线程数+1,尽可能减少cpu的并行;
IO密集型:可以设置核心线程数稍微多些,将IO等待期间的空闲cpu充分利用起来。
2,线程池使用队列的意义?
a)线程的资源是有限的,且线程的创建成本比较高;
b) 要保证cpu资源的合理利用(不能直接给cpu提一堆任务,cpu处理不过来,大家都慢了)
c) 利用了削峰填谷的思想(保证任务执行的可用性);
d) 队列过大也会把内存撑爆。
3,为什么要用阻塞队列?而不是非阻塞队列?
a) 利用阻塞的特性,在没有任务时阻塞一定的时间,防止资源被释放(getTask和processWorkExit);
b) 阻塞队列在阻塞时,CPU状态是wait,等有任务时,会被唤醒,不会占用太多的资源;
线程池有两个地方:
1,在execute方法中(提交任务时),只要工作线程为0,就至少添加一个Worker;
2,在processWorkerExit中(正常或异常结束时),只要有待处理的任务,就会增加Worker
所以正常情况下线程池一定会保证所有任务的执行。
我们在看下ThreadPoolExecutor中以下几个方法
public boolean prestartCoreThread() {return workerCountOf(ctl.get()) < corePoolSize &&addWorker(null, true);}void ensurePrestart() {int wc = workerCountOf(ctl.get());if (wc < corePoolSize)addWorker(null, true);else if (wc == 0)addWorker(null, false);}public int prestartAllCoreThreads() {int n = 0;while (addWorker(null, true))++n;return n;}
确保了核心线程数必须是满的,这些方法特别是在批处理的时候,或者动态调整核心线程数的大小时很有用。
我们再看下Executors中常见的创建线程池的方法:
一、newFixedThreadPool 与newSingleThreadExecutor
public static ExecutorService newFixedThreadPool(int nThreads) {return new ThreadPoolExecutor(nThreads, nThreads,0L, TimeUnit.MILLISECONDS,new LinkedBlockingQueue<Runnable>());}public static ExecutorService newSingleThreadExecutor() {return new FinalizableDelegatedExecutorService(new ThreadPoolExecutor(1, 1,0L, TimeUnit.MILLISECONDS,new LinkedBlockingQueue<Runnable>()));}public LinkedBlockingQueue() {this(Integer.MAX_VALUE);}
特点:
1,核心线程数和最大线程数大小一样(唯一不同的是,一个是1,一个是自定义);
2,队列用的是LinkedBlockingQueue(长度是Integer.Max_VALUE)
当任务的生产速度大于消费速度后,很容易将系统内存撑爆。
二、 newCachedThreadPool 和
public static ExecutorService newCachedThreadPool() {return new ThreadPoolExecutor(0, Integer.MAX_VALUE,60L, TimeUnit.SECONDS,new SynchronousQueue<Runnable>());}
特点:最大线程数为Integer.MAX_VALUE
当任务提交过多时,线程创建过多容易导致无法创建
三、 newWorkStealingPool
public static ExecutorService newWorkStealingPool(int parallelism) {return new ForkJoinPool(parallelism,ForkJoinPool.defaultForkJoinWorkerThreadFactory,null, true);}
这个主要是并行度,默认为cpu的核数。
四、newScheduledThreadPool
public static ScheduledExecutorService newScheduledThreadPool(int corePoolSize) {return new ScheduledThreadPoolExecutor(corePoolSize);}
封装起来的要么最大线程数不可控,要么队列长度不可控,所以阿里规约里也不建议使用Executors方法创建线程池。
ps:
生产上使用线程池,最好是将关键任务和非关键任务分开设立线程池,非关键业务影响关键业务的执行。
原文作者:5ycode;如有侵权,请联系管理员删除。

最新文章
- DeepSeek+ragflow构建企业知识库之工作流,突然觉的dify又香了
- dify1.0.0版本升级及新功能预览
- DeepSeek+ragflow构建企业知识库:突然觉的dify不香了(1)
- DeepSeek官方充值终于开放了,相关工具推荐
- 聊聊dify权限验证的三种方案及实现
- DeepSeek+dify 工作流应用,自然语言查询数据库信息并展示
- DeepSeek+dify知识库,查询数据库的两种方式(api+直连)
- DeepSeek+dify 本地知识库:高级应用Agent+工作流
- 腾讯有Dify团队吗?difySandbox成了腾讯Dify团队开源的
- Deepseek+Dify本地知识库相关问题汇总
