MySQL 本身具备生产binlog日志的功能,在InnoDB存储引擎中,为了持久性有了redo log,为了原子性和隔离性有了undo log,最终通过redo log undo log 保证了一致性;
我先画一个InnoDB操作流程,先简单的了解下它们的工作机制

WAL
在MySQL里,我们必须要了解一个概念WAL。
什么是WAL呢?
WAL全称:Write-Ahead Logging,可以理解为日志先行,InnoDB在有insert、update、delete的时候,都是先写日志,再写磁盘。
为什么这样呢?
效率
当你操作多条数据的时候,操作的数据分布在磁盘的不同位置,如果这个时候直接操作磁盘,你得先一次读I/O,再一次写I/O,由于读写来回切换,磁盘磁头的寻址会耗费很长的时候(相对cpu)。当并发量上来的时候,磁盘压根就承受不住。
为了crash-safe,InnoDB引入了两阶段提交
什么意思呢?
在InnoDB中,binlog 和redo log 是分别独立的逻辑,通过两阶段提交来保证数据的一致性;
InnoDB操作DML的时候,先从磁盘中将数据读取到Buffer pool中;
然后执行器将这条数据备份到undo log 里(undo log 和事务id挂钩);
开始事务
第一阶段:prepare阶段
执行器更新内存中的数据,形成脏页,根据不同的隔离级别决定脏页能不能被查询到;
将实际的修改的数据的物理信息先写到redo log buffer中
redo log 刷盘(redo log 有自己的刷盘机制,可以立即刷盘,也可以操作系统刷盘,也可以配置多少个后刷盘)
执行器将修改写入binlog 缓冲区
Binlog 有自己的刷盘机制
第二阶段commit
redo log 变为提交(commit)状态
事务提交失败
InnoDB 根据事务对应的undo log 回滚
如果因为故障重启
MySQL对prepare阶段的数据进行验证,
如果已经写入到binlog里了(可能已经同步给了从库),继续commit,并更改磁盘的数据;
如果未写入到binlog 可以直接废弃(如果是强一致,每次binlog每次都要刷盘,性能可能会受损)
两阶段提交,并没有操作真正的数据文件,是围绕着3个文件文件redo log、undo log、binlog 这个三个日志文件。有几个特点
不管你多少并发,就这3个文件,磁盘磁头的寻址,也在这个3个文件上;
每次提交都是利用磁盘的顺序写(磁盘的顺序写性能可以媲美内存的随机写)
我们上面讲到的都是缓冲区的操作,具体的刷盘机制,我们在各个日志里面详解。
我们可以看下网上关于磁盘顺序读写的的测试:

感兴趣的同学,可以测试下
Windows : AS SSD Benchmark 和DiskMark
Linux :fio 工具
顺序读:fio -name iops -rw=read -bs=4k -runtime=60 -iodepth 32 -filename /dev/sda -ioengine libaio -direct=1

随机读:fio -name iops -rw=randread -bs=4k -runtime=60 -iodepth 32 -filename /dev/sda -ioengine libaio -direct=1

顺序写:fio -name iops -rw=write -bs=4k -runtime=60 -iodepth 32 -filename /dev/sda -ioengine libaio -direct=1

随机写:fio -name iops -rw=randwrite -bs=4k -runtime=60 -iodepth 32 -filename /dev/sda -ioengine libaio -direct=1
binlog
MySQL本身产生的二进制日志 ,所有的引擎都可以使用
只记录DML语句不记录查询语句
是逻辑日志,记录的是语句的原始逻辑(你可以简单理解为执行的sql,格式不同呈现不同)
每一条binlog是一个event
单纯的binlog 只能用于归档,不具备crash-safe的能力
InnoDB引擎为了解决crash-safe,利用binlog+redo log 实现了crash-safe能力;
binlog日志是持续追加的,固定文件大小(多种机制会切换到下一个)
binlog 格式
怎么查看呢?
物理存储格式查看
[root@dev214 data]# hexdump -Cv mysql-bin.000006 |more
00000000  fe 62 69 6e dd 50 e2 62  0f d6 00 00 00 77 00 00  |.bin.P.b.....w..|
00000010  00 7b 00 00 00 00 00 04  00 35 2e 37 2e 33 30 2d  |.{.......5.7.30-|
00000020  6c 6f 67 00 00 00 00 00  00 00 00 00 00 00 00 00  |log.............|
00000030  00 00 00 00 00 00 00 00  00 00 00 00 00 00 00 00  |................|
00000040  00 00 00 00 00 00 00 00  00 00 00 00 00 00 00 13  |................|
00000050  38 0d 00 08 00 12 00 04  04 04 04 12 00 00 5f 00  |8............._.|
00000060  04 1a 08 00 00 00 08 08  08 02 00 00 00 0a 0a 0a  |................|
00000070  2a 2a 00 12 34 00 01 8e  3e c4 d8 dd 50 e2 62 23  |**..4...>...P.b#|
结构化数据查看
 mysqlbinlog --no-defaults -vvv --base64-output=decode-rows mysql-bin.000006 |less

 这是一个Table_map 类型的event
 # at 2782
- 偏移量
#220728 17:03:25 server id 214  end_log_pos 2865 CRC32 0xf4377c2a       Table_map: `innodb_space`.`t_user_info` mapped to number 114
- 220728 17:03:25  时间戳
- server id 来源
- end_log_pos 结束偏移量为2865
- CRC32 event的crc校验码,用于校验完整性
- Table_map event类型

这是一个Write_rows类型的event
# at 2865
#220728 17:03:25 server id 214  end_log_pos 3007 CRC32 0x78280dc6       Write_rows: table id 114 flags: STMT_END_F
write的具体内容
### INSERT INTO `innodb_space`.`t_user_info`
### SET
###   @1=23822512 /* LONGINT meta=0 nullable=0 is_null=0 */
###   @2='23dad1c20e5411ed9423fefcfef86b' /* VARSTRING(90) meta=90 nullable=0 is_null=0 */
###   @3='13023822512' /* VARSTRING(33) meta=33 nullable=0 is_null=0 */
###   @4='23dadfc90e5411ed9423fefcfef86b49' /* VARSTRING(96) meta=96 nullable=0 is_null=0 */
###   @5='23dae' /* VARSTRING(30) meta=30 nullable=0 is_null=0 */
###   @6='1' /* STRING(3) meta=65027 nullable=0 is_null=0 */
###   @7=1001 /* SHORTINT meta=0 nullable=1 is_null=0 */
###   @8='2020-04-30 04:33:28' /* DATETIME(0) meta=0 nullable=0 is_null=0 */
###   @9='2020-04-30 04:33:28' /* DATETIME(0) meta=0 nullable=1 is_null=0 */
大家只需要了解几个常见的即可
Format_desc:mysql的版本、binlog的版本,该binlog文件的创建时间,一般在文件的前几行
Query:记录事务的操作,事务开始时,执行的begin操作,statement格式中DML操作,Row格式中的DDL操作
Table_map:包含 table id 具体表名的映射关系。
Write_rows/update_rows/delete_rows:分别对应insert、update、delete语句生成的Event, 包含实际数据(insert包含插入值、update不仅包含修改后的值,还包含修改前的值、delete只有主键)
Xid:当事务提交的时候记录 其中携带了 XID 信息
用途:
备份、集群(通过binlog同步增量数据,保证集群架构数据的一致性)
数据恢复,通过最近备份+binlog 能恢复到任意一个时间点;
格式:一共有3种格式
statement (statement-based replication, SBR): 记录的是sql原文
使用函数now()恢复时,不是当时操作的时间,而是恢复时的时间,会导致覆盖范围不一致
Last_insert_id()
日志量小,减少磁盘I/O
row(row-based replication, RBR): 记录的是具体操作的数据,一行行的
量大,对磁盘、网络I/O压力较大
alter table后会让日志暴涨,引起主从延迟
mixed(mixed-based replication, MBR): 混合记录
能明确到具体数据的,使用statement
会产生歧义的,使用row
写入机制:
事务执行的时候,会把sql写到
binlog cache里事务提交的时候,把
binlog cache里的数据刷到binlog文件里(这块也得看配置)
binlog_cache
每个线程一个
binlog cache默认32kb在MySQL中有个
max_binlog_cache_size参数,我们看下binlog 缓存的使用流程事务执行优先写入到线程里的
binlog_cache里,如果事务大,写满了,会写入到临时binlog_cache里临时binlog_cache_size= max_binlog_cache_size - (连接数*32k),属于共享缓存临时binlog_cache_size写满,就会报
Error_code:1197当大事务过多的时候,如果又没有对mysql进行单独的优化,很容易报错,所以在mysql中不建议大事务
刷盘参数:sync_binlog
控制事务提交时,binlog日志多久刷到磁盘
配置值为0~n的整数
0 表示每次提交事务,只写到
binlog_cache中,由操作系统判断什么时候fsync到磁盘默认值为1,表示每次提交事务的时候,都会把之前的binlog 刷入到磁盘
2~n的时候,表示积累n个事务后fsync到磁盘
主从复制
说到binlog 我们就不得不说下主从复制,单纯的binlog只是存储在本地,当使用mysql集群后,主库的DML操作,会通过binlog网络传输到从库,从而实现主从复制;
复制策略
主从复制有以下四种策略
同步策略:
master要等待所有slave应答之后才会提交,性能最低(MySql对DB操作的提交 通常是先对操作事件进⾏binlog⽂件写⼊然后再进⾏提交)半同步策略:
master等待⾄少⼀个slave应答就可以提交异步策略:
master不需要等待slave应答就可以提交延迟策略:
slave要⾄少落后master指定的时间
复制模式
基于语句的复制(SBR),是binlog的statement模式,语句
基于行的复制(RBR),是binlog的ROW模式
混合复制(Mixed),明确具体数据的,使用statement,不能明确的使用row
如何实现
生产者:master,记录DML/DDL语句及数据变化到binlog文件里;
消费者:slave 消费到relay log 中继日志里

三个线程:
master:
binlog dump threadbinlog变化时,通知所有的slaveSlave:
I/O thread:接收到binlog events后,写入本地relay-log(中继日志)SQL thread:读取relay-log,根据读取的内容,转换成sql并在slave执行,并将应用记录存放在relay-log.info文件中
redo log
redo log 称为重做日志,是为了在MySQL崩溃或系统,重启MySQL服务时恢复崩溃前的状态,是为了保证数据的持久性和完整性。也可以理解为WAL的应用实现。
InnoDB独有
顺序循环写入ib_logfile0/1 (默认48mb)
Innodb_log_group_home_dir: 指定redo log所在目录Innodb_log_file_size:指定每个redo log 文件大小,默认48mb;Innodb_log_files_in_group: 指定redo log 文件个数,默认2个物理日志:记录的是数据页的物理修改(比如,在32表空间第n号页面中偏移量为m处的值由x更新为y)
产生于MTR(Mini-Transaction 对底层页面的一次原子访问),直白一些,就是开启事务的时候产生
概念
MTR (Mini-Transaction)代表对底层页面的一次原子访问,这个过程会产生redo log;
checkpoint 表示增加checkpoint_lsn的操作的操作过程;
脏页:修改过的数据页
flush 链表:在MTR执行过程中会将修改过的页面加入到 flush 链表,采用的是头插法
Redo log 刷盘的时机
Log buffer 空间不足(占用空间达到一半的时候,会主动刷盘,由innodb_log_buffer_size 控制)
事务提交时(顺序写磁盘 )
定时刷盘(每秒),通过flush链表
服务正常停止
做checkpoint的时候
参数配置
Innodb_flush_log_at_trx_commit
0 表示每秒提交redo buffer -> 系统缓存-> 磁盘(最多丢失1秒)
1(默认值)每次刷入磁盘,最安全,性能最差
2 每次事务提交 刷入系统缓存,master线程每秒执行刷盘操作(操作系统不挂,就没事)
在mysql进行DML操作的时候,会将修改过的数据采用头插法放入flush链表。
缓冲区产生时机
mysql在启动的时候就会向操作系统申请一块连续的内存空间用于存放redo log,这块区域称为redo log buffer,简称 log buffer。
mysql 通过参数innodb_log_buffer_size来指定log buffer的大小,默认16mb。
https://dev.mysql.com/doc/refman/5.7/en/innodb-parameters.html#sysvar_innodb_log_buffer_size
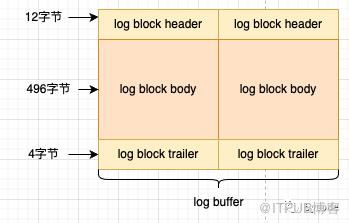
log buffer 是按512字节拆分出一个个的block;
向log buffer 中写入redo log 是顺序写的,从log buffer中刷入到磁盘也是顺序;
Innodb 定义了一个buf free的全局变量,来确定redo log写到 log buffer的哪个位置;
每一条事务的的redo log 是不可分割的(一个事务可能产生多条redo log),一个事务的redo log 可能跨多个block;
LSN
全称 log sequence number
单个mysql的全局变量
用来记录已经写入缓存中的的redo log 的数据量;
如果跨了block,还需要加上log trailer和 log header的大小;
通过不同的
lsn变量来区分哪些在内存,哪些已经写入到了磁盘一旦数据脏页刷入到了磁盘,那么文件中的redo log 就没有意义了,后续重启检测也不会检测这些数据;
mysql 通过 checkpoint_lsn 来表示当前系统中可以被覆盖掉的redo log ;
/** Redo log buffer 的结构 */struct log_t{lsn_t lsn;//缓冲区byte* buf;//空闲buf的偏移指针,从buf_next_to_write 到此都是内存中未写入磁盘的数据ulint buf_free;//缓冲区大小ulint buf_size;//记录缓冲区,可以写入的位置,初始化的时候,只有只有buf_size的一半不到ulint max_buf_free;// flush的时候使用,记录的是log文件的最后偏移量(这个之前的都刷入了磁盘,之后的还没有)ulint buf_next_to_write;//最后写入的lsnlsn_t write_lsn;//当前flush时候的lsn,(同时,可能还会并发的往write_lsn中写入数据)lsn_t current_flush_lsn;//刷新到磁盘的lsnlsn_t flushed_to_disk_lsn}
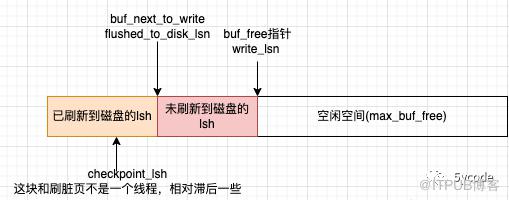
checkpoint
当脏页的数据刷入到磁盘的时候,innodb会把对应的lsn写入到checkpoint_lsn中,这个过程叫checkpoint。
lsn是顺序写,脏页是一个有序链表,脏页的产生也是在redo log的时候产生的
组提交
MySQL为了解决redo log 和binlog 刷盘带来的TPS瓶颈,引入了组提交的概念,将多个刷盘操作合并成一个,如果说100次刷盘的时间成本是100,那么用组提交的方式,将这100个操作刷盘合为1次,时间成本趋近于1。
结合着redo log 和binlog的机制,MySQL将整个过程分为三个阶段,每个阶段增加一个队列来实现组提交。三个阶段为:
Flush 阶段
Sync 阶段
Commit 阶段
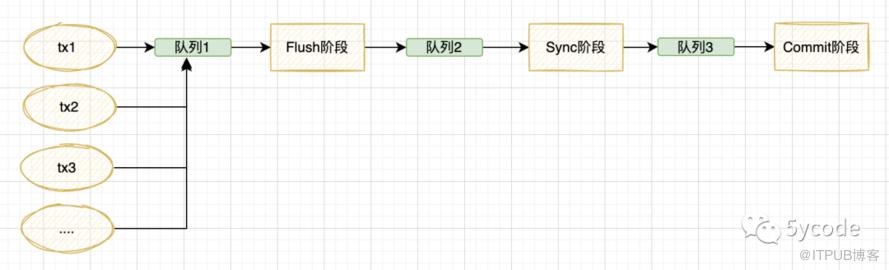
在每个阶段,都有一个队列,这个队列都对应了一把锁,第一个进入队列的事务会成为leader,leader会协调该队列的操作,完成后会通知其他事务操作结束。
Flush阶段
这个阶段维护的队列主要是用来支持redo log prepare 阶段的组提交,将redo log 刷入磁盘,同时,将binlog 写入操作系统的缓冲区,如果在该阶段完成后数据库崩溃,binlog 中不保证有该组事务的记录,MySQL可能会在重启后回滚该组事务。
为什么是可能?
因为binlog写入到的是系统缓冲区,如果操作系统没挂,可能还会刷入binlog文件。
Sync 阶段
该阶段维护的队列,主要是用来支持binlog的组提交,将binlog 刷入磁盘。如果在该阶段完成后数据库崩溃,因为binlog中已经有了事务的记录,重启后会通过prepare 的redo log 继续进行事务的提交。但是这里有个问题,如果业务系统认为失败呢?这里要考虑下业务。
这里通过两个配置来操控
binlog_group_commit_sync_delay=N 等待N 微秒后刷盘
如果在N秒内有多次并发就合并到一次
binlog_group_commit_sync_no_delay_count=N 达到N个事务后就刷盘
这两个参数是只要有一个先达到就执行
Commit阶段
这个阶段维护的队列,主要是将Flush 阶段prepare阶段的事务在引擎层提交,变成Commit。此时prepare阶段数据已经写入文件,commit状态的数据也要写入文件。
undo log
Undo log 称为撤销日志,是MySQL用来记录事务的反向逻辑日志,以达到撤销DML操作,在数据库事务开始之前,将要修改的记录存放在undo 链表里。
undo tablespaceMySQL分配的物理存储空间,直接指向磁盘rollback segment回滚段,undo log 内存的逻辑管理,一个回滚段由1024个槽位;undo log segmentundo log的槽位,每个槽位只能由一个事务占用,一个事务可以占用多个槽位;Undo log 绑定了事务,rowId,回滚指针,以及以及要回滚(备份)的数据
当事务过多,槽位被占满后报
too many active concurrent transactions5.5 之前只有一个回滚段,并且在系统表空间ibdata1里
导致系统表空间持续增大,需要定期重建
IO瓶颈
5.6以后undo log被分离处理,由单独的undo 表空间管理,并且可以支持128个回滚段
5.7 解决了undo log 一直以来的物理空间膨胀问题,可以自动收缩
循环使用,MySQL后台
purge线程来清理事务提交成功以后的undo log日志在事务开启后会先备份数据到undo log,由记录里的隐藏指定回滚指针指向,undo log 链表
逻辑日志,比如你要insert,这里记录的就是将某条记录标记为delete,你要将a由1变为2,这里记录的是将a=1 update为2;
作用
事务的原子性:用于失败回滚到之前的状态
MVCC(多版本并发控制):根据事务的隔离级别在未提交之前,可以将undo log的数据作为快照读
事务ID
全局变量
volatile trx_id_t max_trx_id,开启一次事务,该值+1;定期刷入磁盘;(256倍数的时候,刷到磁盘)
系统重启,直接基于磁盘存储的max_trx_id +2*256
我们看下代码:
/*** 事务系统控制在内存的数据结构,*/struct trx_sys_t {//互斥锁TrxSysMutex mutex;//多版本并发控制MVCC* mvcc;//最大事务id(全局可见),要分配给下一个事务的idvolatile trx_id_t max_trx_id;//通过trx_t:no排序好的活跃事务trx_ut_list_t serialisation_list;//内存中获取和提交的rw事务脸比饿哦通过trx_id倒序排,恢复事务的时候使用trx_ut_list_t rw_trx_list;//给MVCC快照读使用的事务集合,这里保存的是所有,ReadView从这里copy的事务idtrx_ids_t rw_trx_ids;//回滚段trx_rseg_t* rseg_array[TRX_SYS_N_RSEGS]....}UNIV_INLINEtrx_id_ttrx_sys_get_new_trx_id(){/*每次获取事务id的时候,取模256,等于0的刷入磁盘*/if (!(trx_sys->max_trx_id % TRX_SYS_TRX_ID_WRITE_MARGIN)) {//刷入磁盘trx_sys_flush_max_trx_id();}//max_trx_id 是一个volatile 变量return(trx_sys->max_trx_id++);}
purge_pq_t*trx_sys_init_at_db_start(void){//启动的时候,直接+了2倍的256trx_sys->max_trx_id = 2 * TRX_SYS_TRX_ID_WRITE_MARGIN+ ut_uint64_align_up(mach_read_from_8(sys_header+ TRX_SYS_TRX_ID_STORE),TRX_SYS_TRX_ID_WRITE_MARGIN);}
InnoDB启动事务id为要加2*256?
在InnoDB运行的过程中,每当事务达到256的倍数的时候,就会把最大事务id刷入磁盘
如果MySQL突然宕机,部分事务id,可能随着undo log 以及记录刷入了磁盘,在启动时这些记录可能又进入到了内存里
如果直接从磁盘上获取max_trx_id,再重新获取,会导致事务id重复,所以在启动的时候加上2*256,以跳过这些事务id
我们看下undo log的结构
/*** undo log 日志结构*/struct trx_undo_t {//undo log 所在回滚段的槽idulint id;//undo log 类型ulint type; /*!< TRX_UNDO_INSERT or TRX_UNDO_UPDATE *///对应udno log日志段的状态ulint state;// delete语句的标识ibool del_marks;//undo log 产生的事务idtrx_id_t trx_id;//打开xa事务的标识XID xid;//undo log 所在的位置trx_rseg_t* rseg;//所在的空间idulint space;//page的大小page_size_t page_size;//undo log 开始位置所在page的页码ulint hdr_page_no;//在对应page上undo log的偏移量ulint hdr_offset;//undo log 结束在页码,如果不跨页和hdr_page_no相同ulint last_page_no;//undo log的大小ulint size;/*回滚段的链表,是一个双向链表*/UT_LIST_NODE_T(trx_undo_t) undo_list;};
/*** 回滚段的内存结构,这里主要是描述里回滚段的元信息,包括:* 锁、*/struct trx_rseg_t {ulint id;RsegMutex mutex;ulint space;ulint page_no; //该回滚段对应的页码page_size_t page_size;//在当前页面内允许的最大大小(创建的undo log 不能超过这个的大小)ulint max_size;//当前页面大小(已经使用的大小)ulint curr_size;/**update undo log 的列表*/UT_LIST_BASE_NODE_T(trx_undo_t) update_undo_list;/**为快速重用而缓存的更新撤销日志段列表,优先使用这里的*/UT_LIST_BASE_NODE_T(trx_undo_t) update_undo_cached;//历史列表中最后一个尚未清除的日志头的页码;如果所有列表被清除,则FIL_NULLulint last_page_no;//最后一个尚未清除的日志头的字节偏移量ulint last_offset;//最后一个未清除日志的事务idtrx_id_t last_trx_no;}
我们看下几次update形成的undo log 版本链
insert test(id,a,b) VALUES(55,1,2);
update test set a=2,b=4 where id= 55;
update test set a=3,b=6 where id= 55;
update test set a=4,b=5 where id= 55;
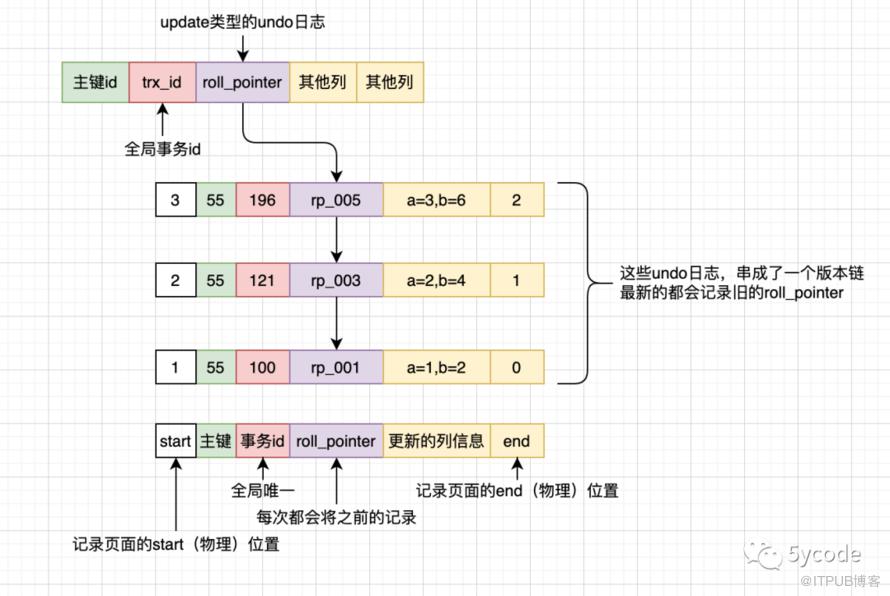
每个事务的undo log 编号undo no都是从0开始
同一条数据的通过回滚指针,将多个事务的版本串联起来;
正常情况一条记录不会同时出现多次修改(InnoDB会加行锁)
后台线程的清理是需要时间的,所以看到的就是一个链式结构;
列信息里记录的是逻辑信息,记录的是当前操作的逆向操作(delete的操作,只是改了一个状态,而不是insert),insert 记录的只是主键id
# undo源码相关
# 操作入口
btr0cur.cc -> btr_cur_del_mark_set_clust_rec 删除操作
           -> btr_cur_ins_lock_and_undo  插入操作
           -> btr_cur_upd_lock_and_undo 更新操作操作

trx0rec.cc -> trx_undo_report_row_operation
trx0undo.cc -> trx_undo_assign_undo  这里会考虑是用缓存还是新创建一个
            -> trx_undo_reuse_cached 缓存中找到一个undo 的空间,就赋值
            -> trx_undo_create 没找到,如果空间足够,初始化一个并赋值
具体的代码我就不粘贴了,我简单的总结下:
undo log 优先使用段缓存的undo log 空间
如果没有缓存空间,就创建并初始化一个undo log 空间
在创建的时候,会判断剩余的空间是否足够,不够就报
too many active concurrent transactions
MVCC 多版本并发控制
MVCC(Mutil-Version Concurrency Control),全称多版本并发,是InnoDB在并发环境下通过记录的版本链来控制数据安全的行为。
多版本的目的是为了避免写事务和读事务的相互等待
多版本的出现是在并发访问的情况
只有insert、update、delete会出现多版本,会生成undo log 版本链
同一条记录的事务执行是从小到大执行
读不加锁,读写不冲突
读的时候不会加锁,但是读到哪个版本,是由隔离级别决定的
MVCC用于READ COMMITTED 和REPEATABLE READ 这两种隔离级别
我们要了解MVCC,就必须了解一些基本概念。
ACID
在使用InnoDB引擎的MySQL中:
原子性(atomicity) 不可分割,表示最小,且是一个整体,要么全成功,要么全失败 ;主要是由undo log 保证,事务中要么全部执行成功 redo log,要么全部执行失败 undo log
一致性(consistency)指的事务开始和结束后,数据库的完整性没有被破坏,保证和客观事实的一致,是将真实业务映射到计算机场景的实现;比如转账 A有100元,B有200元,B给A转了50,事务前和事务后,总账是300;
隔离性(isolation)一个事务的执行不能受其他事务的干扰,每个事务操作都有各自完整的数据空间,我修改的数据只能我自己修改,别人不能修改; 解决的是事务之间的安全和并发能力问题;由undolog 保证,不同的事务操作时,每个事务都有各自完整的空间
持久性(durability)事务提交完成,修改一定不会丢失;解决的是数据安全落地的问题;由redo log 保证,只要事务成功结束,对应的操作就必须永久性的保存下来,即使系统崩溃也能恢复
aid 都是为c服务的,为了达到一致性,你操作的方法必须是原子的,操作成功以后必须永久保存,操作的时候,还必须保证数据的隔离。
隔离级别
我们看下因为隔离级别的问题导致的不一致的现象有哪些?
脏读(dirty read):事务1修改了一行数据,其他事务在事务1提交之前读到了该行数据;
不可重复度(non-repeatable read):事务1读取了一行数据,其他事务修改或删除了该行,当事务1再次读取该行数据时,读到了修改后或已被删除;主要是针对更新;
幻读(phantom):事务1查询到满足某条件的数据集,其他事务在事务1的条件内插入了数据,导致事务1再次以同样的条件查询时,得到的结果集比第一次多;主要是针对插入;InnoDB通过MVCC解决了该问题;
在ANSI SQL STANDARD中定义了四种隔离级别。
Read Uncommitted(读未提交):所有事务都可以看到其他未提交事务的结果;很少用于实际应用;Read Committed(读已提交):一个事务只能只能看见已经提交事务的结果,支持不可重复读,同一事务中同一select可能返回的结果不同;Repeatable Read(可重复读):确保同一个事务同一select(特别是范围读)多次读取,看到同样的结果(MVCC ReadView保证);Serializable(可串行化):最高的隔离级别,通过单线程,强制事务顺序执行,使事务无冲突,性能最低;
在mysql中四种隔离级别从上到下逐步升高,在mysql中Read Uncommitted为0,Read Committed为1,依次递增;
这四种隔离级别可能发生的不一致情况如下:
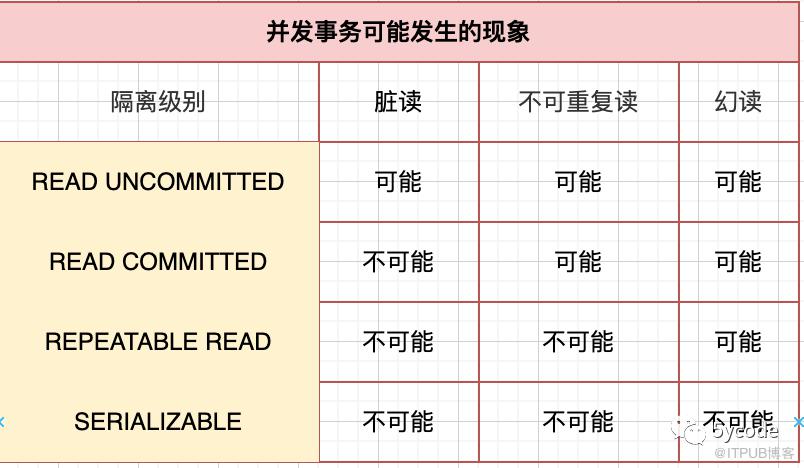
隔离级别的出现,也是为了换取性能的提升,上图从上到下,隔离级别越高;
隔离级别越严格,性能越低,锁的粒度也就越粗
隔离级别越宽松,性能越高,锁粒度也就越细
读操作
想要学习MVCC,我们必须对两种读操作有所了解
快照读:普通的读操作,读取记录中可见版本,不加锁非阻塞,串行化没有这个概念,串行化会退化为当前读
当前读,也叫锁定读
读取记录中
最新版本,并对当前返回的记录加锁,保证其他的事务不能修改当前记录select xx lock in share mode加共享锁sselect xx for update加x锁,排他锁insert(into) /update/delete加x锁,排他锁
快照读:不会存在任何问题,也不需要并发控制;
读写,会有并发的问题,会因为隔离性的问题,造成脏读、幻读、不可重复读,需要MVCC控制;
隐藏字段
为了实现MVCC,InnoDB会向数据库中的每行记录添加三个字段
DB_ROW_ID: 6字节,
DB_TRX_ID:6字节,表示插入或更新的最后一个事务id,删除,内部在mysql内部为更新
DB_ROLL_PTR:7自己接,回滚段指针,指向写入回滚段的撤销日志记录
通过以下sql可以查看
-- 创建的t_account表,只有10个字段CREATE TABLE `t_account` (`id` bigint(20) NOT NULL AUTO_INCREMENT COMMENT '账户id',`uuid` bigint(25) NOT NULL COMMENT '用户唯一标识',`mobile` varchar(11) NOT NULL DEFAULT '0' COMMENT '用户手机号',`pwd` varchar(32) NOT NULL DEFAULT '0' COMMENT '登录密码',`salt` varchar(32) NOT NULL DEFAULT '0' COMMENT '密码盐值',`status` int(2) DEFAULT '0' COMMENT '账户状态,0启用,1禁用',`tenant_id` int(10) DEFAULT '1001' COMMENT '租户id',`proId` varchar(50) DEFAULT NULL COMMENT '注册时渠道号',`create_time` timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间',`updated_time` timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP COMMENT '修改时间',PRIMARY KEY (`id`) USING BTREE,UNIQUE KEY `idx_mobile` (`mobile`) USING HASH,UNIQUE KEY `idx_uuid` (`uuid`) USING BTREE,KEY `idx_create_time` (`create_time`) USING BTREE) ENGINE=InnoDB AUTO_INCREMENT=6 DEFAULT CHARSET=utf8 ROW_FORMAT=COMPACT COMMENT='账户表';-- 通过INNODB_SYS_TABLES查询,n_cols 为13SELECT * from information_schema.INNODB_SYS_TABLES where name LIKE '%t_account%'-- 通过COLUMNS 表查询,只有10个SELECT * from information_schema.COLUMNS where table_name ='t_account' and table_schema='demo'
https://dev.mysql.com/doc/refman/5.7/en/information-schema-innodb-sys-tables-table.html
我们先看官方解释:
n_clols 表中的列数,InnoDB
报告的数字包括由(DB_ROW_ID、DB_TRX_ID和 )创建的三个隐藏列DB_ROLL_PTR我们创建表的语句10个字段,通过INNODB_SYS_TABLES查询,有13个
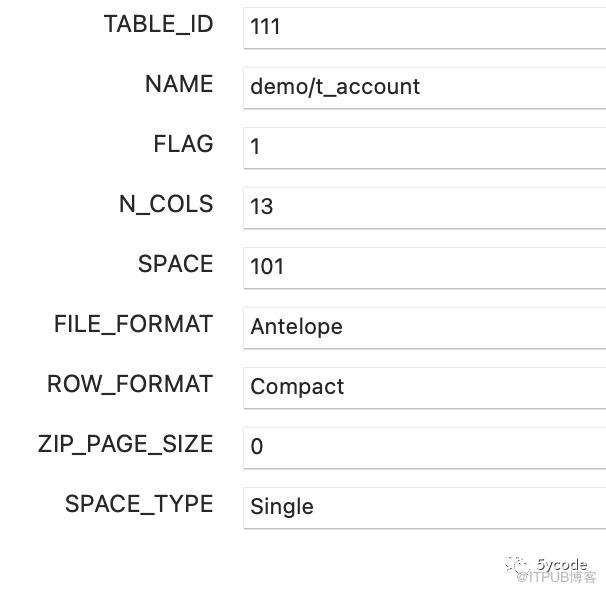
我们通过INNODB_SYS_TABLES查询有13个字段,通过COLUMNS查询,只有10个字段, 那这三个字段怎么填进去呢?我们看下源码
voiddict_table_add_system_columns(dict_table_t* table, /*!< in/out: table */mem_heap_t* heap) /*!< in: temporary heap */{//添加DB_ROW_ID 字段到表对象中dict_mem_table_add_col(table, heap, "DB_ROW_ID", DATA_SYS,DATA_ROW_ID | DATA_NOT_NULL,DATA_ROW_ID_LEN);//添加DB_TRX_ID字段到表对象dict_mem_table_add_col(table, heap, "DB_TRX_ID", DATA_SYS,DATA_TRX_ID | DATA_NOT_NULL,DATA_TRX_ID_LEN);//添加DB_ROLL_PTR 字段到表对象(不是内部表的时候才添加)if (!dict_table_is_intrinsic(table)) {dict_mem_table_add_col(table, heap, "DB_ROLL_PTR", DATA_SYS,DATA_ROLL_PTR | DATA_NOT_NULL,DATA_ROLL_PTR_LEN);}
在storage/innobase/btr/btr0cur.h中,定义了增删改查的方法,每个方法都有个乐观和悲观两种,我们来看下乐观更新的源码。
(感兴趣的同学,可以从row0upd.cc文件中的row_upd_step函数开始看)
row_update_for_mysql_using_upd_graph->row_upd_step ->row_upd ->row_upd_clust_step
ReadView
什么是ReadView? 从字面上来说是读视图,是事务进行快照读操作的时候产生的读视图。
我们先来看下ReadView的代码结构
class ReadView {private:// 高水位:大于这个事务id的都不可见trx_id_t m_low_limit_id;// 低水位:小于这个事务id的可见,小于这个id的都已经提交了,从这个事务id开始一直到m_low_limit_id是当前活跃的事务idtrx_id_t m_up_limit_id;//创建视图的事务idtrx_id_t m_creator_trx_id;//可以理解为创建视图时活跃的事务idids_t m_ids;//小于这个事务id的undo log都不需要考虑,小于的已经提交等待purge线程清理或已经清理trx_id_t m_low_limit_no;//是否被删除bool m_closed;//创建一个ReadView的双向链表typedef UT_LIST_NODE_T(ReadView) node_t;//对应事务里的readviewsbyte pad1[64 - sizeof(node_t)];node_t m_view_list;}
从代码上,我们可以看到
通过
m_low_limit_id和m_up_limit_id构建了一个高低水位,高低水位之间是当时活跃的事务
我们通过代码来看下一致读视图的创建过程
//事务创建的一致读视图ReadView*trx_assign_read_view(trx_t* trx) /*!< in/out: active transaction */{//innodb为只读模式if (srv_read_only_mode) {return(NULL);} else if (!MVCC::is_view_active(trx->read_view)) {//从这里可以看到视图激活以后就不会//创建视图trx_sys->mvcc->view_open(trx->read_view, trx);}return(trx->read_view);}class MVCC {public://MVCC分配并创建一个视图void view_open(ReadView*& view, trx_t* trx);//判断是否处于活动或有效static bool is_view_active(ReadView* view)private:typedef UT_LIST_BASE_NODE_T(ReadView) view_list_t;//可以二次利用的空闲视图view_list_t m_free;//活跃或关闭的视图,关闭视图,将creator_trx_id设置为TRX_ID_MAXview_list_t m_views;}voidMVCC::view_open(ReadView*& view, trx_t* trx){// 如果视图创建以后,没有启动新的读写事务,那么会重用它//重用的时候,会重置m_closed 、m_creator_trx_id、m_low_limit_idif (view != NULL) {uintptr_t p = reinterpret_cast<uintptr_t>(view);view = reinterpret_cast<ReadView*>(p & ~1);if (trx_is_autocommit_non_locking(trx) && view->empty()) {//重置m_closedview->m_closed = false;if (view->m_low_limit_id == trx_sys_get_max_trx_id()) {return;} else {view->m_closed = true;}}} else {//加锁mutex_enter(&trx_sys->mutex)//优先从可二次利用的链表里取ReadView,没有才创建view = get_view();}if (view != NULL) {//这里重置了m_creator_trx_id 和 m_low_limit_idview->prepare(trx->id);view->complete();UT_LIST_ADD_FIRST(m_views, view);}//获取视图ReadView*MVCC::get_view(){ReadView* view;//如果有空闲的,优先使用空闲的,并从空闲链表中移除头部节点if (UT_LIST_GET_LEN(m_free) > 0) {view = UT_LIST_GET_FIRST(m_free);UT_LIST_REMOVE(m_free, view);} else {view = UT_NEW_NOKEY(ReadView());if (view == NULL) {ib::error() << "Failed to allocate MVCC view";}}return(view);}//初始化视图void ReadView::prepare(trx_id_t id){//将当前的事务id赋值给m_creator_trx_idm_creator_trx_id = id;// 设置高水位m_low_limit_id 和m_low_limit_nom_low_limit_no = m_low_limit_id = trx_sys->max_trx_id;if (!trx_sys->rw_trx_ids.empty()) {//从trx_sys_t 中快照一份活跃的数据到ReadViewcopy_trx_ids(trx_sys->rw_trx_ids);} else {m_ids.clear();}if (UT_LIST_GET_LEN(trx_sys->serialisation_list) > 0) {const trx_t* trx;trx = UT_LIST_GET_FIRST(trx_sys->serialisation_list);if (trx->no < m_low_limit_no) {m_low_limit_no = trx->no;}}}voidReadView::complete(){/* 设置低水位事务id */m_up_limit_id = !m_ids.empty() ? m_ids.front() : m_low_limit_id;m_closed = false;}
代码流程图如下:
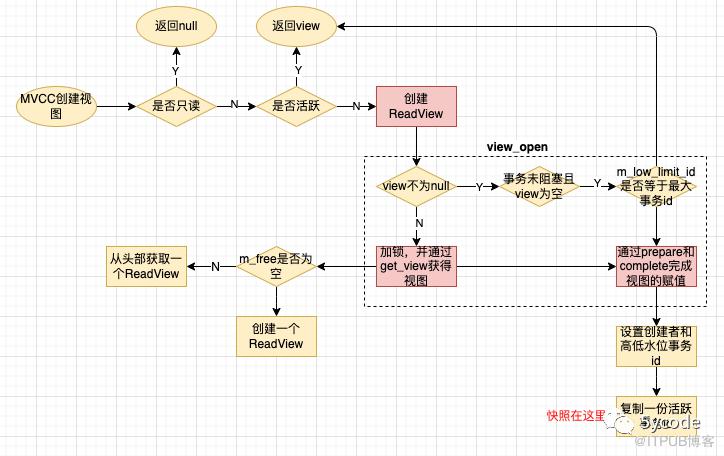
从代码里可以看到
只读模式下,直接返回null(没有写的概念,就没有版本的概念,读都一样)
视图是活跃的情况下就不会创建(所以只有一次机会)
如果之前已经关闭了视图,当前事务会重新利用之前的ReadView
ReadView获取的时候优先从
m_free中获取,没有才重新创建,通过池化提升性能获取
ReadView后会将ReadView中的
不同隔离级别ReadView的创建方式
有了以上的基础,我们再来看下mvcc,在RC和RR下的工作方式。
RC级别
同一个事务里,同一条sql每一次查询都会获得一个新的ReadView,这样就可能导致同一个事务里的重复读问题;
RR级别
同一个事务里,只会获取一次ReadView
其他的隔离级别不会创建ReadView
select 查询逻辑
dberr_trow_search_for_mysql(byte* buf,page_cur_mode_t mode,row_prebuilt_t* prebuilt,ulint match_mode,ulint direction){//不是磁盘临时表if (!dict_table_is_intrinsic(prebuilt->table)) {//我们重点关注这里return(row_search_mvcc(buf, mode, prebuilt, match_mode, direction));} else {//是磁盘临时表,不需要mvccreturn(row_search_no_mvcc(buf, mode, prebuilt, match_mode, direction));}}
我根据row_search_mvcc梳理了下逻辑
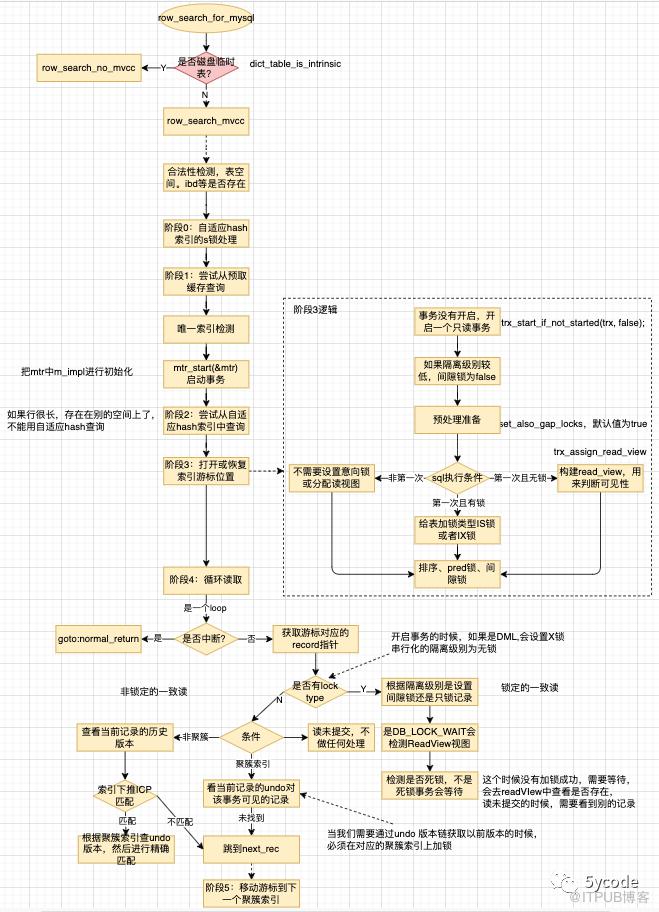
根据上图,做下总结:
进入
row_search_mvcc先进行合法性校验,防止表空间被删除、ibd文件不存在等;查询的时候先从预缓存里获取记录(也就是mysql的缓冲池中,可能之前其他查询拉进去的数据)
接下来开启事务
先从自适应hash索引中查找,如果行比较长,不能使用自适应hash索引(数据页只记录了部分数据)
到了阶段3
第一次执行sql且无锁,构建
Read_view,通过read_view的上下水位来判断可见性第一次执行且有锁,判断是需要给表加意向共享锁还是意向独享锁
非第一次执行(可能是一个事务内的多次执行),啥也不干
最后完成打开或恢复索引游标位置
第四阶段:循环读取
每次进来都会判断是否中断,没有中断,就获取记录指针
然后判断数据页的边界值(infimum 最小和supermum最大)
这里还会对游标碰到页面损坏的时候,进行完整性检查
然后计算对应的record指针的偏移量offset
根据精确查询还是前缀查询加锁
如果有锁类型,就在索引上放一把锁(这个时候根据隔离级别还有别的逻辑做了特殊处理),同时未半一致读构建聚簇索引的最后提交版本,最后检查是否有死锁
没有锁类型,
隔离级别为为读未提交的时候,啥也不做,
如果是聚簇索引,需要看看当前记录是否对当前事务可见的数据(从undo log 中获取可用的版本)
非聚簇索引,根据索引下推的匹配结果
如果未匹配到,则直接跳转到
next_rec如果有匹配到,则根据聚簇索引回表,进行精确匹配
MVCC存在幻读么?
不存在的。
MVCC是快照读,通过
read_view来构建视图读未提交的时候,啥也不干
读取的时候,根据隔离级别会从undo log 版本链里读取历史数据(源码里是 old_ver)
同时会加间隙锁,来保证不会插入数据
原文作者:5ycode;如有侵权,请联系管理员删除。

最新文章
- DeepSeek+ragflow构建企业知识库之工作流,突然觉的dify又香了
- dify1.0.0版本升级及新功能预览
- DeepSeek+ragflow构建企业知识库:突然觉的dify不香了(1)
- DeepSeek官方充值终于开放了,相关工具推荐
- 聊聊dify权限验证的三种方案及实现
- DeepSeek+dify 工作流应用,自然语言查询数据库信息并展示
- DeepSeek+dify知识库,查询数据库的两种方式(api+直连)
- DeepSeek+dify 本地知识库:高级应用Agent+工作流
- 腾讯有Dify团队吗?difySandbox成了腾讯Dify团队开源的
- Deepseek+Dify本地知识库相关问题汇总
