PostgreSQL 的控制权,如何从云端回到用户手中?
导读:PostgreSQL 以开放和灵活著称,但当数据库运行在托管服务中,用户是否仍拥有对底层环境、扩展和数据的充分控制权?在 HOW 2026 大会上,OnGres 创始人、StackGres 项目作者 Álvaro Hernández 以《Make Postgres Yours Again》为题,讨论了 PostgreSQL 从传统自建到云数据库托管服务的演进,以及便利性、成本和自主控制权之间的取舍。他还提出了 MSMR(My Server, My Rules)宣言,探讨如何通过开源自动化技术,让用户在自己的基础设施上获得接近云数据库的管理体验。
PostgreSQL 为什么受到越来越多开发者和企业的青睐?丰富的功能、扩展生态、可靠性和活跃的社区都是重要原因。但在 Álvaro 看来,更根本的特征是 开放。
这种开放不仅意味着源代码可以获取,还意味着用户可以自由选择运行环境、安装所需组件,并按自身需求使用数据库,而不必依赖某一家厂商的许可。
然而,随着托管数据库服务普及,PostgreSQL 引擎仍然开源,用户对运行环境的实际控制权却可能受到限制。演讲者据此提出了一个问题: 能否同时获得托管服务的便利性和自建数据库的自主权?
一、PostgreSQL 的部署演进:从自建到基础设施即代码
为了说明这一问题,Álvaro 首先回顾了 PostgreSQL 部署与管理方式的演进。传统自建、基础设施即代码(IaC)与数据库即服务(DBaaS)并不是彼此完全替代的三个阶段,而是至今仍然并存的不同选择。
1. 自建:拥有控制权,也承担运维负担
在传统自建模式下,用户可以自行选择服务器、虚拟机或数据中心,安装操作系统、PostgreSQL 和其他工具,并决定数据库如何运行。
这种方式具有较高的灵活性,但构建一套能够稳定运行在生产环境中的 PostgreSQL,并不是简单地安装一个数据库软件。PostgreSQL 更像是整个数据库运行体系的核心,生产部署通常还需要配套的组件和流程,例如:
- 高可用与故障切换:确保节点故障后能够恢复服务;
- 连接池:管理数据库连接,降低连接开销;
- 备份与时间点恢复(PITR):满足数据恢复需求;
- 监控与告警:观察数据库运行状态并及时发现异常;
- WAL 归档:为持续恢复和备份提供支持;
- 版本升级:规划并执行数据库版本更新。
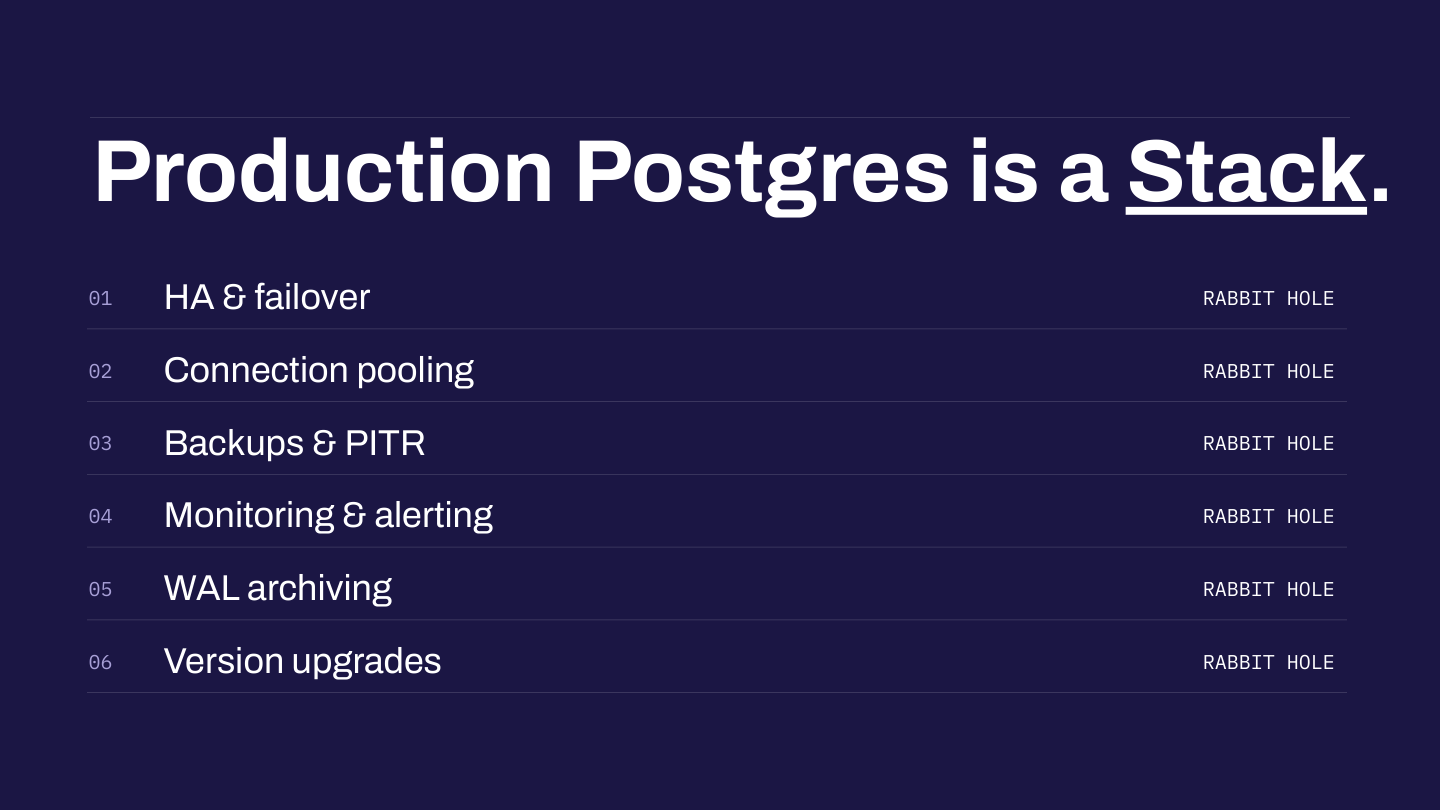
这些组件往往拥有独立的配置方式、依赖关系和维护要求。运维人员既要了解 PostgreSQL 本身,也需要掌握整套外围工具。自建模式赋予用户充分的自主权,同时也意味着较高的技术门槛和持续的运维投入。
2. 基础设施即代码:提高自动化程度,但环境差异仍然存在
随后,Ansible、Terraform、Chef、Puppet 等基础设施自动化工具逐渐普及。通过 IaC,部署配置可以以代码形式保存,纳入版本控制和代码评审,并重复执行。
这在很大程度上改善了传统的手工部署方式,但并没有消除所有问题。即使使用同一套部署代码,不同环境中的网络条件、服务器配置、软件包版本及依赖状态仍可能影响最终结果。因此,实现稳定、可复现的部署,依然需要额外的工程实践和专业知识。
3. DBaaS:便利性推动托管数据库普及
云数据库托管服务带来了不同的使用体验。用户通过控制台、命令行或 API,就可以创建 PostgreSQL 实例,并使用云平台提供的自动化管理能力。
Álvaro 在演讲中明确肯定了托管数据库的价值,也提到自己经常向用户推荐 RDS 等托管服务。与自行搭建完整技术栈相比,托管服务显著降低了数据库交付和日常管理的门槛。
在他看来,推动市场选择托管服务的重要因素可以归结为一个词: 便利性(Convenience)。
不过,便利性并不意味着数据库背后始终有人在手动执行操作。云服务能够快速交付和管理数据库,主要依靠的是自动化软件。这也引出了后续讨论的核心:既然便利性来自软件,能否将类似能力带回自建环境?
二、便利性的另一面:成本、权限与数据主权
选择自建或托管,并不存在适用于所有场景的标准答案。两者在成本、部署位置、系统权限和迁移自由度等方面,有着不同的取舍。
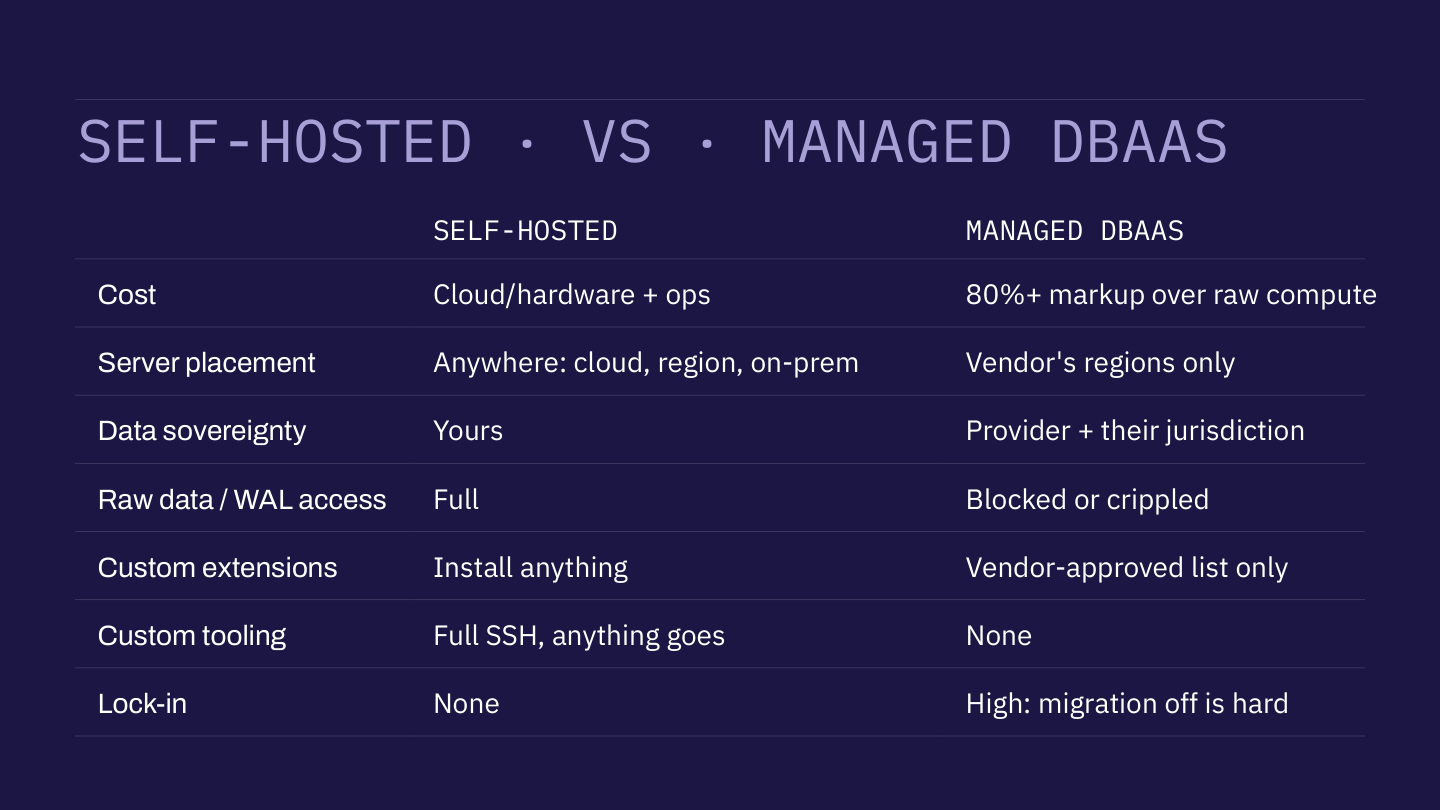
从演讲提出的几个维度来看:
- 成本:自建方案可能降低基础设施资源支出,但需要额外承担部署、监控、备份、维护和故障处理等运维成本;托管服务将一部分管理能力包含在服务价格中。
- 部署位置:自建可根据需要选择本地数据中心、云服务器或其他环境;托管服务的可用区域则取决于服务商。
- 数据主权:自建通常为用户提供更多基础设施控制能力;使用托管服务时,还需要考虑服务商所在地的法律管辖、数据存放位置和访问机制。
- 底层访问与工具安装:自建可获得更完整的操作系统权限,并按需要安装工具与扩展;托管服务通常会对这些能力施加限制,但限制程度因产品而异。
- 复制与迁移:自建环境通常能够直接配置 WAL、物理复制及相关管理工具;托管平台对复制接口及迁移能力的支持存在差异,部分专有功能也可能增加迁移难度。
两组 AWS 成本对比
为了说明基础设施成本的差异,Álvaro 在演讲中展示了两组 AWS 实例价格案例。
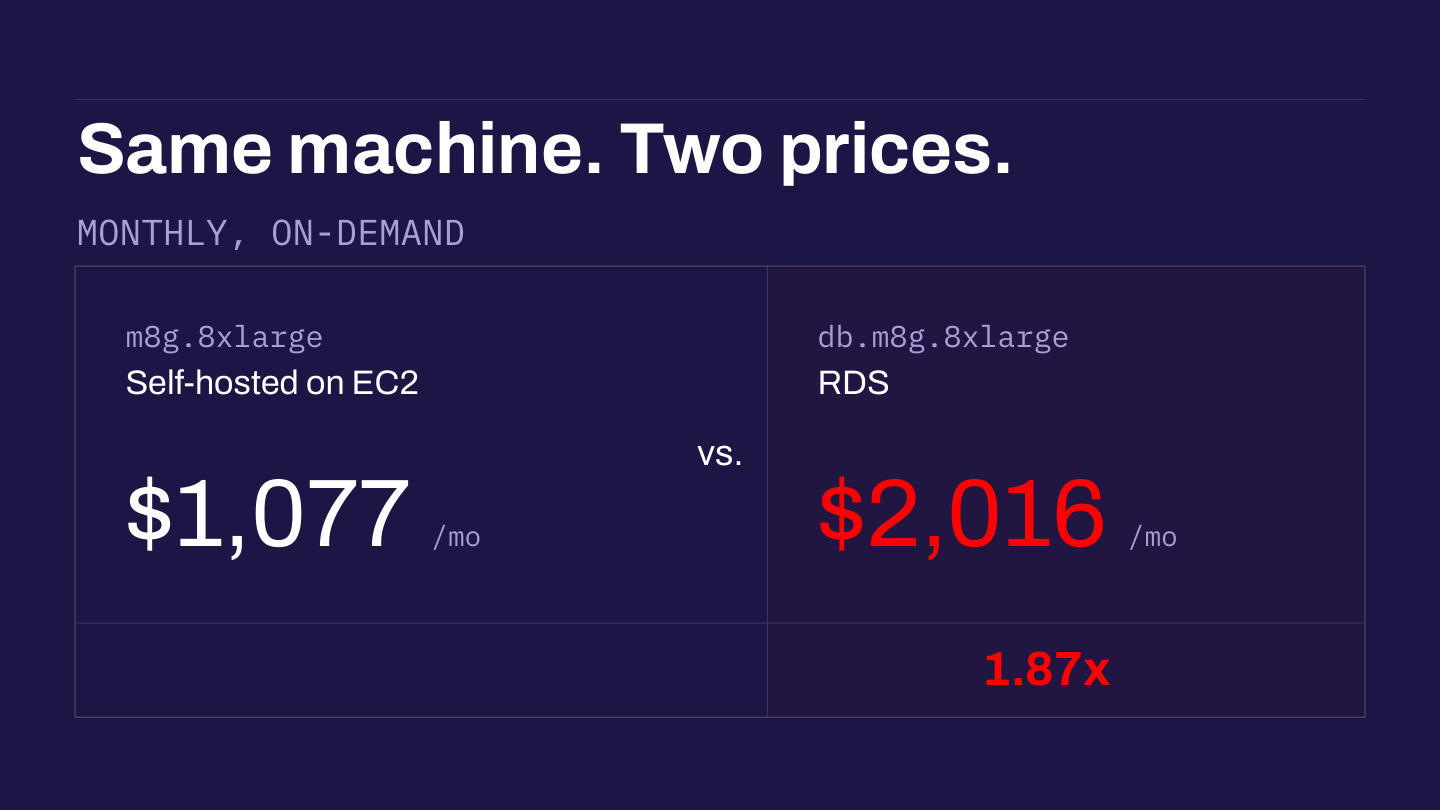
第一组:单实例比较。 根据演讲 PPT 所列的按需计费数据,自建 PostgreSQL 使用的 EC2
m8g.8xlarge 实例每月约
1,077 美元,RDS
db.m8g.8xlarge 实例每月约
2,016 美元。后者约为前者的
1.87 倍,即高出约 87%。
第二组:三节点部署比较。 演讲展示的 EC2 自建方案采用三台
m8gd.8xlarge 实例及本地 NVMe 存储,月成本约
4,143 美元;作为对比的 RDS 方案采用
db.m8gd.8xlarge、Multi-AZ 以及 io2 存储配置,月成本约
19,490 美元,约为前者的
4.7 倍。
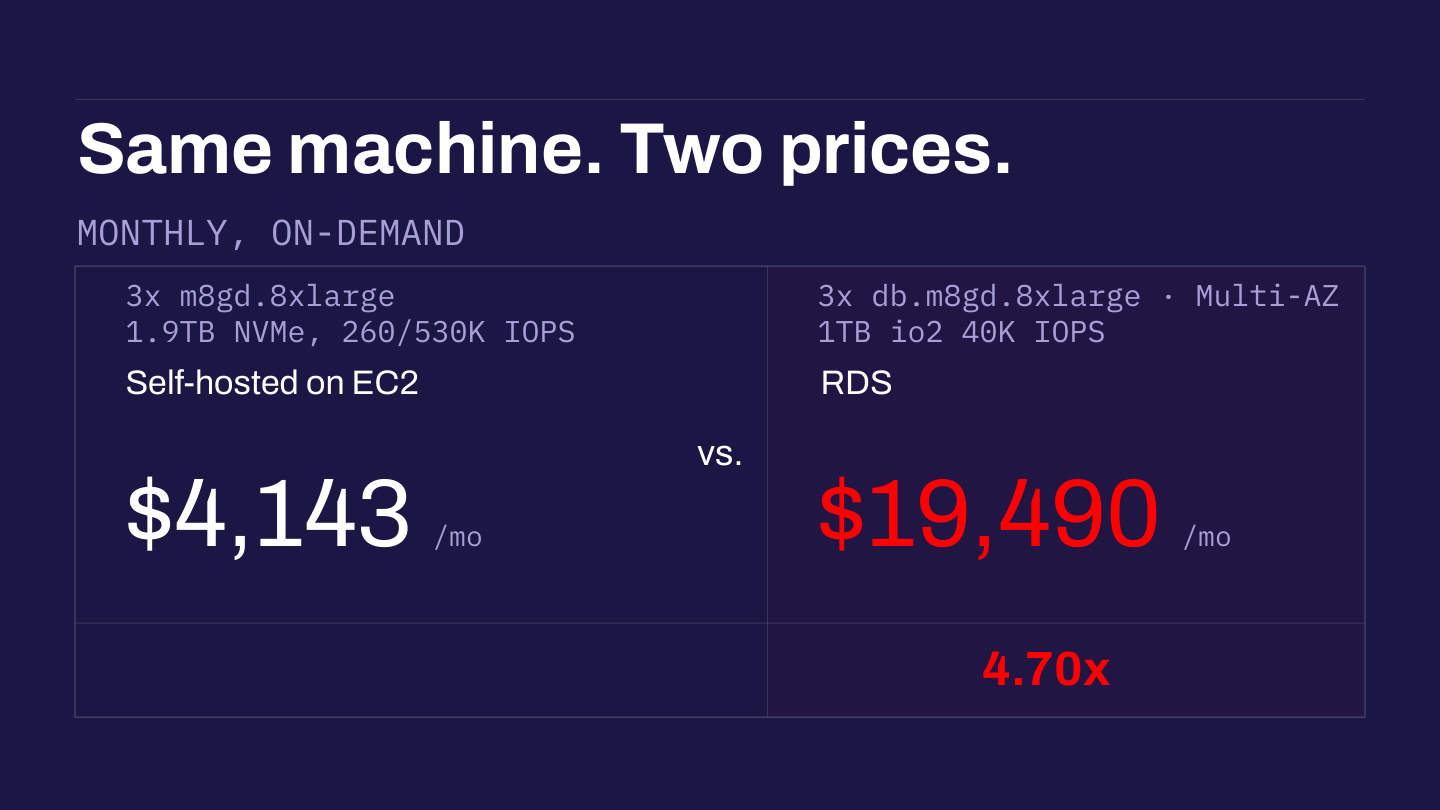
需要说明的是,两组方案并不是完全相同的存储架构。PPT 给出的本地 NVMe 与 io2 存储具有不同的性能指标、持久性特点和故障处理方式,不能仅凭所列 IOPS 规格推断实际 PostgreSQL 业务性能会提升相同比例。
尤其是 EC2 本地实例存储具有临时性:当相关实例存储生命周期结束时,本地数据可能丢失。因此,演讲者强调,自建方案需要结合 PostgreSQL 流复制、跨可用区部署及备份机制来保障数据安全。复制副本不能替代独立备份。
上述价格均为 演讲 PPT 中的示例数据,未给出完整的区域、计费时长及全部费用构成;它们适合说明不同方案的资源成本差异,不应直接视为当前报价或完整的总体拥有成本(TCO)比较。
比成本更值得关注的,是数据主权
在这些取舍之中,Álvaro 特别强调了 数据主权(Data Sovereignty)。
数据实际存放在哪里?受到哪个司法管辖区的法律约束?服务提供商在什么条件下可能访问数据?企业是否能够独立获取、验证和迁移自己的数据?这些问题在跨境业务、监管合规和数据保护要求不断变化的背景下愈发重要。
演讲 PPT 还提到美国《云法案》(CLOUD Act)以及数据驻留相关法规。这里需要区分:数据的物理存放位置、服务商适用的法律制度及具体的数据访问义务,并不完全是同一个问题,不能简单认为“放在本地就不存在合规风险”或“使用云服务就失去全部数据控制权”。
由此,演讲引出了一个更具体的讨论:对于运行 PostgreSQL 的用户而言,哪些控制权应当得到保障?
三、MSMR 宣言:My Server, My Rules
在演讲中,Álvaro 介绍了 MSMR(My Server, My Rules,意为“我的服务器,我的规则”)宣言,提出他认为 PostgreSQL 服务应当尊重的八项原则。
这是一项由演讲者提出的倡议,并非 PostgreSQL 社区的官方规范。其关注点是:无论数据库部署在自有服务器还是云端,用户都应尽可能掌握运行环境和数据的关键控制权。
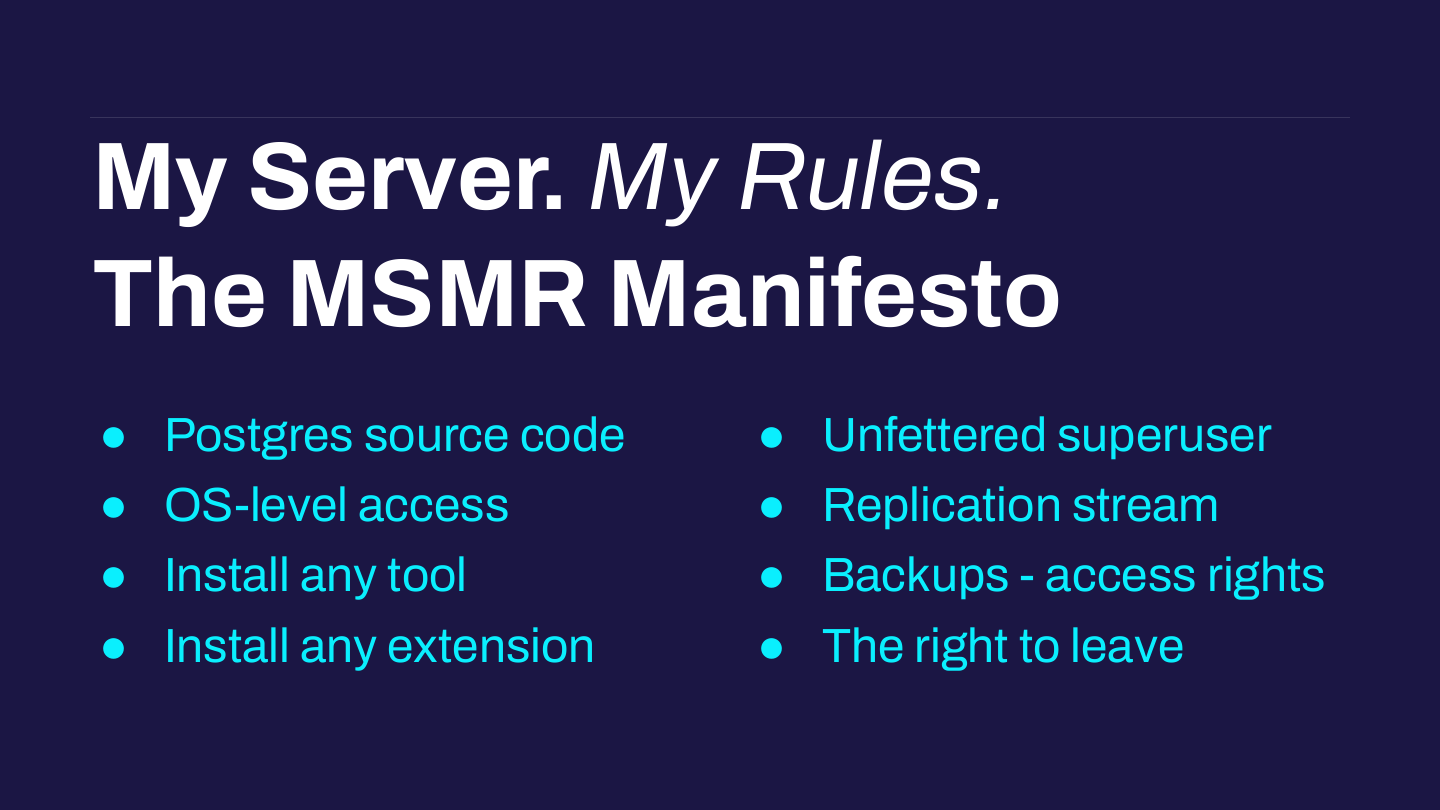
- PostgreSQL 源代码访问权:用户应能够了解自己使用的数据库软件及其源代码来源。
- 操作系统级访问权:用户应能够检查底层环境,以便进行诊断和故障排查。
- 自由安装工具的权利:允许根据实际需要安装系统级管理、监控和排障工具。
- 自由安装扩展的权利:不应只能使用服务商预设的扩展列表。
- 不受人为限制的数据库超级用户权限:保留对 PostgreSQL 实例的充分管理能力。
- 复制数据流访问权:能够访问和利用数据库复制机制及其变更数据流,而不是受限于单一平台提供的接口。
- 备份访问权:用户应当能够访问、检查并验证自己的备份,包括在需要时执行恢复测试,而不是只能依赖服务商对备份可用性的承诺。
- 自由迁移的权利:用户应能够把数据库迁移到其他环境,避免由于技术限制或平台依赖而难以退出。
其中,第七项在 PPT 中的原文为 Backups – access rights,核心是对备份的访问与验证能力;演讲者也强调,只有能够实际验证恢复的备份才更值得信赖。
这八项原则并不意味着现有托管数据库完全无法使用,而是为评价数据库服务的开放程度提供了一个观察角度: 使用开源数据库引擎,与拥有完整的数据库运行控制权,并不是同一件事。
四、开源自动化的发展:能否将云的便利带回自建?
如果云数据库的便利性主要来自自动化软件,开源技术是否也能帮助用户减少自建 PostgreSQL 的管理负担?
Álvaro 的回答是肯定的。他认为,过去十余年间,PostgreSQL 周边的开源工具不断发展,已经为自动化部署和运维提供了越来越完善的基础。
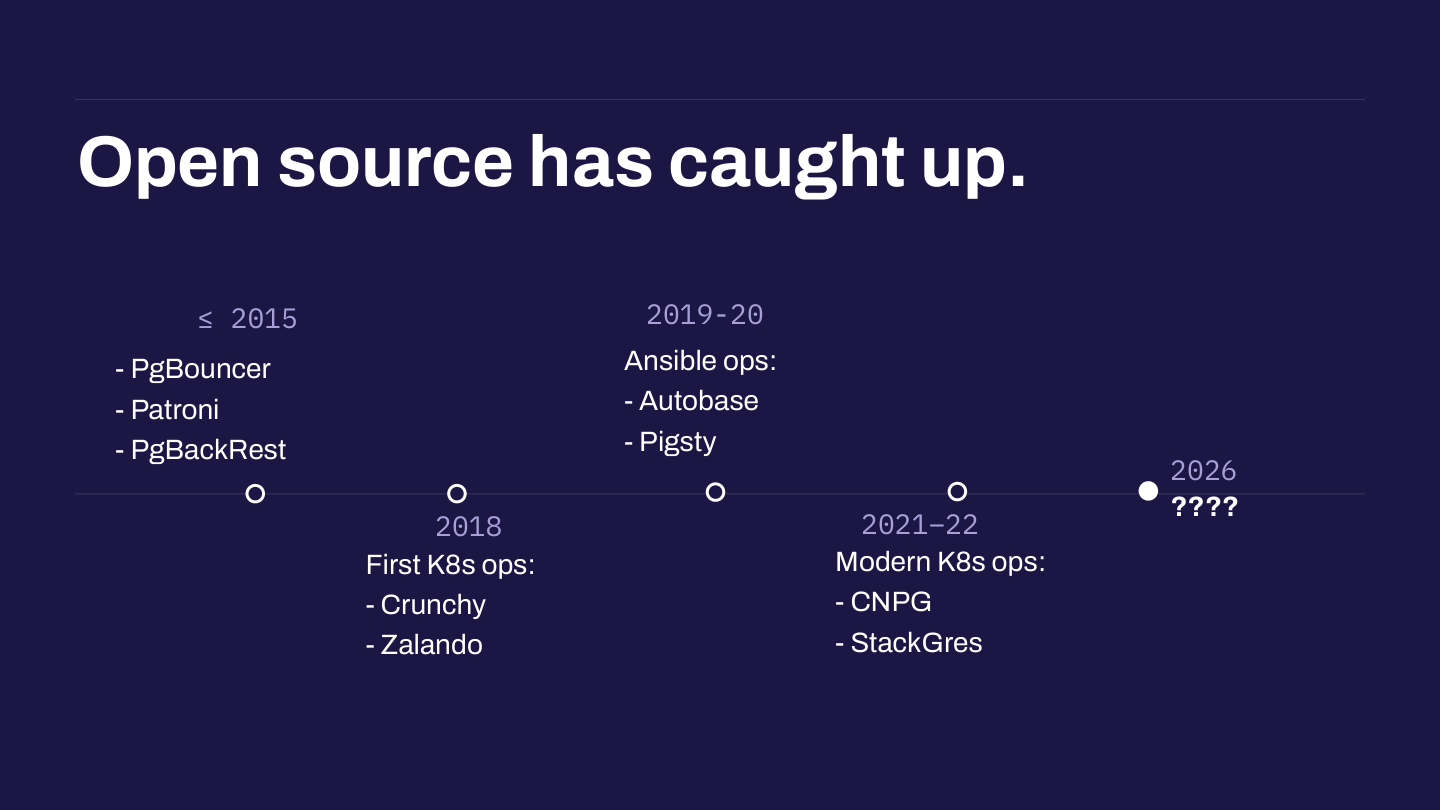
演讲按照技术演进大致梳理了几个阶段:
- 2015 年前后及随后一段时期:PgBouncer、Patroni、pgBackRest 等工具逐步发展,为连接池、高可用、备份恢复等能力提供支持。PPT 将它们概括在早期基础组件阶段,并非表示这些项目都在 2015 年以前发布成熟版本。
- 2018 年前后:以 Crunchy、Zalando 相关项目为代表,PostgreSQL 的 Kubernetes Operator 方案开始发展。
- 2019—2020 年前后:Autobase、Pigsty 等自动化方案进一步丰富了使用 Ansible 管理 PostgreSQL 的选择。
- 2021—2022 年前后:CloudNativePG(CNPG)、StackGres 等现代 Kubernetes Operator 继续发展,推动集群部署、故障恢复和生命周期管理能力完善。
这条时间线旨在展示开源 PostgreSQL 运维能力的逐步丰富,而不是对各项目首 次发布或成熟时间作严格考证。
Kubernetes 很强大,但不适合所有团队
对于在 Kubernetes 上运行数据库,Álvaro 持积极态度。他本人参与了 StackGres 项目,也曾参与 Data on Kubernetes 社区的建设。
Kubernetes 可以通过统一 API 抽象基础设施,Operator 则能够把数据库部署、管理和故障处理流程自动化。但它本身也带来了学习和运维成本。
一方面,数据库管理人员不一定熟悉 Kubernetes;另一方面,熟悉 Kubernetes 的平台工程师也不一定掌握 PostgreSQL 的内部机制。要在生产环境中稳定运行数据库,仍然需要跨领域的知识和协作。
因此, 基于 Kubernetes 的数据库自动化已经为一部分团队提供了成熟的选择,但不愿引入 Kubernetes 的团队,仍然需要其他方案。
五、未来展望:构建自己的 PostgreSQL 云
演讲最后,Álvaro 预告了一项当时正在筹备中的开源技术,目标是让用户能够在自有基础设施上构建自动化的 PostgreSQL 服务环境。
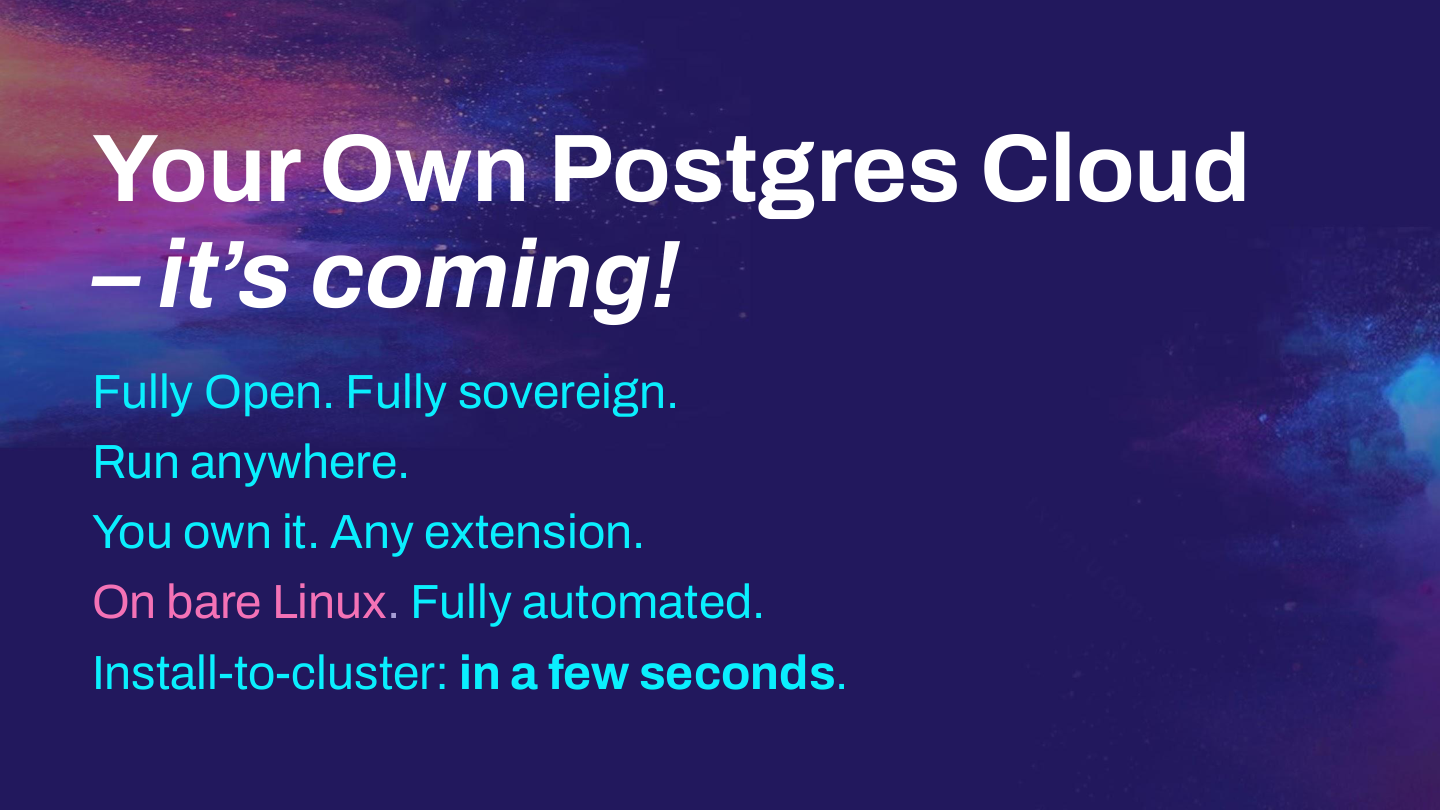
按照演讲中的介绍,该方案计划具备以下特点:直接运行在 Linux 主机上,不要求用户先部署 Kubernetes;通过集中式平台进行管理;支持快速创建数据库集群;同时保留安装扩展、控制底层环境和管理数据的自由。
演讲者希望借此将两种模式的优势结合起来:既拥有接近云数据库的快速交付体验,也能够自行决定数据库运行在哪里、采用哪些组件,以及如何管理和迁移数据。
需要注意的是,在这场演讲中,他没有披露项目名称、仓库地址及完整技术细节。“几秒内创建集群”等描述属于演讲中的预期能力,不能直接当作已经经过独立验证的性能结论。文中的“即将推出”也是 HOW 2026 演讲时的表述,不代表本文发布时的最新项目状态。
对于正在快速发展的 AI 应用,数据库基础设施的自动化交付和灵活配置也日益受到关注。无论是面向开发者还是自动化系统,如何降低部署和运维门槛,同时保持对数据与运行环境的控制,都是值得继续探索的方向。
回到《Make Postgres Yours Again》的主题,演讲所讨论的并不是简单地在自建和云托管之间二选一,而是如何 在享受自动化便利的同时,保留 PostgreSQL 原本赋予用户的开放性与自主选择权。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70043484/viewspace-3186989/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- PostgreSQL 日报|恢复预取器缺陷致检查点失败(10 月 28 日)
- PostgreSQL 日报|参数化 Append 返回错误结果(10 月 23 日)
- PostgreSQL 日报| SQL-PGQ 属性图特性(10 月 22 日)
- 使用 Patroni + HAProxy + Keepalived + ETCD 搭建高可用的 PostgreSQL 集群
- PL/iSQL 迁移的第二道坎:嵌套子函数、%TYPE、%ROWTYPE 与 OUT 参数实测
- PostgreSQL 日报|Anonymizer 3.3 修复高危漏洞(10 月 29 日)
- 回顾| IvorySQL 校园行走进山东大学:数据库技术、产业实践与职业成长
- PostgreSQL 日报| ILIKE 索引扫描漏返数据行(10 月 27 日)
- 关系型数据库在AI战场:从语义搜索到RAG的实战指南
- PostgreSQL 日报| WAL summarizer 断言失败(10 月 26 日)
