Kaggle系列-Mechanisms of Action (MoA) Prediction[表格数据多标签]第一名方案


比赛链接:https://www.kaggle.com/c/lish-moa/overview


药物的作用机制是什么?为什么它很重要?

如何确定新药的MoAs?

如何评估解决方案的准确性?

在这个比赛中,你将预测不同样本(sig_id)的作用机制(MoA)反应的多个靶标概率,给出各种输入,如基因表达数据和细胞活力数据。
train_features.csv:训练集对应的特征数据。特征g-表示基因表达数据,c-表示细胞活力数据。cp_type表示使用化合物(cp_vehicle)或控制扰动(ctrl_vehicle)处理的样品;控制扰动无moa;cp_time和cp_dose表示治疗时间(24、48、72小时)和剂量(高、低)。
train_drug.csv 训练集样本的sig_id和drug_id对应关系
train_targets_scored.csv:MOA的二分类标签数据
train_targets_nonscored.csv:额外没有带有标签的MOA数据
test_features.csv:测试数据的特征。需要选手预测测试数据中每一行的每个MoA得分的概率。
sample_submission.csv:提交文件

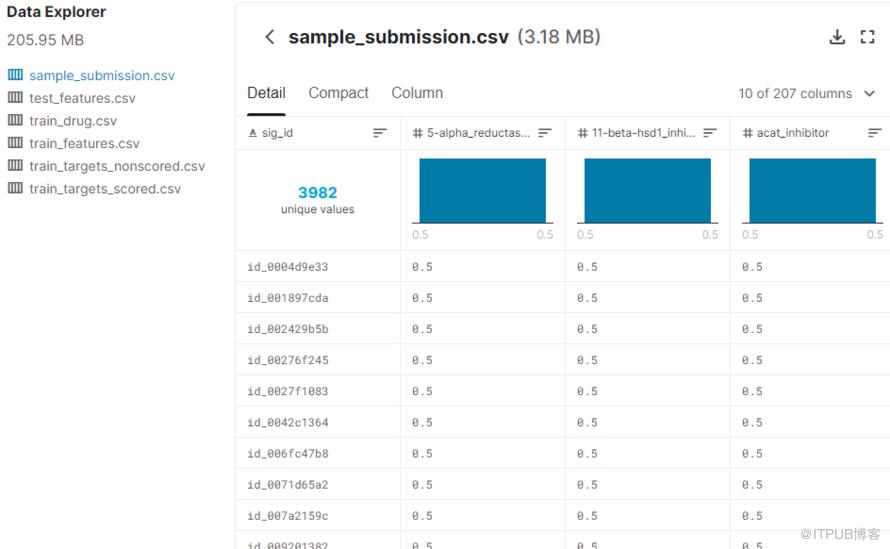
https://www.kaggle.com/isaienkov/mechanisms-of-action-moa-prediction-eda
训练集和测试集中的特征个数为876个
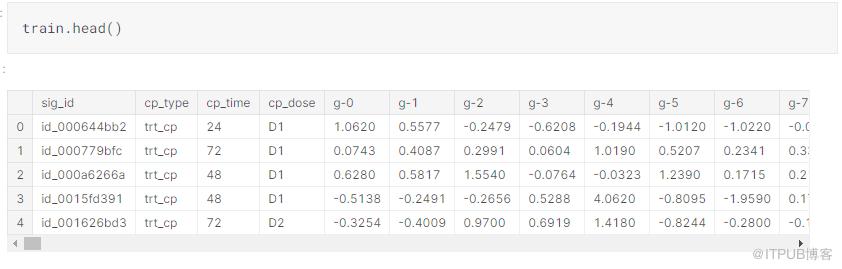
Number of rows in training set: 23814
Number of columns in training set: 876
Number of rows in test set: 3982
Number of columns in test set: 876
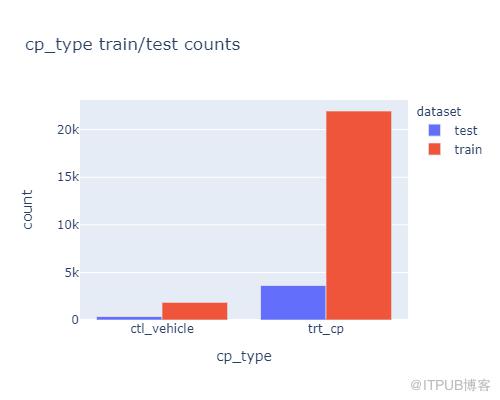
cp_type化合物处理方式
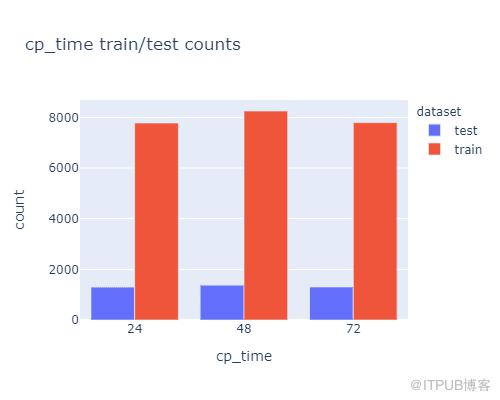
cp_time 实验时间
cp_dose 试验剂量

ds = df[df['dataset']=='train']
ds = ds.groupby(['cp_type', 'cp_time', 'cp_dose'])['sig_id'].count().reset_index()

ds.columns = [
    'cp_type',
    'cp_time',
    'cp_dose',
    'count'
]

fig = px.sunburst(
    ds,
    path=[
        'cp_type',
        'cp_time',
        'cp_dose'
    ],
    values='count',
    title='Sunburst chart for all cp_type/cp_time/cp_dose',
    width=500,
    height=500
)

fig.show()
g代表gene特征数据,c代表cell特征数据
train_columns = train.columns.to_list()
g_list = [i for i in train_columns if i.startswith('g-')]
c_list = [i for i in train_columns if i.startswith('c-')]
def plot_set_histograms(plot_list, title):
    fig = make_subplots(
        rows=4,
        cols=3
    )

    traces = [
        go.Histogram(
            x=train[col],
            nbinsx=100,
            name=col
        ) for col in plot_list
    ]

    for i in range(len(traces)):
        fig.append_trace(
            traces[i],
            (i // 3) + 1,
            (i % 3) + 1
        )

    fig.update_layout(
        title_text=title,
        height=1000,
        width=WIDTH
    )
    fig.show()

plot_list = [
    g_list[
        np.random.randint(0, len(g_list)-1)
    ] for i in range(50)
]

plot_list = list(set(plot_list))[:12]
plot_set_histograms(plot_list, 'Randomly selected gene expression features distributions')
columns = g_list + c_list
for_correlation = random.sample(columns, 50)
data = df[for_correlation]

f = plt.figure(
    figsize=(18, 18)
)

plt.matshow(
    data.corr(),
    fignum=f.number
)

plt.xticks(
    range(data.shape[1]),
    data.columns,
    fontsize=14,
    rotation=50
)

plt.yticks(
    range(data.shape[1]),
    data.columns,
    fontsize=14
)

cb = plt.colorbar()
cb.ax.tick_params(
    labelsize=13
)
纵向为特征列,横向为目标列(206个),每个单元为对应特征与目标的相关性系数
correlation_matrix['train_features'] = columns
correlation_matrix = correlation_matrix.set_index('train_features')

correlation_matrix
与目标列相关性比较高的特征如下:
count_features = total_scores['train_best_column'].value_counts().reset_index().sort_values('train_best_column')

count_features.columns = [
    'column',
    'count'
]

count_features = count_features.tail(33)

fig = px.bar(
    count_features,
    x='count',
    y="column",
    orientation='h',
    title='Columns from training set with number of high correlations with target columns',
    width=WIDTH,
    height=700
)

fig.show()
另外也有高阶的相关系系数分析
二阶相关性
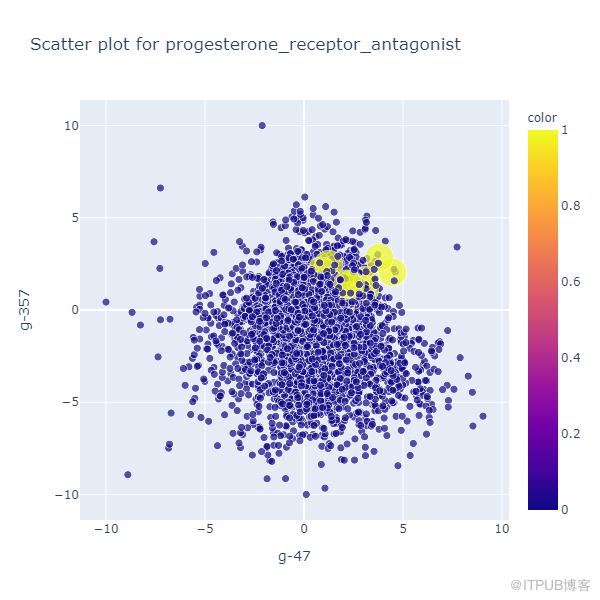
三阶相关性

分享链接:https://www.kaggle.com/c/lish-moa/discussion/201510 代码链接:https://www.kaggle.com/markpeng/final-best-lb-cleaned/notebook

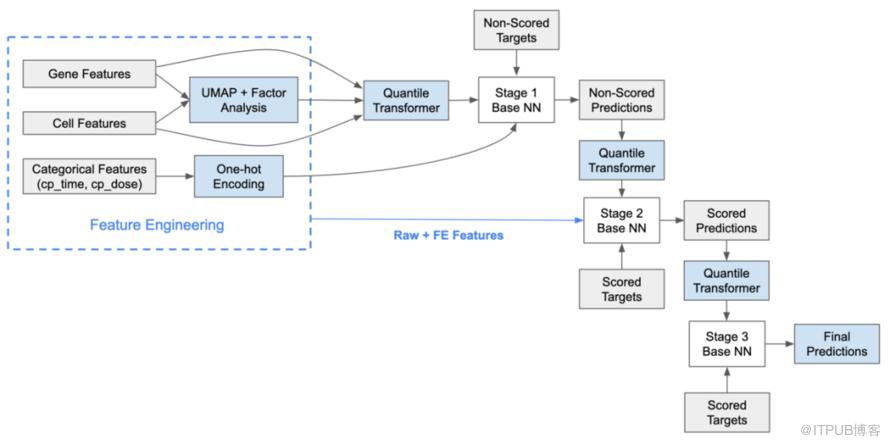
这里主要用到了Tabnet工具,可以利用神经网络在表格数据上进行大放异彩。使用方法大家可以参照Github链接:
dreamquark-ai/tabnet https://github.com/dreamquark-ai/tabnet

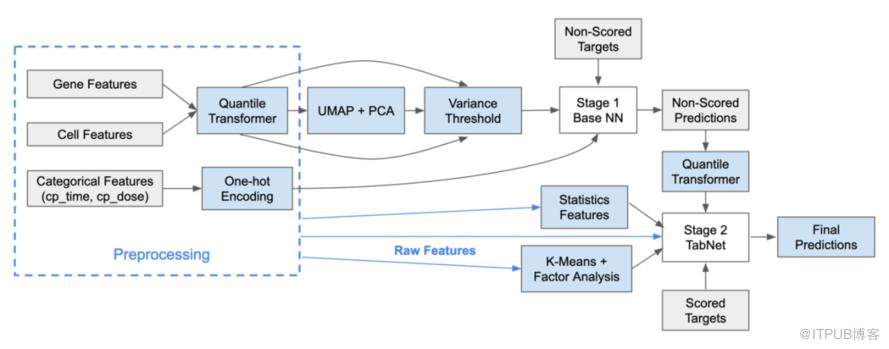
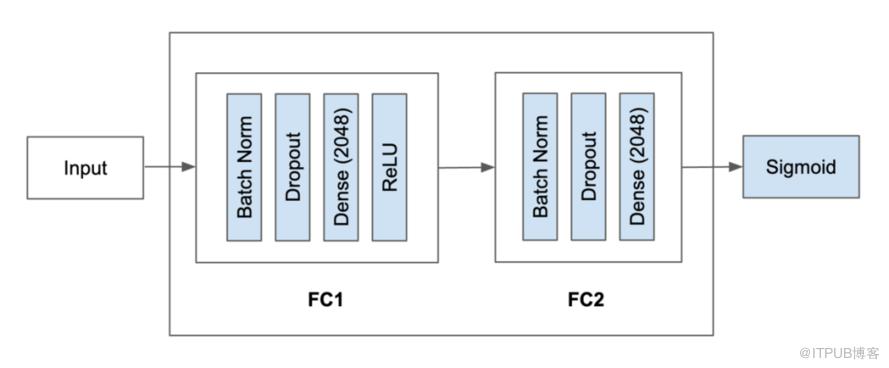
其中2-FC代表简单的两层全连接神经网络,如下图所示
这里和模型1比较相似,但是进行的监督学习,没有用到半监督学习。同时这里加入了基于K-Means聚类的特征
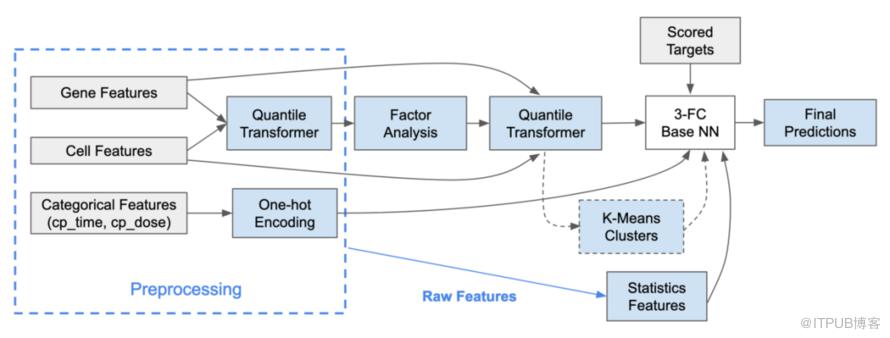
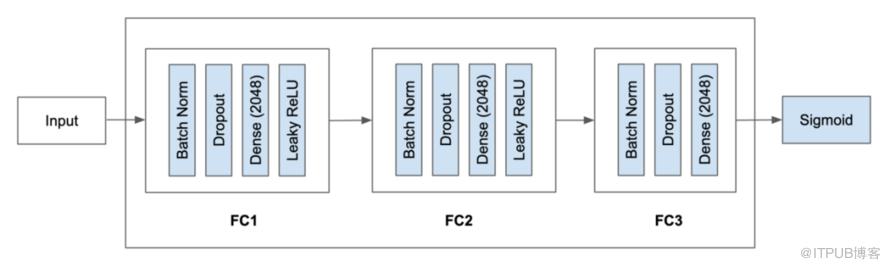
原始开源开源代码:https://www.kaggle.com/demetrypascal/fork-of-2heads-looper-super-puper-plate
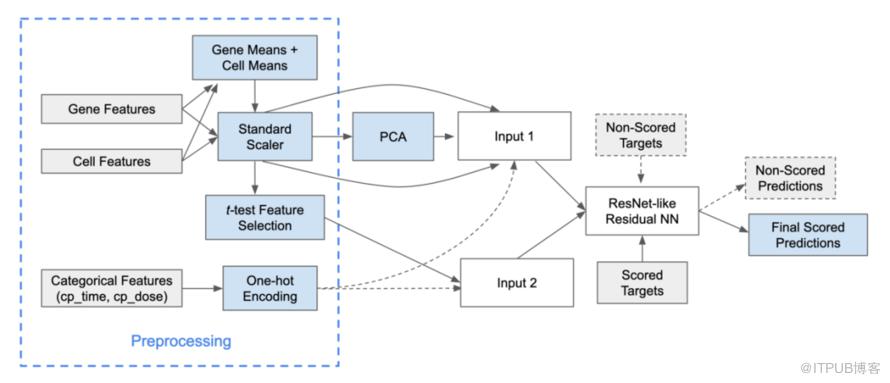
残差网络拓扑图,其中网络用到也是最基本的Dense网络结构:

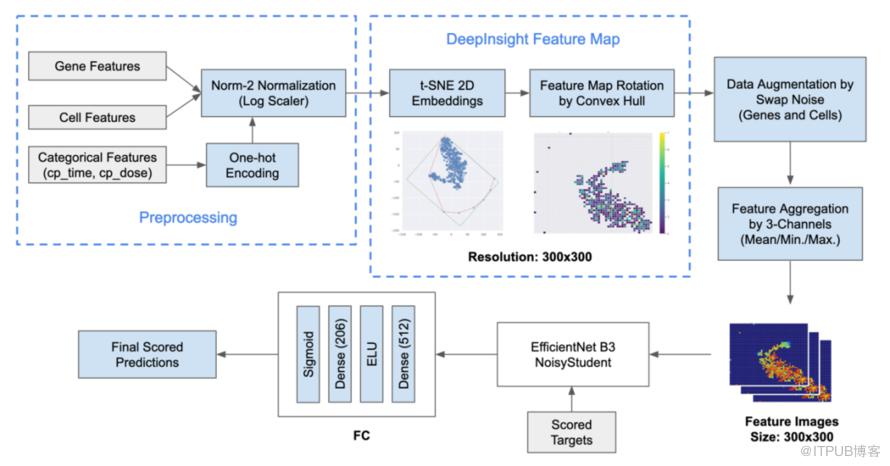
利用 EfficientNet B3 提取特征
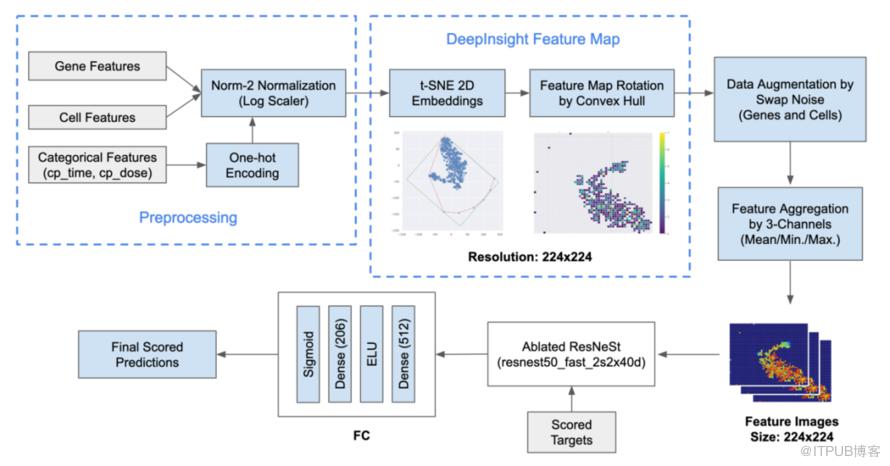
利用ResNeSt提取特征

基于线上提交得出的模型相关性热力图
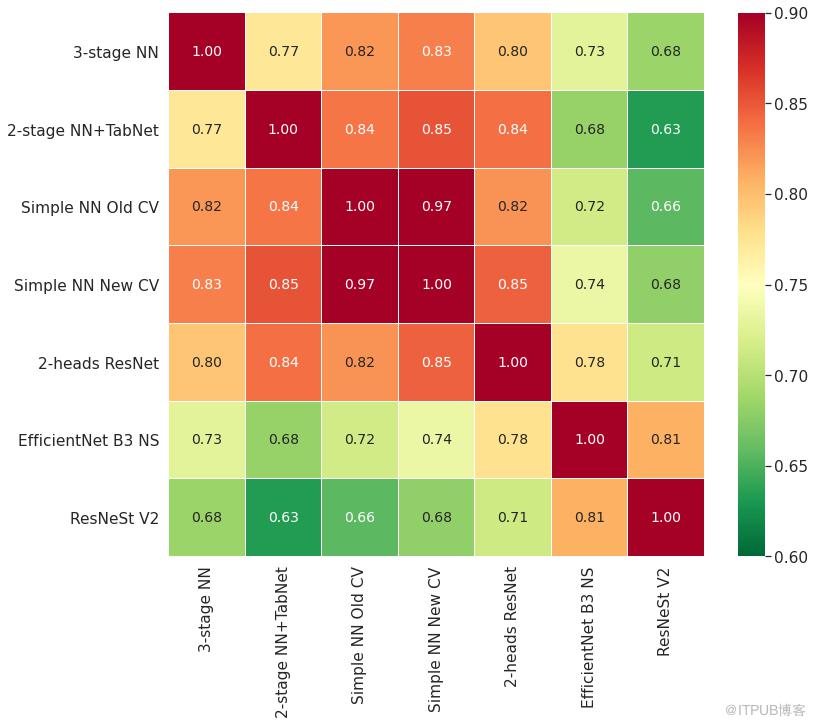
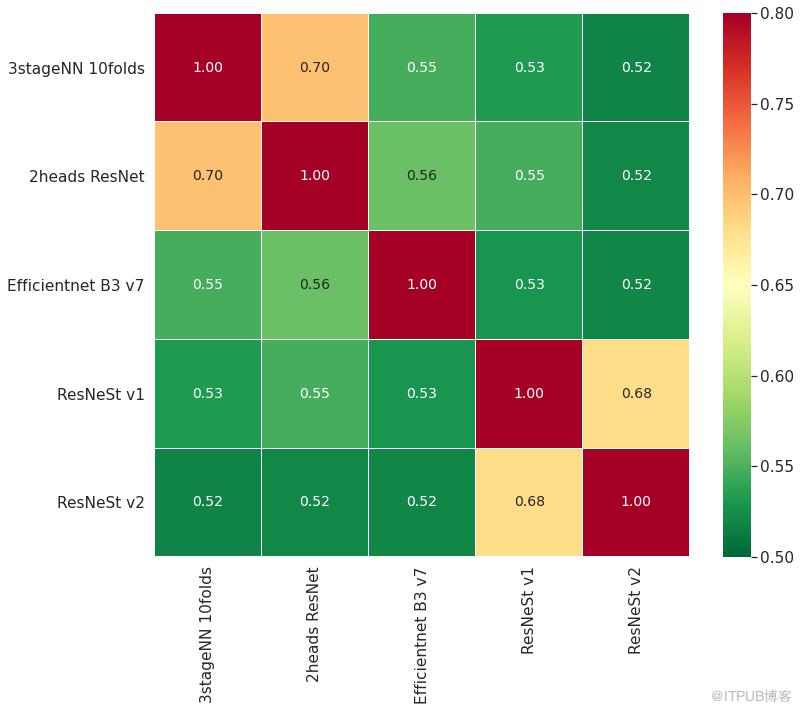
基于线下OOF得出的模型相关性热力图可以看到模型相关性系数都很低,一般在0.52-0.70,模型具有多样性和差异性,那么融合之后的收益会很大
本方案使用神经网络在表格数据上做了大量尝试,并取得很大的成效
为了提高模型融合的收益,需要保证模型多样性,所以作者也使用了不同的训练方法和模型结构
使用CNN等预训练模型提取特征图


原文作者:ChallengeHub;如有侵权,请联系管理员删除。

