全球人工智能技术创新大赛
赛道三: 小布助手对话短文本语义匹配
https://tianchi.aliyun.com/competition/entrance/531851/introduction
小布助手是OPPO公司为欧加集团三品牌手机和IoT设备自研的语音助手,为用户提供了有趣、贴心、便捷的对话式服务。意图识别是对话系统中的一个核心任务,而对话短文本语义匹配是意图识别的主流算法方案之一。本赛题要求参赛队伍根据脱敏后的短文本query-pair,预测它们是否属于同一语义,提交的结果按照指定的评价指标使用在线评测数据进行评测和排名,得分最优者获胜。
训练数据包含输入query-pair,以及对应的真值。初赛训练样本10万,复赛训练样本30万,这份数据主要用于参赛队伍训练模型,为确保数据的高质量,每一个样本的真值都有进行人工标注校验。每行为一个训练样本,由query-pair和真值组成,每行格式如下:
query-pair格式:query以中文为主,中间可能带有少量英文单词(如英文缩写、品牌词、设备型号等),采用UTF-8编码,未分词,两个query之间使用\t分割。
真值:真值可为0或1,其中1代表query-pair语义相匹配,0则代表不匹配,真值与query-pair之间也用\t分割。
训练数据样本举例(空白间隔为\t):
肖战的粉丝叫什么名字 肖战的粉丝叫什么 1
王者荣耀里面打野谁最厉害 王者荣耀什么英雄最好玩 0
我想换个手机 我要换手机 1
我是张睿 我想张睿 0
不想 不想说 0
脱敏后的query-pair数据,初赛采用A/B榜的方式,A榜和B榜样本规模分别为5万,发布时间以赛制为准,初赛队伍根据初赛B榜排名择优进入复赛;复赛采用单榜方式,样本规模5万(与初赛不重复),复赛队伍根据复赛排名择优进入现场答辩。测试数据样本举例(空白间隔为\t)
肖战的粉丝叫什么名字 肖战的粉丝叫什么
王者荣耀里面打野谁最厉害 王者荣耀什么英雄最好玩
我想换个手机 我要换手机
我是张睿 我想张睿
不想 不想说
选手针对测试数据提交预测结果文件,结果文件中每行为一个预测值,是0与1之间的一个浮点数,代表query-pair语义匹配的概率,与测试数据每行一一对应。结果文件内容举例
0.001
0.999
比赛的评估标准由性能标准和效果标准两部分组成,初赛采用效果标准,AUC 指标,具体定义 如下:
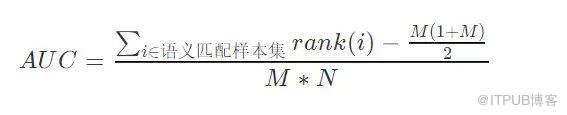
rank(i):表示i这个样本的预测得分在测试集中的排序;
M:测试集中语义匹配的样本的个数;
N:测试集中语义不匹配的样本的个数。
复赛阶段将同时考虑性能标准和效果标准,效果标准继续采用 AUC 指标,性能标准是约束条件,在 复赛阶段需要在限定时间内完成预测,具体要求详见复赛开始前提供的“容器镜像”页面。
本项比赛全程不允许使用外部数据集。
允许使用预训练模型,如网络模型与embedding等。
复赛阶段允许使用初赛阶段的数据集。
原文作者:ChallengeHub;如有侵权,请联系管理员删除。


