Kaggle系列- Russia房产价格预测top1%(22/3270)方案总结
一起加入这次沉浸式学习吧,本次分享的方案基本上包好了结构化数据比赛的基本流程:数据分析、数据预处理,特征工程、模型训练以及模型融合,大家可以留在周末学习一波。

比赛名称:Sberbank Russian Housing Market 比赛链接:https://www.kaggle.com/c/sberbank-russian-housing-market


train.csv,test.csv:有关单个交易的信息。 这些行由“ id”字段索引,该字段引用单个事务(特定属性在单独的事务中可能出现多次)。 这些文件还包括有关每个属性的本地区域的补充信息。
macro.csv:有关俄罗斯宏观经济和金融部门的数据(可以根据“时间戳”与训练集和测试集合并)
data_dictionary.txt:其他数据文件中可用字段的说明
sample_submission.csv:格式正确的示例提交文件 其中字段比较多,我们可以通过data_dictionary文件可以发现至少有200+个字段,所以本次比赛的数据还是比较丰富,比较客观,同时也具有研究价值。
来源:https://www.kaggle.com/sudalairajkumar/simple-exploration-notebook-sberbank
房产价格分布 我们将价格按照从小到大排序,画出如下每处房产价格分布:
plt.figure(figsize=(8,6))
plt.scatter(range(train_df.shape[0]), np.sort(train_df.price_doc.values))
plt.xlabel('index', fontsize=12)
plt.ylabel('price', fontsize=12)
plt.show()
房产价格随着时间变化趋势
train_df['yearmonth'] = train_df['timestamp'].apply(lambda x: x[:4]+x[5:7])
grouped_df = train_df.groupby('yearmonth')['price_doc'].aggregate(np.median).reset_index()

plt.figure(figsize=(12,8))
sns.barplot(grouped_df.yearmonth.values, grouped_df.price_doc.values, alpha=0.8, color=color[2])
plt.ylabel('Median Price', fontsize=12)
plt.xlabel('Year Month', fontsize=12)
plt.xticks(rotation='vertical')
plt.show()
特征重要性较高的特征 因为有292个变量,让我们构建一个基本的xgboost模型,然后先研究重要的变量。
for f in train_df.columns:
    if train_df[f].dtype=='object':
        lbl = preprocessing.LabelEncoder()
        lbl.fit(list(train_df[f].values))
        train_df[f] = lbl.transform(list(train_df[f].values))

train_y = train_df.price_doc.values
train_X = train_df.drop(["id", "timestamp", "price_doc"], axis=1)

xgb_params = {
    'eta': 0.05,
    'max_depth': 8,
    'subsample': 0.7,
    'colsample_bytree': 0.7,
    'objective': 'reg:linear',
    'eval_metric': 'rmse',
    'silent': 1
}
dtrain = xgb.DMatrix(train_X, train_y, feature_names=train_X.columns.values)
model = xgb.train(dict(xgb_params, silent=0), dtrain, num_boost_round=100)

# plot the important features #
fig, ax = plt.subplots(figsize=(12,18))
xgb.plot_importance(model, max_num_features=50, height=0.8, ax=ax)
plt.show()
因此,数据特征中的重要性前5个变量及其描述为:
full_sq-以平方米为单位的总面积,包括凉廊,阳台和其他非住宅区
life_sq-居住面积(平方米),不包括凉廊,阳台和其他非居住区
floor-对于房屋,建筑物的当前层数
max_floor-建筑物中的总楼层数
build_year-建造年份
full_seq与房产价格的分布
ulimit = np.percentile(train_df.price_doc.values, 99.5)
llimit = np.percentile(train_df.price_doc.values, 0.5)
train_df['price_doc'].ix[train_df['price_doc']>ulimit] = ulimit
train_df['price_doc'].ix[train_df['price_doc']<llimit] = llimit

col = "full_sq"
ulimit = np.percentile(train_df[col].values, 99.5)
llimit = np.percentile(train_df[col].values, 0.5)
train_df[col].ix[train_df[col]>ulimit] = ulimit
train_df[col].ix[train_df[col]<llimit] = llimit

plt.figure(figsize=(12,12))
sns.jointplot(x=np.log1p(train_df.full_sq.values), y=np.log1p(train_df.price_doc.values), size=10)
plt.ylabel('Log of Price', fontsize=12)
plt.xlabel('Log of Total area in square metre', fontsize=12)
plt.show()
life_sq与房产价格分布
col = "life_sq"
train_df[col].fillna(0, inplace=True)
ulimit = np.percentile(train_df[col].values, 95)
llimit = np.percentile(train_df[col].values, 5)
train_df[col].ix[train_df[col]>ulimit] = ulimit
train_df[col].ix[train_df[col]<llimit] = llimit

plt.figure(figsize=(12,12))
sns.jointplot(x=np.log1p(train_df.life_sq.values), y=np.log1p(train_df.price_doc.values),
              kind='kde', size=10)
plt.ylabel('Log of Price', fontsize=12)
plt.xlabel('Log of living area in square metre', fontsize=12)
plt.show()
楼层与房产价格中位数分布
grouped_df = train_df.groupby('floor')['price_doc'].aggregate(np.median).reset_index()
plt.figure(figsize=(12,8))
sns.pointplot(grouped_df.floor.values, grouped_df.price_doc.values, alpha=0.8, color=color[2])
plt.ylabel('Median Price', fontsize=12)
plt.xlabel('Floor number', fontsize=12)
plt.xticks(rotation='vertical')
plt.show()
代码链接:https://github.com/LenzDu/Kaggle-Competition-Sberbank
Data.py: 数据清洗以及特征工程 Exploration.py: 数据分析 Model.py: XGBoost模型 BaseModel.py: 基线模型:RandomForestRegressor、GradientBoostingRegressor、Lasso等 lightGBM.py: lightGBM模型 Stacking.py: model stacking (final model):模型融合
因为代码比较清晰简洁,非常适合数据挖掘的新手解读学习,其中作者写的Stacking也是非常漂亮,我们可以感受下:
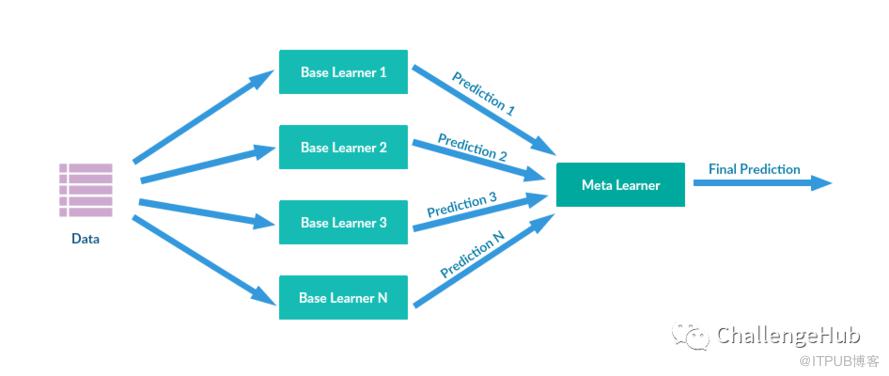
Stacking是通过一个元分类器或者元回归器整合多个模型的集成学习技术。基础模型利用整个训练集做训练,元模型利用基础模型做特征进行训练。一般Stacking多使用不同类型的基础模型
import numpy as np
import pandas as pd
from sklearn.model_selection import ShuffleSplit, cross_val_score
from sklearn.cross_validation import KFold
from sklearn.ensemble import AdaBoostRegressor, RandomForestRegressor, ExtraTreesRegressor, GradientBoostingRegressor
from sklearn.neural_network import MLPRegressor
from sklearn.preprocessing import Imputer
from sklearn.tree import DecisionTreeRegressor
from sklearn.linear_model import LinearRegression
import xgboost as xgb
import lightgbm as lgb
from sklearn.preprocessing import StandardScaler

# 封装一下lightgbm让其可以在stacking里面被调用
class LGBregressor(object):
    def __init__(self,params):
        self.params = params

    def fit(self, X, y, w):
        y /= 10000000
        # self.scaler = StandardScaler().fit(y)
        # y = self.scaler.transform(y)
        split = int(X.shape[0] * 0.8)
        indices = np.random.permutation(X.shape[0])
        train_id, test_id = indices[:split], indices[split:]
        x_train, y_train, w_train, x_valid, y_valid,  w_valid = X[train_id], y[train_id], w[train_id], X[test_id], y[test_id], w[test_id],
        d_train = lgb.Dataset(x_train, y_train, weight=w_train)
        d_valid = lgb.Dataset(x_valid, y_valid, weight=w_valid)
        partial_bst = lgb.train(self.params, d_train, 10000, valid_sets=d_valid, early_stopping_rounds=50)
        num_round = partial_bst.best_iteration
        d_all = lgb.Dataset(X, label = y, weight=w)
        self.bst = lgb.train(self.params, d_all, num_round)

    def predict(self, X):
        return self.bst.predict(X) * 10000000
        # return self.scaler.inverse_transform(self.bst.predict(X))

# 封装一下xgboost让其可以在stacking里面被调用
class XGBregressor(object):
    def __init__(self, params):
        self.params = params

    def fit(self, X, y, w=None):
        if w==None:
            w = np.ones(X.shape[0])
        split = int(X.shape[0] * 0.8)
        indices = np.random.permutation(X.shape[0])
        train_id, test_id = indices[:split], indices[split:]
        x_train, y_train, w_train, x_valid, y_valid,  w_valid = X[train_id], y[train_id], w[train_id], X[test_id], y[test_id], w[test_id],
        d_train = xgb.DMatrix(x_train, label=y_train, weight=w_train)
        d_valid = xgb.DMatrix(x_valid, label=y_valid, weight=w_valid)
        watchlist = [(d_train, 'train'), (d_valid, 'valid')]
        partial_bst = xgb.train(self.params, d_train, 10000, early_stopping_rounds=50, evals = watchlist, verbose_eval=100)
        num_round = partial_bst.best_iteration
        d_all = xgb.DMatrix(X, label = y, weight=w)
        self.bst = xgb.train(self.params, d_all, num_round)

    def predict(self, X):
        test = xgb.DMatrix(X)
        return self.bst.predict(test)

# This object modified from Wille on https://dnc1994.com/2016/05/rank-10-percent-in-first-kaggle-competition-en/
class Ensemble(object):
    def __init__(self, n_folds, stacker, base_models):
        self.n_folds = n_folds
        self.stacker = stacker
        self.base_models = base_models

    def fit_predict(self, trainDf, testDf):
        X = trainDf.drop(['price_doc', 'w'], 1).values
        y = trainDf['price_doc'].values
        w = trainDf['w'].values
        T = testDf.values

        X_fillna = trainDf.drop(['price_doc', 'w'], 1).fillna(-999).values
        T_fillna = testDf.fillna(-999).values

        folds = list(KFold(len(y), n_folds=self.n_folds, shuffle=True))
        S_train = np.zeros((X.shape[0], len(self.base_models)))
        S_test = np.zeros((T.shape[0], len(self.base_models)))
        for i, clf in enumerate(self.base_models):
            print('Training base model ' + str(i+1) + '...')
            S_test_i = np.zeros((T.shape[0], len(folds)))
            for j, (train_idx, test_idx) in enumerate(folds):
                print('Training round ' + str(j+1) + '...')
                if clf not in [xgb1,lgb1]: # sklearn models cannot handle missing values.
                    X = X_fillna
                    T = T_fillna
                X_train = X[train_idx]
                y_train = y[train_idx]
                w_train = w[train_idx]
                X_holdout = X[test_idx]
                # w_holdout = w[test_idx]
                # y_holdout = y[test_idx]
                clf.fit(X_train, y_train, w_train)
                y_pred = clf.predict(X_holdout)
                S_train[test_idx, i] = y_pred
                S_test_i[:, j] = clf.predict(T)
            S_test[:, i] = S_test_i.mean(1)
        self.S_train, self.S_test, self.y = S_train, S_test, y  # for diagnosis purpose
        self.corr = pd.concat([pd.DataFrame(S_train),trainDf['price_doc']],1).corr() # correlation of predictions by different models.
        # cv_stack = ShuffleSplit(n_splits=6, test_size=0.2)
        # score_stacking = cross_val_score(self.stacker, S_train, y, cv=cv_stack, n_jobs=1, scoring='neg_mean_squared_error')
        # print(np.sqrt(-score_stacking.mean())) # CV result of stacking
        self.stacker.fit(S_train, y)
        y_pred = self.stacker.predict(S_test)
        return y_pred

if __name__ == "__main__":
    trainDf = pd.read_csv('train_featured.csv')
    testDf = pd.read_csv('test_featured.csv')

    params1 = {'eta':0.05, 'max_depth':5, 'subsample':0.8, 'colsample_bytree':0.8, 'min_child_weight':1,
              'gamma':0, 'silent':1, 'objective':'reg:linear', 'eval_metric':'rmse'}
    xgb1 = XGBregressor(params1)
    params2 = {'booster':'gblinear', 'alpha':0,# for gblinear, delete this line if change back to gbtree
               'eta':0.1, 'max_depth':2, 'subsample':1, 'colsample_bytree':1, 'min_child_weight':1,
              'gamma':0, 'silent':1, 'objective':'reg:linear', 'eval_metric':'rmse'}
    xgb2 = XGBregressor(params2)
    RF = RandomForestRegressor(n_estimators=500, max_features=0.2)
    ETR = ExtraTreesRegressor(n_estimators=500, max_features=0.3, max_depth=None)
    Ada = AdaBoostRegressor(DecisionTreeRegressor(max_depth=15),n_estimators=200)
    GBR = GradientBoostingRegressor(n_estimators=200,max_depth=5,max_features=0.5)
    LR =LinearRegression()

    params_lgb = {'objective':'regression','metric':'rmse',
              'learning_rate':0.05,'max_depth':-1,'sub_feature':0.7,'sub_row':1,
              'num_leaves':15,'min_data':30,'max_bin':20,
              'bagging_fraction':0.9,'bagging_freq':40,'verbosity':0}
    lgb1 = LGBregressor(params_lgb)

    E = Ensemble(5, xgb2, [xgb1,lgb1,RF,ETR,Ada,GBR])
    prediction = E.fit_predict(trainDf, testDf)
    output = pd.read_csv('test.csv')
    output = output[['id']]
    output['price_doc'] = prediction
    output.to_csv(r'Ensemble\Submission_Stack.csv',index=False)
一般每个比赛的discussion部分,我们可以看到前排方案的讨论交流,感觉读了他们分享的总结以及简介比代码获得收益更大。
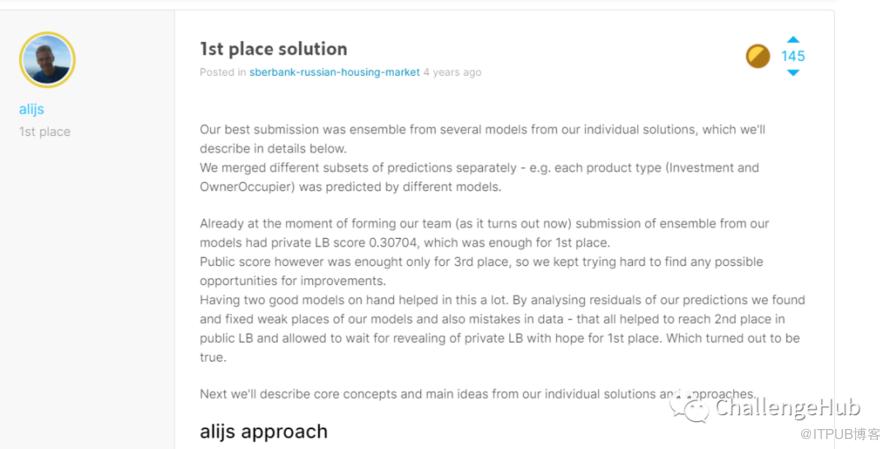
链接为:https://www.kaggle.com/c/sberbank-russian-housing-market/discussion/35684
从第一名分享的方案中,对我收益比较大的是:
没有对目标变量直接预测,而是对单位平方米的价格进行预测,之后转化
尝试很多的独立模型,这里指的是因为他们发现有两个变量放在一块导致模型差异很大(Investment 和OwnerOccupier),然后将两个变量置于两组不同的特征输入给模型
去除异常值,单独训练模型




点个在看你最好看

原文作者:ChallengeHub;如有侵权,请联系管理员删除。

