超越A/B测试:多臂老虎机在谷歌在线广告匹配中的应用

-
A/B测试依赖于统计显著性的经典统计检验。当我们提出一个新的产品策略时(例如测试一个网站红蓝黄三色按钮哪个更容易让用户点击),我们可能想在向全量用户流量发布之前测试它是否有用。测试包括两组:一组是实验组(他们可以使用新功能),另一组是对照组。然后我们为两组人测量一个关键指标:平均网站时间(社交网络),平均结帐时间(电子商务),或点击率(在线广告)。对组间差异进行统计学显著性检验。
-
经典统计检验(z检验、t检验)保证假阳性率不超过α,通常设为5%。这意味着,当实验组和对照组之间没有差异时,该检验将在5%的情况下发现统计学差异。
-
均衡AB测试会给每组分配相同的流量(流量是指用户数量),直到达到足够的样本容量。但是,我们不能在测试期间根据观察到的数据调整流量分配。
所以A/B测试存在以下几点问题:
如果实验组明显优于对照组,我们仍然需要在对照组上花费大量的流量,才能获得统计显著性(即实验过程中就浪费一部分用户数量,可能旧的策略在全量放量到新的策略已经导致用户丢失这种危险性)。
如果策略过多,那就需要大量的A/B实验组,全量用户就会被分流,如果全量用户基数不够大,就很容易导致单个实验结果不具有可靠性(样本少,假设检验不一定成立)。不过由谷歌发表的一篇名为【Overlapping Experiment Infrastructure: More, Better, Faster Experimentation】通过使用多层正交分流方法能够很准确的做更多的AB实验,解决了工业上的一大难题。
A/B实验的周期一般是一周以上,但是对于推荐系统、在线广告中需要短时间就给出反馈的,就无法满足要求,而多臂老虎机能够很好的解决这个问题。
下图中即是在多个策略下,多臂老虎机算法及时更新用户反馈,进行流量的分配,最终某个策略在用户反馈中具有优异表现(广告中表现出用户点击率更高、视频浏览中即完播率更高、浏览时间更长)。

鉴于A/B测试是一种常见的方法,我们也可以从贝叶斯方法进行测试。一旦我们看到一种实验方法明显更好,我们希望立即增加更多的用户使用这种实验方法。多臂老虎机算法使这成为一种可控的方式。
多臂老虎机实验基础是贝叶斯更新:
每一种实验策略(称为arm,多个arm即指多个策略)都有成功的概率,这被建模为伯努利过程。
成功的概率是未知的,是用Beta分布来建模的。
随着实验的继续,每个arm接收到用户流量,Beta分布也随之更新。
该部分代码块展示了每个arm的beta分布变化,主要是由alpha、beta两个参数决定(定义为a、b),即我们定义达到目标更新a参数(例如获取点击),反之更新b参数,最后实现每个arm的beta分布变化。
class Arm(object):
    """
    Each arm's true click through rate is
    modeled by a beta distribution.
    """
    def __init__(self, idx, a=1, b=1):
        """
        Init with uniform prior.
        """
        self.idx = idx
        self.a = a
        self.b = b

    def record_success(self):
        self.a += 1

    def record_failure(self):
        self.b += 1

    def draw_ctr(self):
        return np.random.beta(self.a, self.b, 1)[0]

    def mean(self):
        return self.a / (self.a + self.b)
在这篇文章中,我使用谷歌分析在线广告匹配的例子。假设有K个arm。每条arm都是一条点击率(ctr)遵循Beta分布的广告。实验的目标是找到点击率最高的广告。
将贝叶斯更新应用于各臂的Beta分布
多臂老虎机实验的优雅之处在于汤普森采样和贝叶斯更新的协同工作。如果其中一个手臂表现良好,它的Beta分布参数会更新以记住这一点,汤普森采样将更有可能从这个手臂得出高ctr。在整个实验过程中,优异的arm得到的奖励是更多的交易,而劣质的的arm受到的惩罚是更少的交易。
def thompson_sampling(arms):
    """
    Stochastic sampling: take one draw for each arm
    divert traffic to best draw.

    @param arms list[Arm]: list of Arm objects
    @return idx int: index of winning arm from sample
    """
    sample_p = [arm.draw_ctr() for arm in arms]
    idx = np.argmax(sample_p)
    return idx
Beta分布估计的是点击率,我们需要知道我们对每一个点击率的估计有多大的置信度。如果我们对目前ctr最高的arm有足够的信心,我们可以结束实验。
蒙特卡罗模拟的工作方式是从每个K臂中随机抽取样本多次,并根据经验计算每个arm获胜的频率(具有最高的ctr)。如果获胜的那只arm比第二只arm大得多,实验就终止。
def monte_carlo_simulation(arms, draw=100):
    """
    Monte Carlo simulation of thetas. Each arm's click through
    rate follows a beta distribution.

    Parameters
    ----------
    arms list[Arm]: list of Arm objects.
    draw int: number of draws in Monte Carlo simulation.

    Returns
    -------
    mc np.matrix: Monte Carlo matrix of dimension (draw, n_arms).
    p_winner list[float]: probability of each arm being the winner.
    """
    # Monte Carlo sampling
    alphas = [arm.a for arm in arms]
    betas = [arm.b for arm in arms]
    mc = np.matrix(np.random.beta(alphas, betas, size=[draw, len(arms)]))

    # count frequency of each arm being winner
    counts = [0 for _ in arms]
    winner_idxs = np.asarray(mc.argmax(axis=1)).reshape(draw,)
    for idx in winner_idxs:
        counts[idx] += 1

    # divide by draw to approximate probability distribution
    p_winner = [count / draw for count in counts]
    return mc, p_winner
谷歌分析引入了“实验中剩余价值”的概念。在每次蒙特卡罗模拟中,都会计算剩余的值。如果我们选择α = 5%,那么在蒙特卡罗模拟中95%的样本剩余值小于获胜手臂值的1%时,实验终止。

def should_terminate(p_winner, est_ctrs, mc, alpha=0.05):
    """
    Decide whether experiument should terminate. When value remaining in
    experiment is less than 1% of the winning arm's click through rate.

    Parameters
    ----------
    p_winner list[float]: probability of each arm being the winner.
    est_ctrs list[float]: estimated click through rates.
    mc np.matrix: Monte Carlo matrix of dimension (draw, n_arms).
    alpha: controlling for type I error

    @returns bool: True if experiment should terminate.
    """
    winner_idx = np.argmax(p_winner)
    values_remaining = (mc.max(axis=1) - mc[:, winner_idx]) / mc[:, winner_idx]
    pctile = np.percentile(values_remaining, q=100 * (1 - alpha))
    return pctile < 0.01 * est_ctrs[winner_idx]
定义了上面的实用函数之后,将它们放在一起就很简单了。对于每次迭代,都会有一个新用户出现。我们应用Thompson抽样来选择手臂,看看用户是否点击。然后我们更新手臂的Beta参数,检查我们是否对获胜的手臂有足够的信心来结束实验。
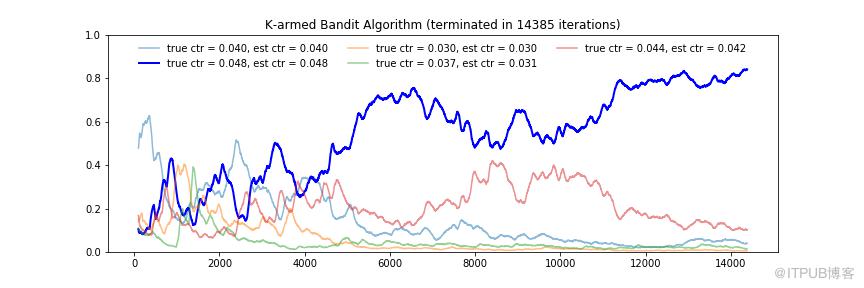
注意,我引入了一个burn-in参数(称为老化参数)。这是声明赢家之前必须运行的最小迭代次数。实验的开始是"最忙碌"的时期,任何失败的arm都可能侥幸领先。老化期有助于防止在噪音稳定下来之前过早地结束实验。
实际上,这也有助于控制新奇效应、冷启动和其他与用户心理相关的混淆变量。谷歌分析迫使所有的多臂实验运行至少2周(这里2周是指观察实验周期,并不是策略更新时间,有所区别)。
def k_arm_bandit(ctrs, alpha=0.05, burn_in=1000, max_iter=100000, draw=100, silent=False):
    """
    Perform stochastic k-arm bandit test. Experiment is terminated when
    value remained in experiment drops below certain threshold.

    Parameters
    ----------
    ctrs list[float]: true click through rates for each arms.
    alpha float: terminate experiment when the (1 - alpha)th percentile
        of the remaining value is less than 1% of the winner's click through rate.
    burn_in int: minimum number of iterations.
    max_iter int: maxinum number of iterations.
    draw int: number of rows in Monte Carlo simulation.
    silent bool: print status at the end of experiment.

    Returns
    -------
    idx int: winner's index.
    est_ctrs list[float]: estimated click through rates.
    history_p list[list[float]]: storing est_ctrs and p_winner.
    traffic list[int]: number of traffic in each arm.
    """
    n_arms = len(ctrs)
    arms = [Arm(idx=i) for i in range(n_arms)]
    history_p = [[] for _ in range(n_arms)]

    for i in range(max_iter):
        idx = thompson_sampling(arms)
        arm, ctr = arms[idx], ctrs[idx]

        # update arm's beta parameters
        if np.random.rand() < ctr:
            arm.record_success()
        else:
            arm.record_failure()

        # record current estimates of each arm being winner
        mc, p_winner = monte_carlo_simulation(arms, draw)
        for j, p in enumerate(p_winner):
            history_p[j].append(p)

        # record current estimates of each arm's ctr
        est_ctrs = [arm.mean() for arm in arms]

        # terminate when value remaining is negligible
        if i >= burn_in and should_terminate(p_winner, est_ctrs, mc, alpha):
            if not silent: print("Terminated at iteration %i"%(i + 1))
            break

    traffic = [arm.a + arm.b - 2 for arm in arms]
    return idx, est_ctrs, history_p, traffic
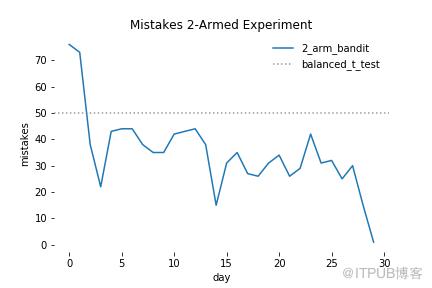
bandit实验的主要优点是它比A/B测试更早终止,因为它需要更小的样本。在一个点击率为4%和5%的双臂实验中,在95%显著性水平下,每个实验组的传统A /B测试需要11,165个。每天有100个用户,这个实验需要223天。而在bandit实验中,模拟在31天后结束,符合上述终止准则。
-
bandit实验的第二个优点是,这个实验比A/B测试犯的错误更少。均衡的A/B测试总是将50%的流量发送给每个组。上图显示,随着实验的进行,越来越少的流量被发送到丢失的arm上(即避免了失败的策略占有较大的流量)。
下面是5个arm的模拟实验。我们发现,在前150次迭代中,红臂(ctr为4.4%)被误认为是获胜臂,我们将80%的流量转向了失败臂。但真正的蓝臂(ctr 4.8%)迎头赶上,成为真正的赢家。

世上没有免费的午餐,更小的样本量带来的便利是以更大的误报率为代价的。虽然我使用了经验的α作为终止实验的假阳性率,但经过多次模拟,假阳性率高于α。
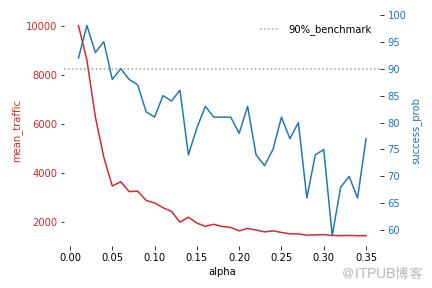
根据经验,α值为5%的人在91%的情况下找到了获胜的arm,而不是95%。我们设置的α越小,我们需要的样本量就越大(用红色表示),这与A/B测试的行为是一致的。
事实证明,没有绝对的赢家,对于产品经理、数据科学家和实践者来说,在做出选择之前了解这两种方法的优缺点是很重要的。在以下情况下,多臂老虎机测试是首选:
-
当用户被分配到一个失败的arm(可以理解为较差的策略)成本很高的时候。在这个例子中,将用户与糟糕的广告相匹配只会导致更少的收益。损失是可以承受的。在其他情况下,例如当测试两种不同的帐户恢复方法时,每个arm的失败意味着永久失去一个用户,多臂老虎机实验显然是一个更好的选择。
-
对于用户流量不足的早期初创公司,多臂老虎机实验效果更好,因为它需要更小的样本容量,更早终止,而且比A/B测试更敏捷。
当有两种以上的策略需要测试时,多臂老虎机实验可以帮助我们快速找到赢家。在bandit实验中,通常一次测试4~8个策略,而A/B测试每次只测试两组。
-
多臂老虎机测试的一个明显局限性是,每个手臂都必须以Beta分布为模型,这意味着每次你尝试一个手臂,它都会导致成功或失败。这对于创建点击率和转换率很有帮助,但如果你想测试哪个校验过程更快,你就必须对均值差进行t检验。
另一方面,A/B测试是一个更好的选择,当公司有足够大的用户群,当控制一类错误是更为重要的时候,当变异数足够少的时候,我们就可以逐个与对照组进行测试。
https://towardsdatascience.com/beyond-a-b-testing-multi-armed-bandit-experiments-1493f709f804
https://static.googleusercontent.com/media/research.google.com/zh-CN//pubs/archive/36500.pdf
欢迎加入ChallengeHub学习交流群


原文作者:ChallengeHub;如有侵权,请联系管理员删除。

