强化学习教程(二):Deep Q Network(DQN)原理与应用

在强化学习教程(一)中,我们了解了Q-Learning的原理,通过有限的状态state和动作action初始化Q-table,从而不断更新Q-table;但是对于图1中的场景中,图像中的状态不断变化,无法枚举全部状态以及动作,如果此时强行使用Q-Learning算法(比如对很多中状态分箱)初始化Q-table,这将是一个高维状态的矩阵,会严重影响agent的学习速度,同时耗用资源和检索时间很大。
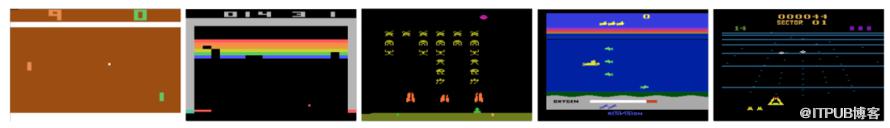
图1:5款雅达利(Atati)2600游戏的截图(从左到右): Pong、Breakout、Space Invaders、 Seaquest、Beam Rider
对于这种无法枚举状态和动作的,如果能够不去建立Q-table,而是直接根据当前环境特征(状态、动作、Q值),就可以得到整个环境的Q值,就可以解决庞大Q-table的问题(即,本质不依赖Q-table);而Deep Q Network(DQN)能够很好的解决这个问题。
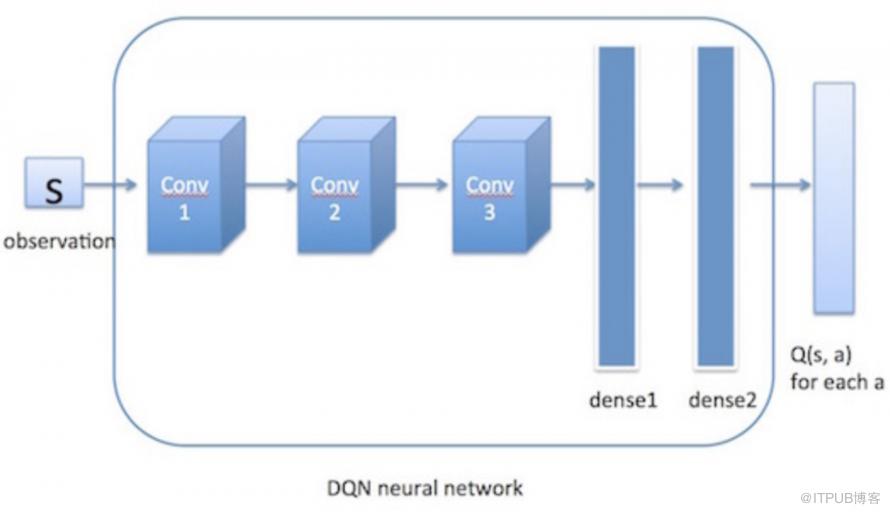
DQN通过输入当前环境特征经过卷积层、隐含层,最终输出每个动作的Q值,最终会根据Q值进行动作的选择。
由于Atati游戏都需要对图像进行渲染、输入,因此需要卷积神经网络(CNN)实现图像读取;
当前环境特征就可以理解为读取的图像大小的所处环境;
可以发现,这个过程中不需要建立Q-table,而是直接根据读取的图像环境,直接输出agent下一个状态需要采取的动作(根据Q值选取)
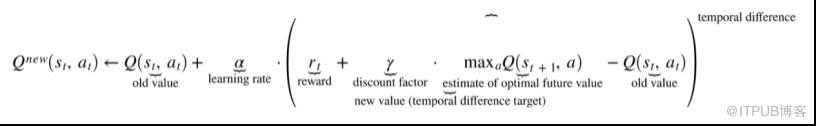
DQN的更新过程与Q-Learning更新过程相似,但是对于Q-Learning在下面公式的更新过程中,用在DQN中存在的一个问题是计算「Target Q」与「Q估计」是同一个Q(即,同一个Q-table),也就是说使用了相同的神经网络;那么在下次更新状态的时候,Target Q也会一起更新,这样会导致神经网络参数不能够收敛(这是因为,神经网络训练学习过程是属于有监督学习的过程,我们更希望标签label是固定的,让神经网络模型更快收敛,而不是时刻改变的,在这里就是对应Target Q尽量是固定的,因此与Q-learning相似的更新过程中,不一样的点在于Target Q网络的设计,当然不同点在算法流程中我们可以看到更多)。

DQN分别设计了Q网络用于计算「Q估计」,以及Target Q不采用与Q估计一模一样的Q网络,而是设计一种带有延迟的Q网络(即定义Q网络与Target Q网络神经网络结构相同,但是Target Q网络引入一个延迟参数w-),从而保证Target Q每隔一段时间步更新(这个时候更新与Q网络一模一样),保证标签Target Q短时间内固定的,从而实现DQN快速收敛。
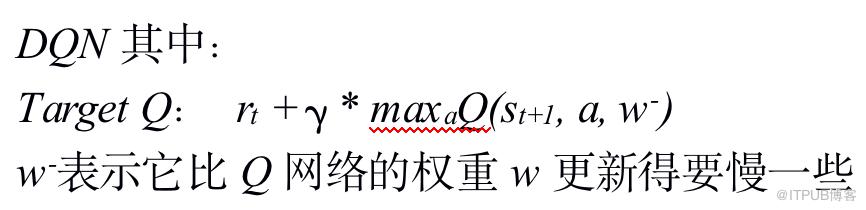
解释了DQN的算法原理,那么下面的算法流程就能够很好的理解了。

【这里需要注意的几点 & DQN的改进】:
网络延迟参数更新:Q网络与Target Q网络的初始化参数w与w-是相同的,episode的C步内只更新Q网络,episode的C步时,更新参数w- = w 更改Target Q = Q估计
经验回放技术:这里我们看到初始化了Memory D,这是由于在强化学习中,我们得到的观测数据是有序的,step by step的,用这样的数据去更新神经网络的参数会有问题。回忆在有监督学习中,数据之间都是独立的。因此DQN中使用经验回放,即用一个Memory来存储经历过的数据,每次更新参数的时候从Memory中抽取一部分的数据来用于更新,以此来打破数据间的关联(同时缓冲区的数据可以用于NN模型训练)。
Loss Function:在算法流程中,我们看到了关于w使用梯度下降法进行更新,因为我们清楚的是神经网络的训练过程是依赖于对损失函数的反向传播,最小化损失函数。那么在这里我们就可以定义一个很明显的损失函数:「Target Q」与 「Q估计」的差值平方的期望(因此我们希望模型能够尽可能的拟合Target Q 与 Q估计),即下面这个公式表示,实际上就是一个残差模型,和我们平常见的最小二乘法很相似。
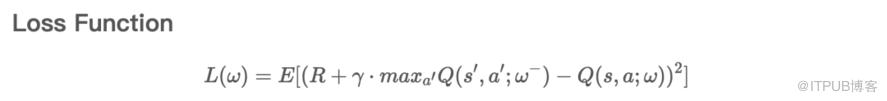
-
值函数近似:可以发现,使用了卷积神经网络来逼近行为值函数Q值,这是一种复杂的非线性模型拟合目标值,同时也是Deep Learning与Reinforcement Learning的完美结合。
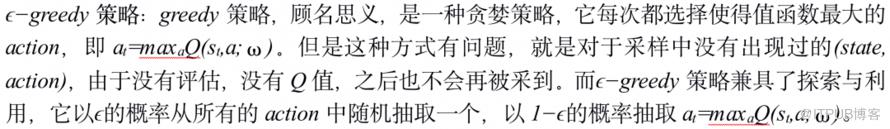
其实这里涉及到了强化学习中一个非常重要的概念,叫Exploration & Exploitation,探索与利用。前者强调发掘环境中的更多信息,并不局限在已知的信息中;后者强调从已知的信息中最大化奖励。而greedy策略只注重了后者,没有涉及前者。所以它并不是一个好的策略。
强化学习正是因为有了探索Exploration,才会常常有一些出人意表的现象,才会更加与其他机器学习不同。例如智能体在围棋游戏中走出一些人类经验之外的好棋局。
同样的为了快速上手,我们在colab进行实验,可以上手Atati游戏的Breakout-v4、Pong-v0、BreakoutDeterministic-v4等游戏;下面的案例形象的展示了Q-Network的建立,以及如何使用经验回放技术以及从缓冲区随机采样数据等DQN的实现过程。
安装环境包
  !sudo apt-get install -y xvfb ffmpeg
  !pip install -q 'gym==0.10.11'
  !pip install -q 'imageio==2.4.0'
  !pip install -q PILLOW
  !pip install -q 'pyglet==1.3.2'
  !pip install -q pyvirtualdisplay
  !pip install -q --upgrade tensorflow-probability
  !pip install -q tf-agents
导入需要的环境包
import base64
import imageio
import IPython
import matplotlib
import matplotlib.pyplot as plt
import numpy as np
import PIL.Image
import pyvirtualdisplay

import tensorflow as tf

from tf_agents.agents.dqn import dqn_agent
from tf_agents.drivers import dynamic_step_driver
from tf_agents.environments import suite_gym, suite_atari
from tf_agents.environments import tf_py_environment, batched_py_environment
from tf_agents.eval import metric_utils
from tf_agents.metrics import tf_metrics
from tf_agents.networks import q_network
from tf_agents.policies import random_tf_policy
from tf_agents.replay_buffers import tf_uniform_replay_buffer
from tf_agents.trajectories import trajectory
from tf_agents.utils import common

from tf_agents.specs import tensor_spec
from tf_agents.trajectories import time_step as ts
display = pyvirtualdisplay.Display(visible=0, size=(1400, 900)).start()
num_iterations = 250000

initial_collect_steps = 200
collect_steps_per_iteration = 10
replay_buffer_max_length = 100000

batch_size =   32
learning_rate = 2.5e-3
log_interval =   5000

num_eval_episodes = 5
eval_interval = 25000
雅达利游戏通常使用2D显示器作为环境状态。AI Gym将雅达利游戏表示为基于屏幕间隔的3D状态(高度、宽度、颜色),或表示游戏计算机RAM状态的矢量。为了预处理Atari游戏以获得更高的计算效率,我们通常会跳过几帧,降低分辨率,并丢弃颜色信息。下面的代码展示了如何设置Atari环境。
#env_name = 'Breakout-v4'
env_name = 'Pong-v0'
#env_name = 'BreakoutDeterministic-v4'
#env = suite_gym.load(env_name)

# AtariPreprocessing runs 4 frames at a time, max-pooling over the last 2
# frames. We need to account for this when computing things like update
# intervals.
ATARI_FRAME_SKIP = 4

max_episode_frames=108000  # ALE frames

env = suite_atari.load(
    env_name,
    max_episode_steps=max_episode_frames / ATARI_FRAME_SKIP,
    gym_env_wrappers=suite_atari.DEFAULT_ATARI_GYM_WRAPPERS_WITH_STACKING)
#env = batched_py_environment.BatchedPyEnvironment([env])
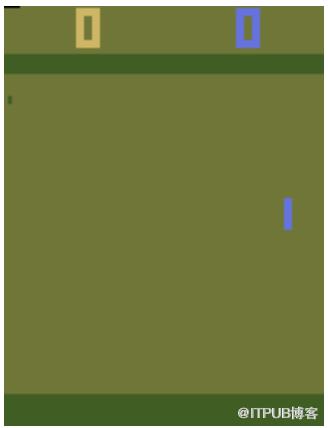
重置环境并显示一个步骤。下图显示了Pong游戏环境对用户的影响。
env.reset()
PIL.Image.fromarray(env.render())
train_py_env = suite_atari.load(
    env_name,
    max_episode_steps=max_episode_frames / ATARI_FRAME_SKIP,
    gym_env_wrappers=suite_atari.DEFAULT_ATARI_GYM_WRAPPERS_WITH_STACKING)

eval_py_env = suite_atari.load(
    env_name,
    max_episode_steps=max_episode_frames / ATARI_FRAME_SKIP,
    gym_env_wrappers=suite_atari.DEFAULT_ATARI_GYM_WRAPPERS_WITH_STACKING)

train_env = tf_py_environment.TFPyEnvironment(train_py_env)
eval_env = tf_py_environment.TFPyEnvironment(eval_py_env)
使用以下来自TF-Agents示例的类来包装常规的Q-network类。AtariQNetwork类确保来自Atari屏幕的像素值除以255。这种划分通过将像素值归一化到0到1之间来辅助神经网络。
class AtariQNetwork(q_network.QNetwork):
  """QNetwork subclass that divides observations by 255."""

  def call(self,
           observation,
           step_type=None,
           network_state=(),
           training=False):
    state = tf.cast(observation, tf.float32)
    # We divide the grayscale pixel values by 255 here rather than storing
    # normalized values beause uint8s are 4x cheaper to store than float32s.
    state = state / 255
    return super(AtariQNetwork, self).call(
        state, step_type=step_type, network_state=network_state,
        training=training)
两个特定的神经网络的超参数。
卷积神经网络通常由几个交替的卷积层和最大池化层组成,最终形成一个或多个dense层。这些层与之前在本课程中看到的类型相同。Q-Network接受两个参数来定义卷积神经网络结构。
这两个参数中比较简单的一个是fc_layer_params。该参数指定每个dense层的大小。元组指定列表中每个层的大小。
第二个参数名为conv_layer_params,是一个卷积层参数列表
fc_layer_params = (512,)
conv_layer_params=((32, (8, 8), 4), (64, (4, 4), 2), (64, (3, 3), 1))

q_net = AtariQNetwork(
            train_env.observation_spec(),
            train_env.action_spec(),
            conv_layer_params=conv_layer_params,
            fc_layer_params=fc_layer_params)
optimizer = tf.compat.v1.train.RMSPropOptimizer(
    learning_rate=learning_rate,
    decay=0.95,
    momentum=0.0,
    epsilon=0.00001,
    centered=True)

train_step_counter = tf.Variable(0)

observation_spec = tensor_spec.from_spec(train_env.observation_spec())
time_step_spec = ts.time_step_spec(observation_spec)

action_spec = tensor_spec.from_spec(train_env.action_spec())
target_update_period=32000  # ALE frames
update_period=16  # ALE frames
_update_period = update_period / ATARI_FRAME_SKIP
_global_step = tf.compat.v1.train.get_or_create_global_step()

agent = dqn_agent.DqnAgent(
    time_step_spec,
    action_spec,
    q_network=q_net,
    optimizer=optimizer,
    epsilon_greedy=0.01,
    n_step_update=1.0,
    target_update_tau=1.0,
    target_update_period=(
        target_update_period / ATARI_FRAME_SKIP / _update_period),
    td_errors_loss_fn=common.element_wise_huber_loss,
    gamma=0.99,
    reward_scale_factor=1.0,
    gradient_clipping=None,
    debug_summaries=False,
    summarize_grads_and_vars=False,
    train_step_counter=_global_step)


agent.initialize()
指标和评估:有许多不同的方法来衡量用强化学习训练的模型的有效性。内部Q-network的损失函数并不能很好地衡量整个DQN算法的整体适应度。网络损失函数衡量Target Q与Q估计的拟合成都,但并没有显示DQN在最大化回报方面的有效性。本例中使用的方法追踪了在几轮迭代中获得的平均奖励。
def compute_avg_return(environment, policy, num_episodes=10):

  total_return = 0.0
  for _ in range(num_episodes):

    time_step = environment.reset()
    episode_return = 0.0

    while not time_step.is_last():
      action_step = policy.action(time_step)
      time_step = environment.step(action_step.action)
      episode_return += time_step.reward
    total_return += episode_return

  avg_return = total_return / num_episodes
  return avg_return.numpy()[0]


# See also the metrics module for standard implementations of
# different metrics.
# https://github.com/tensorflow/agents/tree/master/tf_agents/metrics
经验回放技术:DQN的工作原理是训练一个神经网络来预测每个可能的环境状态的q值。神经网络需要训练数据,因此算法在运行集的时候积累训练数据。重播缓冲区是存储这些数据的地方。只存储最近的数据,当队列积累新数据时,较旧的剧集数据从队列滚出。
replay_buffer = tf_uniform_replay_buffer.TFUniformReplayBuffer(
    data_spec=agent.collect_data_spec,
    batch_size=train_env.batch_size,
    max_length=replay_buffer_max_length)

# Dataset generates trajectories with shape [Bx2x...]
dataset = replay_buffer.as_dataset(
    num_parallel_calls=3,
    sample_batch_size=batch_size,
    num_steps=2).prefetch(3)
随机采样:训练不能在空的重播缓冲区开始。下面的代码执行预定义的步骤来生成初始训练数据。
random_policy = random_tf_policy.RandomTFPolicy(train_env.time_step_spec(),
                                                train_env.action_spec())

def collect_step(environment, policy, buffer):
  time_step = environment.current_time_step()
  action_step = policy.action(time_step)
  next_time_step = environment.step(action_step.action)
  traj = trajectory.from_transition(time_step, action_step, next_time_step)

  # Add trajectory to the replay buffer
  buffer.add_batch(traj)

def collect_data(env, policy, buffer, steps):
  for _ in range(steps):
    collect_step(env, policy, buffer)

collect_data(train_env, random_policy, replay_buffer, \
             steps=initial_collect_steps)
训练agent:这个过程可能需要很多个小时,这取决于您希望运行多少轮。当训练发生时,这个代码将更新损失和平均奖励回报。随着训练越来越成功,平均回报也会增加。报告的损失反映了每个训练批次的平均损失。
iterator = iter(dataset)

# (Optional) Optimize by wrapping some of the code in a graph
# using TF function.
agent.train = common.function(agent.train)

# Reset the train step
agent.train_step_counter.assign(0)

# Evaluate the agent's policy once before training.
avg_return = compute_avg_return(eval_env, agent.policy, \
                                num_eval_episodes)
returns = [avg_return]

for _ in range(num_iterations):

  # Collect a few steps using collect_policy and save to the replay buffer.
  for _ in range(collect_steps_per_iteration):
    collect_step(train_env, agent.collect_policy, replay_buffer)

  # Sample a batch of data from the buffer and update the agent's network.
  experience, unused_info = next(iterator)
  train_loss = agent.train(experience).loss

  step = agent.train_step_counter.numpy()

  if step % log_interval == 0:
    print('step = {0}: loss = {1}'.format(step, train_loss))

  if step % eval_interval == 0:
    avg_return = compute_avg_return(eval_env, agent.policy, \
                                    num_eval_episodes)
    print('step = {0}: Average Return = {1}'.format(step, avg_return))
    returns.append(avg_return)
展示部分迭代过程:


可视化平均奖励反馈:
iterations = range(0, num_iterations + 1, eval_interval)
plt.plot(iterations, returns)
plt.ylabel('Average Return')
plt.xlabel('Iterations')
plt.ylim(top=10)
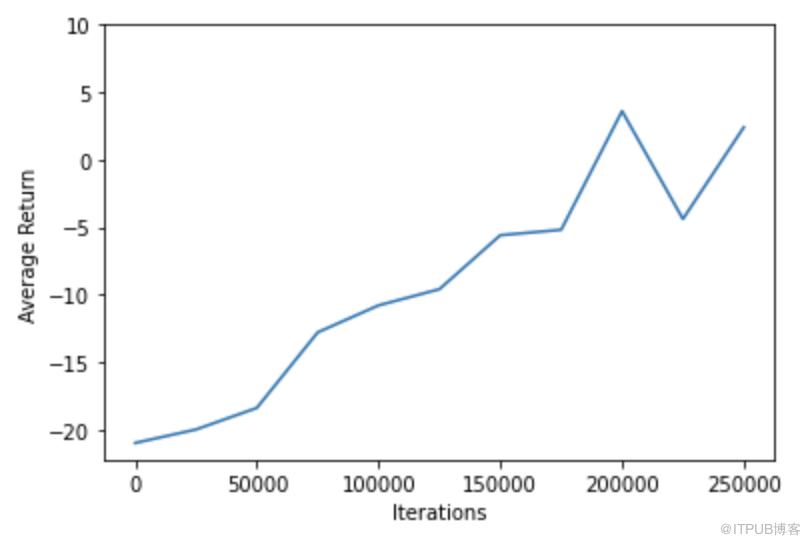
游戏过程视频播放:我们现在有一个训练过的模型,并在图上观察它的训练进度。查看雅达利游戏结果的最吸引人的方式是让我们看到代理玩游戏的视频。定义了以下函数,以便我们可以在笔记本上观看代理进行游戏。
def embed_mp4(filename):
  """Embeds an mp4 file in the notebook."""
  video = open(filename,'rb').read()
  b64 = base64.b64encode(video)
  tag = '''
  <video width="640" height="480" controls>
    <source src="data:video/mp4;base64,{0}" type="video/mp4">
  Your browser does not support the video tag.
  </video>'''.format(b64.decode())

  return IPython.display.HTML(tag)

def create_policy_eval_video(policy, filename, num_episodes=5, fps=30):
  filename = filename + ".mp4"
  with imageio.get_writer(filename, fps=fps) as video:
    for _ in range(num_episodes):
      time_step = eval_env.reset()
      video.append_data(eval_py_env.render())
      while not time_step.is_last():
        action_step = policy.action(time_step)
        time_step = eval_env.step(action_step.action)
        video.append_data(eval_py_env.render())
  return embed_mp4(filename)
训练过的agent玩游戏
create_policy_eval_video(agent.policy, "trained-agent")
随机的agent玩游戏
create_policy_eval_video(random_policy, "random-agent")
参考文献
https://blog.csdn.net/weixin_43283397/article/details/102807956?utm_source=app&app_version=4.5.2
https://wanjun0511.github.io/2017/11/05/DQN/
https://github.com/jeffheaton/t81_558_deep_learning
欢迎加入ChallengeHub学习交流群:
原文作者:ChallengeHub;如有侵权,请联系管理员删除。

