强化学习教程(三):基于策略的Policy Gradient(PG)算法

在强化学习教程(一)和(二)中,我们分别介绍了Q-Learning和DQN算法,它们都是基于价值进行动作选择(即通过Q值选择动作),那么能不能建立一个神经网络,输入状态,直接输出动作,而不是输出每个动作的Q值然后选择动作。Policy Gradient(PG)能够很好的解决这个问题。
PG通过状态输出动作或者动作的概率,这样做的优点就是它可以在一个连续区间内选取动作【比如自动驾驶汽车,需要时刻改变n角度,这个时候DQN输出离散动作的Q值,然后选择动作,就无法满足了】,输出的方式采用神经网络结构。我们了解的是,想要建立神经网络结构就必须要构建一个损失函数,然后通过反向传播方式最小化我们的损失值。
由于我们是直接选择动作,我们也并不知道这个动作选择的好坏,因此我们不能像DQN那样建立一个「Target Q」和「Q估计」的残差模型作为损失函数,但是我们直接去输出动作的最终目标是让获得的奖励最大;因此我们可以建立一个最大化奖励的目标函数(为了作为最小化损失函数,取最大化奖励的负值):
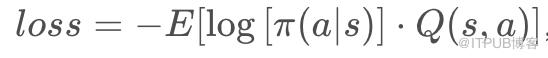
可以理解为如果一个动作的奖励值较大,则下次选取该动作的可能性增加的幅度也大,反之选取该动作的可能性增加的幅度小。
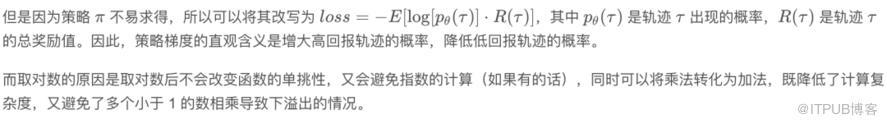
即,该处损失函数的作用就是,PG如果这个回合选择某一动作,下一回合选择该动作的概率大一些,然后再看奖惩值,如果奖惩是正的,那么会放大这个动作的概率,如果奖惩是负的,就会减小该动作的概率。
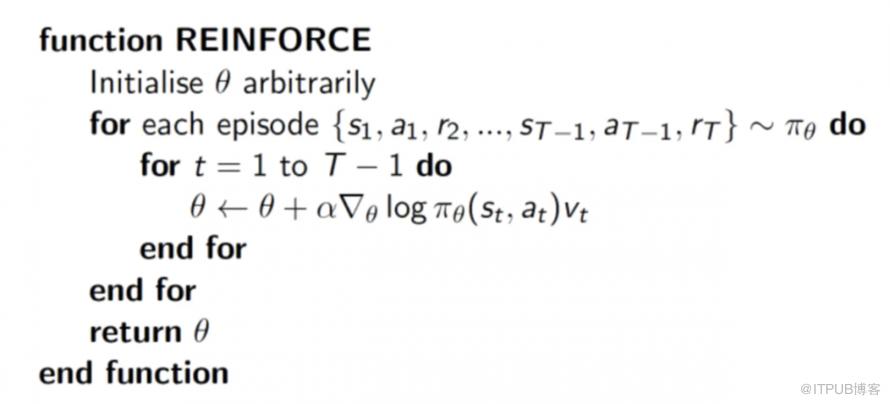
log(Policy(s,a))*V中的log(Policy(s,a))表示在 状态s对所选动作a的吃惊度, 如果Policy(s,a)概率越小, 反向的log(Policy(s,a))(即-log(P)) 反而越大. 如果在Policy(s,a)很小的情况下, 拿到了一个 大的R, 也就是 大的V, 那-log(Policy(s, a))*V就更大, 表示更吃惊, (我选了一个不常选的动作, 却发现原来它能得到了一个好的 reward, 那我就得对我这次的参数进行一个大幅修改). 这就是log(Policy)*V的物理意义啦.
相比较DQN采用短期冷冻Target Q网络相比,具有更好的收敛性;
PG更适用于输出的动作是连续的动作分布;
能够对随机策略进行学习
由于是直接输出动作,很容易在局部最优解上收敛,而不是全局最优;
对策略的估计通常具有很大的方差,求解过程低效
import argparse
import gym
import numpy as np
from itertools import count

import torch
import torch.nn as nn
import torch.nn.functional as F
import torch.optim as optim
from torch.distributions import Categorical


parser = argparse.ArgumentParser(description='PyTorch REINFORCE example')
parser.add_argument('--gamma', type=float, default=0.99, metavar='G',
                    help='discount factor (default: 0.99)')
parser.add_argument('--seed', type=int, default=543, metavar='N',
                    help='random seed (default: 543)')
parser.add_argument('--render', action='store_true',
                    help='render the environment')
parser.add_argument('--log-interval', type=int, default=10, metavar='N',
                    help='interval between training status logs (default: 10)')
args = parser.parse_args()


env = gym.make('CartPole-v1')
env.seed(args.seed)
torch.manual_seed(args.seed)


class Policy(nn.Module):
    #[1,4]-->[1,128]-->[1,2]-->softmax
    def __init__(self):
        super(Policy, self).__init__()
        self.affine1 = nn.Linear(4, 128)
        self.dropout = nn.Dropout(p=0.6)
        self.affine2 = nn.Linear(128, 2)

        self.saved_log_probs = []
        self.rewards = []

    def forward(self, x):
        x = self.affine1(x)
        x = self.dropout(x)
        x = F.relu(x)
        action_scores = self.affine2(x)
        return F.softmax(action_scores, dim=1)


policy = Policy()
optimizer = optim.Adam(policy.parameters(), lr=1e-2)
eps = np.finfo(np.float32).eps.item()


def select_action(state):
    state = torch.from_numpy(state).float().unsqueeze(0)  #将observation转换成tensor
    probs = policy(state)
    m = Categorical(probs)
    action = m.sample()  #按照概率进行采样
    policy.saved_log_probs.append(m.log_prob(action))#m.log_prob(value)函数则是公式中的log部分
    return action.item()


def finish_episode():
    R = 0
    policy_loss = []
    returns = []
    #计算的每个动作时刻收到的回报
    for r in policy.rewards[::-1]:
        R = r + args.gamma * R
        returns.insert(0, R)
    returns = torch.tensor(returns)
    returns = (returns - returns.mean()) / (returns.std() + eps) #标准化
    for log_prob, R in zip(policy.saved_log_probs, returns):
        policy_loss.append(-log_prob * R)
    optimizer.zero_grad()
    policy_loss = torch.cat(policy_loss).sum()
    policy_loss.backward()
    optimizer.step()
    del policy.rewards[:]
    del policy.saved_log_probs[:]


def main():
    running_reward = 10
    for i_episode in count(1):
        state, ep_reward = env.reset(), 0
        for t in range(1, 10000):  # Don't infinite loop while learning
            action = select_action(state)
            state, reward, done, _ = env.step(action)
            if args.render:
                env.render()
            policy.rewards.append(reward) #记录每一步的奖励
            ep_reward += reward  #回报相加
            if done:  #如果为True,这个eposid结束
                break
        #平均reward奖励
        running_reward = 0.05 * ep_reward + (1 - 0.05) * running_reward
        finish_episode()
        if i_episode % args.log_interval == 0:
            print('Episode {}\tLast reward: {:.2f}\tAverage reward: {:.2f}'.format(
                  i_episode, ep_reward, running_reward))
        if running_reward > env.spec.reward_threshold:
            print("Solved! Running reward is now {} and "
                  "the last episode runs to {} time steps!".format(running_reward, t))
            break


if __name__ == '__main__':
    main()
https://www.jianshu.com/p/2ccbab48414b
https://homes.cs.washington.edu/~todorov/courses/amath579/reading/PolicyGradient.pdf
-
https://blog.csdn.net/lihuanyu520/article/details/108394251?utm_medium=distribute.pc_relevant.none-task-blog-OPENSEARCH-7.control&dist_request_id=7cf25061-d286-4e4a-a46f-9f6457d47956&depth_1-utm_source=distribute.pc_relevant.none-task-blog-OPENSEARCH-7.control
END
欢迎加入学习交流群
添加助手微信,可加入微信交流群
发现“在看”和“赞”了吗,戳我试试吧

原文作者:ChallengeHub;如有侵权,请联系管理员删除。

