PySpark四: 机器学习
前面几章介绍了Pyspark的概念与基础的操作,没有看过的朋友可以找我之前发布的文章。本章介绍的是如何采用Pyspark进行机器学习,说实话采用Pyspark进行机器学习的话确实没有直接采用Python来的方便,不过Pyspark可以更加方便地与数据打交道,在一些环境的部署中会更加地容易。废话不多说了,让我们开始机器学习吧。
1、数据读取与探查
第一步数据读取,这里之前都介绍过了。
from pyspark.sql import SparkSession
spark=SparkSession.builder.appName('binary_class').getOrCreate()
df=spark.read.csv('classification_data.csv',inferSchema=True,header=True)
查看数据的大致情况,数据的数量和特征的数量。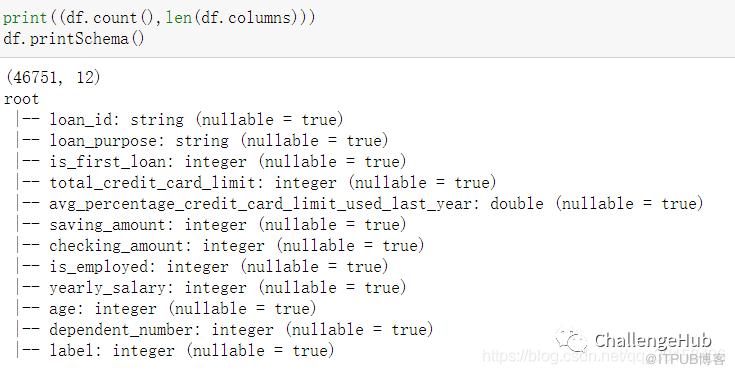 查看部分特征的数据以及基本的信息(由于特征太多,因此只查看部分特征)
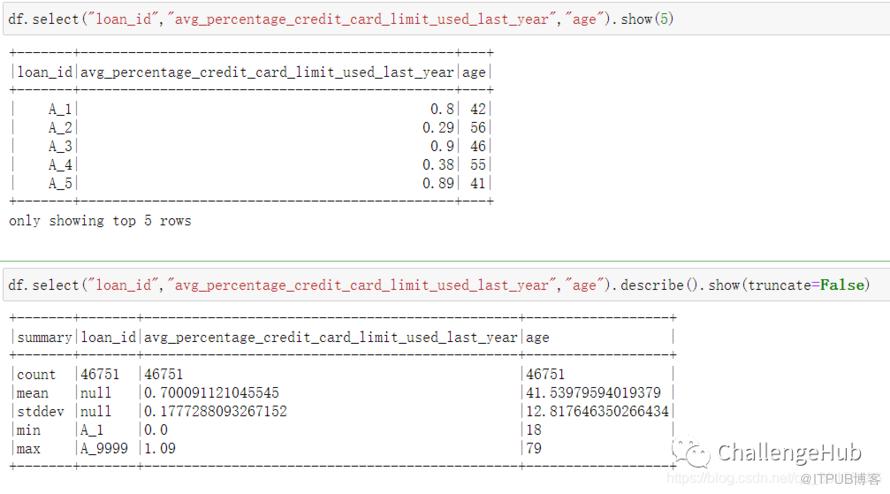
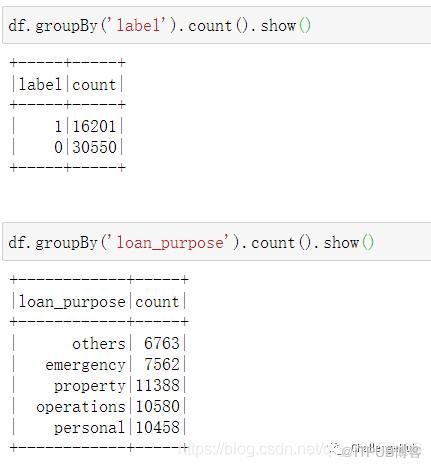
2、特征处理
首先导入特征处理所需要的包,第二行代码是建立一个loan_purpose特征的索引,将该特征中的五个String特征转化为0,1,2,3,4。然后在此基础上进行OneHot操作。
1:from pyspark.ml.feature import OneHotEncoder, StringIndexer, VectorAssembler
2:loan_purpose_indexer = StringIndexer(inputCol="loan_purpose", outputCol="loan_index").fit(df)
3:df = loan_purpose_indexer.transform(df)
4:loan_encoder = OneHotEncoder(inputCol="loan_index",outputCol="loan_purpose_vec").fit(df)
5:df = loan_encoder.transform(df)


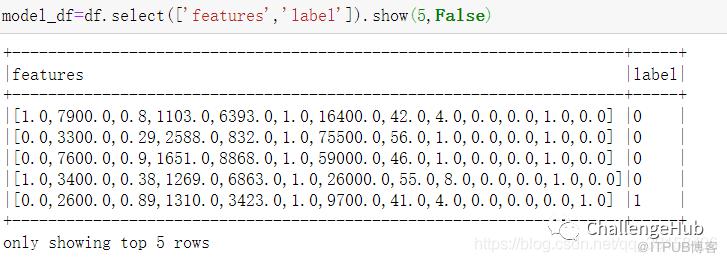 通过VectorAssembler将所有的特征聚合成Features特征,该特征是一个Vec,如上图所示。经过上述的操作,得到模型训练的特征和Label。
3、逻辑回归
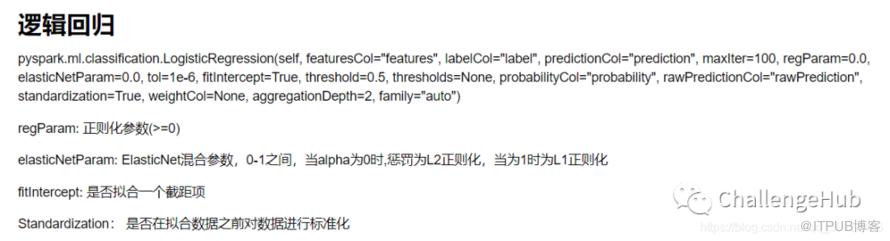 上图中为Pyspark中逻辑回归类主要参数的介绍,下面代码是采用逻辑回归的一个例子。
from pyspark.ml.classification import LogisticRegression
training_df,test_df=model_df.randomSplit([0.75,0.25])
log_reg=LogisticRegression(regParam=0.01).fit(training_df)
模型预测完了之后需要查看模型的效果,可以采用下面的函数获得模型的一些结果。
lr_summary=log_reg.summary
lr_summary的是一个pyspark.ml.classification.BinaryLogisticRegressionTrainingSummary类,该类的方法可以点击网页。这里我举几个例子,查看下模型的结果。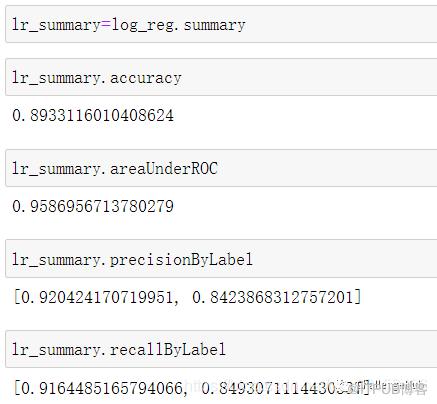 接下来可以查看验证集的结果和进行预测。
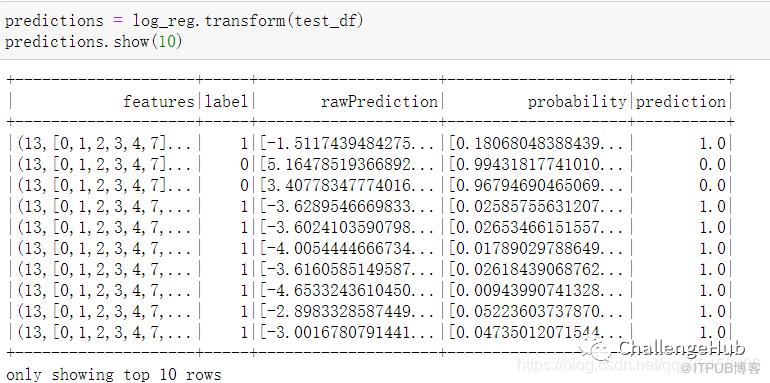 也可以采用evaluate函数,predictions的数据形式为pyspark.ml.classification.BinaryLogisticRegressionSummary,与上文中的lr_summary类似
predictions = log_reg.evaluate(test_df)
4、决策树
from pyspark.ml.classification import DecisionTreeClassifier
dt = DecisionTreeClassifier(maxDepth=5)
dtModel = dt.fit(training_df)
result = dtModel.transform(test_df)
5、随机森林
from pyspark.ml.classification import RandomForestClassifier
rf = RandomForestClassifier(numTrees=10, maxDepth=5)
rfModel = rf.fit(training_df)
result = rfModel.transform(test_df)
6、梯度提升树
from pyspark.ml.classification import GBTClassifier
gbt = GBTClassifier(maxDepth=5)
gbtModel = gbt.fit(training_df)
result = gbtModel.transform(test_df)
7、朴素贝叶斯
from pyspark.ml.classification import NaiveBayes
nb = NaiveBayes()
nbModel = nb.fit(training_df)
result = nbModel.transform(test_df)
8、支持向量机
from pyspark.ml.classification import LinearSVC
svm = LinearSVC(maxIter=10, regPcaram=0.01)
svmModel = svm.fit(training_df)
result = svmModel.transform(test_df)9:尾言
本节中介绍了如何使用pysaprk简单地处理特征,如何调用机器学习算法和如何查看学习效果等。想了解更多算法,数据分析,数据挖掘等方面的知识,欢迎关注ChallengeHub公众号,添加微信进入微信交流群,或者进入QQ交流群。
ChallengeHub出品

参考:
[1]https://github.com/ffzs/pyspark_learning
[2]https://github.com/drabastomek/learningPySpark
[3]Learn Pyspark
推荐阅读:
原文作者:ChallengeHub;如有侵权,请联系管理员删除。

