使用自动编码器的半监督分类用于欺诈检测中
介绍
根据定义,机器学习可以被定义为一个复杂的过程,它从一个数据集中学习可能最好的、最相关的模式、关系或关联,这些模式、关系或关联可用于预测未知数据的结果。广义上讲,它们存在三种不同的机器学习过程:
监督学习是在一个标记数据集中训练一个机器学习模型的过程。目标变量是已知的数据集。在这种技术中,模型的目的是找到自变量和因变量之间的关系。有监督学习的例子有分类、回归和预测。
无监督学习是在目标变量未知的数据集上训练机器学习模型的过程。在这种技术中,模型的目标是在数据或数据段中找到最相关的模式。无监督学习的例子有聚类(如基础的K-Means)、分割、降维(如PCA)等。
半监督学习是监督和非监督学习过程的组合,其中未标记的数据被用于训练模型。在这种方法中,使用非监督学习的属性来学习数据的最佳可能表示,使用监督学习的属性来学习表示中的关系,然后使用这些关系来进行预测。在这个内核中,我已经解释了如何使用半监督学习方法执行分类任务。这种方法利用自动编码器学习数据的表示,然后训练一个简单的线性分类器将数据集分类到各自所属的类别。
使用半监督学习的欺诈检测
我正在使用ULB机器学习的信用卡欺诈检测数据集。稍后,我也将同样的技术应用于泰坦尼克数据集。许多kagglers分享了不同的方法,比如数据集平衡、异常检测、boosting模型、深度学习等,但这个方法是不同的。
内容
数据集准备 可视化欺诈与非欺诈交易 自动编码器:潜在表示提取 获取潜在表示 可视化潜在表示:欺诈与非欺诈 简单线性分类器 在泰坦数据集上应用相同的技术
1.数据准备
首先,我们将使用pandas dataframe加载所有必需的库和数据集。
from keras.layers import Input, Dense
from keras.models import Model, Sequential
from keras import regularizers
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, accuracy_score
from sklearn.manifold import TSNE
from sklearn import preprocessing
import matplotlib.pyplot as plt
import pandas as pd
import numpy as np
import seaborn as sns
sns.set(style="whitegrid")
np.random.seed(203)

data = pd.read_csv("../input/creditcardfraud/creditcard.csv")
data["Time"] = data["Time"].apply(lambda x : x / 3600 % 24)
data.head()
数据集由28个匿名变量组成,一个变量amount; 一个变量time; 一个目标变量target-类别。让我们看看目标的分布。
vc = data['Class'].value_counts().to_frame().reset_index()
vc['percent'] = vc["Class"].apply(lambda x : round(100*float(x) / len(data), 2))
vc = vc.rename(columns = {"index" : "Target", "Class" : "Count"})
vc
这一问题的最大挑战之一是target高度不平衡,只有0.17%的案例是欺诈交易,但是表示学习方法的优势在于它仍然能够处理问题的不平衡性,我们将看看如何应用。对于我们的用例,我们只取大约1000行非欺诈事务。
只考虑1000条非欺诈案件
non_fraud = data[data['Class'] == 0].sample(1000)
fraud = data[data['Class'] == 1]

df = non_fraud.append(fraud).sample(frac=1).reset_index(drop=True)
X = df.drop(['Class'], axis = 1).values
Y = df["Class"].values
2.可视化欺诈和非欺诈交易
让我们用T-SNE可视化欺诈和非欺诈交易的性质。T-SNE (t-Distributed random Neighbor Embedding)是一种数据集分解技术,它降低了数据的维数,只产生信息量最大的top n个分量。下面的每个点代表一个事务。非欺诈交易用绿色表示,而欺诈交易用红色表示。两个轴是t-sne提取的分量。
def tsne_plot(x1, y1, name="graph.png"):
    tsne = TSNE(n_components=2, random_state=0)
    X_t = tsne.fit_transform(x1)

    plt.figure(figsize=(12, 8))
    plt.scatter(X_t[np.where(y1 == 0), 0], X_t[np.where(y1 == 0), 1], marker='o', color='g', linewidth='1', alpha=0.8, label='Non Fraud')
    plt.scatter(X_t[np.where(y1 == 1), 0], X_t[np.where(y1 == 1), 1], marker='o', color='r', linewidth='1', alpha=0.8, label='Fraud')

    plt.legend(loc='best');
    plt.savefig(name);
    plt.show();

tsne_plot(X, Y, "original.png")
从上图中我们可以看到,有很多非欺诈交易,它们非常接近于欺诈交易,因此很难从模型中准确地分类。
3.自动编码器来救援
Autoencoders是什么?
-自动编码器是一种特殊类型的神经网络结构,其中的输出和输入是相同的。自动编码器以无监督的方式进行训练,以便学习输入数据的极低级别表示。然后,这些低级特征会被变形,以投影实际数据。一个自动编码器是一个回归任务,网络被要求预测它的输入(换句话说,建立恒等函数模型)。这些网络中间有几个神经元构成的瓶颈,迫使它们产生有效的表示,将输入压缩成低维码,以便解码器重现原始输入。
我们将创建一个自动编码器模型,在该模型中我们只显示非欺诈案例。该模型将尝试学习非欺诈案例的最佳表现。同样的模型将用于生成欺诈案例的表示,我们希望它们不同于非欺诈案例。
创建一个网络,一个输入层和一个输出层的尺寸相同。非欺诈案件的形态,我们将使用keras包。
input_layer = Input(shape=(X.shape[1],))

## encoding part
encoded = Dense(100, activation='tanh', activity_regularizer=regularizers.l1(10e-5))(input_layer)
encoded = Dense(50, activation='relu')(encoded)

## decoding part
decoded = Dense(50, activation='tanh')(encoded)
decoded = Dense(100, activation='tanh')(decoded)

## output layer
output_layer = Dense(X.shape[1], activation='relu')(decoded)
通过编译输入层和输出层来创建模型体系结构。同时添加优化器和损失函数,我使用“adadelta”作为优化器和“mse”作为损失函数。
autoencoder = Model(input_layer, output_layer)
autoencoder.compile(optimizer="adadelta", loss="mse")
在训练之前,让我们执行数据的最小最大缩放。
x = data.drop(["Class"], axis=1)
y = data["Class"].values

x_scale = preprocessing.MinMaxScaler().fit_transform(x.values)
x_norm, x_fraud = x_scale[y == 0], x_scale[y == 1]
这种方法的美妙之处在于,我们不需要太多的数据样本来学习良好的表示。我们将只使用2000行非欺诈案例来训练自动编码器。此外,我们不需要太多的epochs运行这个模型。
解释: 从原始数据集选择小样本是基于直觉,一个类别特征(非欺诈)将不同于另一个(欺诈)。为了区分这些特征,我们只需要向自动编码器显示一类数据。这是因为自动编码器将尝试只学习一个类别,并自动区分其他类别。
autoencoder.fit(x_norm[0:2000], x_norm[0:2000],
                batch_size = 256, epochs = 10,
                shuffle = True, validation_split = 0.20);
Train on 1600 samples, validate on 400 samples
Epoch 1/10
1600/1600 [==============================] - 1s 358us/step - loss: 0.7218 - val_loss: 0.4842
Epoch 2/10
1600/1600 [==============================] - 0s 19us/step - loss: 0.4609 - val_loss: 0.3261
Epoch 3/10
1600/1600 [==============================] - 0s 19us/step - loss: 0.3052 - val_loss: 0.2208
Epoch 4/10
1600/1600 [==============================] - 0s 19us/step - loss: 0.1991 - val_loss: 0.1238
Epoch 5/10
1600/1600 [==============================] - 0s 19us/step - loss: 0.1303 - val_loss: 0.1265
Epoch 6/10
1600/1600 [==============================] - 0s 18us/step - loss: 0.1313 - val_loss: 0.0889
Epoch 7/10
1600/1600 [==============================] - 0s 19us/step - loss: 0.0986 - val_loss: 0.0975
Epoch 8/10
1600/1600 [==============================] - 0s 17us/step - loss: 0.1131 - val_loss: 0.0793
Epoch 9/10
1600/1600 [==============================] - 0s 18us/step - loss: 0.0857 - val_loss: 0.0797
Epoch 10/10
1600/1600 [==============================] - 0s 19us/step - loss: 0.0966 - val_loss: 0.0721
4.获取潜在表示
现在,模型已经训练好了。我们感兴趣的是获得模型学习的输入的潜在表示。这可以通过训练模型的权值来访问。我们将创建另一个包含顺序层的网络,我们将只添加训练过的权值,直到存在潜在表示的第三层。
hidden_representation = Sequential()
hidden_representation.add(autoencoder.layers[0])
hidden_representation.add(autoencoder.layers[1])
hidden_representation.add(autoencoder.layers[2])
通过使用上述模型预测原始输入,生成两个类别的隐含层表示:非欺诈类和欺诈类。
norm_hid_rep = hidden_representation.predict(x_norm[:3000])
fraud_hid_rep = hidden_representation.predict(x_fraud)
5.可视化潜在表示:欺诈VS非欺诈
现在,我们将使用获得的潜在表示创建一个训练数据集,并让我们可视化欺诈与非欺诈案例的性质。
rep_x = np.append(norm_hid_rep, fraud_hid_rep, axis = 0)
y_n = np.zeros(norm_hid_rep.shape[0])
y_f = np.ones(fraud_hid_rep.shape[0])
rep_y = np.append(y_n, y_f)
tsne_plot(rep_x, rep_y, "latent_representation.png")
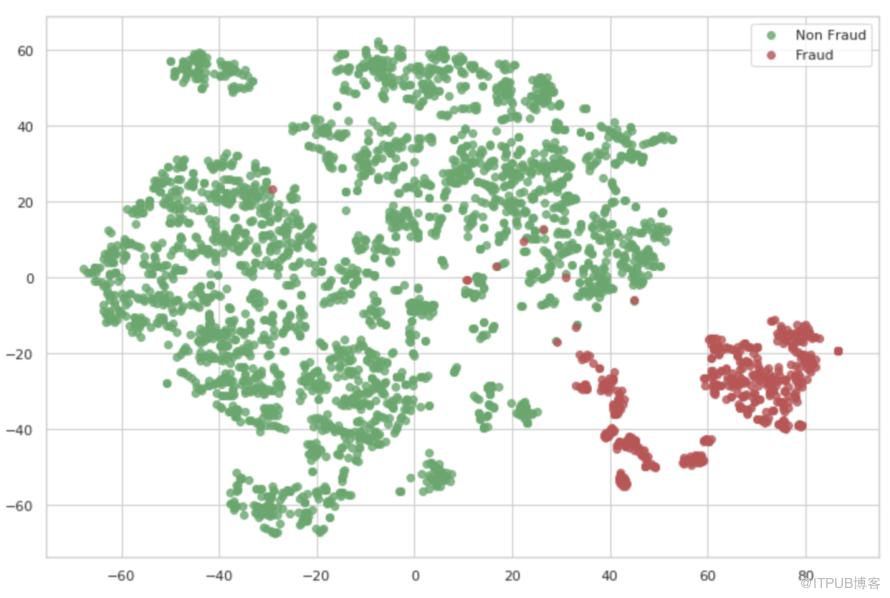 多么完美的图表,我们可以看到现在欺诈和非欺诈交易是非常明显的并且线性可分的。现在我们不需要任何复杂的模型来进行分类,甚至可以用更简单的模型来进行预测。这是对欺诈和非欺诈交易的前后看法。
from IPython.display import display, Image, HTML
display(HTML("""<table align="center">
<tr ><td><b>Actual Representation (Before) </b></td><td><b>Latent Representation (Actual)</b></td></tr>
<tr><td><img src='original.png'></td><td>
             <img src='latent_representation.png'></td></tr></table>"""))
现在,我们可以在数据集上训练一个简单的线性分类器。
6.简单的线性分类器
train_x, val_x, train_y, val_y = train_test_split(rep_x, rep_y, test_size=0.25)
clf = LogisticRegression(solver="lbfgs").fit(train_x, train_y)
pred_y = clf.predict(val_x)

print ("")
print ("Classification Report: ")
print (classification_report(val_y, pred_y))

print ("")
print ("Accuracy Score: ", accuracy_score(val_y, pred_y))
7. 适用于不同的数据集:泰坦尼克号
让我们将这种方法应用到另一个数据集。为此,我将使用流行的titanic数据集。
train = pd.read_csv("../input/titanic/train.csv")
test = pd.read_csv("../input/titanic/test.csv")
计算如下特征工程:
import re
full_data = [train, test]

train['Name_length'] = train['Name'].apply(len)
test['Name_length'] = test['Name'].apply(len)
train['Has_Cabin'] = train["Cabin"].apply(lambda x: 0 if type(x) == float else 1)
test['Has_Cabin'] = test["Cabin"].apply(lambda x: 0 if type(x) == float else 1)

for dataset in full_data:
    dataset['FamilySize'] = dataset['SibSp'] + dataset['Parch'] + 1

for dataset in full_data:
    dataset['IsAlone'] = 0
    dataset.loc[dataset['FamilySize'] == 1, 'IsAlone'] = 1

for dataset in full_data:
    dataset['Embarked'] = dataset['Embarked'].fillna('S')

for dataset in full_data:
    dataset['Fare'] = dataset['Fare'].fillna(train['Fare'].median())
train['CategoricalFare'] = pd.qcut(train['Fare'], 4)

for dataset in full_data:
    age_avg = dataset['Age'].mean()
    age_std = dataset['Age'].std()
    age_null_count = dataset['Age'].isnull().sum()
    age_null_random_list = np.random.randint(age_avg - age_std, age_avg + age_std, size=age_null_count)
    dataset['Age'][np.isnan(dataset['Age'])] = age_null_random_list
    dataset['Age'] = dataset['Age'].astype(int)
train['CategoricalAge'] = pd.cut(train['Age'], 5)

def get_title(name):
    title_search = re.search(' ([A-Za-z]+)\.', name)
    if title_search:
        return title_search.group(1)
    return ""

for dataset in full_data:
    dataset['Title'] = dataset['Name'].apply(get_title)
for dataset in full_data:
    dataset['Title'] = dataset['Title'].replace(['Lady', 'Countess','Capt', 'Col','Don', 'Dr', 'Major', 'Rev', 'Sir', 'Jonkheer', 'Dona'], 'Rare')
    dataset['Title'] = dataset['Title'].replace('Mlle', 'Miss')
    dataset['Title'] = dataset['Title'].replace('Ms', 'Miss')
    dataset['Title'] = dataset['Title'].replace('Mme', 'Mrs')

for dataset in full_data:
    dataset['Sex'] = dataset['Sex'].map( {'female': 0, 'male': 1} ).astype(int)
    title_mapping = {"Mr": 1, "Miss": 2, "Mrs": 3, "Master": 4, "Rare": 5}
    dataset['Title'] = dataset['Title'].map(title_mapping)
    dataset['Title'] = dataset['Title'].fillna(0)
    dataset['Embarked'] = dataset['Embarked'].map( {'S': 0, 'C': 1, 'Q': 2} ).astype(int)

    dataset.loc[ dataset['Fare'] <= 7.91, 'Fare']         = 0
    dataset.loc[(dataset['Fare'] > 7.91) & (dataset['Fare'] <= 14.454), 'Fare'] = 1
    dataset.loc[(dataset['Fare'] > 14.454) & (dataset['Fare'] <= 31), 'Fare']   = 2
    dataset.loc[ dataset['Fare'] > 31, 'Fare']         = 3
    dataset['Fare'] = dataset['Fare'].astype(int)

    dataset.loc[ dataset['Age'] <= 16, 'Age']        = 0
    dataset.loc[(dataset['Age'] > 16) & (dataset['Age'] <= 32), 'Age'] = 1
    dataset.loc[(dataset['Age'] > 32) & (dataset['Age'] <= 48), 'Age'] = 2
    dataset.loc[(dataset['Age'] > 48) & (dataset['Age'] <= 64), 'Age'] = 3
    dataset.loc[ dataset['Age'] > 64, 'Age'] = 4 ;

drop_elements = ['PassengerId', 'Name', 'Ticket', 'Cabin', 'SibSp']
train = train.drop(drop_elements, axis = 1)
train = train.drop(['CategoricalAge', 'CategoricalFare'], axis = 1)
test  = test.drop(drop_elements, axis = 1)
接下来,定义自动编码器模型:
X = train.drop(["Survived"], axis=1)
y = train["Survived"]
y = y.values

## define the model
input_layer = Input(shape=(X.shape[1],))
encoded = Dense(100, activation='tanh', activity_regularizer=regularizers.l1(10e-5))(input_layer)
encoded = Dense(50, activation='relu')(encoded)
decoded = Dense(50, activation='tanh')(encoded)
decoded = Dense(100, activation='tanh')(decoded)
output_layer = Dense(X.shape[1], activation='relu')(decoded)

autoencoder = Model(input_layer, output_layer)
autoencoder.compile(optimizer="adadelta", loss="mse")
训练一个模型:
scaler = preprocessing.MinMaxScaler()
scaler.fit(X.values)
X_scale = scaler.transform(X.values)
test_x_scale = scaler.transform(test.values)

x_perished, x_survived = X_scale[y == 0], X_scale[y == 1]
autoencoder.fit(x_perished, x_perished, epochs = 20, shuffle = True, validation_split = 0.25)
/opt/conda/lib/python3.6/site-packages/sklearn/utils/validation.py:595: DataConversionWa
/opt/conda/lib/python3.6/site-packages/sklearn/utils/validation.py:595: DataConversionWarning: Data with input dtype int64 was converted to float64 by MinMaxScaler.
  warnings.warn(msg, DataConversionWarning)
Train on 411 samples, validate on 138 samples
Epoch 1/20
411/411 [==============================] - 0s 1ms/step - loss: 0.2494 - val_loss: 0.2251
Epoch 2/20
411/411 [==============================] - 0s 84us/step - loss: 0.2083 - val_loss: 0.2093
Epoch 3/20
411/411 [==============================] - 0s 121us/step - loss: 0.1960 - val_loss: 0.1987
Epoch 4/20
411/411 [==============================] - 0s 119us/step - loss: 0.1873 - val_loss: 0.1918
Epoch 5/20
411/411 [==============================] - 0s 67us/step - loss: 0.1814 - val_loss: 0.1865
Epoch 6/20
411/411 [==============================] - 0s 113us/step - loss: 0.1619 - val_loss: 0.1253
Epoch 7/20
411/411 [==============================] - 0s 127us/step - loss: 0.1208 - val_loss: 0.1159
Epoch 8/20
411/411 [==============================] - 0s 129us/step - loss: 0.1140 - val_loss: 0.1122
Epoch 9/20
411/411 [==============================] - 0s 133us/step - loss: 0.1105 - val_loss: 0.1098
Epoch 10/20
411/411 [==============================] - 0s 64us/step - loss: 0.1082 - val_loss: 0.1075
Epoch 11/20
411/411 [==============================] - 0s 61us/step - loss: 0.0845 - val_loss: 0.0479
Epoch 12/20
411/411 [==============================] - 0s 63us/step - loss: 0.0461 - val_loss: 0.0410
Epoch 13/20
411/411 [==============================] - 0s 62us/step - loss: 0.0422 - val_loss: 0.0403
Epoch 14/20
411/411 [==============================] - 0s 64us/step - loss: 0.0412 - val_loss: 0.0390
Epoch 15/20
411/411 [==============================] - 0s 65us/step - loss: 0.0402 - val_loss: 0.0362
Epoch 16/20
411/411 [==============================] - 0s 62us/step - loss: 0.0393 - val_loss: 0.0350
Epoch 17/20
411/411 [==============================] - 0s 63us/step - loss: 0.0378 - val_loss: 0.0345
Epoch 18/20
411/411 [==============================] - 0s 64us/step - loss: 0.0364 - val_loss: 0.0344
Epoch 19/20
411/411 [==============================] - 0s 70us/step - loss: 0.0364 - val_loss: 0.0343
Epoch 20/20
411/411 [==============================] - 0s 63us/step - loss: 0.0321 - val_loss: 0.0268
<keras.callbacks.History at 0x7f453427d940>
获取潜在表示
hidden_representation = Sequential()
hidden_representation.add(autoencoder.layers[0])
hidden_representation.add(autoencoder.layers[1])
hidden_representation.add(autoencoder.layers[2])
perished_hid_rep = hidden_representation.predict(x_perished)
survived_hid_rep = hidden_representation.predict(x_survived)

rep_x = np.append(perished_hid_rep, survived_hid_rep, axis = 0)
y_n = np.zeros(perished_hid_rep.shape[0])
y_f = np.ones(survived_hid_rep.shape[0])
rep_y = np.append(y_n, y_f)
训练分类器
train_x, val_x, train_y, val_y = train_test_split(rep_x, rep_y, test_size=0.25)
clf = LogisticRegression().fit(train_x, train_y)
pred_y = clf.predict(val_x)

print (classification_report(val_y, pred_y))
print (accuracy_score(val_y, pred_y))
temp = pd.DataFrame(pd.read_csv("../input/titanic/test.csv")['PassengerId'])
test_rep_x = hidden_representation.predict(test_x_scale)
temp['Survived'] = [int(x) for x in clf.predict(test_rep_x)]
temp.to_csv("submission.csv", index = False)
temp.head()
推荐阅读
左图加入微信群、右图加入QQ群

ChallengeHub出品
原文作者:ChallengeHub;如有侵权,请联系管理员删除。

