图神经网络07-基于Graph的推荐引擎构建
我们这个教程的主要目的是基于Graph 节点的Adamic Adar指标来推荐相似电影。如果Adamic Adar指标越高,就代表两个节点越相近。
Adamic/Adar (Frequency-Weighted Common Neighbors)
Adamic-Adar 简称AA,该指标根据共同邻居的节点的度给每个节点赋予一个权重值,即为每个节点的度的对数分之一。然后把节点对的所有共同邻居的权重值相加,其和作为该节点对的相似度值。
这个方法同样是对Common Neighbors的改进,当我们计算两个相同邻居的数量的时候,其实每个邻居的“重要程度”都是不一样的,我们认为这个邻居的邻居数量越少,就越凸显它作为“中间人”的重要性,毕竟一共只认识那么少人,却恰好是x,y的好朋友。
例如:
x,y是两个节点(在这个例子中就是两个电影) N(one_node)是返回某个节点的相邻节点集合大小的函数,比如x有相邻节点a,b,c那么这个函数就返回3
这个公式的含义就是,比如对于节点x和y,遍历x和y的每一个共同节点u,然后将他们所有的 1/log(N(u))相加
的大小决定了节点u的重要性:
如果x和y共享节点u,并且节点u有大量的邻居节点,说明这个节点u越不重要或者越不相关:N(u)值越大,1/log((u))就越小 如果x和y共享节点u,并且节点u只有很少的的邻居节点,说明这个节点u越重要或者越相关:N(u)值越小,1/log((u))就越大
这个可以理解我向我们生活中,如果同学A和同学B是通过同学C认识的,而同学C的社交关系很简单或者周围人很少,说明C是能够将A和B强关联的人物
方法1 将文本的TF-IDF权重作为Kmeans进行无监督聚类
如果两个电影同属于分组,那么这两个电影共享一个节点。如果这个分组内的电影数量越少,该聚类分组对于这两个电影越重要,但是这个结论有可能在”聚类标签之前的样本非常不均衡“的时候失效。
方法2 构建电影的TF-IDF向量表示矩阵
通过获取每一个电影的tfidf向量表示,然后基于余弦相似度获取相似性最高的top5个其他电影,然后创建一个相似节点簇,然后通过Adamin Adar评估该簇
# 导入包
import networkx as nx # 构建Graph
import matplotlib.pyplot as plt
import pandas as pd
import numpy as np
import math as math
import time
plt.style.use('seaborn')
plt.rcParams['figure.figsize'] = [14,14]
加载数据集
# 加载数据
df = pd.read_csv('/home/kesci/input/netflix8714/netflix_titles.csv')
# 转换时间格式:将August 14, 2020字符串转为2020-08-14
df["date_added"] = pd.to_datetime(df['date_added'])
df['year'] = df['date_added'].dt.year # 获取年份
df['month'] = df['date_added'].dt.month # 获取月份
df['day'] = df['date_added'].dt.day # 获取天
df.head()
| show_id | type | title | director | cast | country | date_added | release_year | rating | duration | listed_in | description | year | month | day | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | s1 | TV Show | 3% | NaN | João Miguel, Bianca Comparato, Michel Gomes, R... | Brazil | 2020-08-14 | 2020 | TV-MA | 4 Seasons | International TV Shows, TV Dramas, TV Sci-Fi &... | In a future where the elite inhabit an island ... | 2020.0 | 8.0 | 14.0 |
| 1 | s2 | Movie | 7:19 | Jorge Michel Grau | Demián Bichir, Héctor Bonilla, Oscar Serrano, ... | Mexico | 2016-12-23 | 2016 | TV-MA | 93 min | Dramas, International Movies | After a devastating earthquake hits Mexico Cit... | 2016.0 | 12.0 | 23.0 |
| 2 | s3 | Movie | 23:59 | Gilbert Chan | Tedd Chan, Stella Chung, Henley Hii, Lawrence ... | Singapore | 2018-12-20 | 2011 | R | 78 min | Horror Movies, International Movies | When an army recruit is found dead, his fellow... | 2018.0 | 12.0 | 20.0 |
| 3 | s4 | Movie | 9 | Shane Acker | Elijah Wood, John C. Reilly, Jennifer Connelly... | United States | 2017-11-16 | 2009 | PG-13 | 80 min | Action & Adventure, Independent Movies, Sci-Fi... | In a postapocalyptic world, rag-doll robots hi... | 2017.0 | 11.0 | 16.0 |
| 4 | s5 | Movie | 21 | Robert Luketic | Jim Sturgess, Kevin Spacey, Kate Bosworth, Aar... | United States | 2020-01-01 | 2008 | PG-13 | 123 min | Dramas | A brilliant group of students become card-coun... | 2020.0 | 1.0 | 1.0 |
通过上表输出我们可以已经获取了每个作品的year,month,day
# 导演列表director,标签列表listed_in,演员列表cast和国家country这些列包含一组值,我们可以按照逗号,进行分割,后去列表值
# 如果还有NAN值,我们就返回一个空列表[]
df['directors'] = df['director'].apply(lambda l: [] if pd.isna(l) else [i.strip() for i in l.split(",")])
df['categories'] = df['listed_in'].apply(lambda l: [] if pd.isna(l) else [i.strip() for i in l.split(",")])
df['actors'] = df['cast'].apply(lambda l: [] if pd.isna(l) else [i.strip() for i in l.split(",")])
df['countries'] = df['country'].apply(lambda l: [] if pd.isna(l) else [i.strip() for i in l.split(",")])

df.head(3)
| show_id | type | title | director | cast | country | date_added | release_year | rating | duration | listed_in | description | year | month | day | directors | categories | actors | countries | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | s1 | TV Show | 3% | NaN | João Miguel, Bianca Comparato, Michel Gomes, R... | Brazil | 2020-08-14 | 2020 | TV-MA | 4 Seasons | International TV Shows, TV Dramas, TV Sci-Fi &... | In a future where the elite inhabit an island ... | 2020.0 | 8.0 | 14.0 | [] | [International TV Shows, TV Dramas, TV Sci-Fi ... | [João Miguel, Bianca Comparato, Michel Gomes, ... | [Brazil] |
| 1 | s2 | Movie | 7:19 | Jorge Michel Grau | Demián Bichir, Héctor Bonilla, Oscar Serrano, ... | Mexico | 2016-12-23 | 2016 | TV-MA | 93 min | Dramas, International Movies | After a devastating earthquake hits Mexico Cit... | 2016.0 | 12.0 | 23.0 | [Jorge Michel Grau] | [Dramas, International Movies] | [Demián Bichir, Héctor Bonilla, Oscar Serrano,... | [Mexico] |
| 2 | s3 | Movie | 23:59 | Gilbert Chan | Tedd Chan, Stella Chung, Henley Hii, Lawrence ... | Singapore | 2018-12-20 | 2011 | R | 78 min | Horror Movies, International Movies | When an army recruit is found dead, his fellow... | 2018.0 | 12.0 | 20.0 | [Gilbert Chan] | [Horror Movies, International Movies] | [Tedd Chan, Stella Chung, Henley Hii, Lawrence... | [Singapore] |
我们可以看到listed_in中International TV Shows, TV Dramas, TV Sci-Fi转为[International TV Shows, TV Dramas, TV Sci-Fi ],其他几列也是
print(df.shape)
(7787, 19)from sklearn.feature_extraction.text import TfidfVectorizer # 构建TFIDF向量
from sklearn.metrics.pairwise import linear_kernel
from sklearn.cluster import MiniBatchKMeans # Kmeans算法
# 构建作品文本描述tfidf矩阵
start_time = time.time()
text_content = df['description']
vector = TfidfVectorizer(max_df=0.4, # 去除文本频率大约0.4的词
min_df=1, # 词语最小出现次数
stop_words='english', # 去除停用词
lowercase=True, # 将大写字母转为小写
use_idf=True, # 使用idf
norm=u'l2', # 正则化
smooth_idf=True # 平滑因子,避免idf为0
)
tfidf = vector.fit_transform(text_content)
# Kmeans聚类
k = 200# 聚类中心个数
kmeans = MiniBatchKMeans(n_clusters = k)
kmeans.fit(tfidf)
centers = kmeans.cluster_centers_.argsort()[:,::-1]
terms = vector.get_feature_names()
request_transform = vector.transform(df['description'])
# 聚类标签
df['cluster'] = kmeans.predict(request_transform)
df['cluster'].value_counts().head()
19     7179
39      333
182       6
1         5
144       5
Name: cluster, dtype: int64
我们可以看到聚类标签很不均衡,19有7179,39 有333个,所以我们不能基于聚类标签cluster来做节点创建了。
# 输入目标电影描述,查找最相似的topn个电影
def find_similar(tfidf_matrix, index, top_n = 5):
    cosine_similarities = linear_kernel(tfidf_matrix[index:index+1], tfidf_matrix).flatten()
    related_docs_indices = [i for i in cosine_similarities.argsort()[::-1] if i != index]
    return [index for index in related_docs_indices][0:top_n]

节点定义
节点包括如下 :
Movies:电影 Person ( actor or director) :人物 Categorie:勒边 Countries:国家 Cluster (description):描述 Sim(title) top 5 similar movies in the sense of the description:相似电影电影
边定义
关系包括如下 :
ACTED_IN:演员和电影之间的关系 CAT_IN:类别和电影之间的关系 DIRECTED:导演与电影之间的关系 COU_IN:国家与电影之间的关系 DESCRIPTION:聚类标签和电影之间的关系 SIMILARITY:在描述意义上相似的关系
两部电影不是直接相连的,而是它们共享人物,类别,团伙和国家,所以可以构建联系
G = nx.Graph(label="MOVIE")
start_time = time.time()
for i, rowi in df.iterrows():
    if (i%1000==0):
        print(" iter {} -- {} seconds --".format(i,time.time() - start_time))
    G.add_node(rowi['title'],key=rowi['show_id'],label="MOVIE",mtype=rowi['type'],rating=rowi['rating'])
#    G.add_node(rowi['cluster'],label="CLUSTER")
#    G.add_edge(rowi['title'], rowi['cluster'], label="DESCRIPTION")
    for element in rowi['actors']:
        # 创建“演员”节点”,类型为PERSON
        G.add_node(element,label="PERSON")
        # 创建作品与演员的关系:ACTED_IN
        G.add_edge(rowi['title'], element, label="ACTED_IN")
    for element in rowi['categories']:
        # 创建“类别标签”节点“,类型为CAT
        G.add_node(element,label="CAT")
        # 创建作品与类别标签的关系:CAT_IN
        G.add_edge(rowi['title'], element, label="CAT_IN")
    for element in rowi['directors']:
        # 创建“导演”节点,类别为PERSON
        G.add_node(element,label="PERSON")
        # 创建作品与导演的关系:DIRECTED
        G.add_edge(rowi['title'], element, label="DIRECTED")
    for element in rowi['countries']:
        # 创建“国家”节点,类别为COU
        G.add_node(element,label="COU")
        # 创建作品与国家的关系:COU_IN
        G.add_edge(rowi['title'], element, label="COU_IN")
    # 创建相似作品节点
    indices = find_similar(tfidf, i, top_n = 5) # 取相似性最高的top5
    snode="Sim("+rowi['title'][:15].strip()+")"
    G.add_node(snode,label="SIMILAR")
    G.add_edge(rowi['title'], snode, label="SIMILARITY")
    for element in indices:
        G.add_edge(snode, df['title'].loc[element], label="SIMILARITY")


print(" finish -- {} seconds --".format(time.time() - start_time))
 iter 0 -- 0.02708911895751953 seconds --
 iter 1000 -- 4.080239295959473 seconds --
 iter 2000 -- 8.126200675964355 seconds --
 iter 3000 -- 12.209706783294678 seconds --
 iter 4000 -- 16.362282037734985 seconds --
 iter 5000 -- 20.392311811447144 seconds --
 iter 6000 -- 24.43456506729126 seconds --
 iter 7000 -- 28.474121809005737 seconds --
 finish -- 31.648479461669922 seconds --
设置不同类型节点的颜色
def get_all_adj_nodes(list_in):
    sub_graph=set()
    for m in list_in:
        sub_graph.add(m)
        for e in G.neighbors(m):
                sub_graph.add(e)
    return list(sub_graph)
def draw_sub_graph(sub_graph):
    subgraph = G.subgraph(sub_graph)
    colors=[]
    for e in subgraph.nodes():
        if G.nodes[e]['label']=="MOVIE":
            colors.append('blue')
        elif G.nodes[e]['label']=="PERSON":
            colors.append('red')
        elif G.nodes[e]['label']=="CAT":
            colors.append('green')
        elif G.nodes[e]['label']=="COU":
            colors.append('yellow')
        elif G.nodes[e]['label']=="SIMILAR":
            colors.append('orange')
        elif G.nodes[e]['label']=="CLUSTER":
            colors.append('orange')

    nx.draw(subgraph, with_labels=True, font_weight='bold',node_color=colors)
    plt.show()
list_in=["Ocean's Twelve","Ocean's Thirteen"]
sub_graph = get_all_adj_nodes(list_in)
draw_sub_graph(sub_graph)


探索目标电影的所在地→这是演员,导演,国家/地区和类别的列表 探索每个邻居的邻居→发现与目标字段共享节点的电影 计算 Adamic Adar度量→最终结果
def get_recommendation(root):
    commons_dict = {}
    for e in G.neighbors(root):
        for e2 in G.neighbors(e):
            if e2==root:
                continue
            if G.nodes[e2]['label']=="MOVIE":
                commons = commons_dict.get(e2)
                if commons==None:
                    commons_dict.update({e2 : [e]})
                else:
                    commons.append(e)
                    commons_dict.update({e2 : commons})
    movies=[]
    weight=[]
    for key, values in commons_dict.items():
        w=0.0
        for e in values:
            w=w+1/math.log(G.degree(e))
        movies.append(key)
        weight.append(w)

    result = pd.Series(data=np.array(weight),index=movies)
    result.sort_values(inplace=True,ascending=False)
    return result;
推荐结果测试
result = get_recommendation("Ocean's Twelve")
result2 = get_recommendation("Ocean's Thirteen")
result3 = get_recommendation("The Devil Inside")
result4 = get_recommendation("Stranger Things")
print("*"*40+"\n Recommendation for 'Ocean's Twelve'\n"+"*"*40)
print(result.head())
print("*"*40+"\n Recommendation for 'Ocean's Thirteen'\n"+"*"*40)
print(result2.head())
print("*"*40+"\n Recommendation for 'Belmonte'\n"+"*"*40)
print(result3.head())
print("*"*40+"\n Recommendation for 'Stranger Things'\n"+"*"*40)
print(result4.head())
****************************************
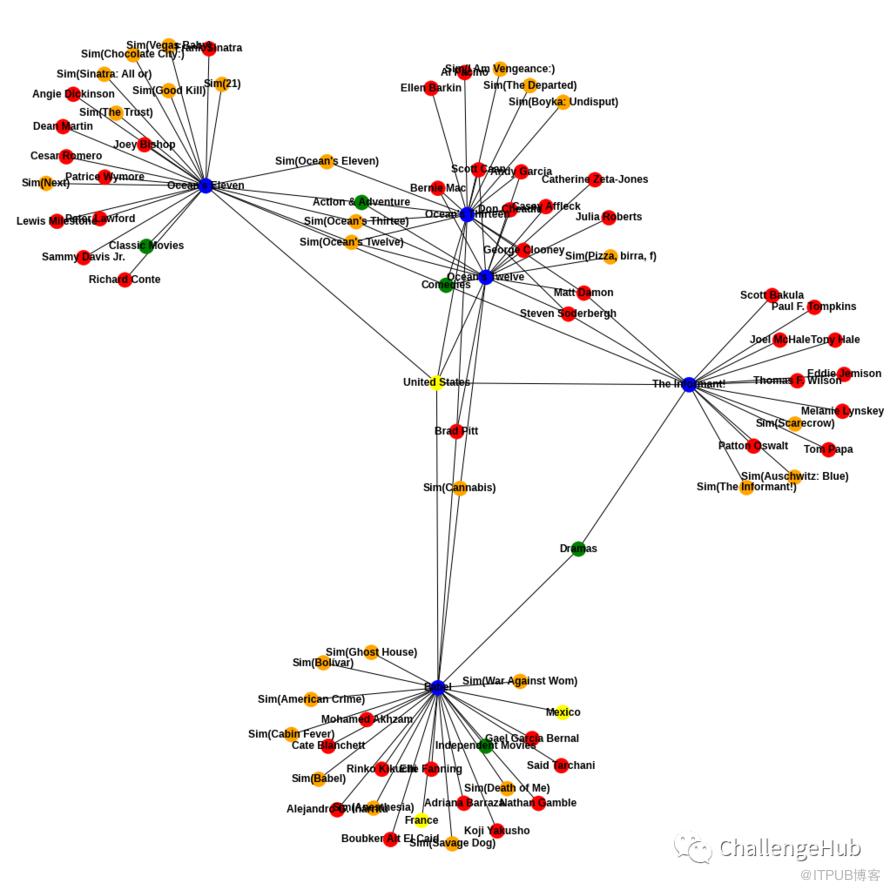
 Recommendation for 'Ocean's Twelve'
****************************************
Ocean's Thirteen    7.033613
Ocean's Eleven      1.528732
The Informant!      1.252955
Babel               1.162454
Cannabis            1.116221
dtype: float64
****************************************
 Recommendation for 'Ocean's Thirteen'
****************************************
Ocean's Twelve       7.033613
The Departed         2.232071
Ocean's Eleven       2.086843
Brooklyn's Finest    1.467979
Boyka: Undisputed    1.391627
dtype: float64
****************************************
 Recommendation for 'Belmonte'
****************************************
The Boy                                  1.901648
The Devil and Father Amorth              1.413791
Making a Murderer                        1.239666
Belief: The Possession of Janet Moses    1.116221
I Am Vengeance                           1.116221
dtype: float64
****************************************
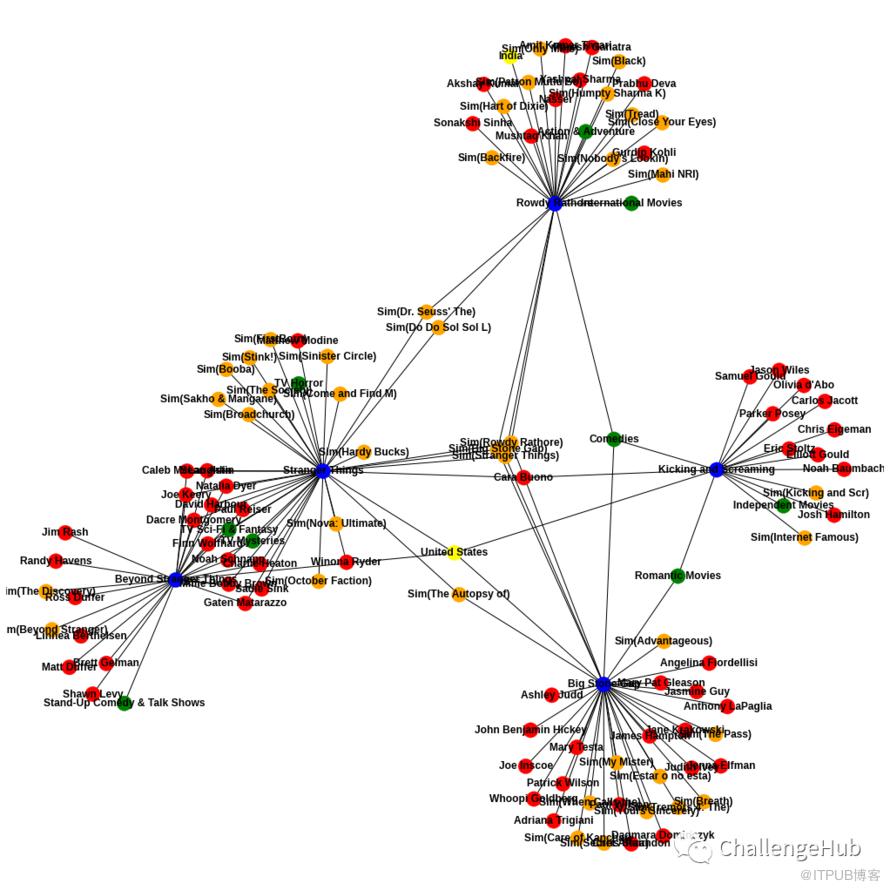
 Recommendation for 'Stranger Things'
****************************************
Beyond Stranger Things    12.047956
Rowdy Rathore              2.585399
Big Stone Gap              2.355888
Kicking and Screaming      1.566140
Prank Encounters           1.269862
dtype: float64
reco=list(result.index[:4].values)
reco.extend(["Ocean's Twelve"])
sub_graph = get_all_adj_nodes(reco)
draw_sub_graph(sub_graph)
reco=list(result4.index[:4].values)
reco.extend(["Stranger Things"])
sub_graph = get_all_adj_nodes(reco)
draw_sub_graph(sub_graph)
关注我的专栏 👉 数据挖掘与可视化教程方便第一时间获取更新的项目
🥘【B站美食视频图鉴】干饭人干饭魂干饭都是人上人 ✔︎ 🚴♀️【【多伦多单车数据】车骑好,车停好,车锁好,车才好 ✔︎ 📶【中国移动手机用户统计】-为发烧而生 TODO ⛹【你是真的蔡】真真假假,假假真真,真亦假时假亦真! TODO 🌍【全球COVID-19】新冠疫苗接种数据分析 ✔︎ 🅱️【B站热点追溯】二次元世界的星辰大海 ✔︎ 🏬一饼吃透破产名单:哪些知名公司终究没能撑过疫情 ✔︎ 🐶【单身人士友好的“理想国”】透过探探的在线社交洞察 ✔︎ 👱♀️【七仙女系列】Pandas教程 ✔︎ 📱【移动5G套餐潜客识别】7步让你成为机器学习达人 ✔︎ 🧠【大脑还健康吗】脑中风疾病预测模型✔︎ 🎬【猜猜你喜欢看什么】从零构建一个电影推荐系统 推荐系统机器学习✔︎
大家加左图进入微信群;右图有QQ学习交流群

阅读原文,可直接运行并查看代码效果
原文作者:ChallengeHub;如有侵权,请联系管理员删除。

