中国移动“梧桐杯”金融赛道TOP1开源
梧桐杯的比赛复赛已经结束,已经得奖的肯定满心欢舞,没有得奖的选手也不需要灰心,下次再来过。为了给大家提升竞赛能力,我们ChallengeHub在梧桐杯的每个赛道都给大家准备了初赛的Top方案(金融赛道B榜Top1,城市赛道B榜Top2,生活赛道A榜Top4,B榜由于队伍原因未提交B榜),内容丰富,诚意满满,希望大家多多支持,你们的支持是我们最大的动力。
金融赛道的代码贡献者是小泽,竞赛届的新秀(dalao),首先恭喜他在初赛获得了第一,复赛获得了第二的好成绩了,废话不多说,来看他的分享吧(下文中代码以及都是作者所述,无一修改)。
比赛链接:https://js.dclab.run/v2/cmptDetail.html?id=463
初赛要求选手依照主办方已给数据找出“羊毛党”,具体包含:利用用户通信、流量、app使用等行为数据。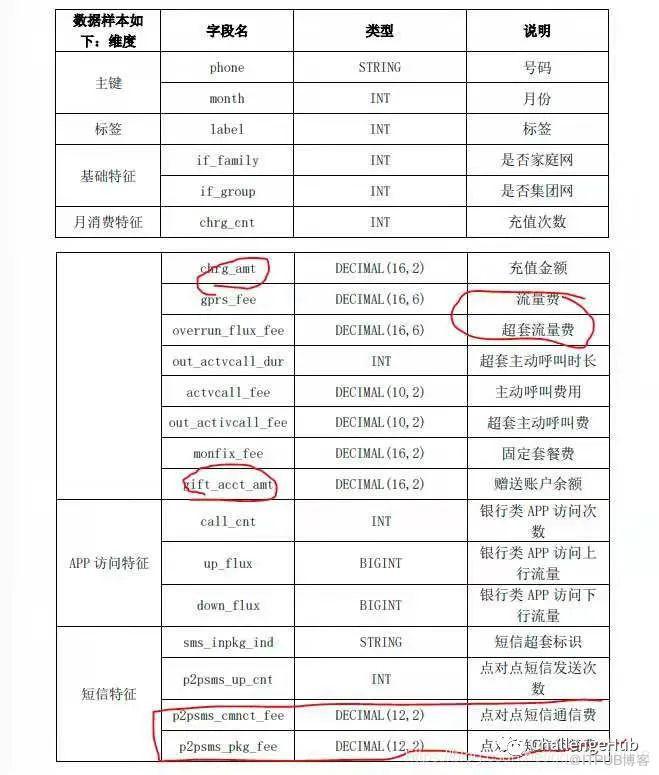
由于之前主要是在生活赛道,来金融的时候大家已经发现数据中奇数月和偶数月分布差异很大,并且采用1、3月份建模效果最好。所以我这一块主要还是怼的业务特征。
数据处理
首先是对数据做了一些转型以及填充编码处理
data.replace('\\N', np.NaN, inplace=True)
#所有从网络侧到用户侧的数据流,都属于下行流量;从用户侧到网络侧是数据流,则属于上行流量,一般用户来说下行流量远大于上行流量
f_features = ['gprs_fee', 'overrun_flux_fee', 'out_actvcall_dur', 'actvcall_fee',
       'out_activcall_fee', 'monfix_fee', 'gift_acct_amt', 'call_cnt',
       'up_flux', 'down_flux', 'p2psms_up_cnt',
       'p2psms_cmnct_fee', 'p2psms_pkg_fee']
data[f_features] = data[f_features].astype('float')

cat_cols = ['if_group','if_family','sms_inpkg_ind']
def encode_df(data):
    for col in cat_cols:
        print(col)
        encode = LabelEncoder()
        data[col] = data[col].fillna('unkown')
        encode.fit(data[col])
        data[col] = encode.transform(data[col])
    return data

data=encode_df(data)
特征工程
然后是一些根据业务背景做的一些简单的业务特征
data['total_flow']=data['up_flux']+data['down_flux']
data['average_flow']=data['total_flow']/data['call_cnt']
data['aver_up_fee'] = data['up_flux']/data['call_cnt']
data['aver_down_fee'] = data['down_flux']/data['call_cnt']
data['total_liuliang_fee']=data['gprs_fee']+data['overrun_flux_fee']
data['total_yu_e'] = data['chrg_amt'] + data['gift_acct_amt']
data['p2p_feeall'] = data['p2psms_cmnct_fee'] + data['p2psms_pkg_fee']

data['use_money'] = data['total_yu_e'] - data['monfix_fee']
data['aver_chrg'] = data['chrg_amt'] / data['chrg_cnt']

data['total_cnt'] = data['call_cnt'] + data['chrg_cnt'] + data['p2psms_up_cnt']
data.drop(['actvcall_fee','out_activcall_fee','overrun_flux_fee','gprs_fee'],axis=1,inplace=True)
接下来是分组特征,分组特征往往表现出比较极端的效果,对模型的影响还是较大,后面需要细致的调试。
data_usr=data.sort_values(by=['phone','month']).reset_index()
data_usr.fillna(data_usr.median(),inplace=True)

def get_features1(data):
    data_count=pd.DataFrame()
    data_count['phone']=data['phone'].unique()
    for f in tqdm(['chrg_amt','total_liuliang_fee','total_yu_e','p2p_feeall','total_flow',
                  'p2psms_up_cnt']):
        df_temp = data.groupby('phone')[f].agg(**{
            'df_{}_mean'.format(f): 'mean',
            'df_{}_std'.format(f): 'std',
            'df_{}_max'.format(f): 'max',
            'df_{}_min'.format(f): 'min',
            'df_{}_sum'.format(f): 'sum',
        }).reset_index()
        data_count=pd.merge(data_count,df_temp,on='phone',how='left')

    for f in tqdm(['monfix_fee']):
        df_temp = data.groupby('phone')[f].agg(**{
            'df_{}_sum'.format(f): 'sum',
        }).reset_index()
        data_count=pd.merge(data_count,df_temp,on='phone',how='left')

    return data_count

data_usr=get_features1(data_usr)
对数据做EDA分析可以发现部分行为特征做01分箱往往可以表现出比较好的效果
def f(x):
    if x>0:
        return 1
    else:
        return 0
data['if_flux_na']=0
data.loc[(data['up_flux'].isnull())&(data['down_flux'].isnull()),['if_flux_na']] = 1
data.loc[data['down_flux']!=np.nan,['if_flux_na']] = 0
data.loc[data['up_flux']!=np.nan,['if_flux_na']] = 0

data['if_czcs']=data['chrg_cnt'].apply(f)
data['if_call']=data['call_cnt'].apply(f)
data['if_p2psms']=data['p2psms_up_cnt'].apply(f)
data['if_czje']=data['chrg_amt'].apply(f)
接下来的特征主要是考虑两个特征之间的相关性,比如上、下行流量的一些衍生关系。B榜还是挺有用的,A榜的上下行流量数据特征基本没啥用,所以这里只是提一下这方面的思路,具体还是要看大家自己线下对比效果。
def get_features2(df):
    features = [['gift_acct_amt','monfix_fee'],['up_flux','down_flux']]
    for fea in features:
        df[f'{fea[0]}_{fea[1]}_std'] = df[fea].std(1)
        df[f'{fea[0]}_{fea[1]}_max'] = df[fea].max(1)
        df[f'{fea[0]}_{fea[1]}_min'] = df[fea].min(1)

        df[f'{fea[0]}_{fea[1]}_sub'] = df[fea[0]] - df[fea[1]]
    return df

X_train = get_features2(X_train)
X_test = get_features2(X_test)
模型训练
模型依旧采用的是五折的lgb,由于时间问题并没有尝试五折的catboost,这题的类别特征不是很多,具体的效果没有进行对比
KF = StratifiedKFold(n_splits=5, random_state=2021, shuffle=True)
params = {
          'objective':'binary',
          'metric':'binary_error',
          'learning_rate':0.04,
          'num_iterations': 10000,
          'silent':True
}

oof_lgb = np.zeros(len(X_train))
predictions_lgb = np.zeros((len(X_test)))

# 五折交叉验证
for fold_, (trn_idx, val_idx) in enumerate(KF.split(X_train.values, y.values)):
    print("fold n°{}".format(fold_))
    print('trn_idx:',trn_idx)
    print('val_idx:',val_idx)
    trn_data = lgb.Dataset(X_train.iloc[trn_idx][features],label=y.iloc[trn_idx])
    val_data = lgb.Dataset(X_train.iloc[val_idx][features],label=y.iloc[val_idx])
    num_round = 10000
    clf = lgb.train(
        params,
        trn_data,
        num_round,
        valid_sets = [trn_data, val_data],
        verbose_eval=500,
        early_stopping_rounds=200,
        categorical_feature=cat_cols,
    )
    oof_lgb[val_idx] = clf.predict(X_train.iloc[val_idx][features], num_iteration=clf.best_iteration)
    predictions_lgb[:] += (clf.predict(X_test[features], num_iteration=clf.best_iteration))/5
print("AUC score: {}".format(roc_auc_score(y, oof_lgb)))
print("F1 score: {}".format(f1_score(y, [1 if i >= 0.5 else 0 for i in oof_lgb])))
print("Precision score: {}".format(precision_score(y, [1 if i >= 0.5 else 0 for i in oof_lgb])))
print("Recall score: {}".format(recall_score(y, [1 if i >= 0.5 else 0 for i in oof_lgb])))
写在最后
到这里基本就结束了,是不是觉得很不可思议?百余行代码就可以获得较好的成绩,也没有用比较花里胡哨的模型,所以根据数据去实现好的业务特征往往就是会带来意想不到的效果,由于做金融赛道的时候只剩下一周时间还有部分想法没有实现,这里也一并分享给大家(仅供参考):1.对类别特征做交叉 2.对数值特征(比如余额)做更为细致的分箱 3.研究业务背景,根据已有的特征去实现更强的业务特征 4.尝试更换其他模型,比如catboost
再次感谢小泽的分享,最后贴上小泽的CSDN链接:https://blog.csdn.net/qq_43240913/article/details/116329467
小泽是一个大三的学生,热爱技术,喜欢数据挖掘,大家喜欢的话可以关注他一下,多多交流(有问题就找他)。
关于梧桐杯金融赛道Top1的分享到此就结束了,当然城市生活赛道的分享也会尽快带给大家的。
另外,想了解更多算法,数据分析,数据挖掘等方面的知识,欢迎关注ChallengeHub公众号,添加微信进入微信交流群,或者进入QQ交流群。关注公众号或者进群可以直接获得上面的代码,而且也有很多机器学习的资料可以获取。
ChallengeHub出品
写在最后,最近梧桐杯有一个复活赛,希望大家可以投票支持下我们复活,下面是投票二维码(直接扫码进入投票页面,直接投票,无需注册,每个人可以投三票,可以投给同一个人),大家投票给8号队伍,希望大家可以稍微支持一下。
推荐阅读:
原文作者:ChallengeHub;如有侵权,请联系管理员删除。

