基于PySpark的K-means模型搭建,简单的demo带大家入门
如今,聚类被用于从客户细分到异常检测等各种用途。企业广泛地使用驱动聚类的机器学习来实现客户分析以及细分,以便围绕这些结果指定市场策略。聚类驱动着大量搜索引擎的结果,这是通过在聚类中找出类似对象并且让并不类似的对象彼此原理来实现的。可以根据数据类型和业务需求以多种方式完成聚类。最常用的就是K-means以及层次聚类。在本练习中,使用传统的鸢尾花数据集,利用PySpark的ml库实现K-means聚类。
首先导入必要的包,以及使用Spark创建一个新的SparkSession对象,利用spark.read.csv读取csv数据,此处并不会把csv读到内存里面,源于spark的惰性机制(RDD采用了惰性(lazy)执行机制,即在RDD的转换操作只是记录了执行逻辑,并不会发生真正的计算,真正的计算发生在对RDD调用了Action类算子)。
import pyspark
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from pyspark.sql.functions import *
from pyspark.sql.types import *
from pyspark.sql.functions import rand, randn
from pyspark.ml.clustering import KMeans
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName('k_means').getOrCreate()
我们将创建单个向量,通过使用Spark的VectorAssembler将所有的输入特征合并到该向量,实质上会以列表的形式将四个列转换成具有四个输入值的单一列。
from pyspark.ml.linalg import Vectors
from pyspark.ml.feature import VectorAssembler
input_cols=['sepal_length', 'sepal_width', 'petal_length', 'petal_width']
vec_assembler = VectorAssembler(inputCols = input_cols, outputCol='features')
final_data = vec_assembler.transform(df)
最终的数据包含了输入向量,它可被用于运行K-means。由于需要在使用K-means之前需要预先声明K的值,因此我们可以使用肘部法确定合适的K值。
手肘法核心思想
随着聚类数k的增大,样本划分会更加精细,每个簇的聚合程度会逐渐提高,那么误差平方和SSE自然会逐渐变小。
当k小于真实聚类数时,由于k的增大会大幅增加每个簇的聚合程度,故SSE的下降幅度会很大,而当k到达真实聚类数时,再增加k所得到的聚合程度回报会迅速变小,所以SSE的下降幅度会骤减,然后随着k值的继续增大而趋于平缓,也就是说SSE和k的关系图是一个手肘的形状,而这个肘部对应的k值就是数据的真实聚类数。
为了使用肘部法则,需要用不同的K值运行K-means。首先,要从PySpark中引入Kmeans,并且创建一个空列表,为每个K值的计算SSE,从而通过手肘图确定最优的K值。
errors=[]

for k in range(2,10):
    kmeans = KMeans(featuresCol='features',k=k)
    model = kmeans.fit(final_data)
    intra_distance = model.computeCost(final_data)
    errors.append(intra_distance)
    print("With K={}".format(k))
    print("Within Set Sum of Squared Errors = " + str(wssse))
    print('--'*30)

With K=2
Within Set Sum of Squared Errors = 31.377209665335272
------------------------------------------------------------
With K=3
Within Set Sum of Squared Errors = 31.377209665335272
------------------------------------------------------------
With K=4
Within Set Sum of Squared Errors = 31.377209665335272
------------------------------------------------------------
With K=5
Within Set Sum of Squared Errors = 31.377209665335272
------------------------------------------------------------
With K=6
Within Set Sum of Squared Errors = 31.377209665335272
------------------------------------------------------------
With K=7
Within Set Sum of Squared Errors = 31.377209665335272
------------------------------------------------------------
With K=8
Within Set Sum of Squared Errors = 31.377209665335272
------------------------------------------------------------
With K=9
Within Set Sum of Squared Errors = 31.377209665335272
------------------------------------------------------------
cluster_number = range(2,10)
plt.scatter(cluster_number,errors)
plt.xlabel('Number of Clusters (K)')
plt.ylabel('SSE')
plt.show()
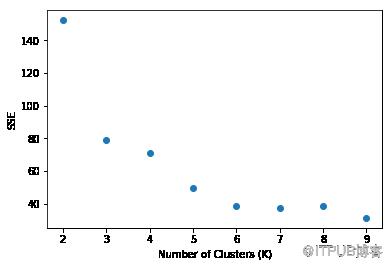
在这个示例中,K=3是最合适的聚类数量,因为我们可以看到3,4这两个值存在一种肘部形状。
我们使用K=3来构建最终的聚类。
kmeans = KMeans(featuresCol='features',k=3,)
model = kmeans.fit(final_data)
model.transform(final_data).groupBy('prediction').count().show()
predictions=model.transform(final_data)
predictions.groupBy('species','prediction').count().show()

+----------+----------+-----+
|   species|prediction|count|
+----------+----------+-----+
| virginica|         2|   14|
|    setosa|         0|   50|
| virginica|         1|   36|
|versicolor|         1|    3|
|versicolor|         2|   47|
+----------+----------+-----+
最后使用matplotlib库来可视化新的聚类。对此我们需要将Spark DataFrame转换成Pandas DataFrame。
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D
pandas_df = predictions.toPandas()
cluster_vis = plt.figure(figsize=(15,10)).gca(projection='3d')
cluster_vis.scatter(pandas_df.sepal_length, pandas_df.sepal_width, pandas_df.petal_length, c=pandas_df.prediction,depthshade=False)
plt.show()

本文主要使用PySpark来构建K-means模型,在大数据背景下,pyspark的使用要比python更加频繁,之后会给大家带来更多的pyspark的机器学习构建教学,感兴趣的小伙伴点赞收藏,关注公众号获取第一手资源哦!!!


原文作者:ChallengeHub;如有侵权,请联系管理员删除。

