基于PySpark的序列向量化
在前面的文章中,我们介绍了如何使用PySpark进行文本分类任务,在NLP的任务中,如何将文本表示为模型可以输入的向量化数据是非常重要的,其中序列嵌入便是一种常用的向量化方法。那么在本文中,将介绍如何使用PySpark计算序列嵌入。
首先导入必要的包,以及使用Spark创建一个新的SparkSession对象,利用spark.read.csv读取csv数据,此处并不会把csv读到内存里面,源于spark的惰性机制(RDD采用了惰性(lazy)执行机制,即在RDD的转换操作只是记录了执行逻辑,并不会发生真正的计算,真正的计算发生在对RDD调用了Action类算子)。
from pyspark.ml.feature import StringIndexer
from pyspark.sql.window import Window

# scikit-learn
from sklearn.decomposition import PCA
from sklearn.preprocessing import StandardScaler, MinMaxScaler
from sklearn.model_selection import train_test_split, GridSearchCV
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
from sklearn.tree import DecisionTreeClassifier
from sklearn.dummy import DummyClassifier
from statsmodels.api import Logit
from sklearn.decomposition import PCA
from sklearn import metrics
from sklearn.metrics import classification_report
from sklearn.model_selection import train_test_split
from sklearn.manifold import TSNE
import matplotlib.pyplot as plt
%matplotlib inline

# others
import pandas as pd
import numpy as np
import sys
import itertools
import re
from random import sample
import time
# gensim包
from gensim.models.doc2vec import LabeledSentence
from gensim.models import Doc2Vec
from gensim.models import Word2Vec

spark=SparkSession.builder.appName('seq_embedding').getOrCreate()
df = spark.read.csv('embedding_dataset.csv',header=True,inferSchema=True)

df.printSchema()
root
 |-- user_id: string (nullable = true)
 |-- page: string (nullable = true)
 |-- timestamp: timestamp (nullable = true)
 |-- visit_number: integer (nullable = true)
 |-- time_spent: double (nullable = true)
 |-- converted: integer (nullable = true)
接着我们查看数据集的基本信息。样本数据集共有100万条,其中有10w的独立用户,每个用户在每个网页上花费的时间以及该用户是否购买了产品的最终状态也会被跟踪。
df.select('user_id').distinct().count()
104087

df.groupBy('page').count().orderBy('count',ascending=False).show(10,False)
+-------------+------+
|page         |count |
+-------------+------+
|product info |767131|
|homepage     |142456|
|added to cart|67087 |
|others       |39919 |
|offers       |32003 |
|buy          |24916 |
|reviews      |23443 |
+-------------+------+

df.select(['user_id','page','visit_number','time_spent','converted']).show(10,False)
+----------------------------------------------------------------+-------------+------------+-----------+---------+
|user_id                                                         |page         |visit_number|time_spent |converted|
+----------------------------------------------------------------+-------------+------------+-----------+---------+
|8057ed24427be18922f640b20b60997e7d070946b6c8f48117ae4d6dad0ebb23|homepage     |0           |0.16666667 |1        |
|8057ed24427be18922f640b20b60997e7d070946b6c8f48117ae4d6dad0ebb23|product info |0           |0.4        |1        |
|8057ed24427be18922f640b20b60997e7d070946b6c8f48117ae4d6dad0ebb23|product info |0           |0.31666666 |1        |
|8057ed24427be18922f640b20b60997e7d070946b6c8f48117ae4d6dad0ebb23|product info |0           |0.6333333  |1        |
|8057ed24427be18922f640b20b60997e7d070946b6c8f48117ae4d6dad0ebb23|product info |0           |0.15       |1        |
|8057ed24427be18922f640b20b60997e7d070946b6c8f48117ae4d6dad0ebb23|homepage     |1           |0.8333333  |1        |
|8057ed24427be18922f640b20b60997e7d070946b6c8f48117ae4d6dad0ebb23|product info |1           |0.16666667 |1        |
|8057ed24427be18922f640b20b60997e7d070946b6c8f48117ae4d6dad0ebb23|product info |2           |0.16666667 |1        |
|8057ed24427be18922f640b20b60997e7d070946b6c8f48117ae4d6dad0ebb23|buy          |2           |0.016666668|1        |
|8057ed24427be18922f640b20b60997e7d070946b6c8f48117ae4d6dad0ebb23|added to cart|2           |0.41666666 |1        |
+----------------------------------------------------------------+-------------+------------+-----------+---------+
序列嵌入的整体理念是,将用户于线上操作期间的一系列操作步骤转换成一个页面序列,该序列可用于计算嵌入评分。第一步就是移除用户操作期间所访问的所有连续重复页面。我们创建一个额外的列来保护用户访问的上一个页面。Window是Spark中的一个函数,它有助于针对数据集中个别行或多个行的分组来应用特定的逻辑。
w = Window.partitionBy("user_id").orderBy('timestamp')
df = df.withColumn("previous_page", lag("page", 1, 'started').over(w))
df.select('user_id','timestamp','previous_page','page').show(10,False)
+----------------------------------------------------------------+-------------------+-------------+-------------+
|user_id                                                         |timestamp          |previous_page|page         |
+----------------------------------------------------------------+-------------------+-------------+-------------+
|004e96d0dc01f2541b7e5be735da6321b15f797ded220d5f6fb9d66910b5ce88|2017-04-10 20:23:09|started      |product info |
|004e96d0dc01f2541b7e5be735da6321b15f797ded220d5f6fb9d66910b5ce88|2017-04-10 20:26:23|product info |product info |
|004e96d0dc01f2541b7e5be735da6321b15f797ded220d5f6fb9d66910b5ce88|2017-04-12 14:12:40|product info |product info |
|004e96d0dc01f2541b7e5be735da6321b15f797ded220d5f6fb9d66910b5ce88|2017-04-12 20:49:33|product info |product info |
|004e96d0dc01f2541b7e5be735da6321b15f797ded220d5f6fb9d66910b5ce88|2017-04-13 12:18:12|product info |product info |
|01158797281955155c5c6bbe7daaa368021adcc4eaf4b3794e1789b5ee412a34|2018-02-21 23:47:13|started      |homepage     |
|01158797281955155c5c6bbe7daaa368021adcc4eaf4b3794e1789b5ee412a34|2018-02-21 23:49:17|homepage     |homepage     |
|01158797281955155c5c6bbe7daaa368021adcc4eaf4b3794e1789b5ee412a34|2018-02-22 00:07:58|homepage     |homepage     |
|01158797281955155c5c6bbe7daaa368021adcc4eaf4b3794e1789b5ee412a34|2018-02-22 11:08:24|homepage     |homepage     |
|01158797281955155c5c6bbe7daaa368021adcc4eaf4b3794e1789b5ee412a34|2018-02-22 11:08:32|homepage     |added to cart|
+----------------------------------------------------------------+-------------------+-------------+-------------+
only showing top 10 rows
现在,我们创建一个函数来检查当前页面是否类似于用户访问的上一个页面,并企鹅在新的名为indicator的列中标记为同一页面。指标累计列会跟踪用户操作期间访问独立页面的次数。
def indicator(page, prev_page):
    if page == prev_page:
        return 0
    else:
        return 1

page_udf = udf(indicator,IntegerType())
df = df.withColumn("indicator",page_udf(col('page'),col('previous_page'))) \
        .withColumn('indicator_cummulative',sum(col('indicator')).over(w))
df.select('previous_page','page','indicator','indicator_cummulative').show(20,False)
+-------------+-------------+---------+---------------------+
|previous_page|page         |indicator|indicator_cummulative|
+-------------+-------------+---------+---------------------+
|started      |product info |1        |1                    |
|product info |product info |0        |1                    |
|product info |product info |0        |1                    |
|product info |product info |0        |1                    |
|product info |product info |0        |1                    |
|started      |homepage     |1        |1                    |
|homepage     |homepage     |0        |1                    |
|homepage     |homepage     |0        |1                    |
|homepage     |homepage     |0        |1                    |
|homepage     |added to cart|1        |2                    |
|added to cart|homepage     |1        |3                    |
|homepage     |added to cart|1        |4                    |
|added to cart|homepage     |1        |5                    |
|started      |homepage     |1        |1                    |
|homepage     |product info |1        |2                    |
|product info |product info |0        |2                    |
|product info |product info |0        |2                    |
|product info |product info |0        |2                    |
|product info |product info |0        |2                    |
|started      |product info |1        |1                    |
+-------------+-------------+---------+---------------------+
我们持续创建新的窗口对象,从而对数据进行进一步的分区,以便每一个用户构建序列。
w2 = Window.partitionBy(["user_id",'indicator_cummulative']).orderBy('timestamp')
df = df.withColumn('time_spent_cummulative',sum(col('time_spent')).over(w2))
df.select('timestamp','previous_page','page','indicator','indicator_cummulative','time_spent','time_spent_cummulative').show(20,False)
+-------------------+-------------+-------------+---------+---------------------+-----------+----------------------+
|timestamp          |previous_page|page         |indicator|indicator_cummulative|time_spent |time_spent_cummulative|
+-------------------+-------------+-------------+---------+---------------------+-----------+----------------------+
|2017-04-10 20:23:09|started      |product info |1        |1                    |3.2333333  |3.2333333             |
|2017-04-10 20:26:23|product info |product info |0        |1                    |0.08       |3.3133333             |
|2017-04-12 14:12:40|product info |product info |0        |1                    |0.08       |3.3933333             |
|2017-04-12 20:49:33|product info |product info |0        |1                    |0.08       |3.4733333             |
|2017-04-13 12:18:12|product info |product info |0        |1                    |0.08       |3.5533333000000002    |
|2018-02-21 23:47:13|started      |homepage     |1        |1                    |0.16666667 |0.16666667            |
|2018-02-21 23:49:17|homepage     |homepage     |0        |1                    |0.06666667 |0.23333334            |
|2018-02-22 00:07:58|homepage     |homepage     |0        |1                    |0.06666667 |0.30000001            |
|2018-02-22 11:08:24|homepage     |homepage     |0        |1                    |0.13333334 |0.43333334999999995   |
|2018-02-22 11:08:32|homepage     |added to cart|1        |2                    |0.11666667 |0.11666667            |
|2018-02-22 11:10:08|added to cart|homepage     |1        |3                    |0.05       |0.05                  |
|2018-02-22 11:10:11|homepage     |added to cart|1        |4                    |0.083333336|0.083333336           |
|2018-02-22 12:31:58|added to cart|homepage     |1        |5                    |1.65       |1.65                  |
|2017-12-09 21:35:03|started      |homepage     |1        |1                    |0.25       |0.25                  |
|2017-12-09 21:35:18|homepage     |product info |1        |2                    |0.1        |0.1                   |
|2017-12-09 21:36:14|product info |product info |0        |2                    |0.15       |0.25                  |
|2017-12-09 21:36:23|product info |product info |0        |2                    |0.33333334 |0.58333334            |
|2017-12-09 21:36:52|product info |product info |0        |2                    |0.23333333 |0.81666667            |
|2017-12-09 21:42:31|product info |product info |0        |2                    |0.21666667 |1.03333334            |
|2017-04-24 06:45:25|started      |product info |1        |1                    |0.15       |0.15                  |
+-------------------+-------------+-------------+---------+---------------------+-----------+----------------------+
w3 = Window.partitionBy(["user_id",'indicator_cummulative']).orderBy(col('timestamp').desc())
df = df.withColumn('final_page',first('page').over(w3))\
     .withColumn('final_time_spent',first('time_spent_cummulative').over(w3))
df.select(['time_spent_cummulative','indicator_cummulative','page','final_page','final_time_spent']).show(10,False)
+----------------------+---------------------+-------------+-------------+-------------------+
|time_spent_cummulative|indicator_cummulative|page         |final_page   |final_time_spent   |
+----------------------+---------------------+-------------+-------------+-------------------+
|3.5533333000000002    |1                    |product info |product info |3.5533333000000002 |
|3.4733333             |1                    |product info |product info |3.5533333000000002 |
|3.3933333             |1                    |product info |product info |3.5533333000000002 |
|3.3133333             |1                    |product info |product info |3.5533333000000002 |
|3.2333333             |1                    |product info |product info |3.5533333000000002 |
|0.43333334999999995   |1                    |homepage     |homepage     |0.43333334999999995|
|0.30000001            |1                    |homepage     |homepage     |0.43333334999999995|
|0.23333334            |1                    |homepage     |homepage     |0.43333334999999995|
|0.16666667            |1                    |homepage     |homepage     |0.43333334999999995|
|0.11666667            |2                    |added to cart|added to cart|0.11666667         |
+----------------------+---------------------+-------------+-------------+-------------------+

aggregations=[]
aggregations.append(max(col('final_page')).alias('page_emb'))
aggregations.append(max(col('final_time_spent')).alias('time_spent_emb'))
aggregations.append(max(col('converted')).alias('converted_emb'))
df_embedding = df.select(['user_id','indicator_cummulative','final_page','final_time_spent','converted']).groupBy(['user_id','indicator_cummulative']).agg(*aggregations)
df_embedding.show(30, False)
+----------------------------------------------------------------+---------------------+-------------+-------------------+-------------+
|user_id                                                         |indicator_cummulative|page_emb     |time_spent_emb     |converted_emb|
+----------------------------------------------------------------+---------------------+-------------+-------------------+-------------+
|004e96d0dc01f2541b7e5be735da6321b15f797ded220d5f6fb9d66910b5ce88|1                    |product info |3.5533333000000002 |0            |
|01158797281955155c5c6bbe7daaa368021adcc4eaf4b3794e1789b5ee412a34|1                    |homepage     |0.43333334999999995|0            |
|01158797281955155c5c6bbe7daaa368021adcc4eaf4b3794e1789b5ee412a34|2                    |added to cart|0.11666667         |0            |
|01158797281955155c5c6bbe7daaa368021adcc4eaf4b3794e1789b5ee412a34|3                    |homepage     |0.05               |0            |
|01158797281955155c5c6bbe7daaa368021adcc4eaf4b3794e1789b5ee412a34|4                    |added to cart|0.083333336        |0            |
|01158797281955155c5c6bbe7daaa368021adcc4eaf4b3794e1789b5ee412a34|5                    |homepage     |1.65               |0            |
|020d29467c7810a85cdf9c85f8bad4c551bc79f5aee959f41b92d75de968d81b|1                    |homepage     |0.25               |0            |
|020d29467c7810a85cdf9c85f8bad4c551bc79f5aee959f41b92d75de968d81b|2                    |product info |1.03333334         |0            |
|032d6e8c20f41c18ec32b4178099e5ec6648715cb43953734e9b2428d92e84ed|1                    |product info |2.329999975        |0            |
|0377ebcf2ac8f8aef0f6dc28d61479f85a30d88203b9a46fd8dde56bee6384c5|1                    |product info |1.0699999999999998 |0            |
|03f484c3d0dc5afaf2589fff76f127ebd9f0c878c0ce027fe22938459a9b1454|1                    |homepage     |0.6500000100000001 |0            |
|03f484c3d0dc5afaf2589fff76f127ebd9f0c878c0ce027fe22938459a9b1454|2                    |product info |0.033333335        |0            |
|03f484c3d0dc5afaf2589fff76f127ebd9f0c878c0ce027fe22938459a9b1454|3                    |homepage     |0.5                |0            |
|03f484c3d0dc5afaf2589fff76f127ebd9f0c878c0ce027fe22938459a9b1454|4                    |product info |0.28               |0            |
|040828e6773148d00d1cbee03c90363e9c66c7d95d21313b6db6a20e9e45d210|1                    |product info |1.430000006        |0            |
|05bd9a73b6f61509e6e7e0fa2d3012efccc6103779a0816d46911a2f2ef55a3e|1                    |product info |14.79999967        |0            |
|068ea915e886eb11c747ea6cb137b76c73379dc7b71ac18fa1459a4f49528bed|1                    |homepage     |0.5                |0            |
|068ea915e886eb11c747ea6cb137b76c73379dc7b71ac18fa1459a4f49528bed|2                    |others       |0.5                |0            |
|068ea915e886eb11c747ea6cb137b76c73379dc7b71ac18fa1459a4f49528bed|3                    |product info |0.979999986        |0            |
|06a572f2d5e9d5c56cda08c2ab688854c9f4c8823f2b7f3fe27d0a68596a346e|1                    |product info |0.56               |0            |
|06d70abf021b34477cb7ee3151d3a9de1086dd270a1be5cc3c3407bf03a6393a|1                    |homepage     |0.5                |0            |
|06d70abf021b34477cb7ee3151d3a9de1086dd270a1be5cc3c3407bf03a6393a|2                    |product info |5.4666667          |0            |
|06d70abf021b34477cb7ee3151d3a9de1086dd270a1be5cc3c3407bf03a6393a|3                    |homepage     |1.2333333          |0            |
|06d70abf021b34477cb7ee3151d3a9de1086dd270a1be5cc3c3407bf03a6393a|4                    |product info |4.31666666         |0            |
|06d70abf021b34477cb7ee3151d3a9de1086dd270a1be5cc3c3407bf03a6393a|5                    |homepage     |0.85               |0            |
|06d70abf021b34477cb7ee3151d3a9de1086dd270a1be5cc3c3407bf03a6393a|6                    |reviews      |2.3                |0            |
|06d70abf021b34477cb7ee3151d3a9de1086dd270a1be5cc3c3407bf03a6393a|7                    |product info |0.2                |0            |
|06d70abf021b34477cb7ee3151d3a9de1086dd270a1be5cc3c3407bf03a6393a|8                    |reviews      |0.36333333         |0            |
|06d70abf021b34477cb7ee3151d3a9de1086dd270a1be5cc3c3407bf03a6393a|9                    |homepage     |1.55               |0            |
|06d70abf021b34477cb7ee3151d3a9de1086dd270a1be5cc3c3407bf03a6393a|10                   |product info |0.08               |0            |
+----------------------------------------------------------------+---------------------+-------------+-------------------+-------------+
最后,我们使用集合列表将用户访问过的所有页面合并成单个列表,对于用户访问时长也做相同的处理。
w4 = Window.partitionBy(["user_id"]).orderBy('indicator_cummulative')
w5 = Window.partitionBy(["user_id"]).orderBy(col('indicator_cummulative').desc())
df_embedding = df_embedding.withColumn('journey_page', collect_list(col('page_emb')).over(w4))\
                          .withColumn('journey_time_temp', collect_list(col('time_spent_emb')).over(w4)) \
                         .withColumn('journey_page_final',first('journey_page').over(w5))\
                        .withColumn('journey_time_final',first('journey_time_temp').over(w5)) \
                        .select(['user_id','journey_page_final','journey_time_final','converted_emb'])
df_embedding.select('user_id','journey_page_final','journey_time_final').show(10)
+--------------------+--------------------+--------------------+
|             user_id|  journey_page_final|  journey_time_final|
+--------------------+--------------------+--------------------+
|004e96d0dc01f2541...|      [product info]|[3.5533333000000002]|
|01158797281955155...|[homepage, added ...|[0.43333334999999...|
|01158797281955155...|[homepage, added ...|[0.43333334999999...|
|01158797281955155...|[homepage, added ...|[0.43333334999999...|
|01158797281955155...|[homepage, added ...|[0.43333334999999...|
|01158797281955155...|[homepage, added ...|[0.43333334999999...|
|020d29467c7810a85...|[homepage, produc...|  [0.25, 1.03333334]|
|020d29467c7810a85...|[homepage, produc...|  [0.25, 1.03333334]|
|032d6e8c20f41c18e...|      [product info]|       [2.329999975]|
|0377ebcf2ac8f8aef...|      [product info]|[1.0699999999999998]|
+--------------------+--------------------+--------------------+
每个用户以单个访问页面和时长向量表示。
df_embedding = df_embedding.dropDuplicates()
df_embedding.select('user_id','journey_page_final','journey_time_final').show(10)
+--------------------+--------------------+--------------------+
|             user_id|  journey_page_final|  journey_time_final|
+--------------------+--------------------+--------------------+
|004e96d0dc01f2541...|      [product info]|[3.5533333000000002]|
|01158797281955155...|[homepage, added ...|[0.43333334999999...|
|020d29467c7810a85...|[homepage, produc...|  [0.25, 1.03333334]|
|032d6e8c20f41c18e...|      [product info]|       [2.329999975]|
|0377ebcf2ac8f8aef...|      [product info]|[1.0699999999999998]|
|03f484c3d0dc5afaf...|[homepage, produc...|[0.65000001000000...|
|040828e6773148d00...|      [product info]|       [1.430000006]|
|05bd9a73b6f61509e...|      [product info]|       [14.79999967]|
|068ea915e886eb11c...|[homepage, others...|[0.5, 0.5, 0.9799...|
|06a572f2d5e9d5c56...|      [product info]|              [0.56]|
+--------------------+--------------------+--------------------+
当我们有了用户访问列表和时长列表,将Spark DataFrame转化成pandas的DataFrame,利用gensim包计算词向量。
pd_df_embedding = df_embedding.toPandas()
pd_df_embedding = pd_df_embedding[pd_df_embedding['journey_length'] > 4 ]
pd_df_embedding = pd_df_embedding.reset_index(drop=True)
EMBEDDING_SIZE = 100
model = Word2Vec(pd_df_embedding['journey_page_final'], size=EMBEDDING_SIZE)
print(model)

Word2Vec(vocab=7, size=100, alpha=0.025)
page_categories = list(model.wv.vocab)
print(page_categories)

['product info', 'homepage', 'added to cart', 'others', 'reviews', 'offers', 'buy']

print(model['reviews'])
[ 0.47489035  0.53834176 -0.47785276 -0.26488945 -0.2656599  -0.04322785
  0.24362227  0.26430744 -0.48902759 -0.31393662  0.41263634  0.78189737
  0.58100605 -0.4459599  -0.70117044 -0.63221812 -0.6908192  -0.6791628
 -0.02506013  0.21131983 -0.02721698 -0.20559131 -0.78862274 -0.55389541
 -0.1507041   0.7149269  -0.24301411  0.29431018 -0.52848756 -0.500494
  0.16006927 -0.10355954 -0.36789769 -0.01349463 -0.40723842  0.15346751
 -0.79262614 -0.67456675 -0.18617149  0.69221032  0.53981733  0.75779319
  0.0573662   0.85435468  0.78063792  0.57342744 -0.16319969  0.46502107
 -0.09518502  0.60525858  0.31979162 -0.26889852 -0.12189896  0.65022558
  0.07857032  0.06138223  0.15626955  0.23680885  0.33999926 -0.54703128
 -0.21992962  0.83436728 -0.34557605 -0.69831383  0.4595826  -0.49346444
 -0.14114673  0.37797749  0.70894194  0.55426389 -0.40428343 -0.67311144
 -0.46010655 -0.44518954  0.7340765  -0.04775194 -0.44416061  0.45019379
 -0.54332632 -0.48565596  0.093257   -0.5141685   0.24856164  0.39611688
 -0.15698397 -0.45113751 -0.15056689  0.75211751 -0.06628865  0.07008368
  0.46780539 -0.13114813 -0.61940897 -0.29163912 -0.3338908   0.40938324
  0.08697812  0.74824899  0.53244144 -0.20717621]
使用模型并传入模型词汇表,可以创建一个大小为(7,100)的嵌入矩阵。并利用PCA技术,将纬度降到2维,可以可视化的展示词向量。
X = model[model.wv.vocab]
pca = PCA(n_components=2)
result = pca.fit_transform(X)
plt.figure(figsize=(10,10))
plt.scatter(result[:, 0], result[:, 1])

for i,page_category in enumerate(page_categories):
    plt.annotate(page_category,horizontalalignment='right', verticalalignment='top',xy=(result[i, 0], result[i, 1]))

plt.show()
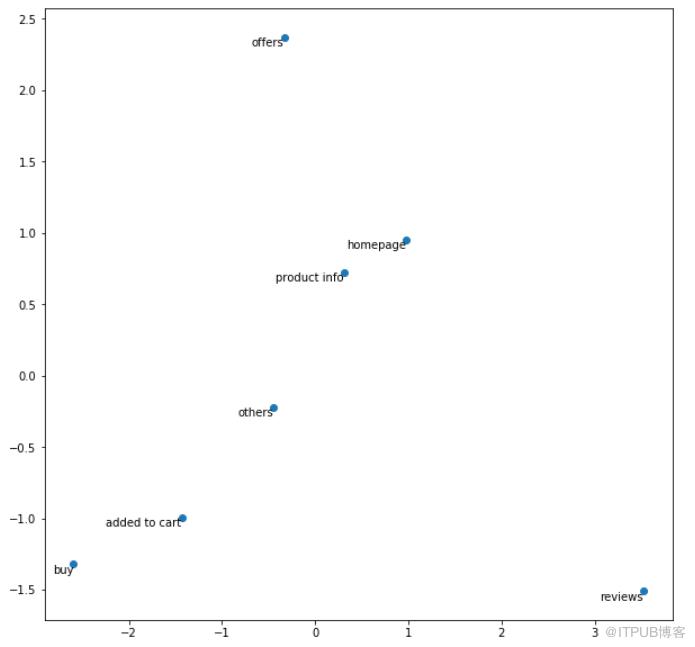
可以明显看出,购买和添加到购物车的嵌入向量在相似度方面彼此接近,而首页和产品信息彼此也较为相近。
本文主要使用PySpark来计算序列嵌入向量,在实践中embedding技术是非常常用的序列向量化的手段,也是处理大规模稀疏特征的首选方法。感兴趣的小伙伴点赞收藏,关注公众号获取第一手资源哦!!!




原文作者:ChallengeHub;如有侵权,请联系管理员删除。

